P2-5.2 분포(distribution), 평균(mean), 분산(variance)
Section ID:
P2-5.2Version:v2026.09.15
분포(distribution)는 값들이 어디에 얼마나 모여 있는지를 보여 줍니다. 평균(mean)은 중심을, 분산(variance)은 평균 주변의 퍼짐을 숫자로 요약합니다. 평균이 같은 두 데이터 묶음도 분포와 분산은 다를 수 있습니다.
점수 구간과 개수
시험 점수 10개를 구간별로 묶으면 값들이 어디에 모여 있는지 볼 수 있습니다.
40, 45, 48, 50, 52, 55, 58, 60, 62, 90
히스토그램(histogram)의 가로축은 점수 구간, 세로축은 각 구간에 들어가는 값의 개수입니다. 여기서는 구간 폭을 모두 10점으로 맞추고, 각 구간의 왼쪽 경계는 포함하며 오른쪽 경계는 다음 구간에 넣습니다.
| 점수 구간 | 해당 점수 | 개수 |
|---|---|---|
| 35 이상 45 미만 | 40 | 1 |
| 45 이상 55 미만 | 45, 48, 50, 52 | 4 |
| 55 이상 65 미만 | 55, 58, 60, 62 | 4 |
| 65 이상 75 미만 | 없음 | 0 |
| 75 이상 85 미만 | 없음 | 0 |
| 85 이상 95 미만 | 90 | 1 |
45점은 두 번째 구간에, 55점은 세 번째 구간에 들어갑니다. 이렇게 경계를 정하면 같은 점수를 두 번 세지 않습니다. 각 구간의 개수를 더하면 원래 점수 개수인 10이 됩니다.
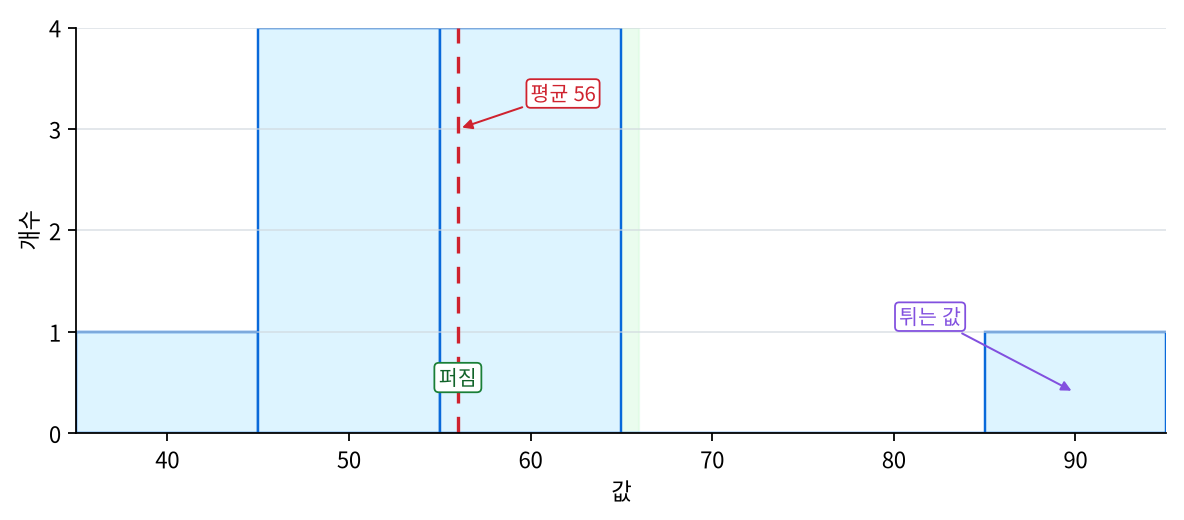
10개 중 8개가 45 이상 65 미만에 모여 있고, 65 이상 85 미만에는 값이 없습니다. 90점은 나머지 값들과 떨어져 있습니다. 빨간 점선은 평균 56점을 나타냅니다. 평균선 하나로는 값이 없는 구간이나 떨어진 점수를 알 수 없으므로, 막대의 배치도 함께 읽어야 합니다.
데이터 분포와 확률분포
분포는 관측한 데이터의 배치나 가능한 값들의 확률을 가리킬 수 있습니다.
| 표현 | 영어 | 작업용 설명 |
|---|---|---|
| 데이터 분포 | data distribution | 실제로 관측한 데이터 값들이 놓인 모양 |
| 확률분포 | probability distribution | 가능한 값들에 확률을 배정한 수학적 표현 |
예를 들어 사용자 나이 데이터가 실제로 10만 개 있다고 하겠습니다. 이 값을 히스토그램으로 그리면 데이터 분포를 볼 수 있습니다.
반면 “어떤 값이 나올 가능성이 얼마나 되는가”를 수학적으로 표현하면 확률분포입니다.
데이터 분포는 이미 모은 값들이 어떻게 놓였는가를 말하고, 확률분포는 가능한 값들이 어떤 가능성으로 나올 것인가를 말합니다.
둘은 연결되어 있지만 같은 말은 아닙니다. 실제 데이터 분포를 보고 확률분포를 가정하거나 추정할 수 있지만, 관측 데이터 자체가 곧 완전한 확률분포라는 뜻은 아닙니다.
AI에서는 이 구분이 중요합니다. 학습 데이터의 분포는 모델이 실제로 본 데이터의 모양이고, 현실 세계의 분포는 모델이 앞으로 만날 가능성이 있는 데이터의 모양입니다. 두 분포가 다르면 모델 성능이 흔들릴 수 있습니다.
평균 계산
평균(mean)은 여러 값을 하나의 대표 중심으로 요약한 값입니다.
예를 들어 다음 값들이 있다고 하겠습니다.
2, 4, 6, 8, 10
평균은 모든 값을 더한 뒤 값의 개수로 나눕니다.
시그마(sigma) 표기로 쓰면 다음과 같습니다.
시그마는 모든 값을 더하는 계산을 압축합니다. 합계를 값의 개수 n으로 나누면 평균입니다.
평균은 매우 자주 쓰입니다. 이유는 단순합니다. 많은 값을 하나의 숫자로 압축해 비교할 수 있기 때문입니다. 예를 들어 이번 달 평균 응답 시간, 사용자당 평균 클릭 수, 배치(batch)의 평균 손실, 모델의 평균 정확도가 모두 이런 방식으로 읽힙니다.
하지만 평균은 데이터의 모든 특징을 말해 주지는 않습니다.
같은 평균, 다른 퍼짐
평균은 중심을 빠르게 보여 주지만, 값의 모양을 숨길 수 있습니다.
예를 들어 두 데이터 묶음이 있다고 하겠습니다.
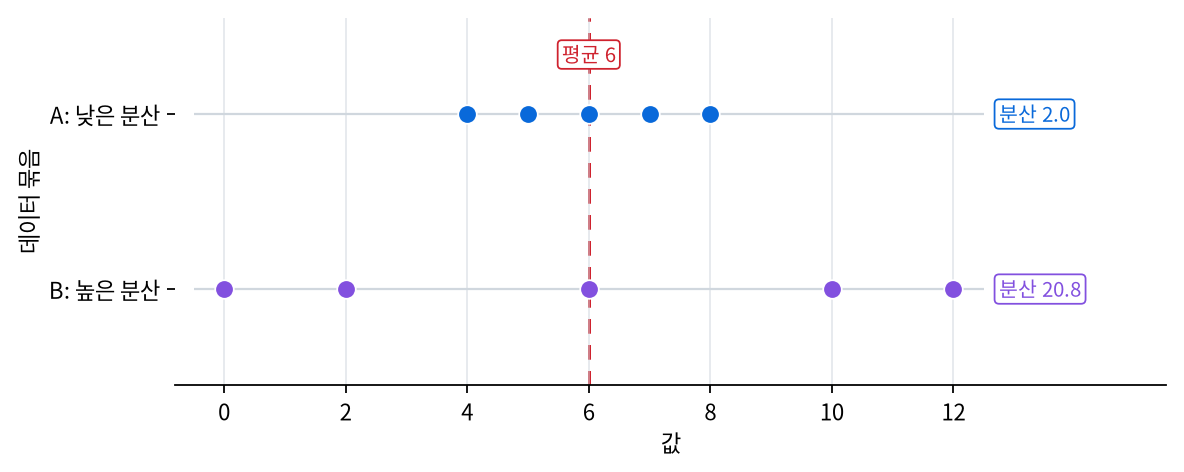
A: 4, 5, 6, 7, 8, B: 0, 2, 6, 10, 12
두 묶음의 평균은 모두 6입니다.
하지만 두 데이터는 같은 성격으로 보이지 않습니다. A는 값들이 평균 근처에 모여 있고, B는 값들이 평균에서 멀리 퍼져 있습니다.
평균만 보면 두 데이터가 비슷해 보일 수 있습니다. 하지만 실제로는 안정성, 예측 가능성, 위험이 다를 수 있습니다.
아래 차트는 평균이 같아도 퍼짐이 다를 수 있음을 보여 줍니다.
평균에서의 거리와 분산
분산(variance)은 값들이 평균 주변에 얼마나 퍼져 있는지 나타내는 값입니다.
각 값과 평균의 차이를 제곱한 뒤 평균내면, 관측한 데이터 묶음의 퍼짐을 요약할 수 있습니다.
분산을 계산하는 대표적인 흐름은 다음과 같습니다.
- 평균을 구한다.
- 각 값에서 평균을 뺀다.
- 그 차이를 제곱한다.
- 제곱한 값을 평균낸다.
이 데이터 묶음 자체의 분산을 v로 적으면 다음과 같습니다.
이 식은 주어진 값들의 퍼짐을 기술하므로 개수 n으로 나눕니다. 표본으로 모집단 분산을 추정할 때 흔히 쓰는 표본분산은 n − 1로 나누며, 위 계산과 목적이 다릅니다.
평균보다 큰 값의 차이는 양수, 작은 값의 차이는 음수입니다. 차이를 그대로 더하면 상쇄되지만, 제곱하면 평균에서 벗어난 정도를 0 이상의 값으로 모을 수 있습니다.
두 묶음의 분산 계산
앞의 두 묶음 A: 4, 5, 6, 7, 8, B: 0, 2, 6, 10, 12는 모두 평균이 6입니다.
| 계산 | A | B |
|---|---|---|
| 평균과의 차이 | −2, −1, 0, 1, 2 | −6, −4, 0, 4, 6 |
| 차이의 제곱 | 4, 1, 0, 1, 4 | 36, 16, 0, 16, 36 |
| 제곱의 합 | 10 | 104 |
| 분산: 합계 / 5 | 2 | 20.8 |
평균은 같지만 B의 분산은 A의 10.4배입니다. B에 평균에서 멀리 떨어진 값이 더 많다는 차이가 숫자로 드러납니다.
분산과 표준편차의 단위
분산(variance)을 배우면 표준편차(standard deviation)도 자주 만납니다.
표준편차는 분산의 제곱근입니다.
데이터의 단위가 초이면 분산의 단위는 초², 표준편차의 단위는 초입니다. 표준편차는 제곱근을 취하므로 원래 데이터와 같은 단위로 퍼짐을 비교할 수 있습니다.
A와 B의 값이 응답 시간(초)이었다면 표준편차는 각각 √2 ≈ 1.41초, √20.8 ≈ 4.56초입니다. 두 서비스의 평균 응답 시간이 모두 6초여도 B의 응답 시간이 더 넓게 퍼져 있음을 알 수 있습니다.
평균 손실과 그룹별 차이
모델 평가에서도 평균만 보면 차이가 가려질 수 있습니다. 평가 데이터 100개 중 90개의 손실이 0.1, 나머지 10개의 손실이 2.1이라고 가정하면 평균 손실은 (90 × 0.1 + 10 × 2.1) / 100 = 0.3입니다.
전체 평균은 0.3이지만 마지막 10개에서는 손실이 2.1입니다. 이 10개가 같은 촬영 조건의 이미지라면, 해당 조건에서 모델이 어려움을 겪는지 따로 확인할 수 있습니다. 평균 손실과 함께 손실의 분포와 그룹별 값을 보는 이유입니다.
체크리스트
- 분포, 평균, 분산이 각각 값의 모양, 중심, 퍼짐을 나타낸다고 설명할 수 있다.
- 관측 데이터의 분포와 확률분포를 구분할 수 있다.
- 평균이 6인 두 데이터 묶음의 분산 2와 20.8을 계산할 수 있다.
- 데이터 묶음 자체의 분산과 모집단 분산을 추정하는 표본분산의 분모를 구분할 수 있다.
- 분산과 표준편차의 관계 및 단위를 설명할 수 있다.
- 전체 평균 손실이 특정 그룹의 큰 손실을 가릴 수 있음을 설명할 수 있다.
출처와 참고 자료
- Barbara Illowsky, Susan Dean, Introductory Statistics, 2.2 Histograms, Frequency Polygons, and Time Series Graphs, OpenStax, 확인 날짜: 2026-07-20. 히스토그램을 통해 큰 데이터 묶음의 모양, 중심, 퍼짐을 읽는다는 설명 확인에 사용했다.
- Barbara Illowsky, Susan Dean, Introductory Statistics, 2.5 Measures of the Center of the Data, OpenStax, 확인 날짜: 2026-07-20. 평균(mean)을 데이터 중심의 대표값으로 설명하는 근거로 사용했다.
- Barbara Illowsky, Susan Dean, Introductory Statistics, 2.7 Measures of the Spread of the Data, OpenStax, 확인 날짜: 2026-07-20. 분산과 표준편차가 평균 주변의 퍼짐, 제곱 편차, 원래 단위와 연결되는 설명 확인에 사용했다.