P5-13.2 셀프 어텐션(self-attention)으로 이어지는 흐름
Section ID:
P5-13.2Version:v2026.07.31
P5-13.1에서는 어텐션(Attention)을 현재 계산에 중요한 위치를 더 크게 참고하는 방식으로 설명했습니다. 이제 다음 질문이 바로 이어집니다.
그렇다면 입력과 출력이 따로 있는 encoder-decoder 참조만이 아니라, 하나의 작업 지시 문장 안 각 위치가 서로를 직접 참고하게 만들면 무엇이 달라지는가?
이 질문에 대한 핵심 답이 셀프 어텐션(self-attention)입니다.
셀프 어텐션은 시퀀스 안의 각 토큰이 같은 시퀀스의 다른 토큰들을 서로 참고하며, 현재 표현을 다시 계산하는 방식입니다.
Transformer 직전의 핵심 메커니즘을 다시 짧게 확인해야 할 때는 개념사전의 셀프 어텐션(self-attention) 항목으로 돌아갑니다.
self-attention으로 넘어갈 때 붙잡을 질문
- 셀프 어텐션은 어텐션과 무엇이 다른가?
- 왜
자기 시퀀스 안에서 서로 참조한다는 발상이 중요한가? - self-attention은 RNN과 어떤 점에서 계산 관점이 다른가?
- 왜 트랜스포머(Transformer)의 핵심으로 이어지는가?
이 절에서 먼저 붙잡아야 할 핵심은 토큰이 상태를 차례로 넘겨받는 대신, 같은 시퀀스 안 다른 토큰을 직접 다시 참고해 자기 표현을 새로 만든다는 점입니다. 따라서 여기서는 optimizer나 regularization 같은 학습 절차보다, 같은 시퀀스 안 토큰들이 서로를 다시 참고해 표현을 어떻게 갱신하는가라는 관계 재계산 구조를 먼저 읽습니다.
Transformer 전체 구성은 P5-14.1부터 P5-14.5까지 이어서 다루고, query, key, value와 multi-head attention의 입문적 설명은 보충학습 P5-13.3에서 회수합니다.
여기서 끝내야 하는 설명은 하나입니다. 토큰이 순차 상태를 전달받는가보다 토큰들이 서로를 다시 참고해 자기 표현을 갱신하는가라는 계산 감각 전환을 현재 절 안에서 이해해야 합니다.
self-attention을 읽는 기준
- self-attention을
시퀀스 내부 토큰들 사이의 상호 참조로 설명할 수 있습니다. - self-attention이 RNN식 순차 전달과 다른 계산 감각을 준다는 점을 말할 수 있습니다.
- self-attention이 병렬 처리와 긴 문맥 문제에 어떤 장점을 주는지 말할 수 있습니다.
- 실행 가능한 Python 예제로 토큰 간 중요도 참조 직관을 확인할 수 있습니다.
attention과 self-attention은 무엇이 다른가
attention은 넓게 보면 현재 계산이 어떤 위치를 더 강하게 참고할지 정하는 방식입니다. self-attention은 그 참조 대상이 같은 시퀀스 내부라는 점이 핵심입니다.
예를 들어 문장 안에서:
- 각 단어는 다른 단어들을 참고할 수 있고
- 현재 단어 표현은 전체 문장 안의 관련 토큰 정보를 다시 모아 계산할 수 있습니다
즉, self-attention은 문장 바깥 정보를 가져오는 것이 아니라, 문장 내부 관계를 다시 읽는 방식입니다.
P5-13.1이 현재 출력이 입력 어디를 더 참고할까를 묻는 절이었다면, 여기서는 그 질문이 현재 토큰이 같은 문장 안 다른 토큰을 어떻게 다시 참고할까로 바뀝니다.
같은 장면을 두 방식으로 나눠 보면 차이가 더 또렷해집니다.
| 같은 장면 | attention에서 먼저 보는 관계 | self-attention에서 먼저 보는 관계 |
|---|---|---|
| 다국어 작업 지시 문구를 한 줄 쓰는 순간 | 현재 출력 문구가 입력 절차 어느 위치를 더 참고할까 | 현재 작업 지시 문장 안 각 토큰이 서로를 어떻게 다시 참고할까 |
| 교대 인수인계 요약 문장 하나를 만드는 순간 | 현재 요약 문장이 원문 어느 문장을 더 볼까 | 기록 안 각 토큰 표현이 서로를 참고하며 어떻게 다시 바뀔까 |
| 정비 코드 한 줄을 해석하는 순간 | 현재 출력이 앞 입력 중 어느 위치를 더 참고할까 | 코드 안 이름, 조건, 호출 위치가 서로를 어떻게 다시 연결할까 |
즉, attention이 지금 출력이 어디를 더 볼까에 가깝다면, self-attention은 문장 안 각 위치가 서로를 어떻게 다시 읽을까에 더 가깝습니다. 여기서 핵심은 참조 대상이 안쪽으로 들어왔다는 사실보다, 현재 토큰마다 새로 계산되는 참조 분포가 달라진다는 점입니다.
이 차이를 attention에서 self-attention으로 넘어가는 전환만 따로 압축하면 다음과 같습니다.
flowchart TD
  A["현재 출력"]
  B["입력 위치들을 다시 훑음"]
  C["관련 단서를 더 크게 참고"]
  D["이 참조 발상이 같은 시퀀스 안으로 들어감"]
  E["각 토큰이 다른 토큰들을 다시 참고"]
  F["토큰 표현을 함께 다시 계산"]

  A --> B
  B --> C
  C --> D
  D --> E
  E --> F
즉, 현재 출력이 입력 어디를 볼까라는 참조 방식이 각 토큰이 같은 시퀀스 안 다른 토큰을 어떻게 다시 볼까로 안쪽으로 확장된다고 보면 됩니다.
왜 이것이 중요한가
RNN은 보통 앞에서 뒤로, 혹은 양방향이라 해도 시간 흐름을 따라 상태를 전달하는 감각이 강합니다. self-attention은 이와 다르게, 현재 토큰이 필요할 때 멀리 떨어진 토큰도 비교적 직접 참고할 수 있게 합니다.
핵심 차이는 RNN이 상태를 이어 전달하는 쪽에 가깝고, self-attention은 필요한 토큰 관계를 다시 계산하는 쪽에 가깝다는 점입니다.
RNN은 기억을 이어서 전달하는 방식에 가깝고, self-attention은 필요한 단어를 다시 찾아보는 방식에 가깝다.
즉, 오래전 정보가 희미해지는 문제에 대해, self-attention은 더 직접적인 참조 경로를 만듭니다. 이 절에서 self-attention을 읽는 핵심은 문장 전체를 본다보다 현재 토큰이 자기에게 필요한 관계를 다시 계산한다에 있습니다.
이 차이는 다음 표로 더 짧게 잡을 수 있습니다.
| 관점 | RNN 계열 | self-attention |
|---|---|---|
| 기본 감각 | 상태를 다음 step으로 넘긴다 | 모든 토큰 사이 관련도를 다시 계산한다 |
| 먼 정보 접근 | 여러 step을 거쳐 전달된다 | 더 직접 참고할 수 있다 |
| 계산 느낌 | 순차 전달 | 관계 계산 |
여기서 독자가 꼭 잡아야 할 핵심은 self-attention은 기억을 넘기는 구조라기보다, 관계를 다시 계산하는 구조라는 점입니다.
문장 안에서 어떤 일이 일어나나
예를 들어 문장:
The animal didn't cross the road because it was tired.
에서 it이 무엇을 가리키는지 이해하려면, 문장 안 다른 단어와의 관계를 봐야 합니다. self-attention은 이런 관계를 설명하는 입문적 직관에 매우 잘 맞습니다.
각 토큰은:
- 자기 자신만 보는 것이 아니라
- 다른 토큰과의 관련도를 계산하고
- 더 중요한 토큰 정보를 더 많이 반영해
- 새로운 표현을 만듭니다
즉, self-attention은 토큰 표현을 문맥적으로 다시 쓰는 방식입니다.
이 말을 아주 짧은 예시로 다시 보면 다음과 같습니다.
여기서 그것을 읽을 때, 바로 앞 단어 하나만 보는 것으로는 트레이를 가리키는지 절연캡을 가리키는지 충분히 안정적으로 판단하기 어렵습니다. self-attention 관점에서는 그것 위치가 문장 안 다른 단어들을 다시 참고하면서, 현재 문맥에 더 맞는 후보 쪽에 더 큰 비중을 둘 수 있습니다. 즉, 현재 토큰 하나를 이해하려고 문장 전체를 다시 섞어 읽는다는 감각이 핵심입니다.
왜 Transformer의 핵심이 되었나
self-attention이 중요한 이유는 단순히 더 똑똑해 보여서가 아닙니다. 계산 구조 자체를 바꾸기 때문입니다.
특히 독자 기준에서 중요한 차이는 다음 두 가지입니다.
- 먼 위치를 더 직접 참고할 수 있습니다
- 순차적으로만 상태를 전달하지 않아도 되어 병렬 계산과 잘 맞습니다
즉, self-attention은 장기 의존성 문제와 병렬 처리 요구를 동시에 더 잘 만족시키는 방향으로 보였습니다. 이것이 Transformer의 핵심이 된 이유 중 하나입니다.
즉, 멀리 있는 단서를 다시 찾기 쉽고, 계산도 한 번에 다루기 쉬웠기 때문에 self-attention이 구조의 중심으로 올라왔다고 보면 됩니다. 여기서 중요한 것은 attention이 있다가 아니라 각 토큰 표현을 다시 쓰는 계산이 블록 중심이 되었다는 점입니다.
여기서 독자가 한 번 더 붙잡아야 할 점은, self-attention이 단지 좋은 기능 하나가 아니라 블록 중심 계산이 되었다는 사실입니다. 즉, Transformer는 먼저 self-attention으로 관계를 다시 읽고, 그 결과를 다음 계산으로 넘기는 구조를 반복 기본 단위로 삼습니다. 이 연결이 바로 다음 절 P5-14.1의 출발점입니다.
이를 아주 단순하게 그리면
flowchart TD
  A["토큰 1"]
  B["토큰 2"]
  C["토큰 3"]
  D["토큰 4"]

  A --- B
  A --- C
  A --- D
  B --- C
  B --- D
  C --- D
이 도식은 각 토큰이 다른 토큰들을 서로 참고할 수 있다는 직관을 압축합니다. 실제 구현은 더 정교하지만, 여기서 먼저 확인해야 할 점은 토큰이 앞에서 뒤로만 정보를 넘기는 것이 아니라 서로의 관련도를 함께 계산한다는 구조입니다.
한 토큰은 앞 토큰만 받는 것이 아니라, 문장 안 다른 토큰들을 함께 참고해 자기 표현을 다시 만든다.
같은 입력 문장 안에서도 현재 토큰이 달라지면 다시 보는 위치가 달라진다는 점을 한 번 더 짧게 고정하면 다음처럼 볼 수 있습니다.
flowchart TD
  A["같은 입력 메모<br/>배터리팩 분리 / 절연캡 미적용 / 그것이 위험?"]
  B["후보 토큰 묶음<br/>배터리팩 · 분리 · 절연캡 · 씌우지 · 그것 · 위험"]

  A --> B
  B --> C["현재 토큰: 그것"]
  B --> D["현재 토큰: 씌우지"]

  C --> E["더 크게 다시 봄<br/>절연캡 0.430<br/>씌우지 0.214<br/>위험 0.143"]
  D --> F["더 크게 다시 봄<br/>절연캡 0.367<br/>분리 0.246<br/>씌우지 0.182"]

  E --> G["새 표현<br/>위험 원인 단서 쪽으로 이동"]
  F --> H["새 표현<br/>작업 동작 맥락 쪽으로 이동"]

  classDef input fill:#f8fafc,stroke:#64748b,color:#0f172a
  classDef target fill:#ecfeff,stroke:#0891b2,color:#164e63
  classDef weight fill:#eff6ff,stroke:#2563eb,color:#1e3a8a
  classDef result fill:#f0fdf4,stroke:#16a34a,color:#14532d
  class A,B input
  class C,D target
  class E,F weight
  class G,H result
이 차이는 attention 비중을 막대로 놓으면 더 직접 보입니다. 같은 메모라도 현재 토큰이 그것일 때와 씌우지일 때는 다시 참고하는 단서의 분포가 같지 않습니다.
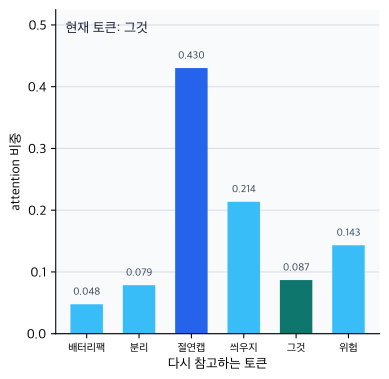
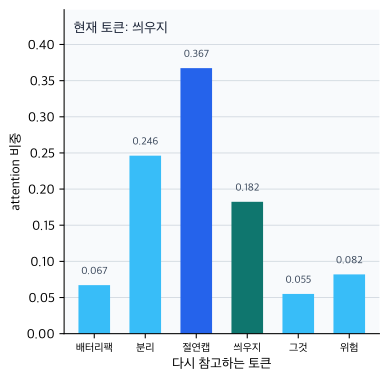
이 비교 도식에서 먼저 붙잡아야 할 점은 다음과 같습니다.
- 같은 문장을 읽어도
그것이 다시 볼 단서와씌우지가 다시 볼 단서는 다릅니다. - 그래서 self-attention의 핵심은
문장 전체를 한 번 본다가 아니라,현재 토큰마다 다시 참고할 위치가 달라진다는 데 있습니다. - 이 감각이 잡혀야 바로 다음
QKV와multi-head를토큰별 질문과관계 분화의 계산 이름으로 더 자연스럽게 읽을 수 있습니다.
self-attention은 왜 병렬 처리와 잘 맞나
RNN은 시점 순서대로 상태를 넘기므로, 계산 흐름이 순차적이라는 감각이 강합니다. self-attention은 각 토큰의 관련도 계산을 더 행렬적인 방식으로 다루기 쉬워, GPU 병렬 처리와 잘 맞습니다.
self-attention은 토큰들을 순서대로만 밀어내기보다, 한 번에 서로의 관계를 계산하는 방향에 더 가깝다.
이 점은 Part 5의 GPU/배치/텐서 계산과도 자연스럽게 연결됩니다.
셀프 어텐션으로 이어지는 흐름: 확인할 판단 기준
이 사례에서는 self-attention으로 이어지는 흐름을 순차 구조 한계와 연결해 설명하는지 확인한다.
대표 사례. 문장 안 지시어 해석
안전 점검 메모에 배터리 팩은 분리했지만 절연 캡은 씌우지 않았습니다. 그것이 문제인가요? 같은 표현이 있다고 해 보겠습니다. 사람이 대충 읽을 때는 보통 그것 바로 근처 단어만 먼저 보고 뜻을 짐작하기 쉽습니다. 하지만 실제로는 그것이 절연 캡을 가리키는지, 분리 사실을 가리키는지에 따라 후속 조치 내용이 달라질 수 있습니다. 가까운 단어만 따라가면 이런 참조 관계를 놓치기 쉽습니다. 여기서 바뀌는 점은 바로 앞 단어만 보는 읽기에서 문장 전체 관계를 함께 보는 읽기로 기준이 이동한다는 것입니다. self-attention은 현재 토큰이 문장 안 다른 위치를 다시 참고해 무엇을 가리키는가를 더 직접 계산한다는 직관을 줍니다.
그래서 이 사례에서 확인해야 할 결과는 그것이라는 현재 토큰이 바로 앞 단어 하나만 보는 것이 아니라, 문장 안 여러 후보 중 무엇을 실제로 더 강하게 다시 참고해야 하는지가 더 분명해지는가입니다.
같은 관점은 한 문장 안 조건 범위 해석이나 코드 한 줄 조건 해석에도 그대로 이어집니다. 다만 이 절에서 붙잡을 핵심은 도메인 이름이 아니라, 현재 토큰마다 다시 참고할 대상이 달라지고 그에 따라 새 표현도 달라지는가입니다.
| 사례 | 현재 위치가 다시 봐야 하는 대상 | 가까운 위치만 보면 생기는 문제 | self-attention으로 확인할 결과 |
|---|---|---|---|
| 대명사 해석 | 대명사가 가리키는 앞 명사 | 바로 옆 단어만 보고 잘못 연결할 수 있다 | 문장 전체 관계를 반영해 더 그럴듯한 지시어를 고르는가 |
| 조건 범위 해석 | 조건 표현, 조치 표현, 부정 범위 | 조치 단어만 보고 금지 범위를 잘못 읽을 수 있다 | 문장 안 관계를 반영해 조건이 어디까지 미치는지 다시 묶는가 |
| 코드 한 줄 해석 | 변수명, 부정 표현, 논리 연산자 | 눈에 띄는 변수 하나만 보고 조건식 뜻을 잘못 읽을 수 있다 | 코드 시퀀스 관계를 반영해 부정과 결합 순서를 함께 읽는가 |
| 사람이 먼저 보기 쉬운 기준 | self-attention 관점으로 다시 읽는 기준 |
|---|---|
| 문장 전체를 한 번 읽은 뒤 공통 문맥 하나만 있으면 충분하다고 느낀다 | 각 토큰이 자기 위치에서 다시 봐야 할 대상이 다르므로 토큰마다 새 표현도 달라져야 한다 |
| 중요한 단서는 문장 전체에서 한 번만 정해진다고 본다 | 그것이 중요하게 보는 단서와 씌우지가 중요하게 보는 단서는 서로 다를 수 있다 |
self-attention을 그냥 문장 전체를 본다로만 이해하기 쉽다 | 핵심은 문장 전체를 똑같이 보는 것이 아니라 각 토큰별로 관계를 다시 계산하는 데 있다 |
세 사례를 같이 놓고 보면, self-attention의 핵심은 문장 전체를 한 번 본다가 아니라 현재 토큰마다 무엇을 다시 참고해야 하는지가 달라지고, 그에 따라 새 표현도 달라진다는 점입니다.
연습 및 예제
이번 예제의 목표는 안전 점검 메모에서 현재 토큰이 문장 안 여러 후보 중 무엇을 더 크게 참고하는지, 그리고 그 결과 현재 표현이 어떻게 달라지는지를 직접 확인하는 것입니다. 이번에는 토큰과 점수를 코드 안에만 넣지 않고, 여러 안전 메모의 후보 토큰을 CSV 파일로 분리해 읽습니다.
문제 상황:
- 현재 토큰 해석은 바로 옆 단어만이 아니라 문장 안 여러 위치를 다시 참고해야 달라질 수 있다
- 같은 메모라도 현재 토큰이
그것인지씌우지인지에 따라 다시 참고할 단서가 달라질 수 있다
입력:
self-attention-safety-memo-candidates.csv- 3개 안전 메모 시나리오, 6개 현재 토큰 조건, 36개 후보 토큰 행
- 후보 토큰별 간단한 의미 벡터
evidence_pack,evidence_cap,evidence_action - 현재 토큰별 관련도 점수
score
출력:
- 현재 메모 후보 토큰을 똑같이 평균낸 baseline 표현
그것,씌우지위치에서 계산된 attention 비중- self-attention 이후 각 현재 토큰의 새 표현
- 어떤 토큰 묶음이 가장 크게 반영됐는지에 대한 요약
CSV의 한 행은 특정 메모에서 현재 토큰 하나가 후보 토큰 하나를 얼마나 다시 참고하는가를 뜻합니다. 예를 들어 memo_cap_missing 메모에서는 그것과 씌우지가 같은 후보 토큰 묶음을 보지만, target token이 다르기 때문에 score 분포가 달라집니다.
CSV 일부를 먼저 보면 다음과 같습니다.
| document_id | target_token | candidate_token | candidate_role | evidence_pack | evidence_cap | evidence_action | score |
|---|---|---|---|---|---|---|---|
| memo_cap_missing | 그것 | 절연캡 | missing_object | 0.1 | 0.95 | 0.2 | 2.4 |
| memo_cap_missing | 그것 | 씌우지 | missing_action | 0.0 | 0.7 | 0.9 | 1.7 |
| memo_cap_missing | 씌우지 | 분리 | prior_action | 0.8 | 0.2 | 0.4 | 1.7 |
| memo_cap_missing | 씌우지 | 절연캡 | missing_object | 0.1 | 0.95 | 0.2 | 2.1 |
| memo_pressure_hold | 재기동 | 재기동 | current_decision | 0.5 | 0.1 | 0.6 | 2.4 |
| memo_flow_alarm | 해제 | 부족 | risk_state | 0.1 | 0.7 | 0.9 | 2.3 |
코드를 보기 전에, 같은 메모이어도 현재 토큰이 달라지면 어디에 weight가 몰릴지 먼저 예상해 보면 좋습니다.
| 현재 토큰 | baseline에서 생기기 쉬운 오해 | self-attention에서 먼저 예상할 변화 |
|---|---|---|
그것 | 메모 전체 평균만 보면 어느 안전 단서가 중요한지 굳이 안 갈라도 된다고 느끼기 쉽다 | 절연캡, 씌우지, 위험 쪽 단서에 비중이 더 실려야 한다 |
씌우지 | 같은 메모 안이니 그것과 비슷한 분포가 나올 것이라고 느끼기 쉽다 | 동작 맥락을 위해 분리, 절연캡, 씌우지 쪽 비중이 더 커질 수 있다 |
| 둘 다 | 문장마다 공통 attention 하나만 있다고 느끼기 쉽다 | 토큰마다 자기 입장에서 다시 읽는 대상이 달라져야 한다 |
입력(input):
위 CSV를 읽어 memo_cap_missing의 두 현재 토큰을 비교합니다.
출력에서는 먼저 csv_rows와 focus_document_rows를 보아 CSV 전체와 현재 비교 대상의 범위를 구분합니다. 그다음 각 현재 토큰의 weight, new_representation, representation_shift를 순서대로 보면 됩니다.
| 먼저 볼 출력 | 이 출력이 뜻하는 것 | 바꿔 보면 달라지는 것 |
|---|---|---|
weights에서 절연캡이 가장 크고 씌우지도 높다 | 현재 토큰 그것이 메모 안 단서를 균등하게 보지 않고 특정 안전 단서를 더 크게 다시 참고한다는 뜻 | CSV의 score를 바꾸면 어떤 단서가 현재 토큰 해석을 끌어가는지 바로 달라집니다 |
그것과 씌우지의 weights 분포가 같지 않다 | 같은 메모를 읽어도 현재 토큰마다 다시 참고하는 대상이 다르다는 뜻 | target_token을 바꾸면 어떤 위치가 top token이 되는지 바로 달라집니다 |
cap_plus_not_applied_weight = 0.644 | 단어 하나만이 아니라 관련 단서 묶음이 함께 해석을 끌어간다는 뜻 | 절연캡이나 씌우지 점수를 낮추면 위험 원인 해석이 어느 쪽으로 흔들리는지 볼 수 있습니다 |
representation_shift에서 두 번째 축이 크게 늘어난다 | attention 이후 현재 토큰 표현이 실제로 특정 문맥 방향으로 다시 이동했다는 뜻 | CSV의 evidence 축 값을 바꾸면 어떤 의미 축이 더 강조되는지 직접 비교할 수 있습니다 |
| 현재 토큰 | baseline만 보고 읽었을 때 나올 쉬운 판단 | self-attention 출력을 읽고 바뀌는 판단 |
|---|---|---|
그것 | 메모 전체가 한 덩어리라서 분리와 절연캡 미적용을 비슷하게 취급하기 쉽다 | 절연캡과 씌우지 쪽 비중이 높으므로, 위험 원인을 절연 캡 미적용 쪽으로 더 우선 확인해야 한다 |
씌우지 | 현재 동작만 보며 무언가 안 했다 정도로만 읽기 쉽다 | 분리, 절연캡, 씌우지를 함께 크게 참고하므로, 무엇에 무엇을 씌우지 않았는가라는 작업 맥락을 같이 복원해야 한다 |
즉, 숫자를 읽는 목적은 어느 weight가 제일 컸는가를 외우는 데 있지 않습니다. 같은 메모라도 현재 토큰이 달라질 때 무엇을 다시 확인해야 하는가가 실제로 갈라지는지 확인하는 데 있습니다.
- baseline 평균에서는
배터리팩,분리,절연캡,씌우지,그것,위험이 모두 같은 비중으로 섞여, 현재 토큰그것이 무엇을 가리키는지에 대한 강조가 없습니다. - 현재 토큰 표현은 자기 자신만으로 정해지지 않고, 메모 안 다른 토큰들을 다시 참고해 새로 계산됩니다.
- 이 예제에서는
그것이분리보다절연캡과씌우지쪽 단서를 훨씬 더 크게 참고하므로, 위험 원인 해석이절연 캡 미적용쪽으로 기웁니다. - 같은 메모이어도
씌우지를 현재 토큰으로 두면,분리와절연캡쪽 비중이 다시 커지며그것을 해석할 때와는 다른 분포가 나옵니다. 절연캡과씌우지의 합 비중이그것에서는 0.644,씌우지에서는 0.55라는 점은, self-attention이 단어 하나만 보는 것이 아니라 관련 단서 묶음을 함께 반영한다는 점을 보여 줍니다.representation_shift에서 두 번째 축 값이 크게 늘어난다는 점은, 현재 토큰 표현이절연캡/씌우지쪽 문맥으로 다시 당겨졌다는 직관을 줍니다.- 즉, self-attention은
지금 이 토큰을 이해하려면 문장 안 어디를 다시 봐야 하는가를 토큰별로 따로 수치화하는 방식으로 읽을 수 있습니다.
이 결과를 현장 메모 읽기로 바꾸면, 그것을 읽을 때는 무엇이 빠졌는가를 확인하는 쪽으로 시선이 모이고, 씌우지를 읽을 때는 무엇에 대해 그 동작이 적용되지 않았는가를 복원하는 쪽으로 시선이 모입니다. self-attention은 바로 이런 토큰별 재확인 경로 분리를 계산으로 만든다고 이해하면 됩니다.
이 예제도 결과를 한 번 읽고 넘어가기보다, 어떤 값을 바꿔 보면 재참조 감각이 더 선명해지는지 바로 이어서 확인하는 편이 좋습니다.
| 먼저 보인 출력 신호 | 지금 바로 해 볼 변화 | 아직 이 예제만으로 서두르지 않을 결론 |
|---|---|---|
절연캡 비중이 가장 크다 | CSV에서 분리나 배터리팩의 score를 높여 위험 원인 해석 중심이 어디로 이동하는지 본다 | attention 가중치가 크다고 해서 곧바로 완전한 의미 이해가 보장된다고 단정하지 않는다 |
cap_plus_not_applied_weight가 높다 | 씌우지 점수를 낮추거나 높여 단서 묶음이 얼마나 함께 움직이는지 본다 | 단서 둘이 함께 높다고 해서 항상 정답이 고정된다고 단정하지 않는다 |
representation_shift가 baseline에서 멀어진다 | CSV의 evidence_* 축 값을 바꿔 어떤 의미 축이 재계산에 더 민감한지 비교한다 | 이 간단한 벡터 비교 하나로 실제 multi-head self-attention 전체를 대체하지 않는다 |
즉, self-attention은 문맥을 보고 표현을 다시 계산하는 방식입니다.
이 예제를 현재 토큰 재해석 관점으로 다시 보면
앞의 숫자는 실제 대규모 self-attention 전체를 구현한 것은 아니지만, 비교 기준은 분명합니다.
- baseline 평균은
문장 전체 정보를 그냥 뭉뚱그려 섞은 표현에 가깝습니다. - self-attention 결과는
현재 토큰 그것이 지금 누구를 더 참고해야 하는가를 다시 계산한 표현에 가깝습니다. - 그래서 독자가 실제로 구분해야 하는 것도
문장 전체를 봤는가자체가 아니라,현재 토큰마다 재확인 우선순위가 다르게 계산됐는가입니다.
즉, self-attention은 단순히 문장 전체를 보는 기능이 아니라, 각 토큰이 자기 입장에서 문장 전체를 다시 읽고 새 표현을 만드는 계산입니다. 이 감각이 잡혀야 다음 절 P5-13.3의 QKV와 multi-head attention도 무슨 이름을 외우는 절이 아니라 이 재참조 계산을 더 구조적으로 설명하는 절로 읽을 수 있습니다.
self-attention에서 확인해야 할 전환은 attention이 번역의 보조 장치에 머무르지 않고, sequence modeling의 중심 계산 방식으로 이동했다는 점입니다. 이 절에서 독자가 남겨야 할 결론도 간단합니다. self-attention은 문장 전체를 한 번 본다가 아니라 현재 토큰마다 다시 참고할 위치를 계산해 자기 표현을 새로 만든다는 구조입니다. 다음 장 P5-14.1에서는 이 계산이 Transformer 블록의 기본 단위로 어떻게 묶이는지를 이어서 설명합니다.
체크리스트
- 셀프 어텐션(self-attention)이 같은 시퀀스 안 토큰들이 서로를 참고하는 방식이라는 점을 설명할 수 있는가?
- 순차 상태 전달과 관계 재계산 방식의 차이를 말할 수 있는가?
- self-attention을
문장 전체를 본다정도로만 말하지 않고,각 토큰이 같은 시퀀스 안 다른 토큰을 다시 참고해 자기 표현을 갱신한다로 설명할 수 있는가? - 먼 위치 단서를 다시 참조하면서도 토큰 계산을 병렬로 처리할 수 있다는 점에서 RNN과 다른 장점을 설명할 수 있는가?
- 같은 문장이라도 현재 토큰이
그것인지씌우지인지에 따라 다시 참고하는 단서와 판단 우선순위가 달라진다는 점을 예제로 설명할 수 있는가? - 순차 전달보다 토큰 간 관계 재계산이 더 중요해 보일 때, self-attention 관점을 먼저 떠올릴 수 있는가?
- 다음 장의 Transformer를 읽을 때도 먼저
self-attention이 왜 블록 중심 계산이 되었는가를 떠올릴 준비가 되어 있는가?
출처와 참고 자료
- Ashish Vaswani et al.,
Attention Is All You Need, NeurIPS 2017, 확인 날짜: 2026-07-19. https://papers.nips.cc/paper/2017/hash/3f5ee243547dee91fbd053c1c4a845aa-Abstract.html - Dzmitry Bahdanau, Kyunghyun Cho, Yoshua Bengio,
Neural Machine Translation by Jointly Learning to Align and Translate, ICLR 2015, 확인 날짜: 2026-07-19. https://arxiv.org/abs/1409.0473 - Ian Goodfellow, Yoshua Bengio, Aaron Courville,
Deep Learning, MIT Press, 2016, 확인 날짜: 2026-06-29. https://www.deeplearningbook.org/