P7-5.1 공통 T2I 프롬프트로 화풍 데이터 축적하기
Section ID:
P7-5.1Version:v2026.09.13
이 프로젝트는 Qwen Image의 text-to-image(T2I) 생성에서 공통 화풍 프롬프트 계약을 모든 행에 재사용하고, 장면별 장소·시간·카메라만 바꾸어 배경 화풍 데이터를 축적합니다. 화풍 참조 셋은 보기 좋은 배경을 모은 폴더가 아닙니다. 선의 역할, 색의 겹침, 시간대의 광원, 장소의 폭, 카메라 구도를 같은 기준으로 비교할 수 있게 만든 관찰 입력입니다. 한 장이 마음에 들어도 다른 장소와 카메라에서 같은 특성이 반복되는지는 별도로 기록합니다.
이 절의 질문은 공통 T2I 화풍 프롬프트를 유지한 채 장면 변수를 바꾸어, 비교 가능한 화풍 데이터를 어떻게 축적하는가입니다. 이 절의 산출물은 화풍 계약, 장면별 T2I 원본, 행별 관찰 기록입니다.
웹툰 컷 생성 전체를 한 번에 해결하려고 하지 않습니다. 이 절은 배경의 선·색·광원·카메라 계약을 먼저 만들고 검수하는 데 한정합니다. 한 단계의 출력이 다음 단계에서 쓰이려면, 생성된 이미지가 마음에 드는지를 넘어서 어떤 조건을 관찰했는지 기록되어야 합니다.
화풍 참조 셋은 생성과 검수가 번갈아 가는 파이프라인이다
화풍 생성은 프롬프트 한 번으로 끝나지 않습니다. 먼저 어떤 선과 색을 유지할지 계약을 고정하고, 그 계약이 장소·시간·카메라가 달라져도 남는지 확인할 장면 행렬을 만듭니다. 각 행의 원본을 생성한 뒤 사람은 프레임, 선, 색, 장소, 시간, 카메라를 함께 관찰합니다. 기대와 다른 점은 crop이나 상태 변경으로 덮지 않고, 다음 프롬프트의 장면 구조를 바꾼 비교 기록으로 남깁니다.
flowchart TD
  contract["1. 화풍 계약 고정<br/>외곽 · 선 · 색 · 공간 · 카메라"]
  matrix["2. 장면 행렬 구성<br/>스무 장면 행"]
  generate["3. 행별 원본 생성<br/>프레임 없는 전체 캔버스"]
  review["4. 사람 관찰 기록<br/>외곽 · 선 · 색 · 장소 · 시간 · 카메라"]
  repair["관찰한 이탈을 장면 구조로 바꿔<br/>해당 행을 다시 생성"]
  coverage["5. 스무 행의 공통점과 이탈을<br/>비교 기록으로 정리"]
  originals["6. 원본 표 확인<br/>파일명·scene ID·관찰 범위"]

  contract --> matrix --> generate --> review
  review --> coverage
  coverage --> repair --> generate
  coverage --> originals
이 흐름에서 모델은 배경 후보를 먼저 만들고, 사람은 후보에서 계약의 일치와 이탈을 기록합니다. 행별 기록과 스무 행의 비교는 다음 입력을 자동으로 허용하거나 차단하는 상태가 아닙니다. 타일로 합친 비교 이미지는 모델 입력으로 쓰지 않습니다.
| 파이프라인 층 | 고정하거나 바꾸는 것 | 다음 단계로 남기는 것 |
|---|---|---|
| 화풍 계약 | 선·수채화 색층·프레임 금지 조건 | 관찰할 공통 특징 |
| 장면 행렬 | 장소·시간·카메라 조합 | 스무 장면 행 목록 |
| 행별 생성 | seed와 장면의 구체 구성 | crop하지 않은 후보 원본 |
| 사람 관찰 | 외곽·선·색·장소·시간·카메라 기록 | 일치·이탈과 다음 비교 질문 |
| 원본 표 | 행 사이의 일관성과 관찰 범위 | 원본 파일명·장면 식별자와 관찰 범위 |
화풍은 팔레트 하나로 고정되지 않는다
같은 청록색과 주황빛을 쓴다고 같은 웹툰 화풍이 되지는 않습니다. 선이 명암을 대신하는지, 수채화 색면 아래에 남는지, 실내의 인공광과 실외의 자연광에서 색의 대비가 어떻게 달라지는지, 높은 시점과 낮은 시점에서 원근선이 어떻게 놓이는지가 함께 반복되어야 합니다.
이 실습의 수채화 계약은 얇은 charcoal 윤곽선과 건축 구조선을 남기고, 그 아래에 기존보다 한 단계 높은 안료 농도의 투명 색면을 겹치는 것입니다. 채도는 시간대와 무관하게 같은 warm apricot으로 고정하지 않습니다. 낮에는 clear teal·leaf green·cool off-white가 주가 되고, 석양에서만 apricot 역광을 제한적으로 씁니다. 밤과 우천 야간은 indigo·navy 그림자와 작은 tungsten 반사광으로 읽혀야 하며, 하늘을 붉게 물들여 석양처럼 만들지 않습니다. 형광색·neon·불투명 airbrush로 바꾸지 않습니다. 색은 wet-on-wet 번짐, 불규칙한 안료 고임, 반투명 색층으로 남아야 합니다. 해칭, crosshatching, 점묘, 검은 먹 번짐은 드로잉 라인이 아니라 명암을 채우는 질감으로 판단해 제외합니다. 수채화는 선을 흐리게 만드는 필터가 아니라 선이 구획한 면에 겹쳐지는 색층입니다. 따라서 수채화처럼 보인다는 인상만으로는 충분한 관찰 기록이 되지 않습니다. 외곽, 선, 색, 공간, 카메라를 각각 확인해야 합니다.
| 확인 축 | 관찰할 특징 | 이탈 신호 |
|---|---|---|
| 외곽 | 생성 원본이 프레임 없이 캔버스를 채움 | page border, panel frame, 사후 crop 필요 |
| 선 | 윤곽·구조·원근선이 읽힘 | 선이 색 번짐에 묻힘, 명암 해칭이 화면을 지배함 |
| 색 | 한 단계 높은 자연 채도의 반투명 수채화 색층과 시간대별 광원이 함께 보임 | 모든 시간대를 석양색으로 통일함, 단색 먹 질감, 불투명 airbrush, neon, 번짐 없는 평면 도색 |
| 공간 | 실내와 실외가 모두 있음 | 한 장소 유형의 반복 |
| 카메라 | high angle, low angle, wide eye-level, oblique side, overhead high angle이 실제로 다름 | 세로 중앙 소실점·아이레벨 구도 반복 |
다섯 행이 있어야 한 장의 우연을 구별할 수 있다
한 장면에서 seed만 바꾸면 다른 장소와 카메라를 다뤘다고 볼 수 없습니다. 다음 다섯 행은 같은 장면의 변형이 아니라, 장소·시간·카메라가 모두 다른 최소 검수 집합입니다. 새벽의 실내 고각도와 우천 야간의 overhead high angle은 빛과 원근을 동시에 시험하므로, 낮의 거리 한 장으로 대신할 수 없습니다.
| scene ID | 장소 | 시간 | 카메라 |
|---|---|---|---|
indoor-dawn-high-angle | 실내 | 새벽 | high angle |
indoor-night-oblique | 실내 | 밤 | oblique side view |
outdoor-day-wide | 실외 | 낮 | wide eye-level |
outdoor-sunset-low-angle | 실외 | 해질녘 | low angle |
outdoor-rainy-night-overhead | 실외 | 우천 야간 | overhead high angle |
각 행에는 사람·동물·차량·읽을 수 있는 표지·글자를 넣지 않습니다. 화풍 팩은 배경의 매체 처리와 공간 조건만 관찰하는 자산입니다. 프롬프트에는 no border frame, no panel, fill the canvas edge to edge를 함께 쓰되, 이 단어가 있다고 결과 특성을 단정하지 않습니다. 출력 원본에서 프레임이 보이면 그 이미지는 crop으로 살리지 않고, 프레임 이탈을 포함한 다음 비교 조건을 기록합니다.
AI 모델은 텍스트 조건과 seed에서 후보 원본을 만든다
후보 한 장은 장면 prompt와 공통 화풍 계약, seed, 해상도, 반복 횟수를 함께 받아 만들어집니다. Qwen Image 구성 요소를 torch_dtype=torch.bfloat16으로 읽고 Nunchaku transformer offload 및 enable_sequential_cpu_offload()를 켜는 일은 모델 내부 추론 단계가 아니라 실행 준비에 가깝습니다. 준비가 끝난 뒤 QwenImagePipeline은 장면 prompt와 공통 화풍 계약을 조건으로 바꾸고, seed에서 시작한 이미지 표현을 정해진 횟수만큼 갱신합니다. 이 단계의 목적은 다른 모델에 일반화되는 배경 화풍을 찾는 것이 아니라 Qwen Image가 이 계약을 어느 정도 따르는지 관찰하는 것입니다. 기본 STEPS=30과 true_cfg_scale=4.0은 이번 후보 생성의 실행 설정이며, 이 숫자 자체가 화풍 특성의 판정값은 아닙니다.
도식의 입력 조건 구역은 값을 텍스트 입력, 이미지 출발 조건, 추론 설정 세 묶음으로 정리합니다. 아래 표는 같은 값을 코드 위치와 검수 의미로 더 풀어 쓴 것입니다. 이렇게 보면 어떤 값이 텍스트 조건을 만들고 어떤 값이 latent 출발점과 반복 갱신 조건을 바꾸는지 구별할 수 있습니다.
| 입력 조건 | 코드에서 오는 곳 | 파이프라인에서 쓰이는 곳 | 검수할 때의 의미 |
|---|---|---|---|
| scene 행 | SCENES의 prompt, seed | pipe(...)에 넘길 prompt와 초기 latent | 장소·시간·카메라와 같은 행별 비교 조건 |
| 공통 화풍 계약 | 화풍 프롬프트 JSON의 common_contract | pipe(...)에 넘길 prompt | 모든 행에서 유지해야 할 선·수채화·프레임 금지 조건 |
| 해상도 | 기본 1024×1024, 또는 --width, --height | latent 크기와 VAE 출력 | 실행별 JSON에 함께 남기는 후보 원본 형식 |
| 추론 반복 | num_inference_steps=30 기본값 | scheduler의 timesteps와 transformer 반복 | 생성 조건이지 품질 점수는 아님 |
| 텍스트 유도 | true_cfg_scale=4.0, negative_prompt=" " | classifier-free guidance 계산에 쓰이는 조건 | 값 자체가 화풍 특성의 판정값은 아님 |
| seed 생성기 | torch.Generator(device="cpu").manual_seed(...) | 초기 latent 출발점 | 비교 기록이며 픽셀 동일성 보장은 아님 |
flowchart TD
  subgraph input["입력 조건"]
    direction TB
    prompt_input["텍스트 입력<br/>scene prompt + COMMON_CONTRACT"]
    latent_input["이미지 출발 조건<br/>CPU seed · 실행별 해상도"]
    run_input["추론 설정<br/>기본 30 steps · true CFG 4.0"]
    input_bundle["pipe 호출 입력"]
  end

  subgraph prepare["실행 준비"]
    direction TB
    weights["가중치 로드<br/>Qwen Image · bfloat16"]
    offload["Nunchaku transformer + sequential CPU offload<br/>GPU 상주량을 줄임"]
    ready["실행 준비 완료"]
  end

  subgraph pipeline["Diffusers QwenImagePipeline"]
    direction TB
    apply_input["pipe 입력 분배<br/>prompt · generator · size · steps · guidance"]
    text["Qwen tokenizer + text encoder<br/>token IDs → text embeddings"]
    latent["초기 latent 준비<br/>CPU seed noise · 해상도 비율 반영"]
    schedule["FlowMatch scheduler<br/>timesteps 준비"]
    transformer["Qwen Image transformer<br/>embeddings · timestep · true CFG · latent로 갱신"]
    decode["VAE decode<br/>latent tensor → RGB 픽셀 이미지"]
  end

  subgraph result["산출과 검수"]
    direction TB
    output["PNG 저장<br/>scene ID · run label"]
    review["사람 검수와 ledger<br/>프레임 · 선 · 색 · 장소 · 시간 · 카메라"]
    originals["원본 표<br/>파일명·scene ID"]
  end

  prompt_input --> input_bundle
  latent_input --> input_bundle
  run_input --> input_bundle

  weights --> offload --> ready
  ready -.메모리 운용.-> apply_input

  input_bundle --> apply_input
  apply_input --> text
  apply_input --> latent
  apply_input --> schedule
  text --> transformer
  latent --> transformer
  schedule --> transformer
  transformer -->|기본 30 steps| transformer
  transformer --> decode --> output --> review --> originals
QwenImagePipeline 안에서는 먼저 입력이 prompt, generator, size, step, true CFG로 나뉩니다. tokenizer와 text encoder는 prompt를 token ID와 text embedding 같은 조건 표현으로 만들고, CPU seed에서 출발한 noise는 해상도에 맞는 초기 latent가 됩니다. scheduler와 transformer는 조건 표현과 timestep을 보며 latent를 반복 갱신하고, VAE는 이를 RGB 픽셀 이미지로 되돌립니다. offload는 이 내부 단계를 바꾸는 알고리즘이 아니라 GPU 상주량을 줄이는 메모리 운용입니다. prompt, seed, step, guidance는 생성 조건이고, 프레임 없음·선화 유지·시간대 광원·camera 충족은 생성 뒤 검수 조건입니다.
| 모델 파이프라인 단계 | 이 절에서 맡는 역할 | 관찰 기록과의 관계 |
|---|---|---|
| prompt와 공통 계약 | 장소·시간·카메라와 금지 조건을 한 텍스트 입력으로 묶음 | 금지 문구가 있어도 결과 보장은 아님 |
| tokenizer와 text encoder | 텍스트를 모델이 쓰는 조건 표현으로 바꿈 | 조건 해석의 시작점이지 사람 판정을 대체하지 않음 |
| seed와 latent | 같은 실행 조건의 출발점을 기록함 | 다른 환경에서 픽셀 동일성을 보장하지 않음 |
| scheduler와 transformer 반복 | timestep과 조건 표현을 보며 이미지 표현을 단계적으로 갱신함 | 반복 수와 guidance는 품질 점수가 아님 |
| VAE decode와 PNG 저장 | latent를 이미지로 바꾸고 원본 파일로 남김 | 파일 생성은 관찰할 원본을 남김 |
| 사람 관찰과 기록 | 외곽·선·색·장소·시간·카메라를 기록함 | 입력 역할과 알려진 이탈을 남김 |
COMMON_CONTRACT와 장면별 prompt는 하나의 positive prompt로 이어 붙여 전달되고, 빈 문자열이 아닌 공백인 negative_prompt=" "를 함께 넘깁니다. 따라서 no panel 같은 금지 문구는 원하는 결과를 보장하는 규칙이 아니라 다른 장면 설명과 함께 해석되는 조건입니다. seed는 같은 실행 조건의 출발점을 기록하지만, 다른 GPU·라이브러리·모델 버전에서도 픽셀까지 같은 결과를 보장하지는 않습니다.
Qwen Image도 조건 검수가 필요하다
Qwen Image는 text-to-image와 이미지 편집을 지원하는 이미지 생성 모델이며, 공개 모델 카드는 Apache 2.0 라이선스와 QwenImagePipeline 사용 예시를 제공합니다. 이 실험은 Diffusers의 QwenImagePipeline에 Nunchaku FP4 r128 transformer를 연결해 로컬 GPU에서 후보를 만듭니다.
로컬에서 이미지가 생성된다고 해서 웹툰 컷 파이프라인이 안정적이라는 뜻은 아닙니다. 이 실행은 Nunchaku transformer offload와 enable_sequential_cpu_offload()로 GPU 상주량을 줄이고 한 행씩 생성합니다. 따라서 P7-5.1은 모델이 좋은 배경 이미지를 만들 수 있는지 보는 절이 아니라, 다음 단계에서 각 원본을 어떤 화풍 참조로 읽을지 사람이 기록하는 절입니다.
| 구분 | 이 실험에서 유리한 점 | 조심할 점 |
|---|---|---|
| 실행 구성 | Qwen Image와 양자화 transformer로 로컬 후보를 반복 생성할 수 있음 | offload와 양자화가 화풍·구도 특성을 보장하지 않음 |
| 기능 범위 | text-to-image와 이미지 편집 흐름을 시험할 수 있음 | 기능 지원이 곧 화풍 계약의 반복 관찰을 뜻하지 않음 |
| 공개 가중치 | Apache 2.0 공개 가중치라 실험 조건과 산출물을 기록하기 좋음 | 모델 출력은 prompt를 놓치거나 왜곡할 수 있어 사람 검수 ledger가 필요함 |
| 빠른 후보 생성 | 여러 장면 후보를 반복해 만들 수 있음 | 빠른 생성은 화풍 특성의 근거가 아니며, 이탈은 다음 prompt 구조 비교로 옮김 |
실행 코드는 공통 계약과 장면 변수를 분리한다
배경 후보 생성에는 Diffusers의 QwenImagePipeline을 사용합니다. 스무 장면 후보를 만드는 기준 실행 코드는 p7_5_1_regenerate_local_gpu_style_references.py입니다. 학습 관점에서 이 코드는 세 가지를 구분하게 해 줍니다. 첫째, 모든 행에 같은 화풍 계약을 붙입니다. 둘째, 행마다 장소·시간·카메라·seed만 바꿉니다. 셋째, 생성 기록과 사람의 관찰 기록을 별도로 남깁니다.
공통 화풍 계약은 화풍 프롬프트 JSON에 분리한다. 이 자산에는 프레임 없는 캔버스, 얇은 charcoal 선, 반투명 수채화 색층, 안료 질감, 제외 대상만 들어 있다. 장소·시간·카메라는 실행 코드의 장면별 prompt가 맡으므로, 한 행의 공간 문제를 고칠 때 공통 화풍 계약을 함께 바꾸지 않는다.
현재 background-style-v3 계약은 같은 핵심 조건을 47단어에서 30단어로 압축했다. 1~20번 참조 원본은 이 v3 계약으로 재생성했다. 계약을 바꾸면 기존 원본의 역할을 소급해 바꾸지 않고, 새 후보와 관찰 기록을 별도로 남긴다.
| 코드 위치 | 바꾸면 달라지는 것 | 학습할 경계 |
|---|---|---|
화풍 프롬프트 JSON의 common_contract | 스무 장면 전체의 선·수채화·프레임 금지 기준 | 공통 계약을 바꾸면 이전 행과 직접 비교하기 어려움 |
SCENES의 prompt | 한 행의 장소·시간·카메라 구조 | 실패 원인은 금지어보다 장면 구조로 고침 |
SCENES의 seed | 같은 조건의 다른 출발점 | seed 고정은 비교 기록이지 품질 보장이 아님 |
--scene, --exclude | 생성할 행의 범위 | 한 행 생성은 전체 팩의 관찰 범위를 대신하지 않음 |
STEPS, TRUE_CFG_SCALE, 해상도 | 추론 조건 전체 | 값을 바꾸면 별도 비교 실험으로 기록함 |
| 터미널 실행 요약 | 시간·GPU 메모리·출력 파일 | 후보 생성 기록과 사람 관찰을 분리함 |
공통 계약의 원문에는 common_contract(모델에 전달할 짧은 조건), fixed_checks(사람이 결과에서 확인할 항목), assembly_rule(한 장면 prompt와 계약을 결합하는 규칙)을 둡니다. 본문에서는 세 필드의 역할을 먼저 읽고, 필요할 때만 아래 패널에서 전문을 확인합니다.
P7-5.1의 참조 원본은 로컬 GPU로 생성한 것만 사용하며, 내장 이미지 생성으로 만든 자산은 이 절의 원본 표에 넣지 않습니다.
실행 환경과 장면 선택
저장소 루트에서 Bash로 실행합니다. .venv에는 CUDA를 사용할 수 있는 PyTorch와 Diffusers, Hugging Face Hub, Nunchaku가 설치되어 있어야 하며, nvidia-smi로 GPU 메모리를 조회할 수 있어야 합니다. 모델은 Qwen/Qwen-Image와 nunchaku-tech/nunchaku-qwen-image의 svdq-fp4_r128-qwen-image.safetensors를 사용합니다. 두 모델을 저장소의 .tmp/download/huggingface/hub 캐시에 미리 준비해야 합니다. 코드는 local_files_only=True로 읽으므로 실행 중 누락된 모델을 다운로드하지 않습니다.
스크립트와 같은 폴더의 화풍 계약 JSON 및 p7_5_image_output_naming.py도 필요합니다. 실행 조건은 명령행 옵션으로 전달합니다. 기본값은 30스텝·1024×1024이므로 일반 실행에서는 스텝과 해상도를 생략합니다. 다음 명령은 downtown-clear-day-wide 장면 한 장을 생성합니다.
--scene은 코드의 SCENES에 있는 장면 ID를 선택합니다. 위 장면은 seed 420703을 사용하며, seed를 바꾸려면 해당 장면의 seed를 수정합니다. --scene을 생략하면 전체 20개 장면을 순서대로 생성합니다.
| 옵션 | 기본값 | 변경할 내용 |
|---|---|---|
--scene | 전체 장면 | 지정한 장면 하나만 생성 |
--exclude | 제외 없음 | 공백으로 나열한 장면 ID를 제외 |
--no-include-existing | 기존 장면 포함 | 단일 장면을 지정하지 않았을 때 generate_by_default=True인 장면만 선택 |
--run-label | v1 | 출력 파일에 붙일 실행 이름 |
--steps | 30 | 생성 스텝 수. 양의 정수 사용 |
--width, --height | 각각 1024 | 출력 너비·높이. 양수이며 16의 배수 사용 |
예를 들어 --exclude downtown-clear-day-wide park-clear-day-eye-level은 두 장면을 제외합니다. 해상도나 스텝을 비교할 때만 --steps 20 --width 1024 --height 1536처럼 기본값을 바꿉니다. true CFG는 코드의 TRUE_CFG_SCALE=4.0을 사용합니다. 실행 이름에는 영문자·숫자·밑줄·하이픈을 쓸 수 있습니다.
사용 가능한 옵션은 다음 명령으로 확인합니다. --help는 모델을 불러오거나 이미지를 생성하지 않습니다.
앞의 단일 장면·전체 장면 명령은 실제 GPU 생성을 시작하며, --dry-run 기능은 없습니다. 결과 PNG와 장면별 -result.json은 docs/assets/part-07/chapter-05/sec-01/에 저장됩니다. 파일명에는 실행 이름과 실행마다 새로 만드는 코드, seed, 스텝 수가 붙습니다. 모든 장면이 끝나면 터미널에 실행 시간·GPU 메모리·출력 파일 목록을 담은 JSON 요약이 표시됩니다. 장면별 JSON에서는 prompt, seed, size, steps와 출력 경로를 확인합니다. 비교 실행에는 --run-label practice-one-v2처럼 구분되는 이름을 사용합니다.
공통 화풍 계약과 장면 조건이 만나는 코드
아래는 실행 파일에서 가져온 핵심 발췌입니다. 긴 영어 prompt를 그대로 반복하지 않고, 독자가 모든 행에 유지할 조건과 한 행에서만 바꿀 조건의 경계를 읽도록 축약했습니다. 실제 실행 때는 바로 위의 전체 소스를 기준으로 합니다.
여기서 COMMON_CONTRACT를 바꾸면 스무 행 전체의 비교 기준이 달라집니다. 반대로 SCENES의 한 prompt를 바꾸면 그 행의 장소·시간·카메라만 재생성합니다.
다음 발췌는 한 행을 실제로 만드는 부분입니다. --scene을 바꾸면 scenes에 남는 행 수가 바뀌고, --run-label v2처럼 실행 이름을 바꾸면 기존 PNG와 구분되는 새 파일로 남깁니다.
이 코드 블록에서 파이프라인 분절은 모델 구조를 새로 나누는 일이 아니라, 한 번에 GPU에 상주하는 것을 줄이는 실행 분절입니다. from_pretrained(...)는 Qwen Image 구성 요소를 준비하고, transformer의 Nunchaku offload와 enable_sequential_cpu_offload()는 실행 순서에 맞춰 GPU 상주량을 줄입니다. 이 설정은 메모리 운용일 뿐 화풍 품질을 높이는 설정이 아닙니다.
for scene in scenes:는 이 절의 두 번째 분절입니다. 스무 장면을 하나의 큰 batch로 묶지 않고, 한 행의 prompt와 seed로 한 장을 만들고 저장한 뒤 다음 행으로 넘어갑니다. 실패한 행만 --scene으로 다시 생성할 수 있으며, 코드 원문은 행이 끝날 때 torch.cuda.empty_cache()로 다음 장면을 위한 캐시 반환을 요청합니다. 비교 실행에서는 --run-label을 새 값으로 지정해 기존 결과와 경로가 겹치지 않게 합니다.
따라서 pipe(...) 호출 안의 width, height, num_inference_steps, true_cfg_scale, seed는 후보를 만드는 추론 조건이고, offload와 행별 반복은 그 추론을 나누는 운영 조건입니다. 기본값 STEPS=30은 이번 후보 생성의 기본 운용점입니다. 이 블록의 image.save(...)가 성공했다는 사실은 후보 PNG가 생겼다는 뜻뿐입니다. 외곽선·수채화 질감·공간의 물리성·장면 조건은 다음의 사람 관찰 기록에서 확인합니다.
하나의 스크립트로 1~20번 후보와 관찰 기록을 만든다
p7_5_1_regenerate_local_gpu_style_references.py는 SCENES에 정의한 스무 행을 한 실행 목록으로 읽습니다. 모든 행은 같은 모델·화풍 계약·해상도·30스텝·true_cfg_scale을 공유하고, 장소·시간·카메라·seed만 행마다 바뀝니다. 기본 실행은 이 스무 행을 차례로 생성하고, 각 PNG 옆에 같은 stem의 -result.json을 저장합니다. result JSON에는 장면 식별자, prompt, seed, 해상도, step, true_cfg_scale, 모델·transformer, 출력 PNG와 생성 시간을 남깁니다. 터미널에는 실행 전체의 GPU 메모리 요약과 결과 목록을 출력합니다. 따라서 1~20번은 서로 다른 생성 방법의 결과가 아니라, 하나의 스크립트에서 조건 행만 바꿔 만든 비교 집합입니다.
아트리움 한 행을 1024×1024, seed 420713, 102단어 prompt로 비교했을 때 4·10·20·30·40·50스텝 후보를 만들었습니다. 20스텝부터 선과 색층의 기본 형태는 읽을 수 있었지만, 30스텝을 스무 행 공통의 기본값으로 두었습니다. 30스텝 아트리움 후보의 행 생성 시간은 99.8초였고, 전체 실행의 GPU 메모리 peak은 5,467 MiB였습니다. 이 결과는 한 장면·한 해상도에서의 운용 기록이지 모든 장면의 필요 스텝이나 품질 보장은 아닙니다.
사람은 스무 행의 장소·시간·카메라 변화에서 화풍 계약의 일치와 이탈을 함께 기록합니다. 각 행의 세부 조건과 이미지 자체는 아래의 스무 원본 표에서 한 번만 확인합니다. 재현 비용을 늘린 40·50스텝 후보는 보관하지 않습니다.
실패 원인을 다음 프롬프트의 구조로 바꾸기
실패한 후보에 no frame이나 no hatching을 더 쓰는 것만으로는 충분하지 않았습니다. 도심은 넓은 도로를 요청했을 때 중앙 소실점의 거리 복도로 수렴했습니다. 이를 고치기 위해 금지어를 늘리는 대신, 가까운 모퉁이에서 옆으로 건너다보는 측면 교차로로 장면 구조를 바꿨습니다. 복잡한 실내 좌석 배치는 요구가 길어질수록 공간 구조를 안정적으로 제어하지 못해 이 참조 팩의 범위에서 폐기했습니다. 대체 장면은 필요한 시간·카메라 조건을 더 단순한 구조로 검증해야 합니다.
반대로 장가계는 외곽 프레임은 사라졌지만 절벽의 반복 선이 해칭처럼 남았고, 우천 야간 플랫폼은 비·레일·지붕 선이 화면을 지배했습니다. 이 경우에는 crop이나 부분 보정으로 이탈을 감추지 않습니다. 무엇이 달랐는가를 다음 생성의 구도·피사체 밀도·광원 조건으로 번역하고, 새 원본과 관찰 기록을 남깁니다.
사람 관찰 기록과 원본 표를 분리한다
사람이 기록하는 것은 이미지의 미적 품질 점수 하나가 아닙니다. 각 원본에서 외곽·선·색·장소·시간·카메라와 로컬 GPU 생성 기록을 확인하고, 행별 일치·이탈과 다음 비교 질문을 로컬 관찰 기록에 적습니다. 다음 단계에서 사용할 원본은 아래 표의 파일명과 장면 식별자를 보고 작업 목적에 맞게 고릅니다. 별도 목록 파일이 다음 입력을 고정하지 않으므로, 무엇을 관찰했는가와 무엇을 다음 생성에 쓸 것인가를 혼동하지 않습니다.
1~20번 행은 Qwen Image 30스텝으로 만든 로컬 GPU 원본입니다. 이 원본들은 배경 화풍 계약을 비교하기 위한 관찰 대상이며, 내장 이미지 생성 원본은 섞지 않습니다.
1~20번 로컬 GPU 참조 원본을 한 번에 확인한다
아래 표는 위 스크립트의 SCENES 순서대로 1번부터 20번까지 정리한 로컬 GPU 원본입니다. 모든 이미지는 Qwen Image 30스텝 실행 결과이며, 이미지 파일명과 scene_id가 각 원본의 생성 조건을 연결합니다.
| 1 · 실내 아트리움 · 새벽 · high angle | 2 · courtyard · 이른 아침 · high angle | 3 · 도심 · 낮 · wide eye-level | 4 · 주택가 · 해질녘 · low angle |
|---|---|---|---|
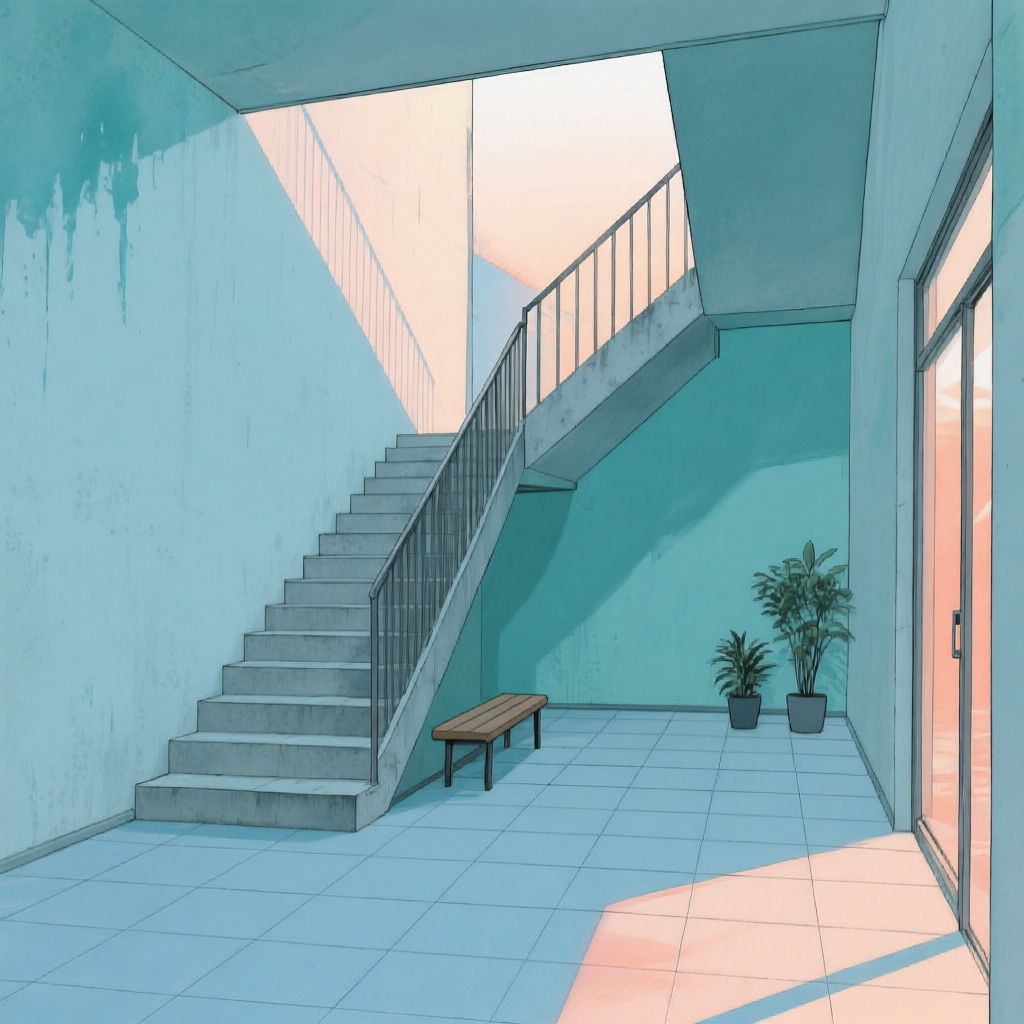 | 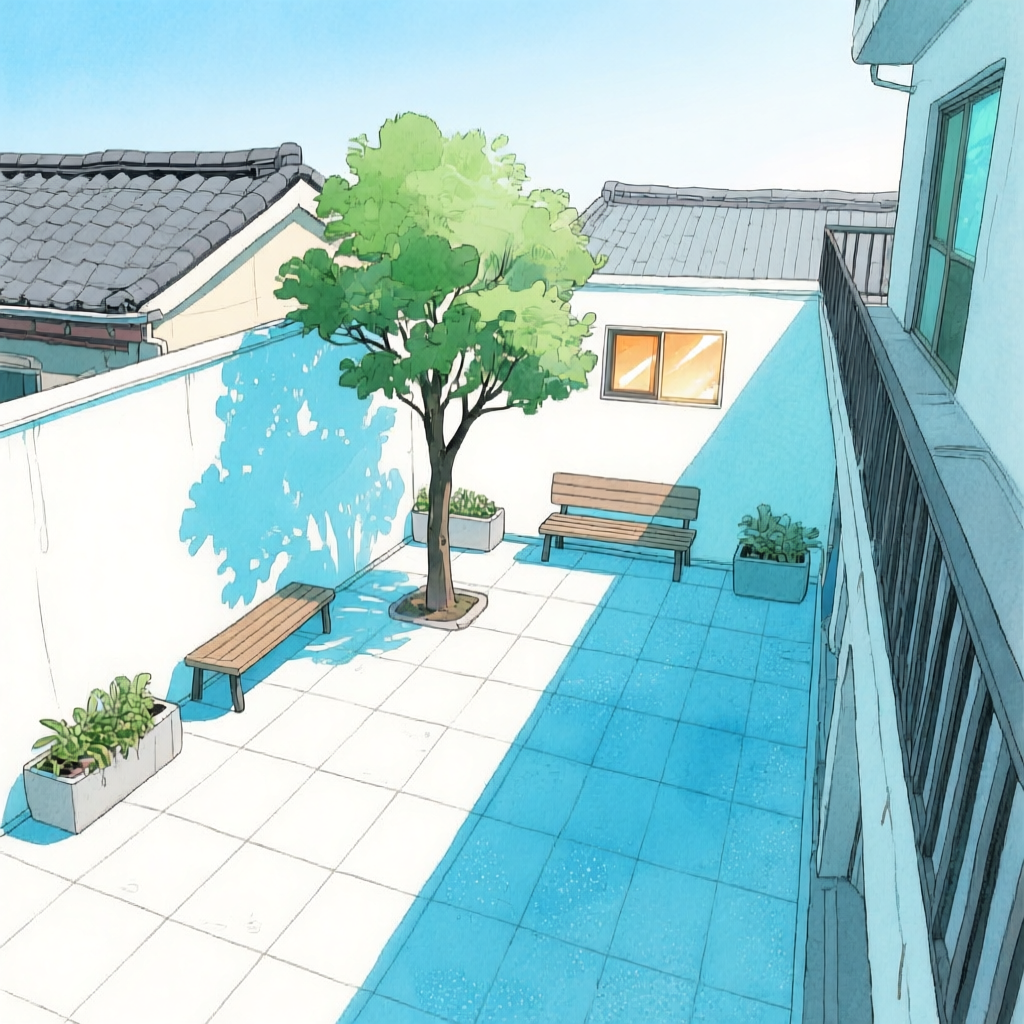 | 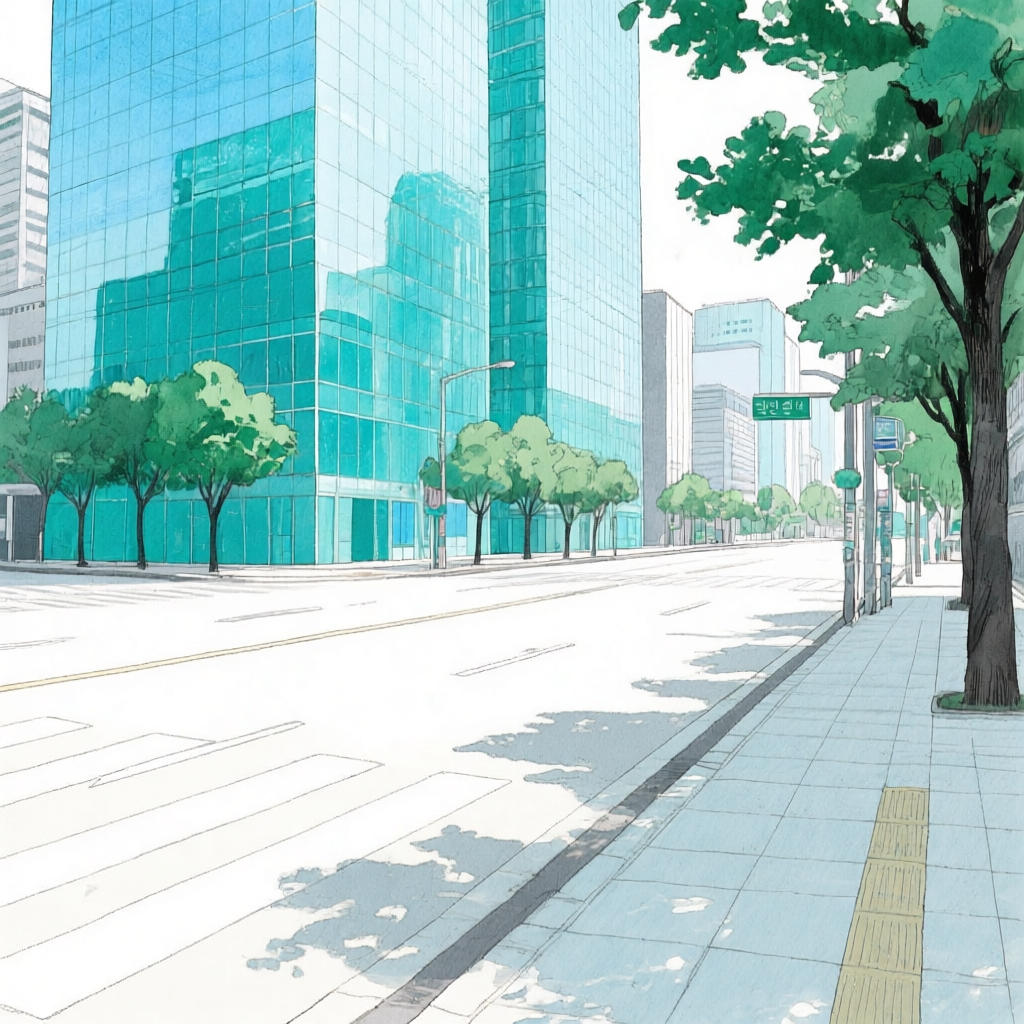 | 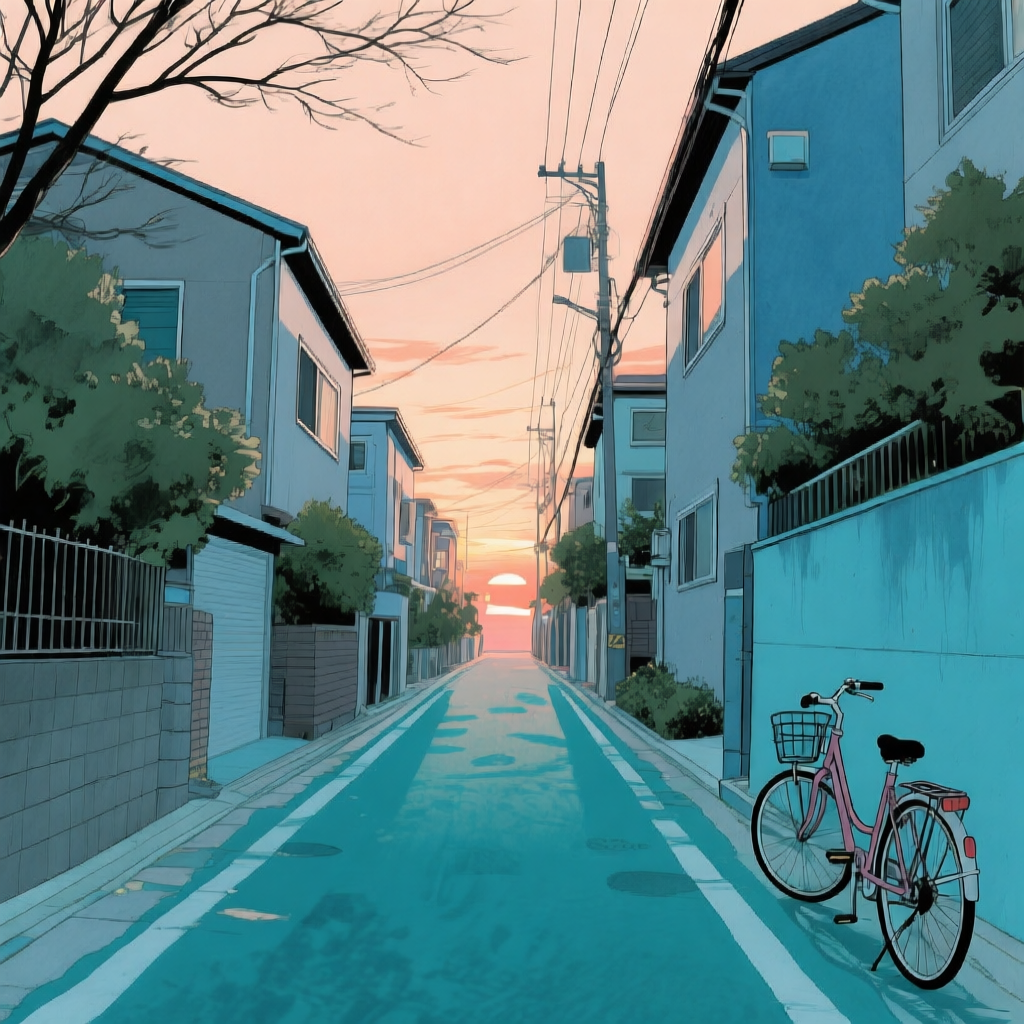 |
| 5 · 독서실 · 밤 · oblique | 6 · 옥상 광장 · 우천 야간 · overhead high angle | 7 · 베니스 운하 · 해질녘 · oblique | 8 · 공원 연못 · 낮 · eye-level |
|---|---|---|---|
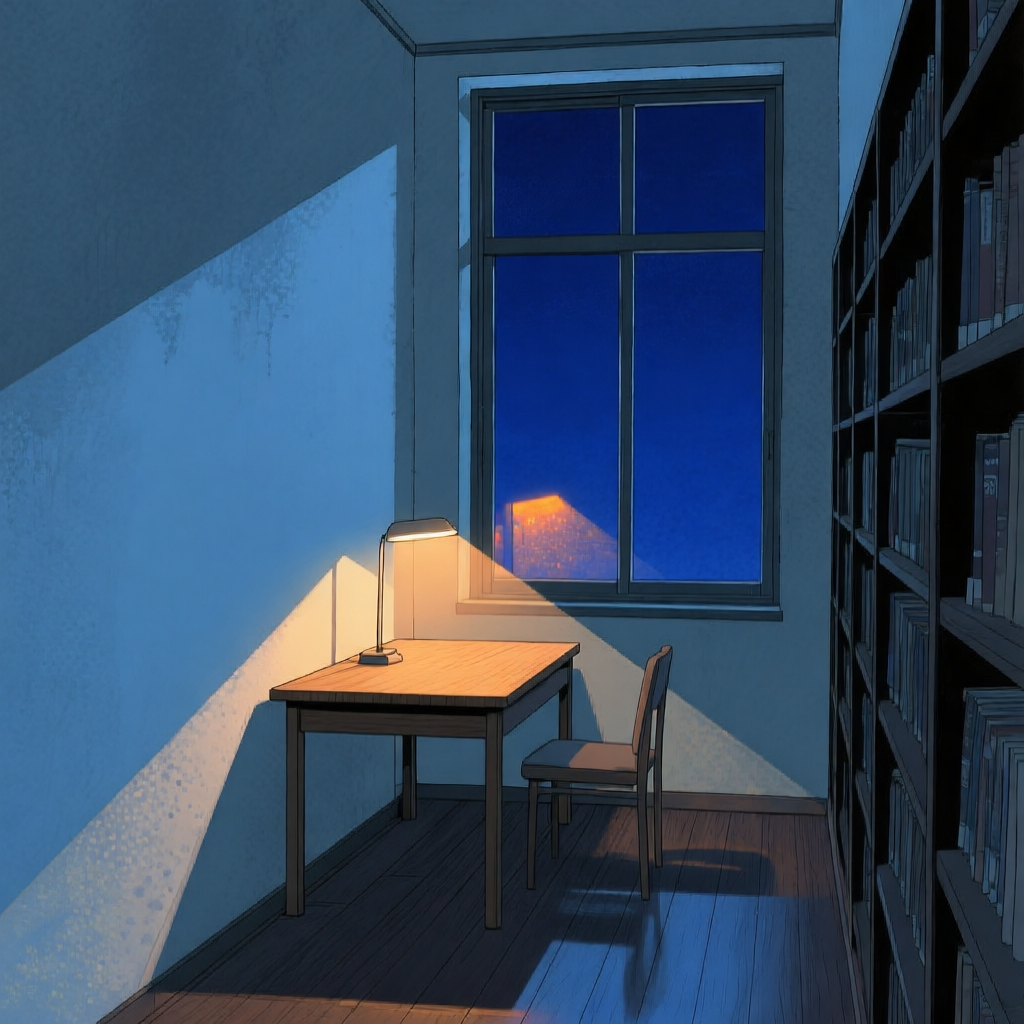 | 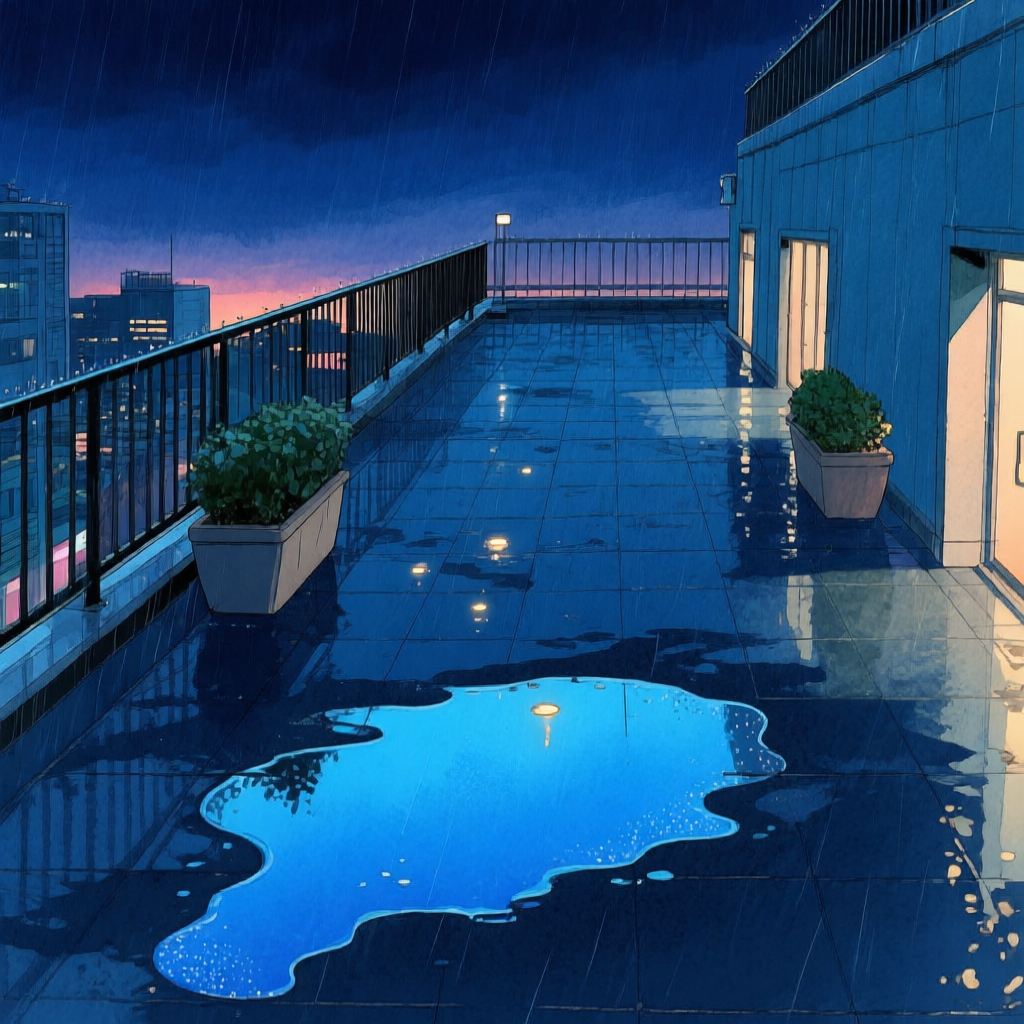 | 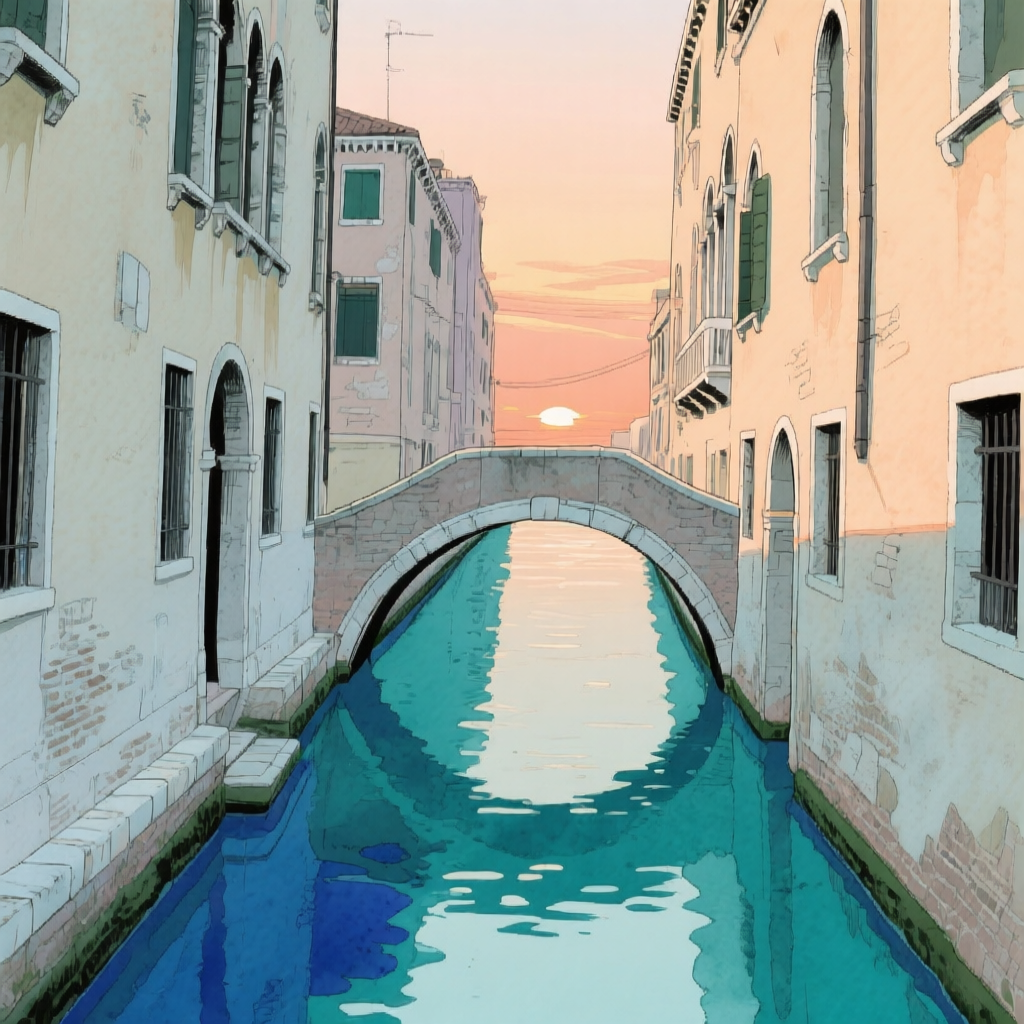 | 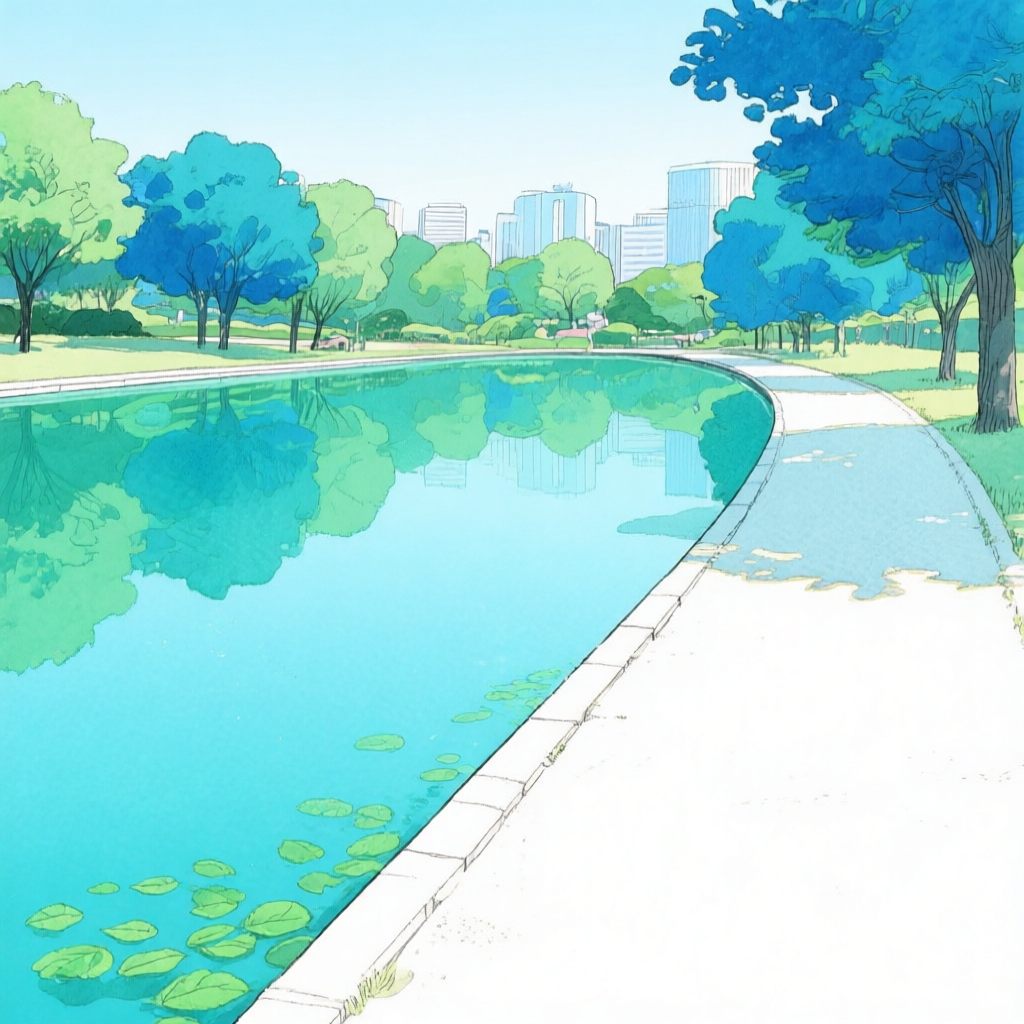 |
| 9 · 열차 승강장 · 우천 야간 · oblique | 10 · gallery · 낮 · oblique | 11 · 높은 로비 도서관 · 낮 · high oblique | 12 · harbor terrace · 해돋이 · high oblique |
|---|---|---|---|
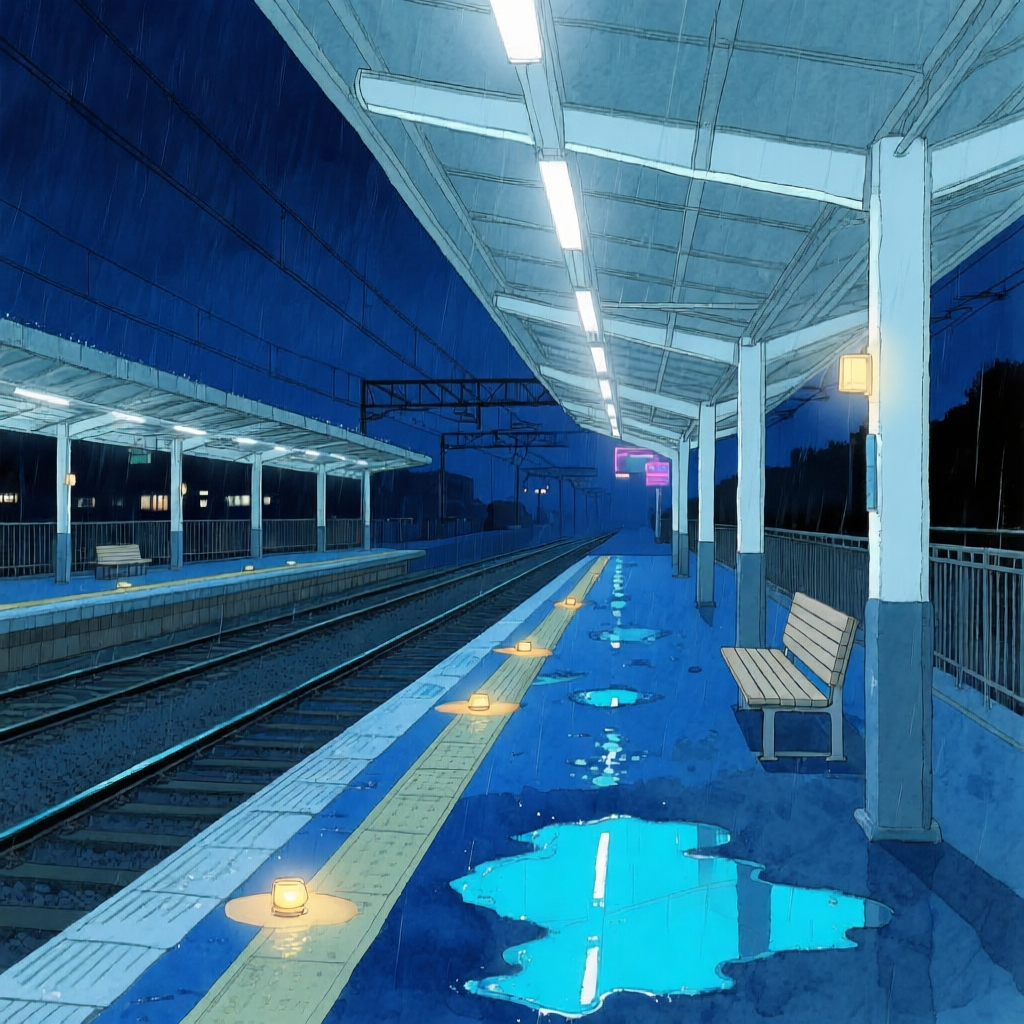 | 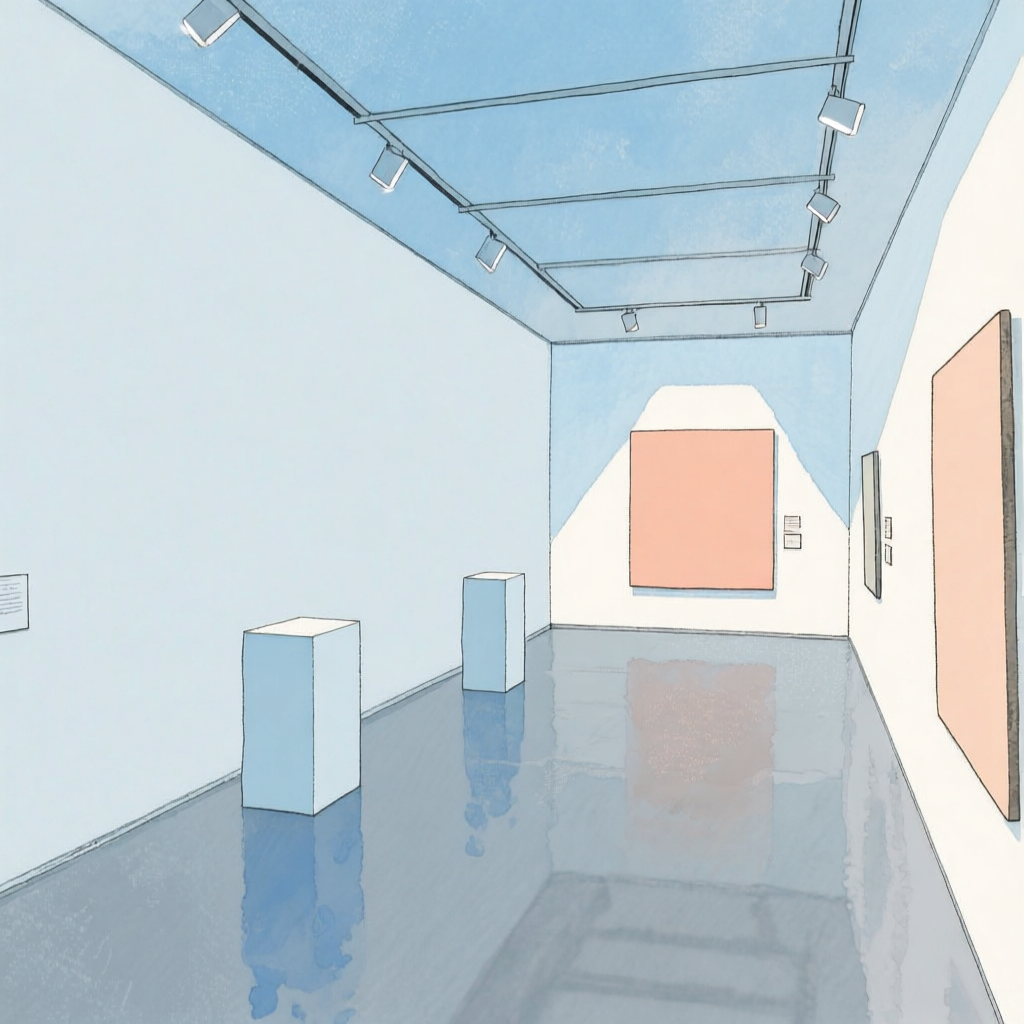 | 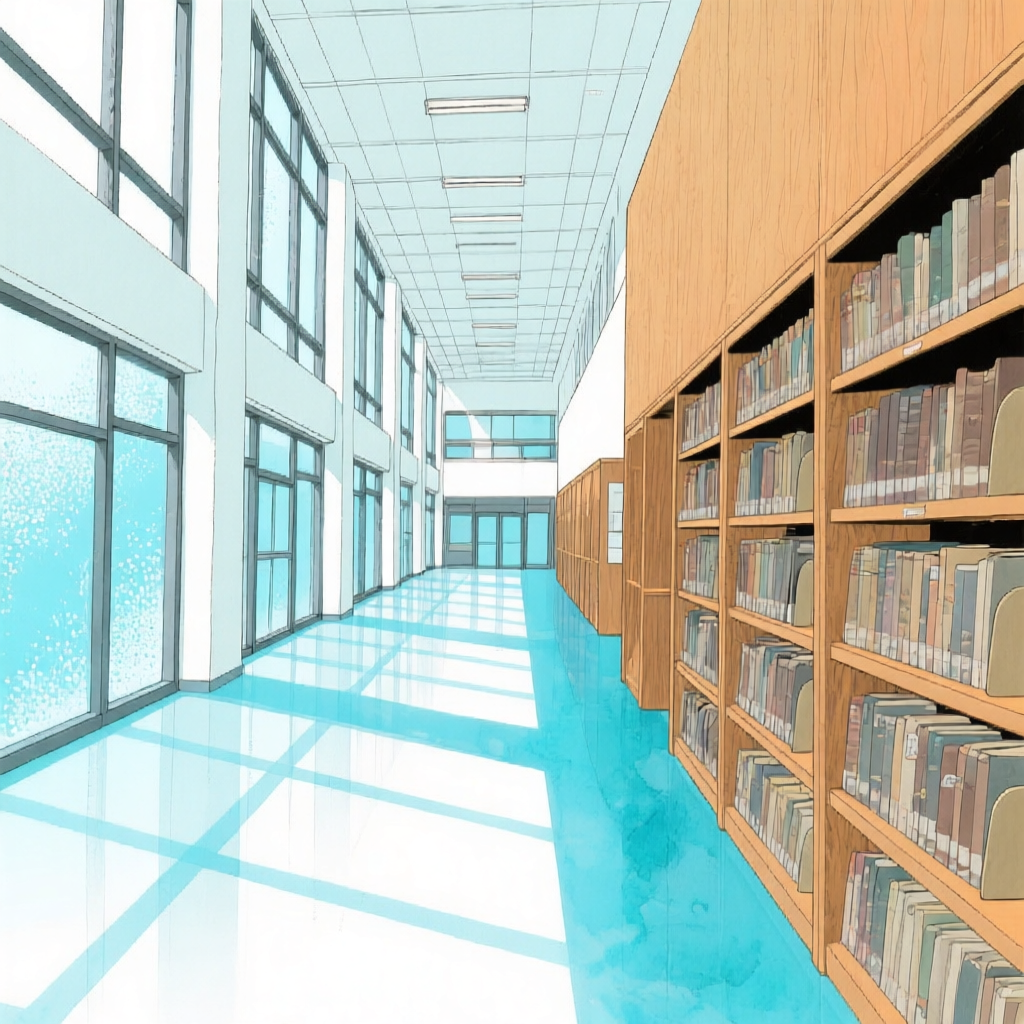 | 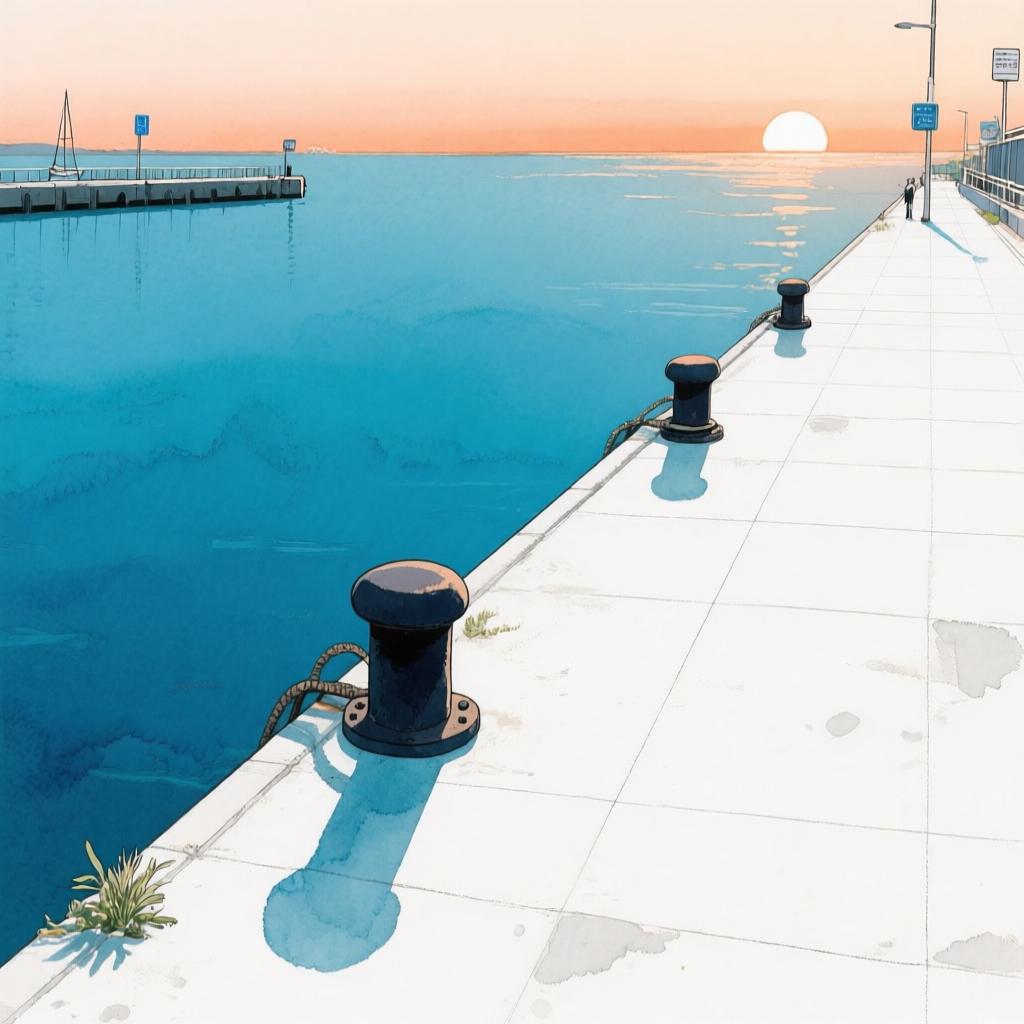 |
| 13 · underpass · 우천 twilight · oblique | 14 · hillside alley · 오후 · eye-level | 15 · market arcade · 흐림 · oblique | 16 · riverside terrace · 밤 · oblique |
|---|---|---|---|
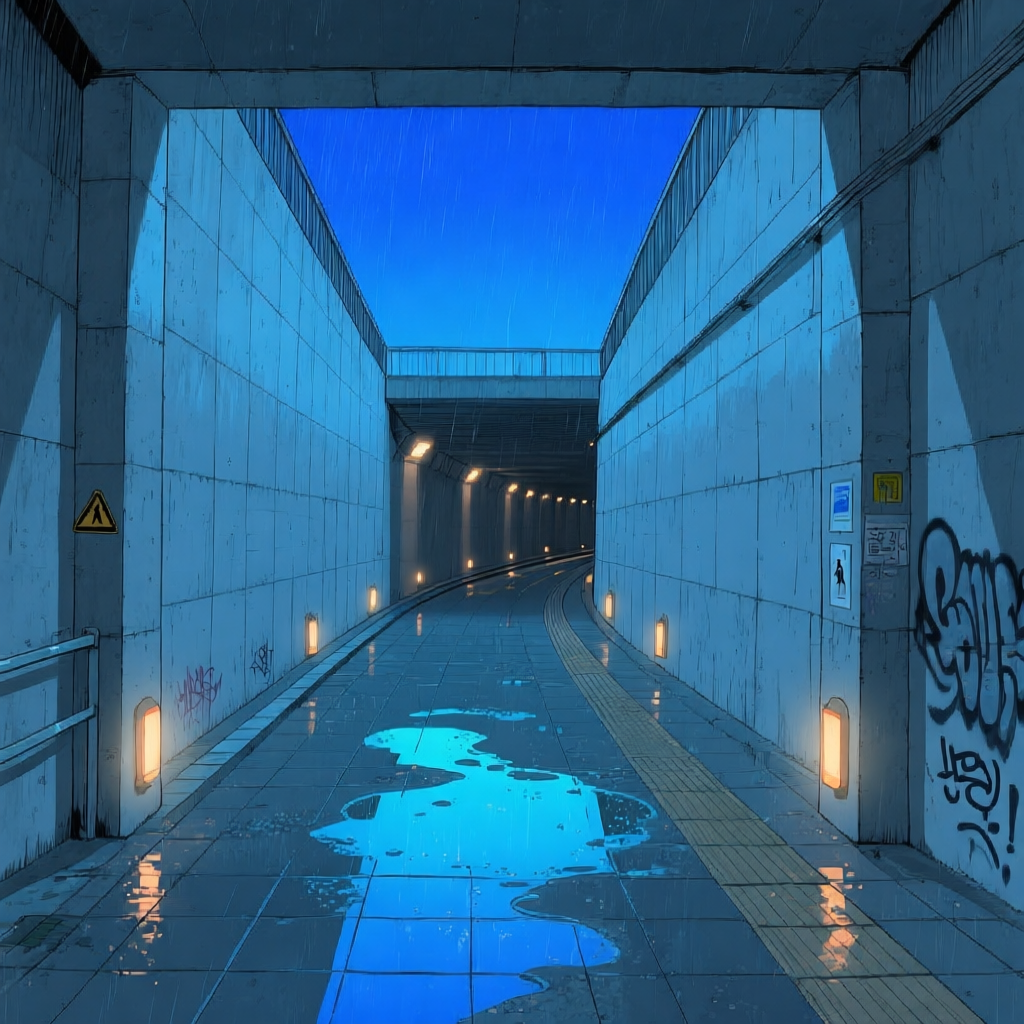 | 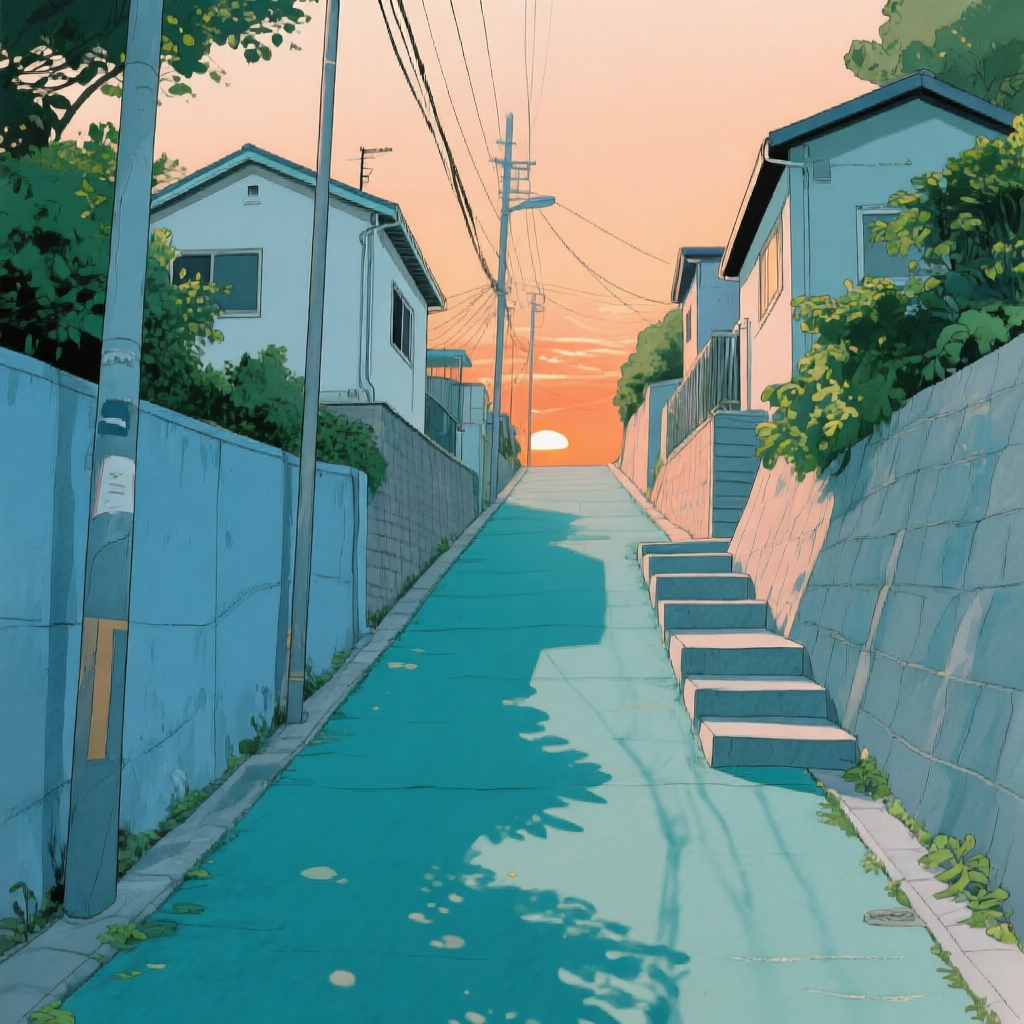 | 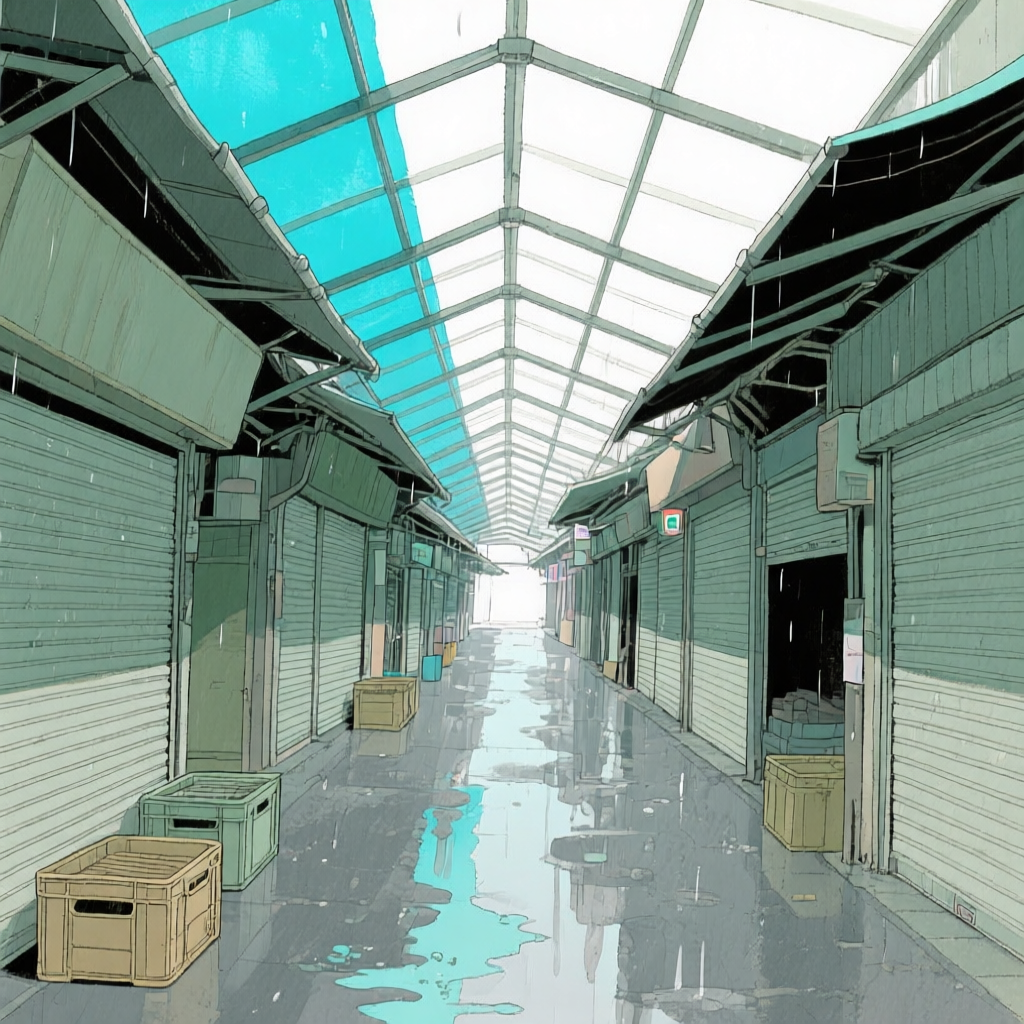 | 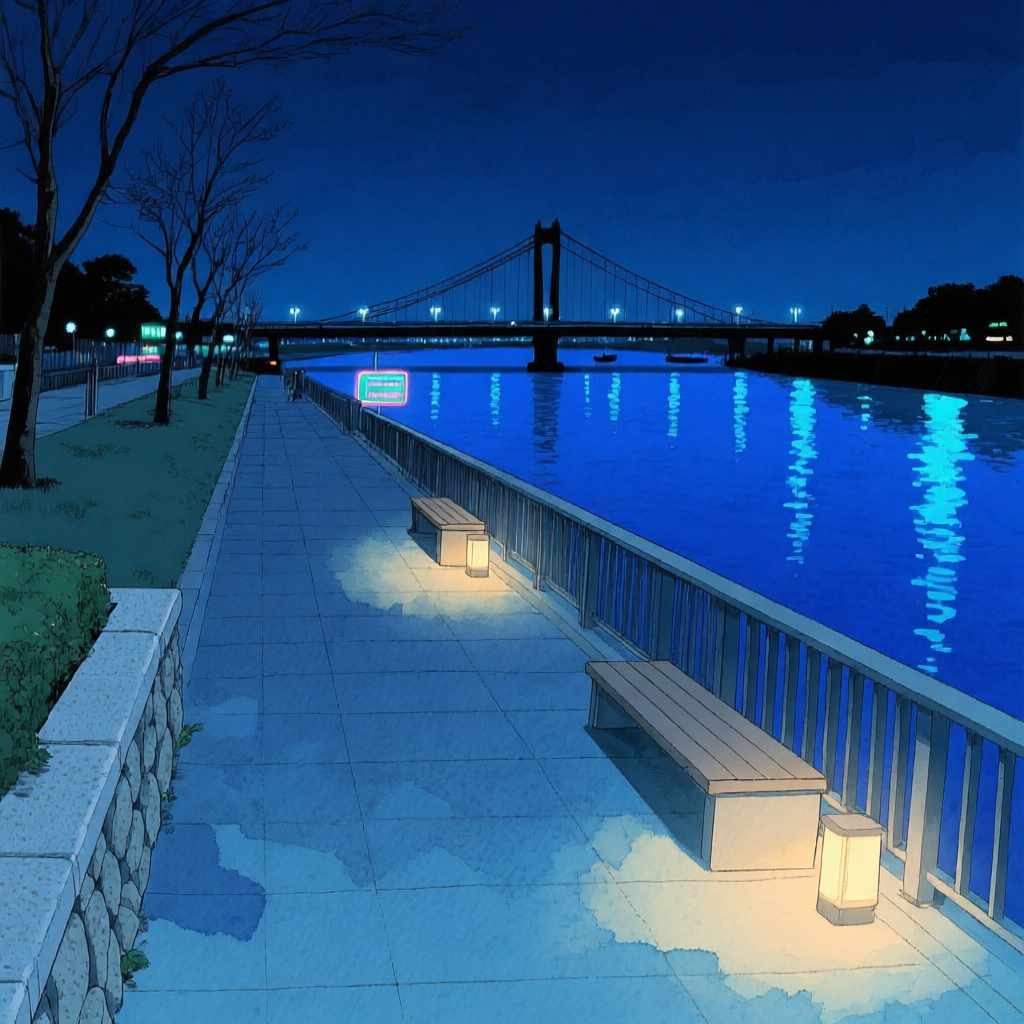 |
| 17 · greenhouse · blue hour · eye-level | 18 · ferry deck · 아침 · oblique | 19 · cinema foyer · 밤 · eye-level | 20 · 세라믹 스튜디오 · 오후 · oblique |
|---|---|---|---|
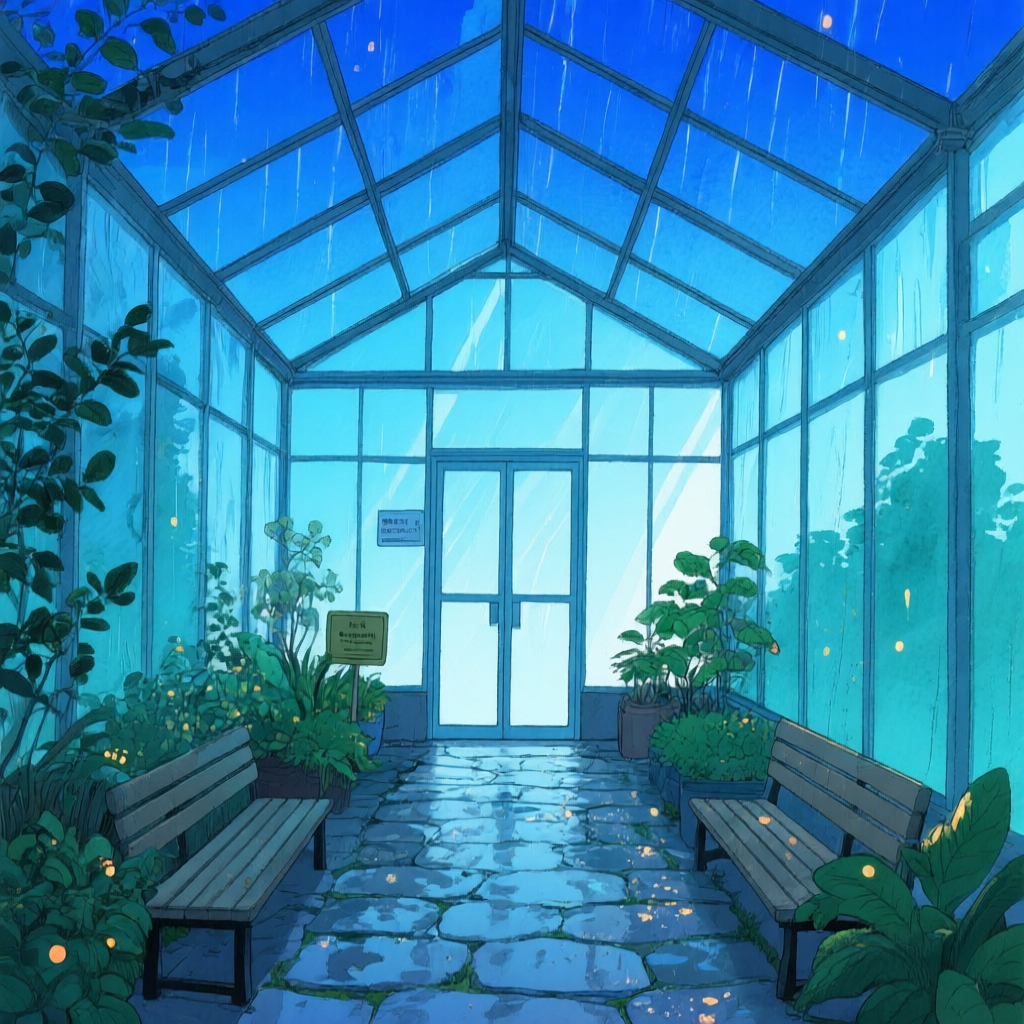 | 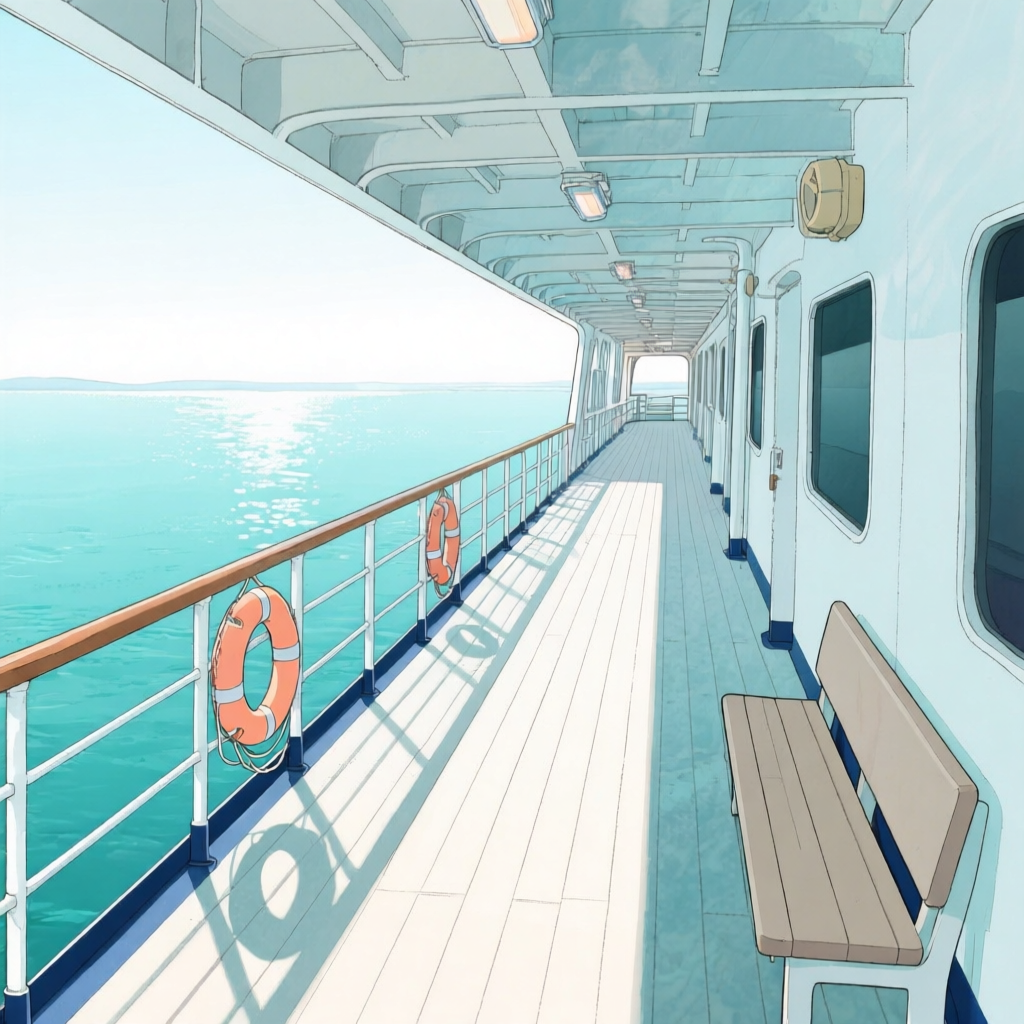 | 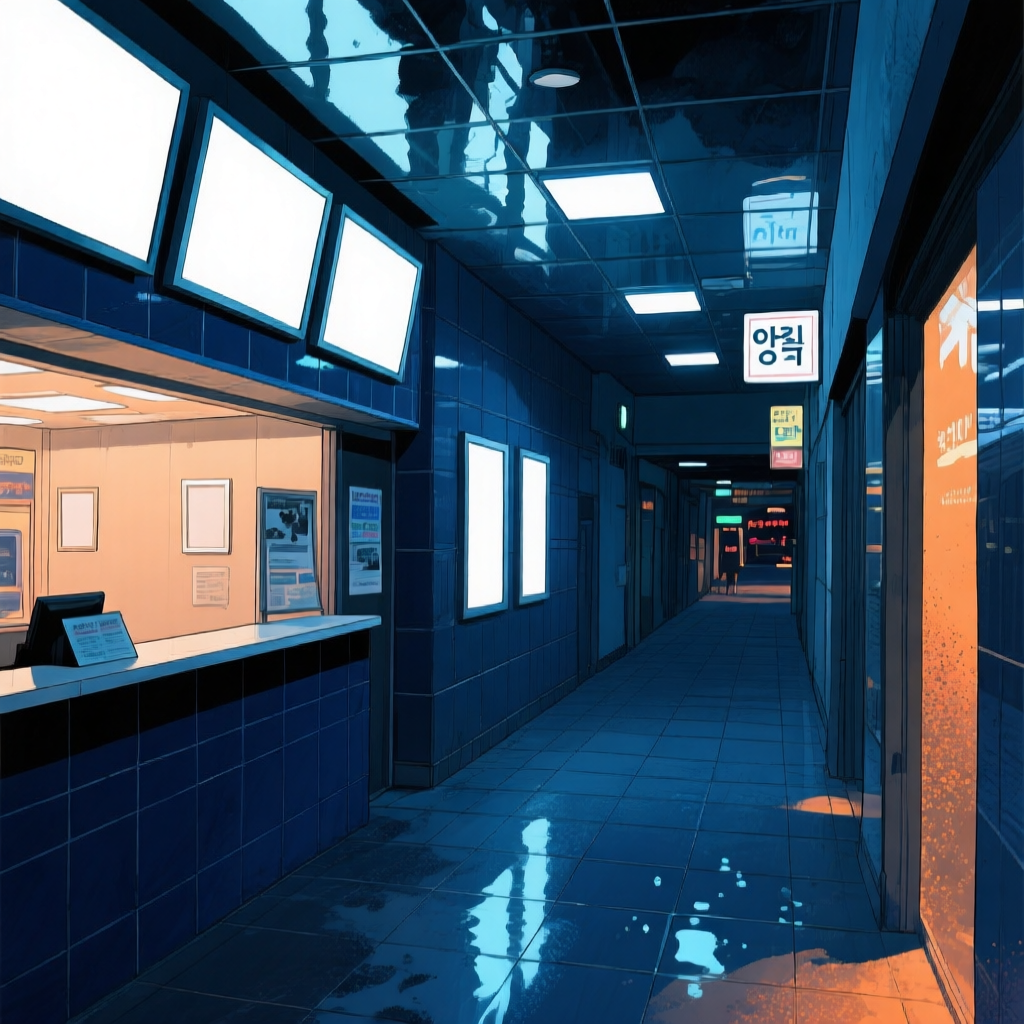 | 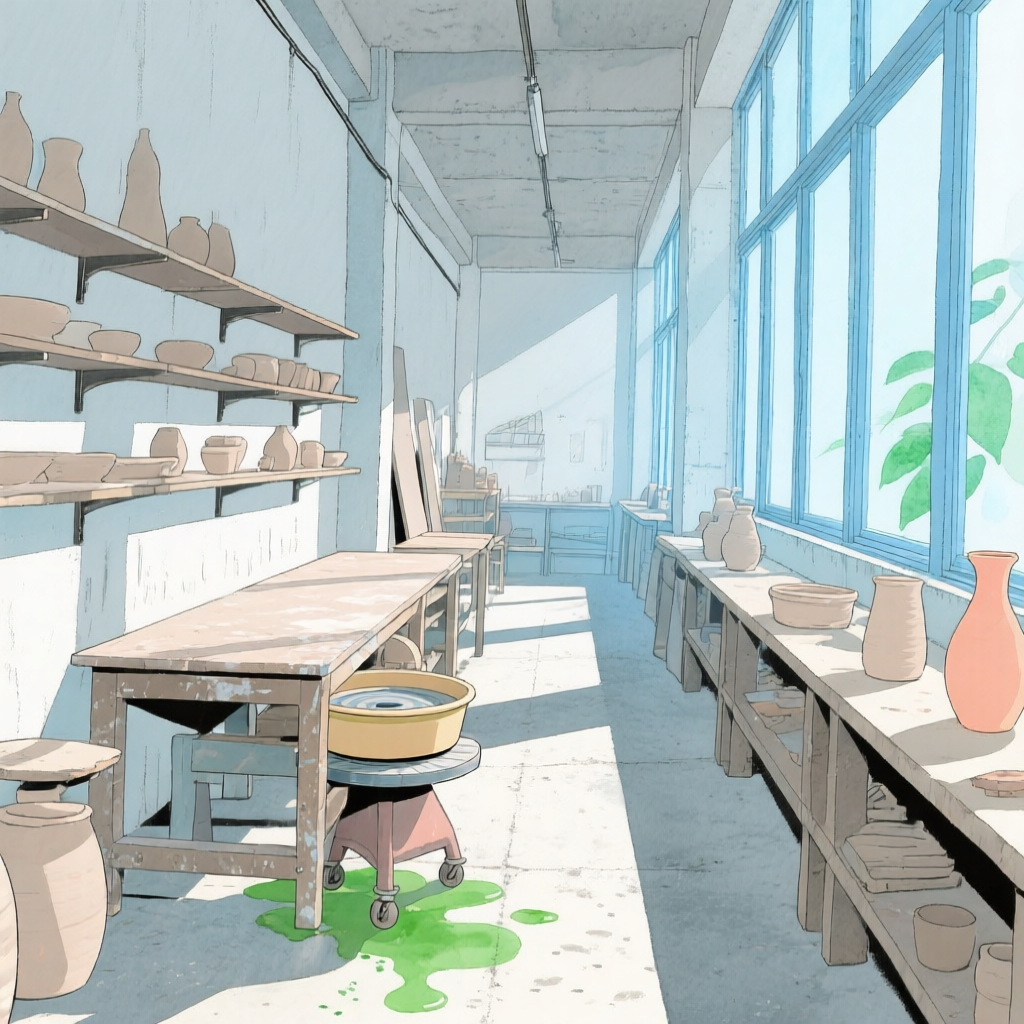 |
스무 장면의 자산 이름과 장면 식별자는 위 원본 표와 각 PNG 파일명에서 확인하고, 행별 관찰은 커밋하지 않는 로컬 기록으로 분리합니다.
실험에서 확인한 기능과 변경 결정
아래 기록은 한 번의 출력이 보기 좋았는지가 아니라, 같은 로컬 GPU 조건에서 다음 단계가 비교 가능한 입력을 받는지를 기준으로 정리했습니다. 표의 결과는 이 참조 팩에서 관찰한 범위이며, 다른 모델·해상도·prompt에 그대로 일반화하지 않습니다.
| 확인한 기능 또는 변경 | 결정 이유 | 이 실험에서 확인한 결과 | 이 결과가 뜻하지 않는 것 |
|---|---|---|---|
| Nunchaku·순차 CPU offload와 행별 생성 | GPU 상주량을 줄이고 실패 행만 다시 실행하려고 함 | offload와 행별 저장으로 스무 로컬 GPU 후보 행을 같은 계약으로 실행할 수 있음 | offload가 선화·구도 품질을 높이거나 모든 환경에서 같은 속도를 보장한다는 뜻은 아님 |
| Qwen Image 30스텝 기본값 | 1024×1024 아트리움 비교에서 20스텝부터 기본 형태가 읽혔지만 이후 후보의 일관된 운용점을 남기려고 함 | 1번 아트리움, 2번 courtyard, 3번 도심의 30스텝 원본과 prompt 단어 수·시간·메모리 기록을 보관함 | 30스텝이 모든 장면의 필요량을 뜻하는 것은 아님 |
| 공통 화풍 계약과 장면 행의 분리 | 선·수채화·프레임 조건을 바꾸지 않은 채 장소·시간·camera 차이만 비교하려고 함 | 같은 계약 아래 실내·실외, 새벽·낮·석양·밤·우천 야간, 다섯 camera family를 참조 팩에서 대조함 | 공통 prompt 하나가 모든 장면의 공간 구조를 자동으로 고정한다는 뜻은 아님 |
| 중앙 도로 대신 측면 교차로로 도심 조건 변경 | 넓은 도로 요구가 중앙 소실점의 거리 복도로 수렴한 이탈을 장면 구조 문제로 해석함 | 측면 모퉁이에서 비스듬히 보는 도심 원본으로 교체해 낮·wide 행을 비교함 | 금지어를 더 많이 쓰면 모든 원근 오류를 고칠 수 있다는 뜻은 아님 |
| 여객기 실내를 창가 독서실로 대체 | 좌석 모듈·천장·사선 구도를 동시에 안정적으로 관찰하기 어려웠음 | 밤·실내·oblique 조건은 단순한 독서실과 작은 스탠드 조명으로 비교함 | 복잡한 실내 장면이 모델에서 불가능하다는 일반 결론은 아님 |
| 사람 관찰 기록과 원본 표의 분리 | 미적 판단을 자동화하지 않으면서 관찰 근거와 원본 식별 정보를 분리하려 함 | 사람 관찰은 로컬 기록에 남기고, 스무 원본의 파일명·장면 식별자는 본문의 원본 표에서 확인함 | 원본 표가 이미지의 선·색·공간 품질을 자동 채점하거나 사람 관찰을 대신한다는 뜻은 아님 |
체크리스트
| 확인할 것 | 스스로 답할 질문 |
|---|---|
| 원본 | crop 없이 프레임 없는 생성 원본인가? |
| 선과 색 | 선화가 살아 있고 수채화 색층이 선을 덮지 않는가? |
| 시간 | 새벽·낮·해질녘·밤·우천 야간이 실제 광원 차이로 읽히는가? |
| 카메라 | 같은 중앙 소실점 반복이 아니라 camera family가 다른가? |
| 실패 해석 | 실패 원인을 crop이나 status 변경으로 덮지 않고 다음 구도·피사체 밀도·광원 조건으로 바꿨는가? |
| 생성 출처 | 참조 원본이 로컬 GPU 생성 스크립트와 사람 검수 ledger에 연결되고, 내장 이미지 생성 자산이 섞이지 않았는가? |
| 원본 표 기록 | 스무 원본의 자산명·장면 식별자·관찰 범위를 원본 표와 로컬 기록에서 구분했는가? |
출처와 참고 자료
- Qwen, Qwen-Image 모델 카드, Hugging Face, 확인일: 2026-08-18.
- Hugging Face, Diffusers QwenImage pipeline, Hugging Face, 확인일: 2026-08-18.
- Hugging Face, Diffusers Reduce memory usage, Hugging Face, 확인일: 2026-08-04.