P7-5.5 스토리보드 장면에서 캐릭터를 분리하고 적용하는 경로
Section ID:
P7-5.5Version:v2026.09.15
이 절은 P7-5.4의 마지막 단계에서 주변 인물과 동물까지 추가한 A·B·C를 입력으로 이어받는다. 캐릭터와 배경을 각각 처리한 뒤 합성·리라이트한 장면까지 연결하며, 한 단계의 출력이 다음 단계의 입력이 되는 파이프라인을 구성한다.
캐릭터와 배경을 나누어 처리한 뒤 한 장면으로 합친다
장면을 캐릭터와 배경 두 흐름으로 나눈다. 캐릭터 쪽에서는 외형과 필요한 소품을 적용하고, Mira의 얼굴·헤어를 BFS로 보강한다. 배경 쪽에서는 편집 대상 인물을 제거해 빈 영역을 채운다. 두 흐름에 각각 DeLight를 적용해 조명을 중립화한 뒤 합성하고, 마지막으로 장면에 필요한 조명을 텍스트로 지시한다.
flowchart TD
    scene["P7-5.4 최종 장면"]
    cutout["캐릭터 분리"]
    identity["외형·소품 적용"]
    face["Mira 얼굴·헤어 보강 · BFS"]
    characterLight["캐릭터 조명 중립화 · DeLight"]
    background["편집 대상 인물을 제거한 배경"]
    backgroundLight["배경 조명 중립화 · DeLight"]
    composite["캐릭터와 배경 합성"]
    relight["텍스트 조명 적용 · Relight"]
    result["최종 장면"]

    scene --> cutout
    scene --> background
    cutout --> identity
    identity -->|Mira| face
    face --> characterLight
    identity -->|C 조연| characterLight
    background --> backgroundLight
    characterLight --> composite
    backgroundLight --> composite
    composite --> relight
    relight --> result
화살표는 앞 단계의 결과 이미지를 다음 단계의 입력으로 전달한다는 뜻이다. C 조연은 외형·책 적용 후 BFS를 거치지 않고 DeLight로 이어진다. 마지막 Relight의 조명 설명은 최초 장면을 보고 작성하되, 모델에는 합성 결과 한 장만 넣는다. 합성과 조명 처리도 이미지를 다시 생성하므로, 각 단계에서 인물·소품·구도가 유지되는지 확인한다.
P7-5.4의 최종 장면을 입력으로 고정한다
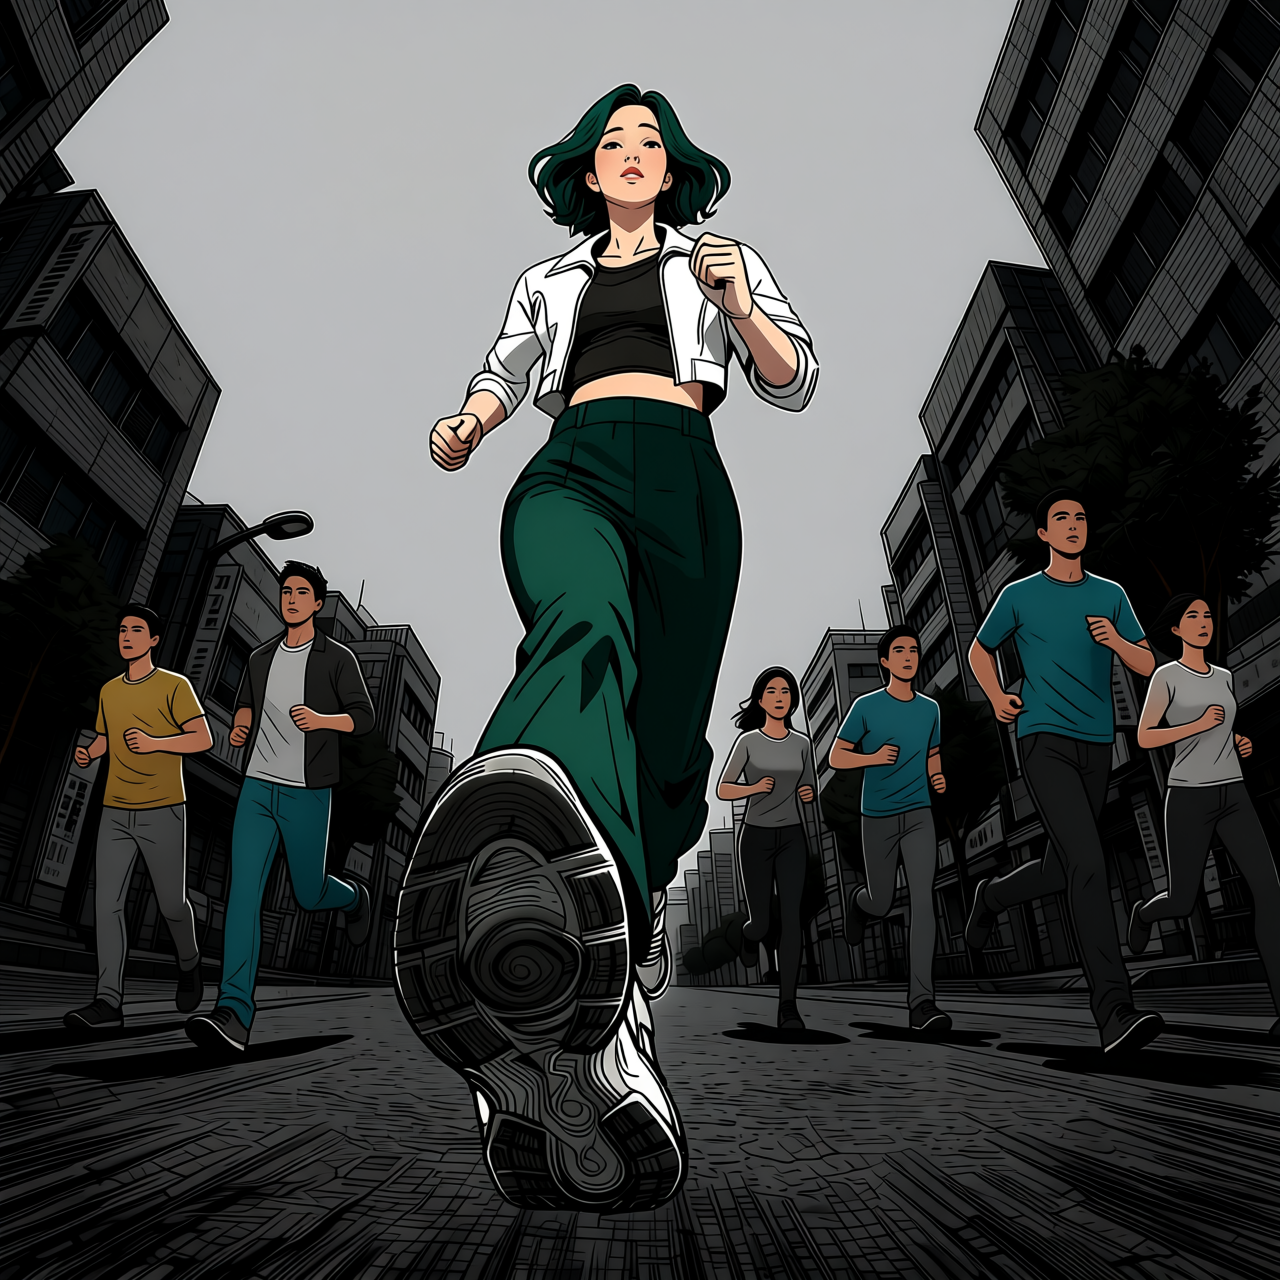
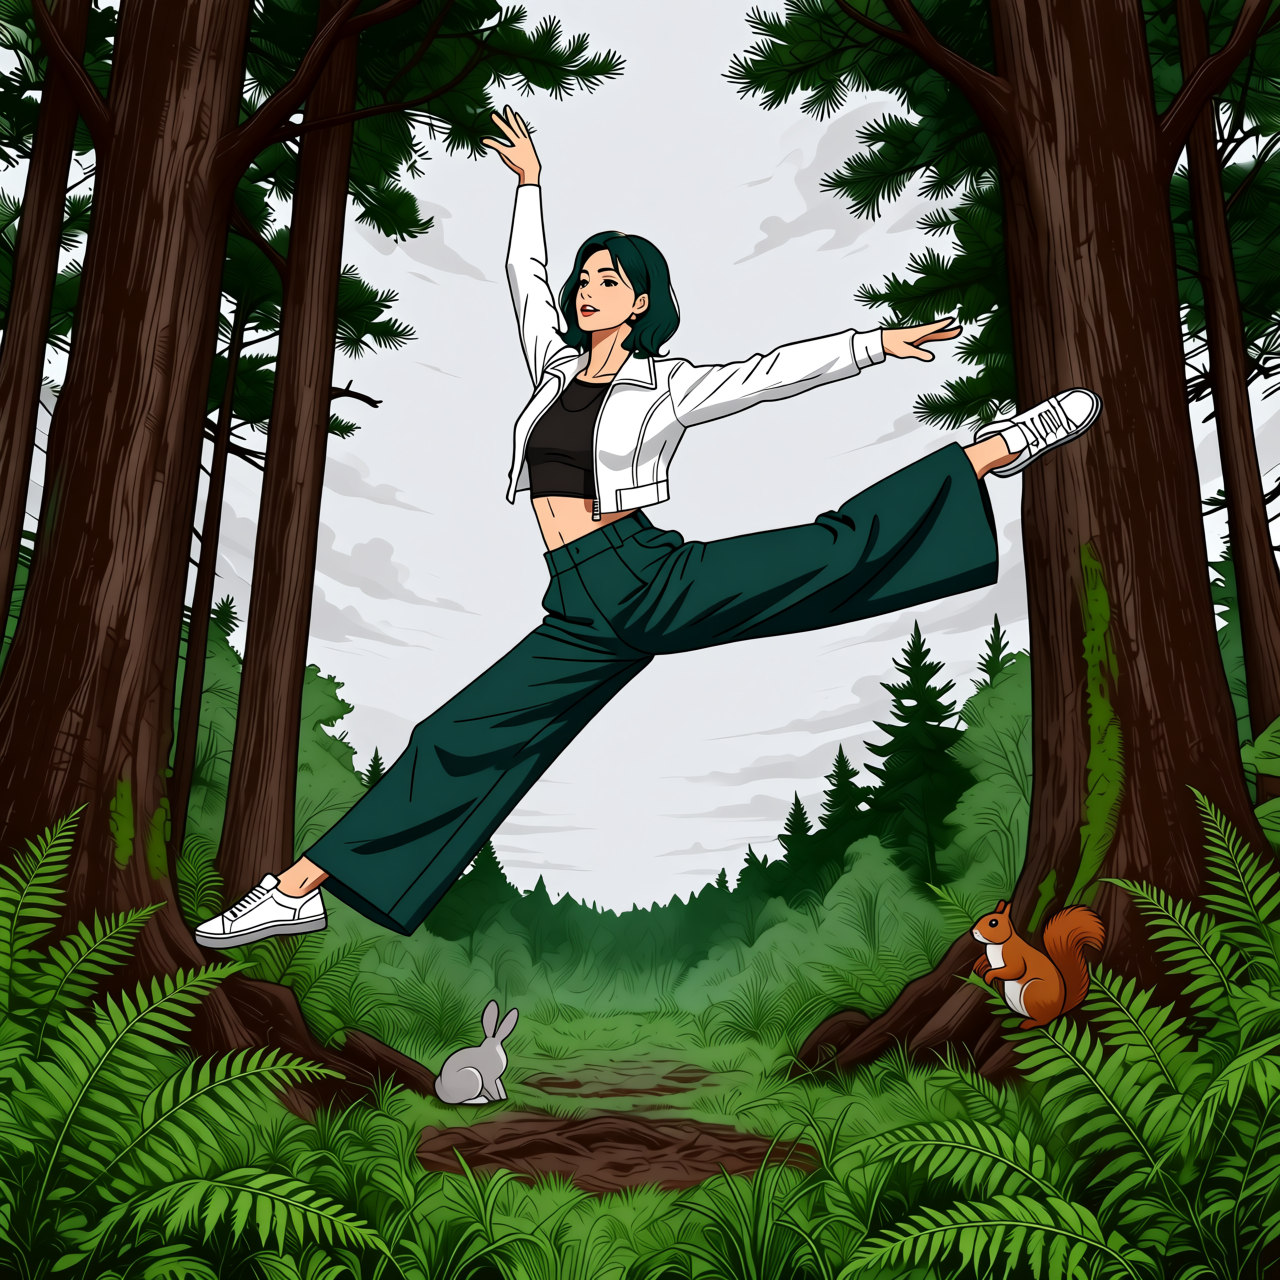
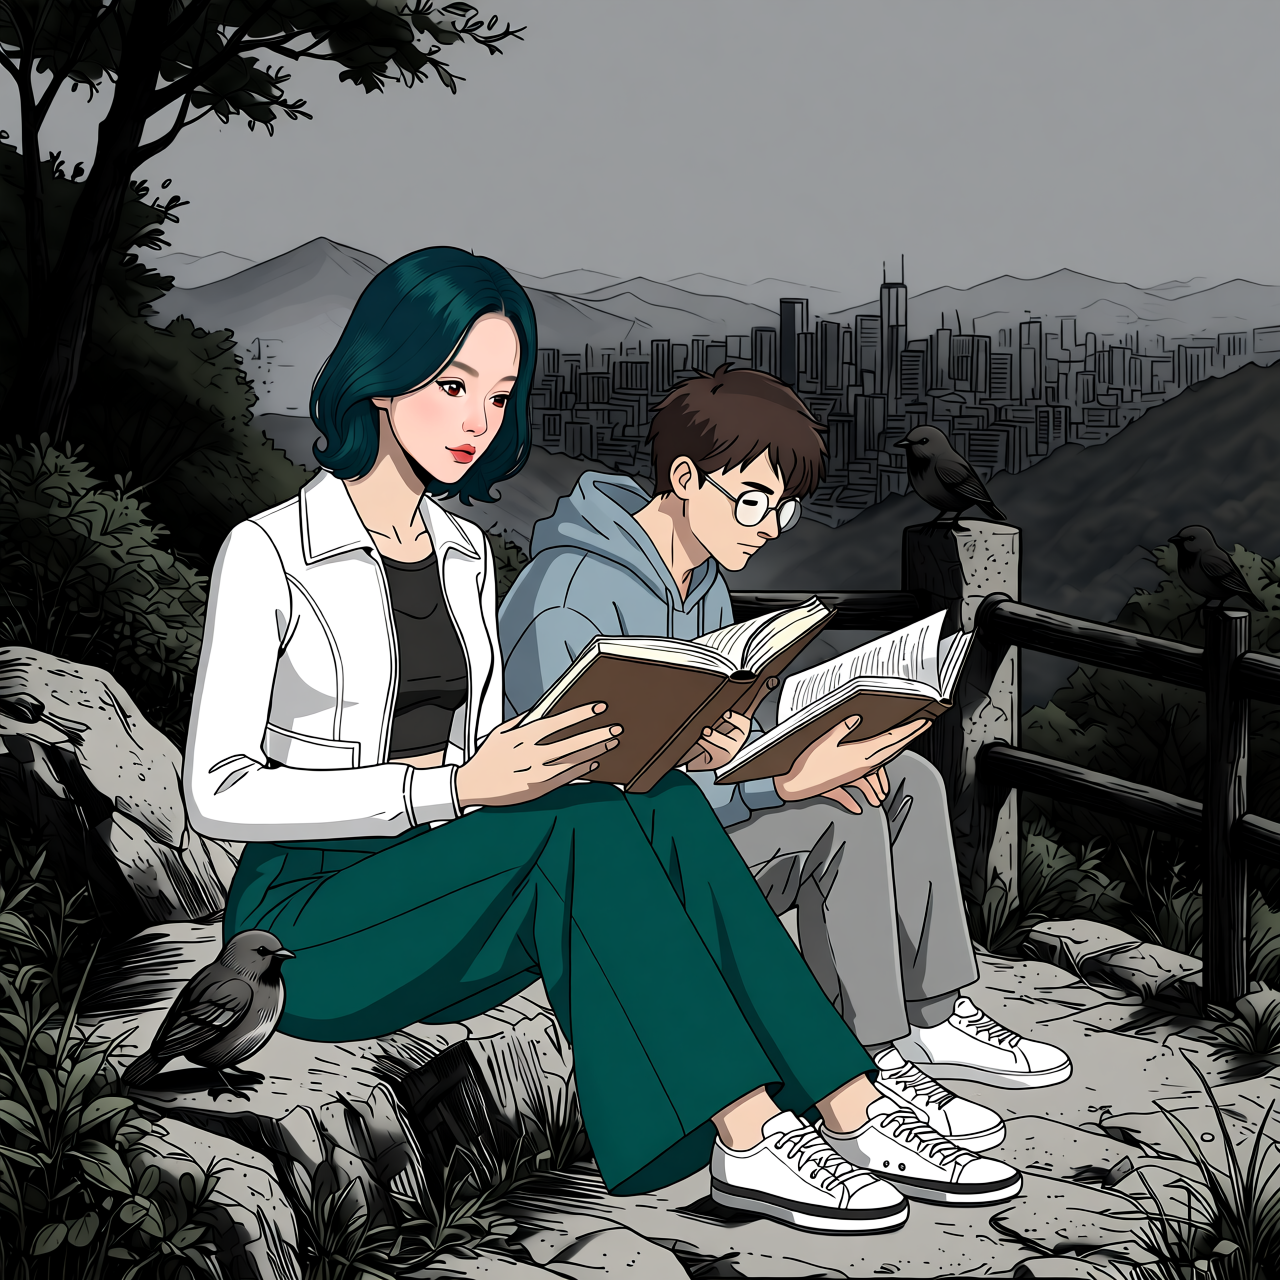
세 입력은 모두 1280×1280이다. A·B·C 모두 P7-5.4에서 재생성한 extras-audit-20260909-v1을 사용한다. A는 주변 인물 여섯 명, B는 토끼와 다람쥐, C는 앉아 있는 새 세 마리를 포함한다. 원본 자산을 P7-5.5용으로 복제하지 않고 P7-5.4의 파일을 직접 참조한다.
각 후속 결과의 result.json에는 실제 입력 파일, SHA-256과 실행 조건을 남긴다. 아래 코드와 JSON은 원고에 표시한 결과의 입력·출력 관계를 확인하는 기준이다.
| Scene A | Scene B | Scene C |
|---|---|---|
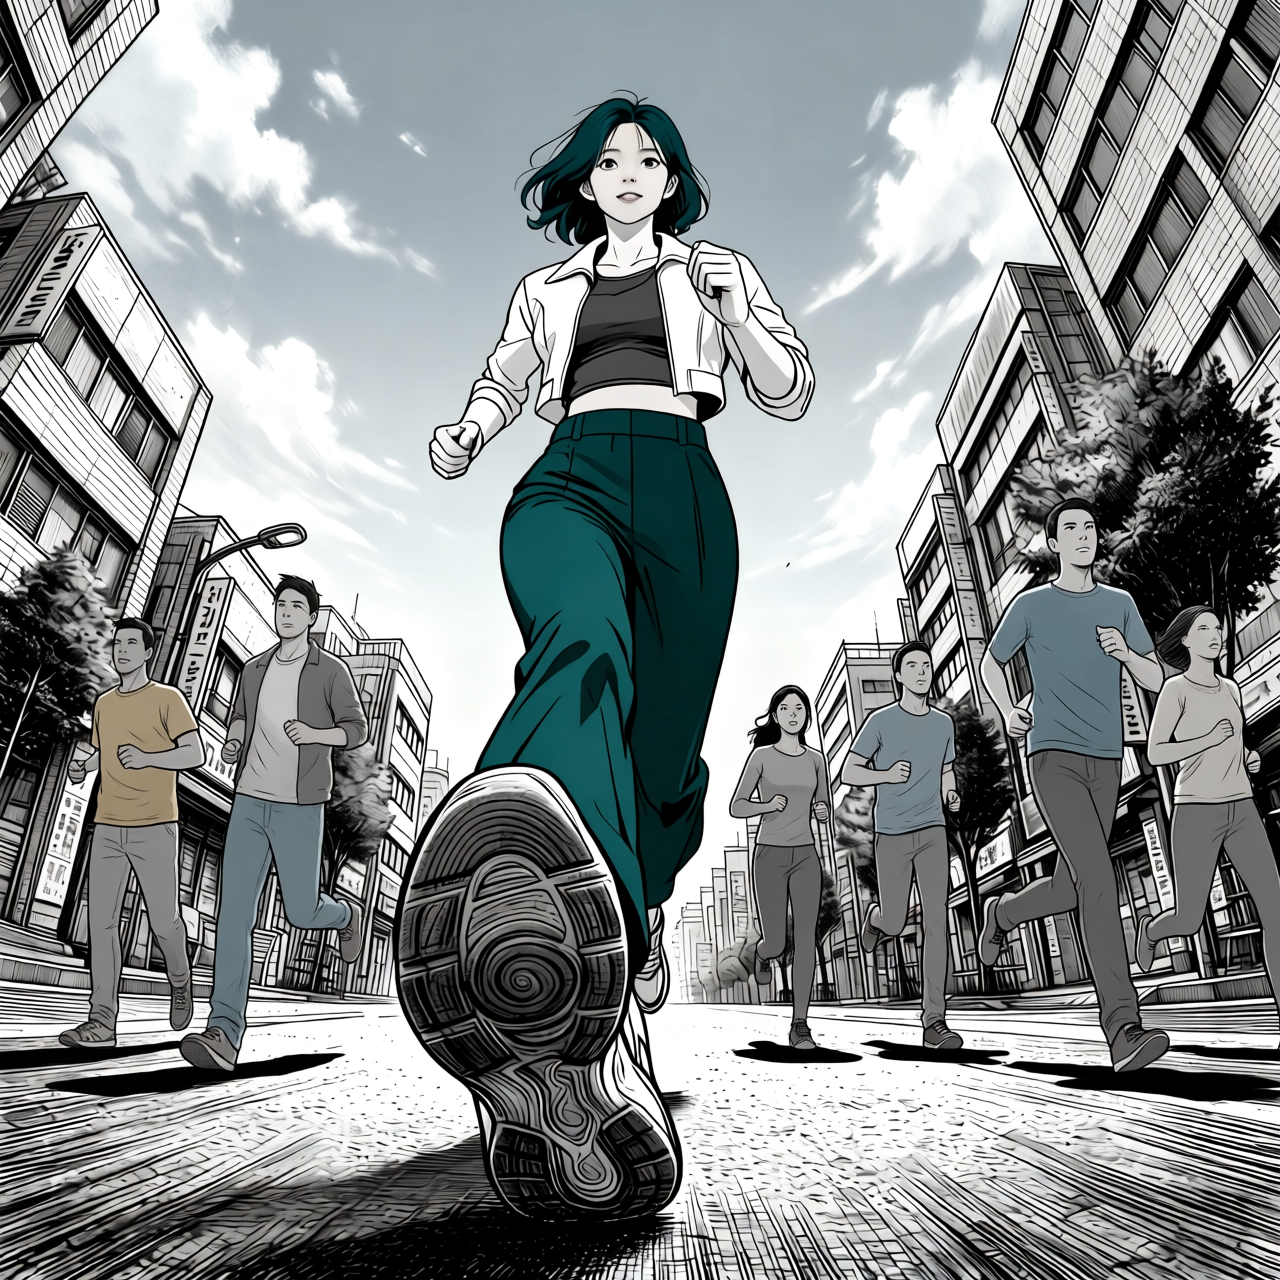 | 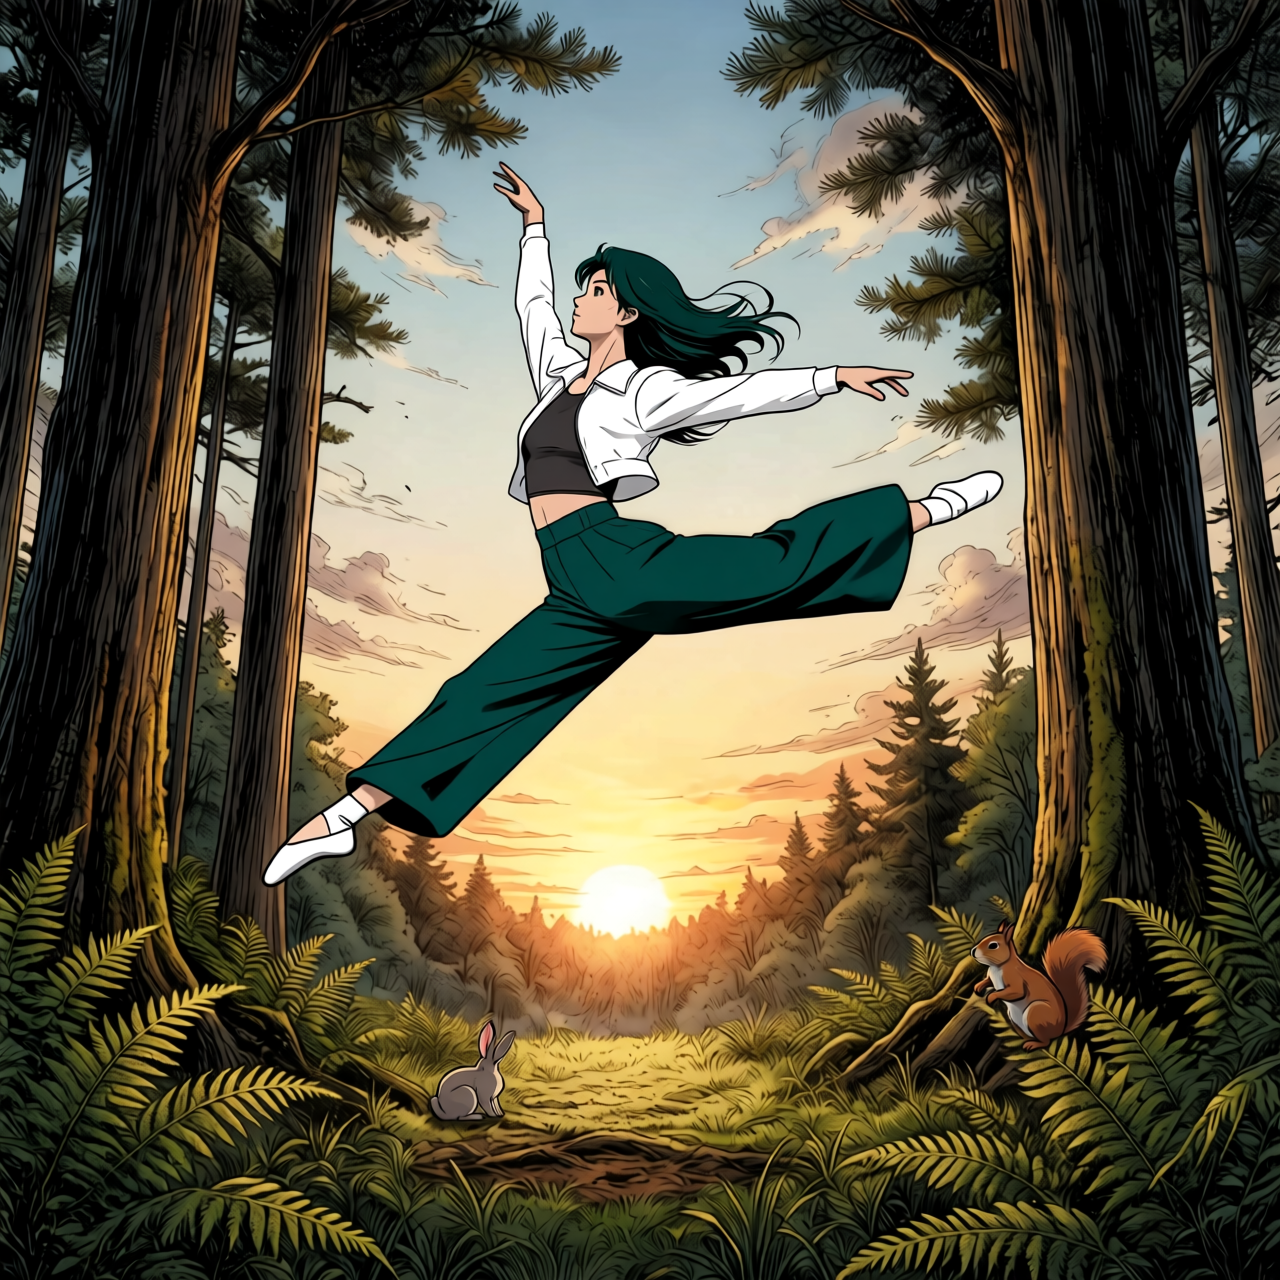 | 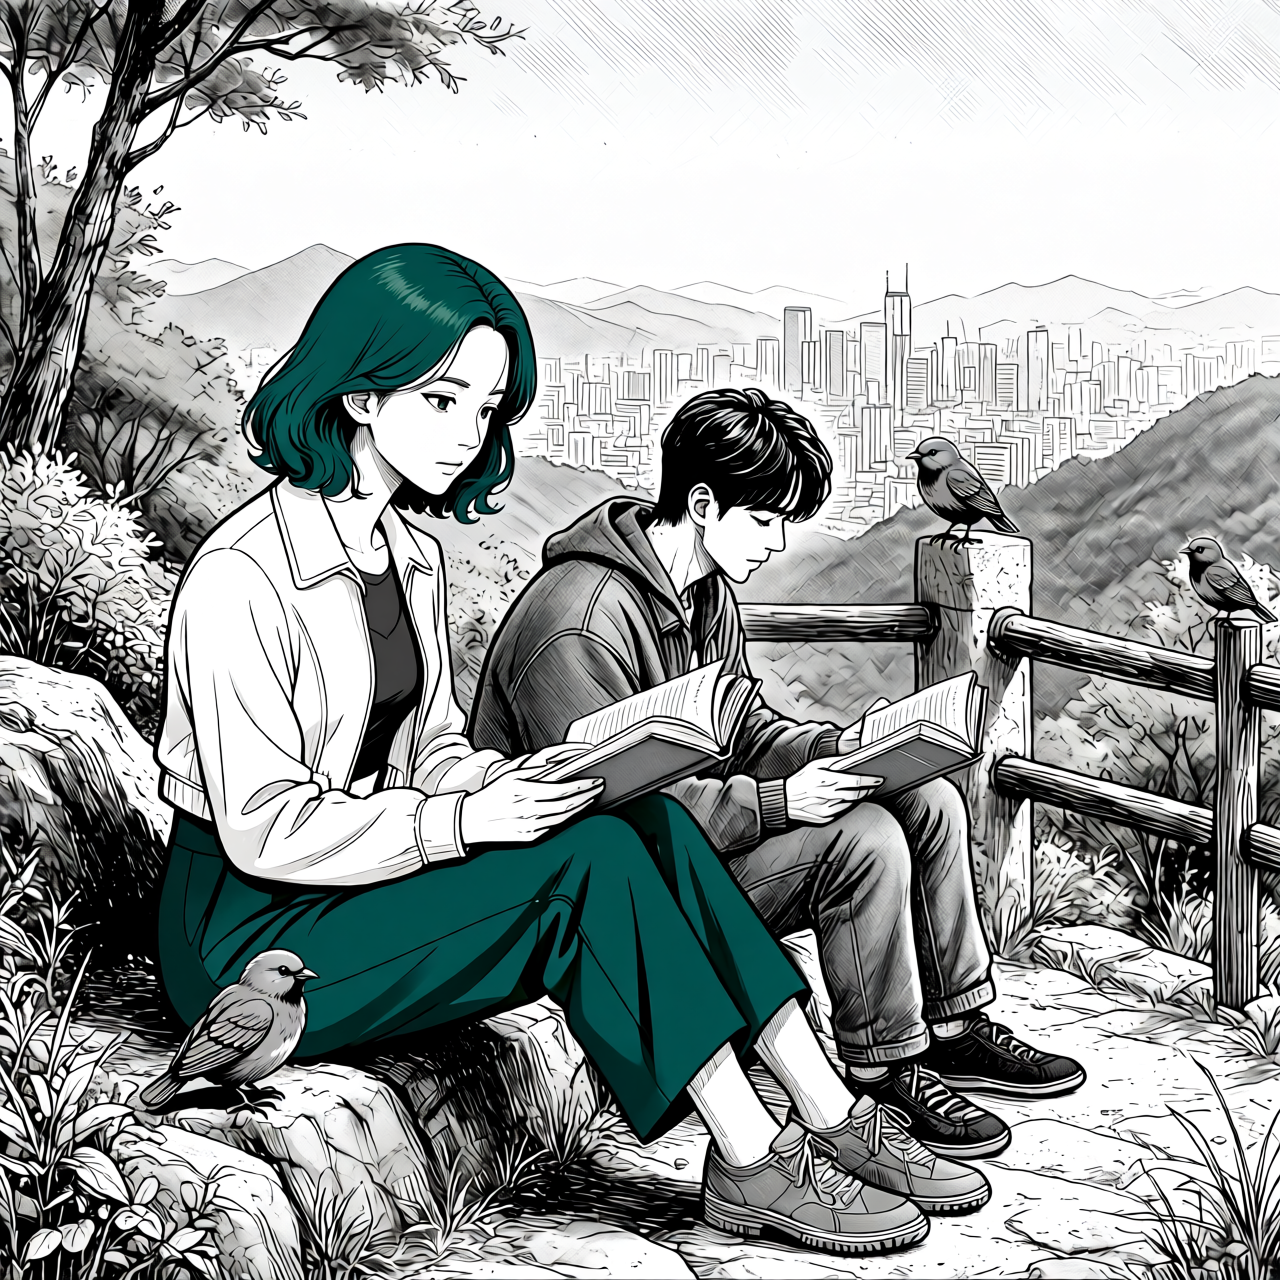 |
각 장면에서 편집할 인물과 남겨야 할 대상을 먼저 구분한다.
| 장면 | 인물 마스크·컷아웃 대상 | 인물 편집에서 보존할 주변 대상 |
|---|---|---|
| A | 화면 중앙에서 달리는 Mira | 주변 인물 여섯 명, 도로와 건물 |
| B | 공중에서 도약하는 Mira | 왼쪽 아래 토끼, 오른쪽 나무 밑 다람쥐, 나무와 양치식물 |
| C | 왼쪽 Mira와 오른쪽 조연을 각각 별도 마스크로 분리 | 각 마스크에서 다른 인물, 책, 새 세 마리, 난간과 도시 배경 |
A와 C에는 여러 인물이 있으므로 a person 검출 결과를 그대로 모두 합치지 않고 Mira에 해당하는 상자와 마스크를 확인해야 한다. C에서는 손과 책이 겹치는 경계도 확인한다. Mira를 제거한 배경판을 만들 때도 주변 인물·동물까지 함께 지워서는 안 된다.
Mira와 조연을 각각 분리한다
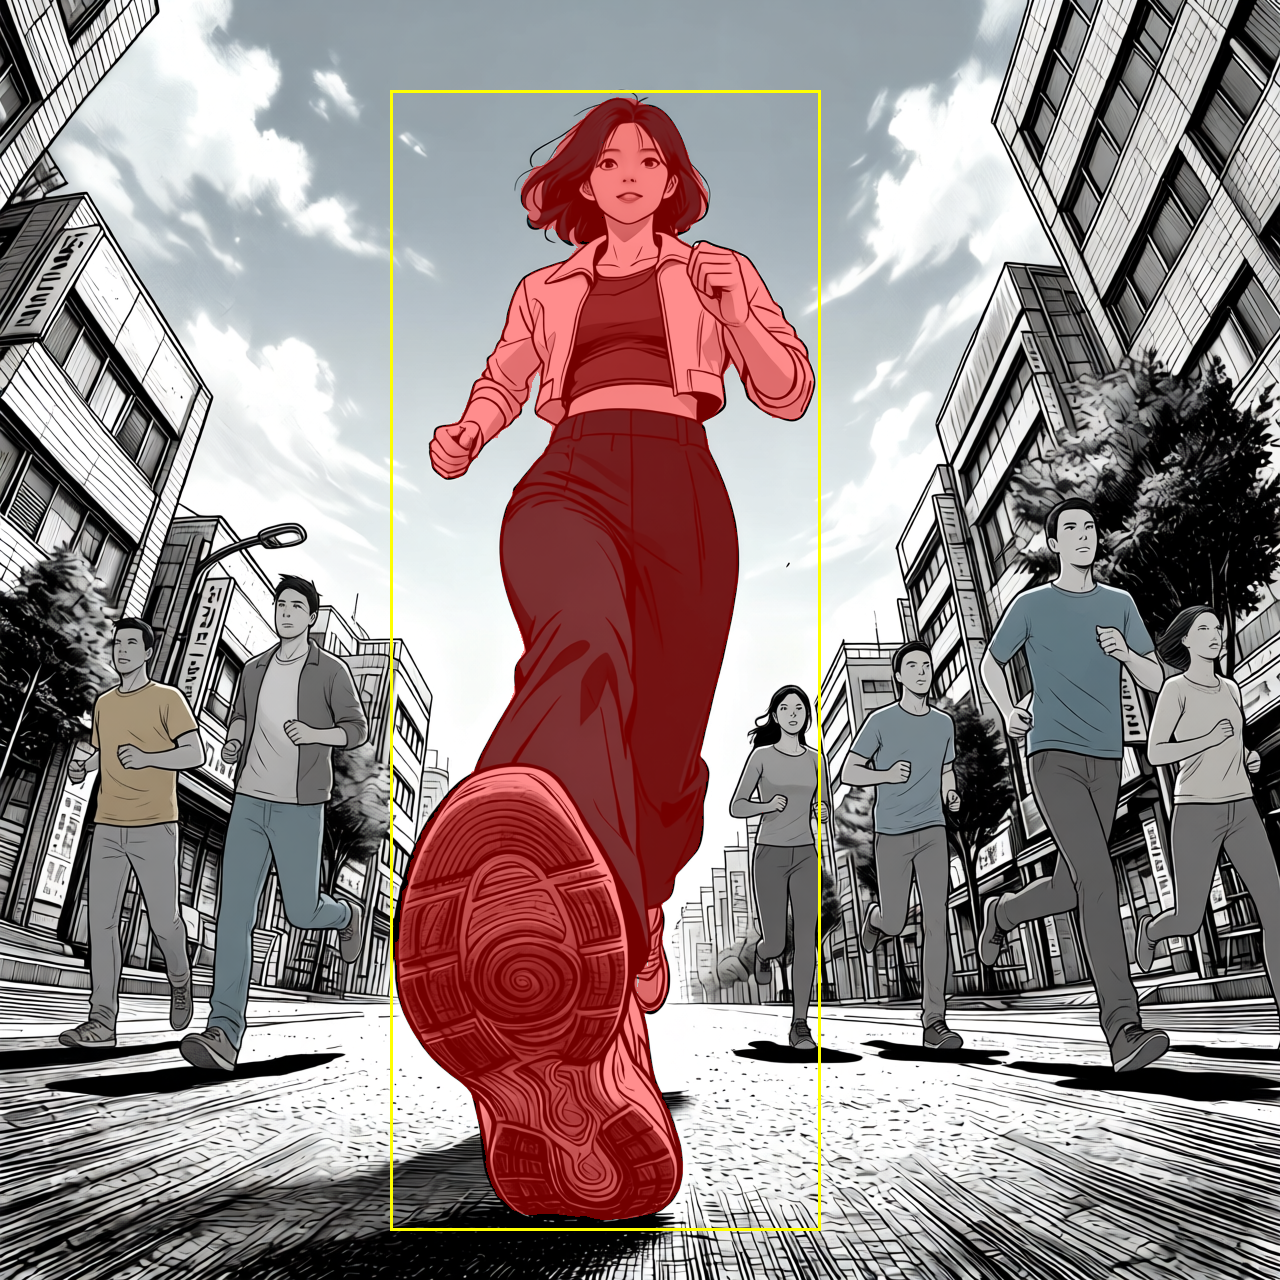
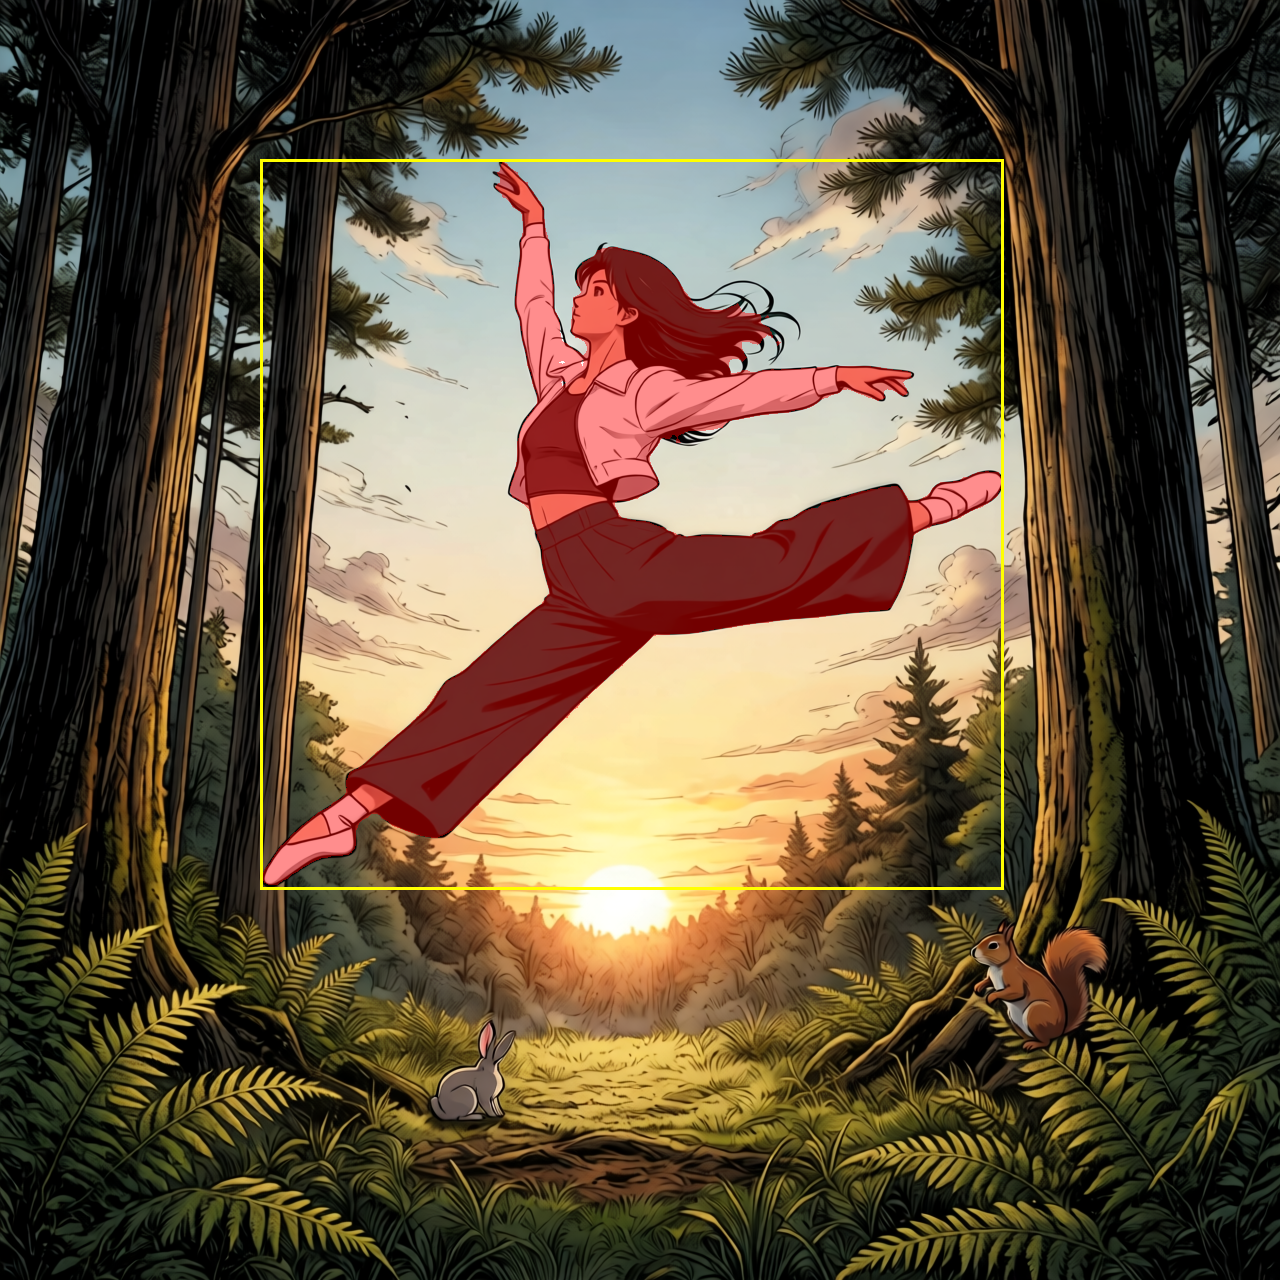
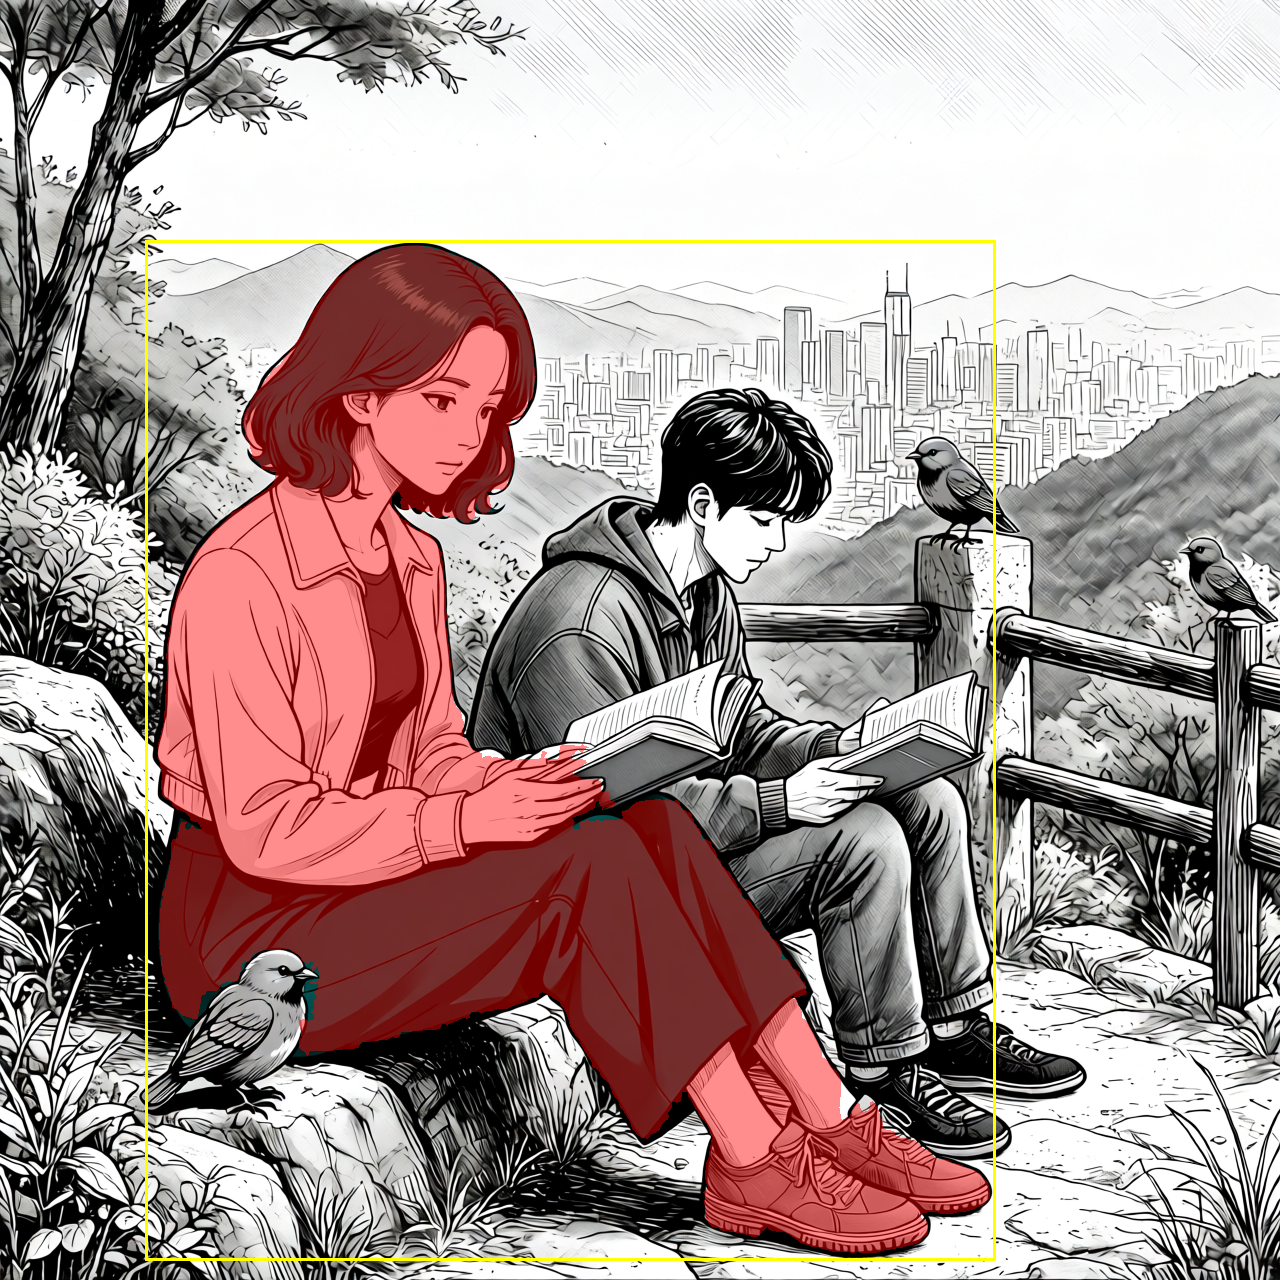
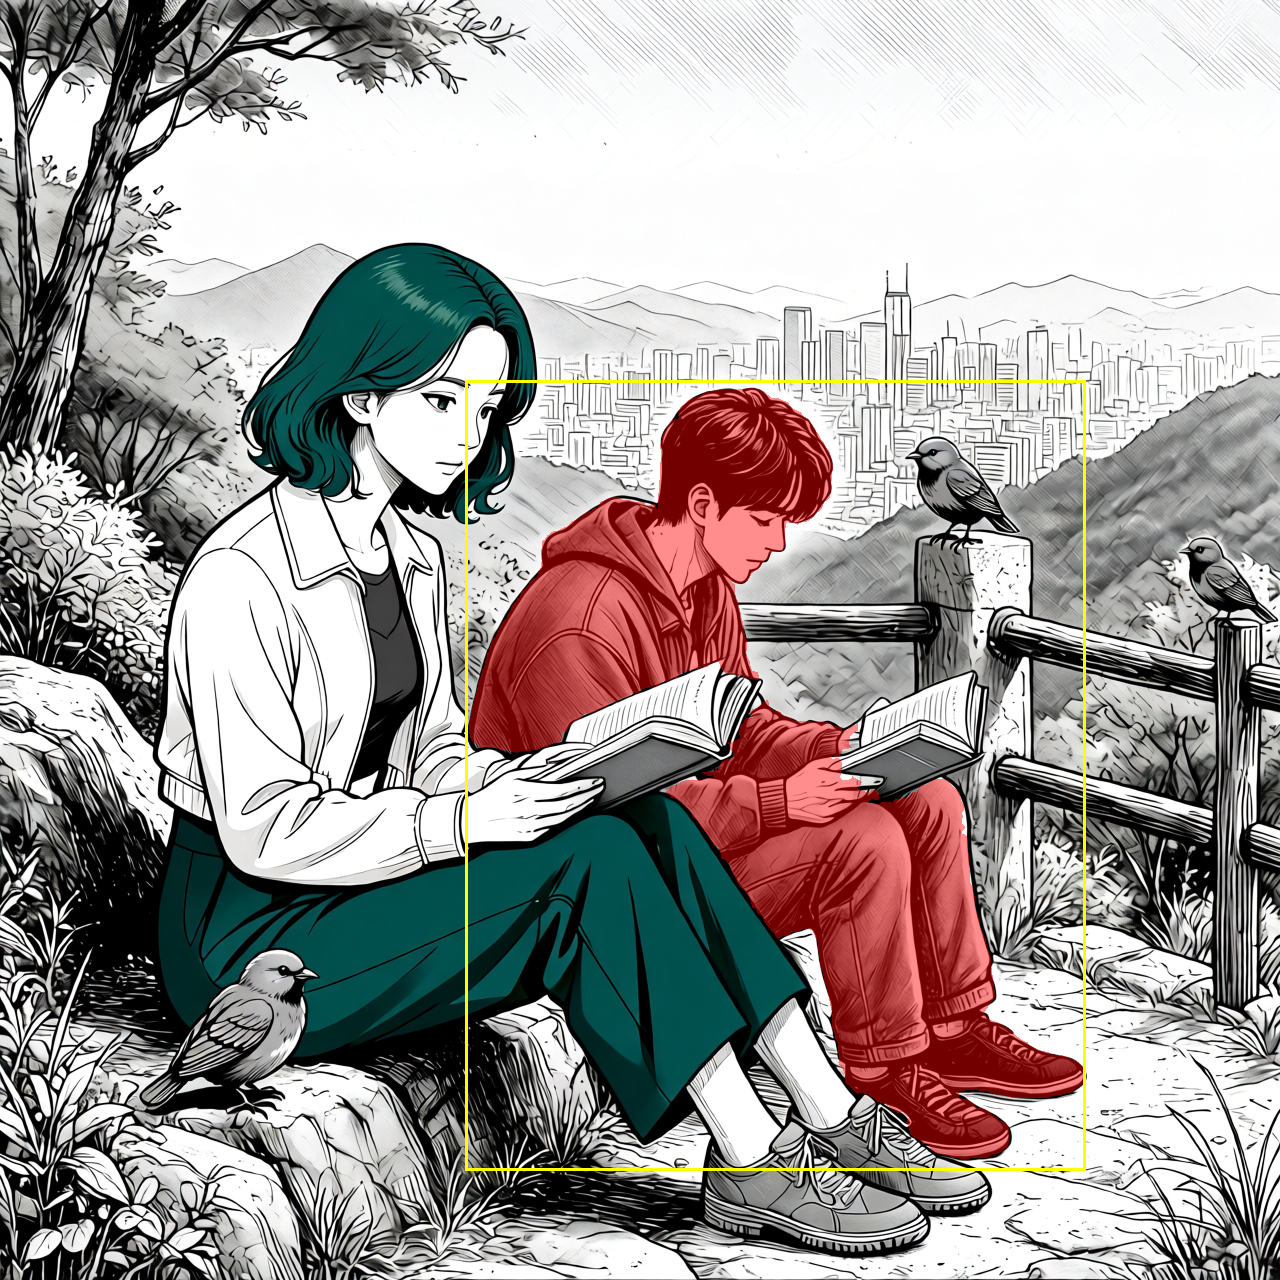
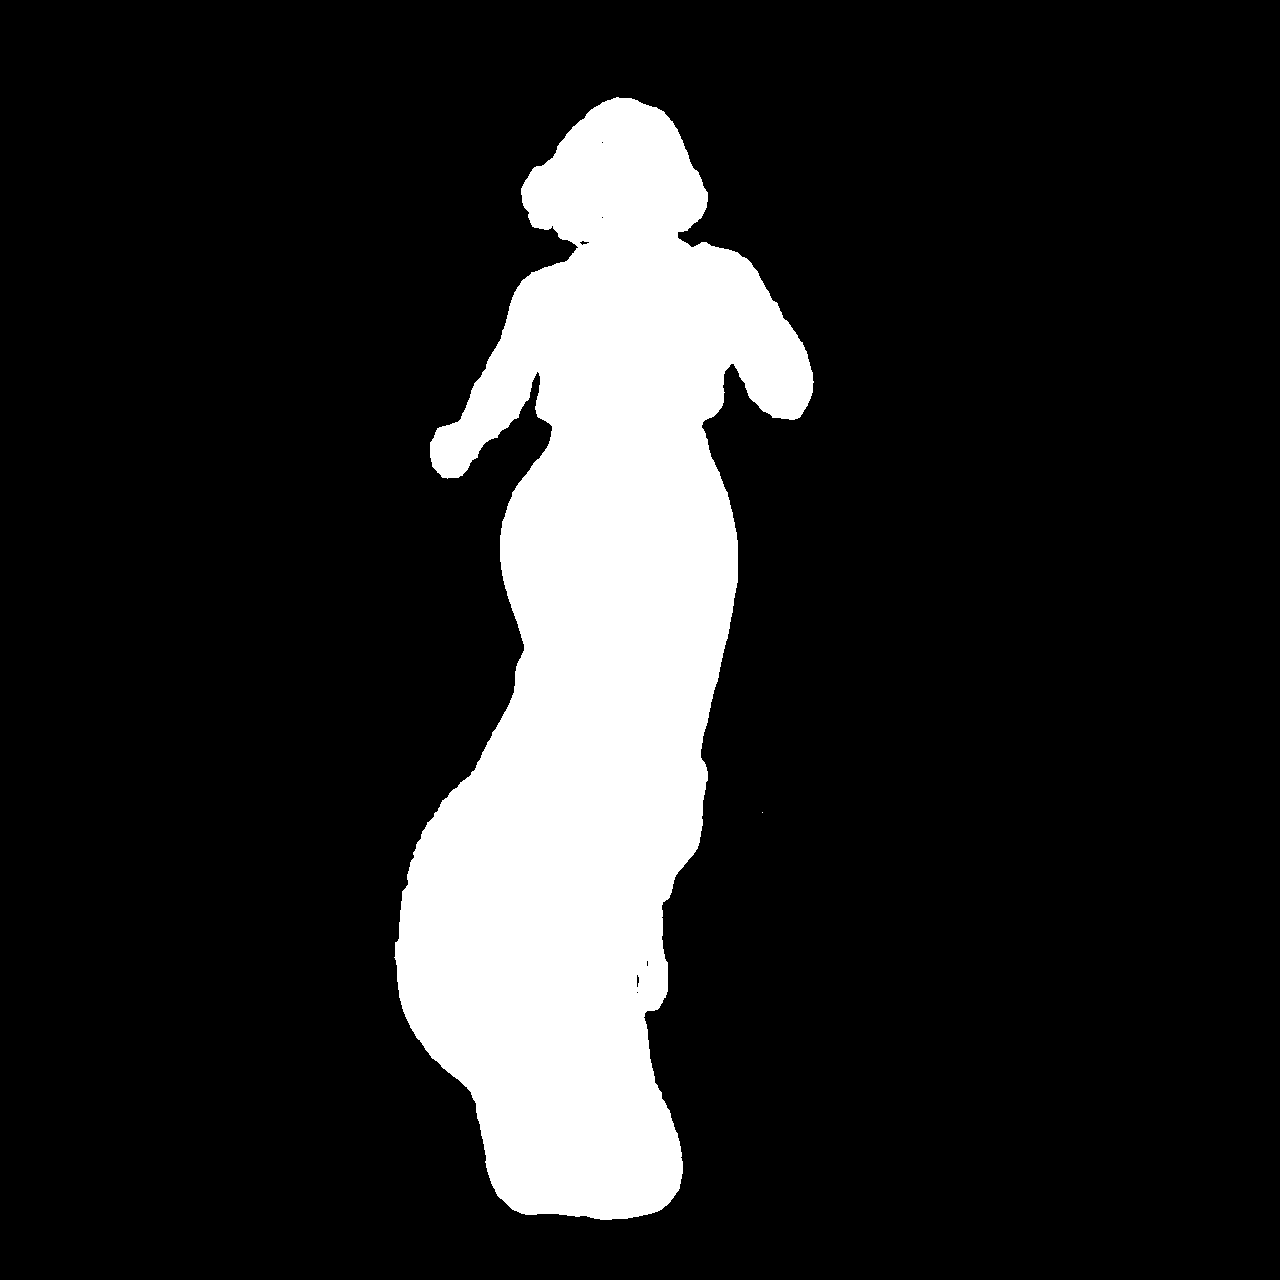
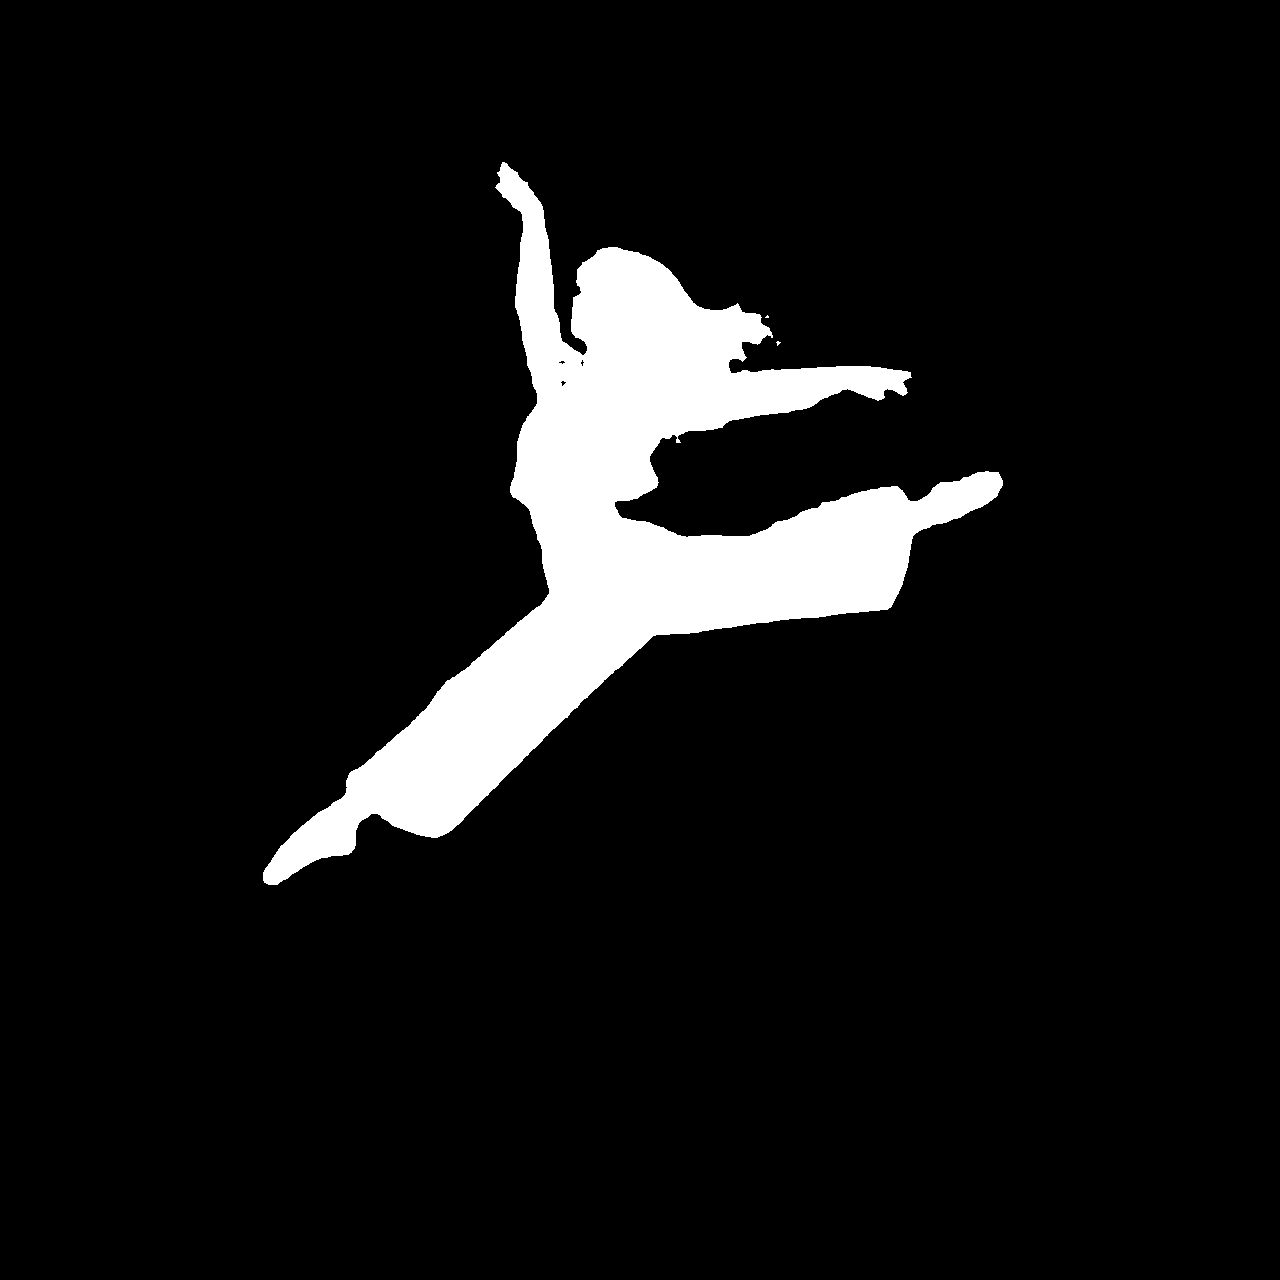
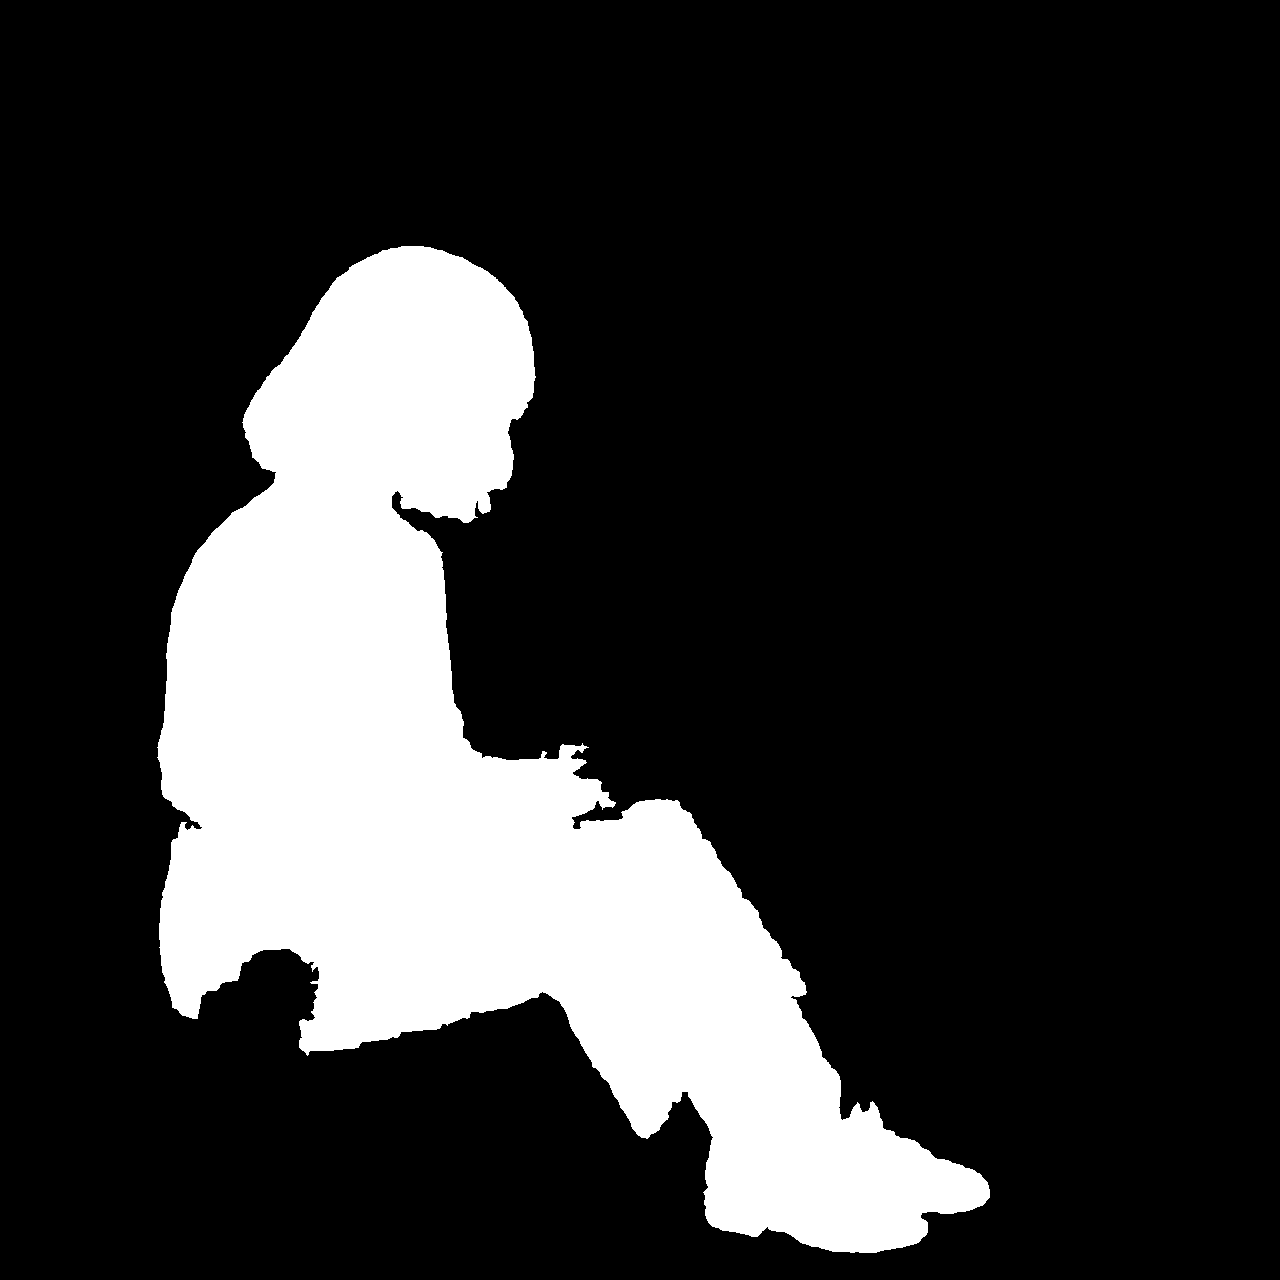
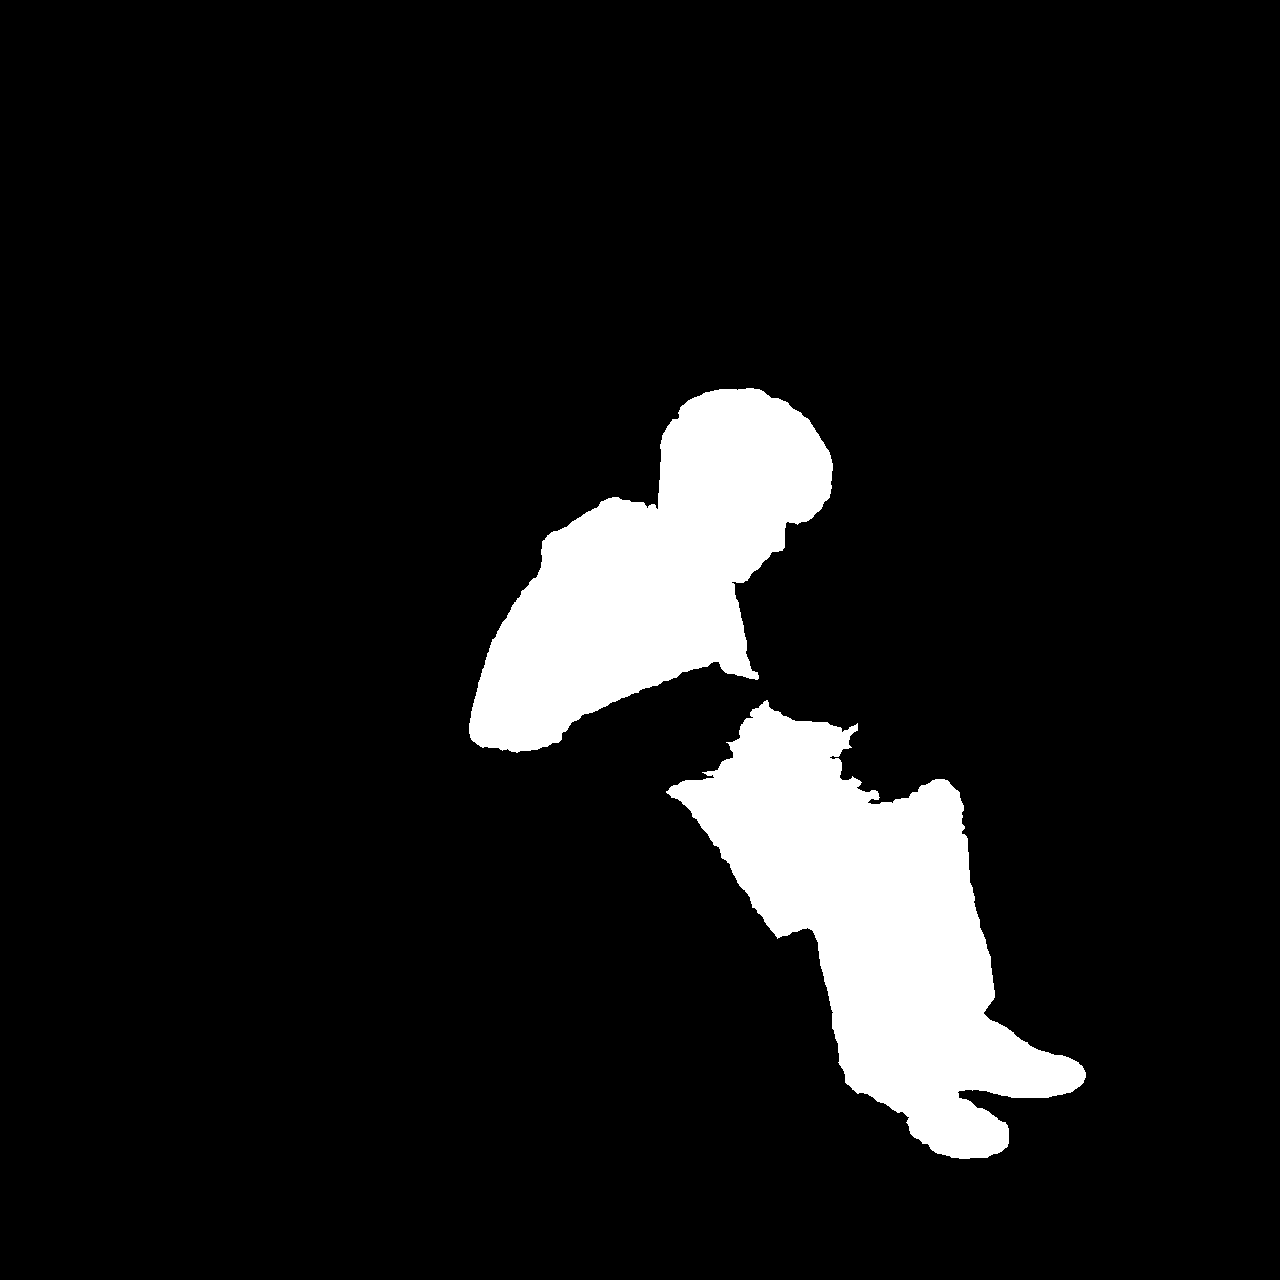
먼저 장면에서 어느 인물을 분리할지 지정한다. 로컬 GPU에서 Grounding DINO Tiny로 인물 상자를 찾고 SAM 2.1 Hiera Small로 마스크를 만들었다. 여기서 마스크는 복사할 인물 픽셀을 흰색, 제외할 영역을 검은색으로 표시한 이미지다. 모델이 Mira라는 이름을 알아본 것은 아니다. 청록색 머리와 위치를 눈으로 확인한 뒤 대상 좌표를 지정했으며, 겹친 영역은 상자·포함점·제외점을 모델에 전달해 다시 추론했다. C에서는 포함점이 놓인 마스크 조각을 유지하고 작은 내부 구멍을 채우는 후처리도 사용했다. Grounding DINO 모델 카드 · SAM 2.1 모델 카드
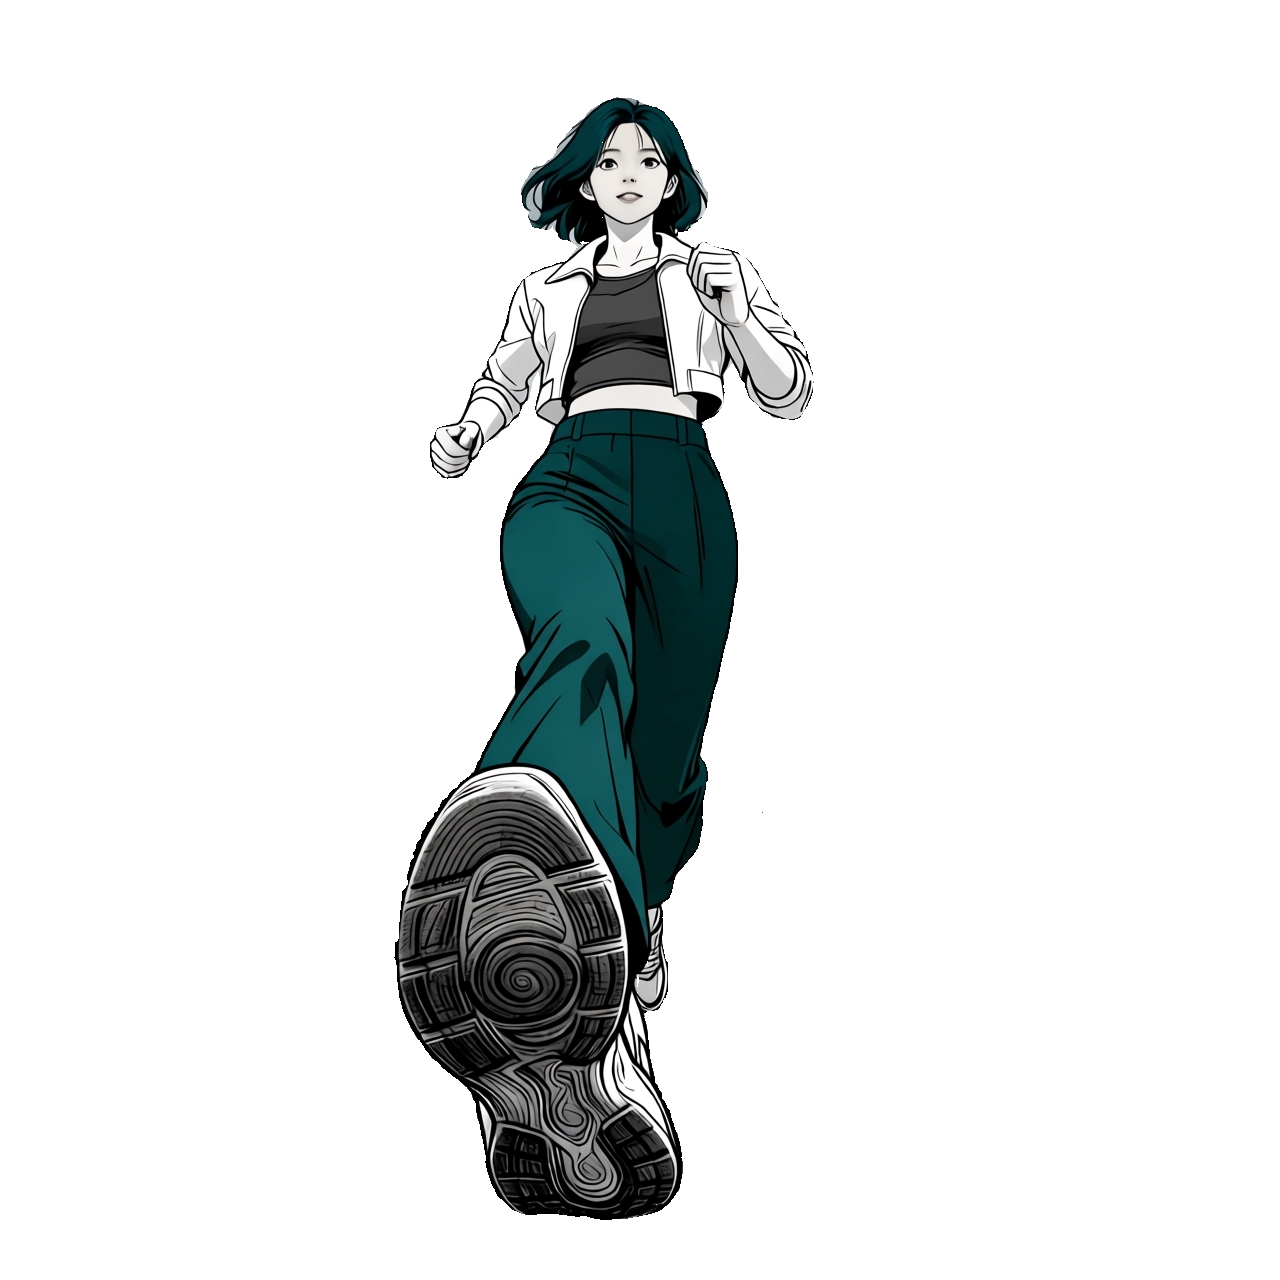
A에서는 화면 앞으로 크게 나온 신발 끝까지 포함하고 배경의 달리는 사람은 제외했다. B에서는 도약하는 Mira만 선택하고 토끼와 다람쥐를 제외했다. C에서는 Mira와 조연을 따로 선택했다. 조연은 Mira에 가려 상체와 하체가 떨어져 보이므로, 가장 큰 덩어리 하나만 남기면 상체가 사라질 수 있다. 이번에는 포함점이 놓인 여러 덩어리를 함께 유지했다.
마스크와 컷아웃 결과
아래 흰 배경 컷아웃은 분리 영역을 확인하는 이미지다. 함께 저장한 투명 PNG는 같은 마스크를 알파 채널로 사용한다. 네 파일 모두 원본과 같은 1280×1280 캔버스와 인물 위치를 유지하며, 선택된 픽셀의 색을 원본에서 그대로 복사했다.
마스크 오버레이
| Scene A Mira | Scene B Mira | Scene C Mira | Scene C 조연 |
|---|---|---|---|
 |  |  |  |
마스크 이미지
| Scene A Mira | Scene B Mira | Scene C Mira | Scene C 조연 |
|---|---|---|---|
 |  |  |  |
분리 결과
| Scene A Mira | Scene B Mira | Scene C Mira | Scene C 조연 |
|---|---|---|---|
 | 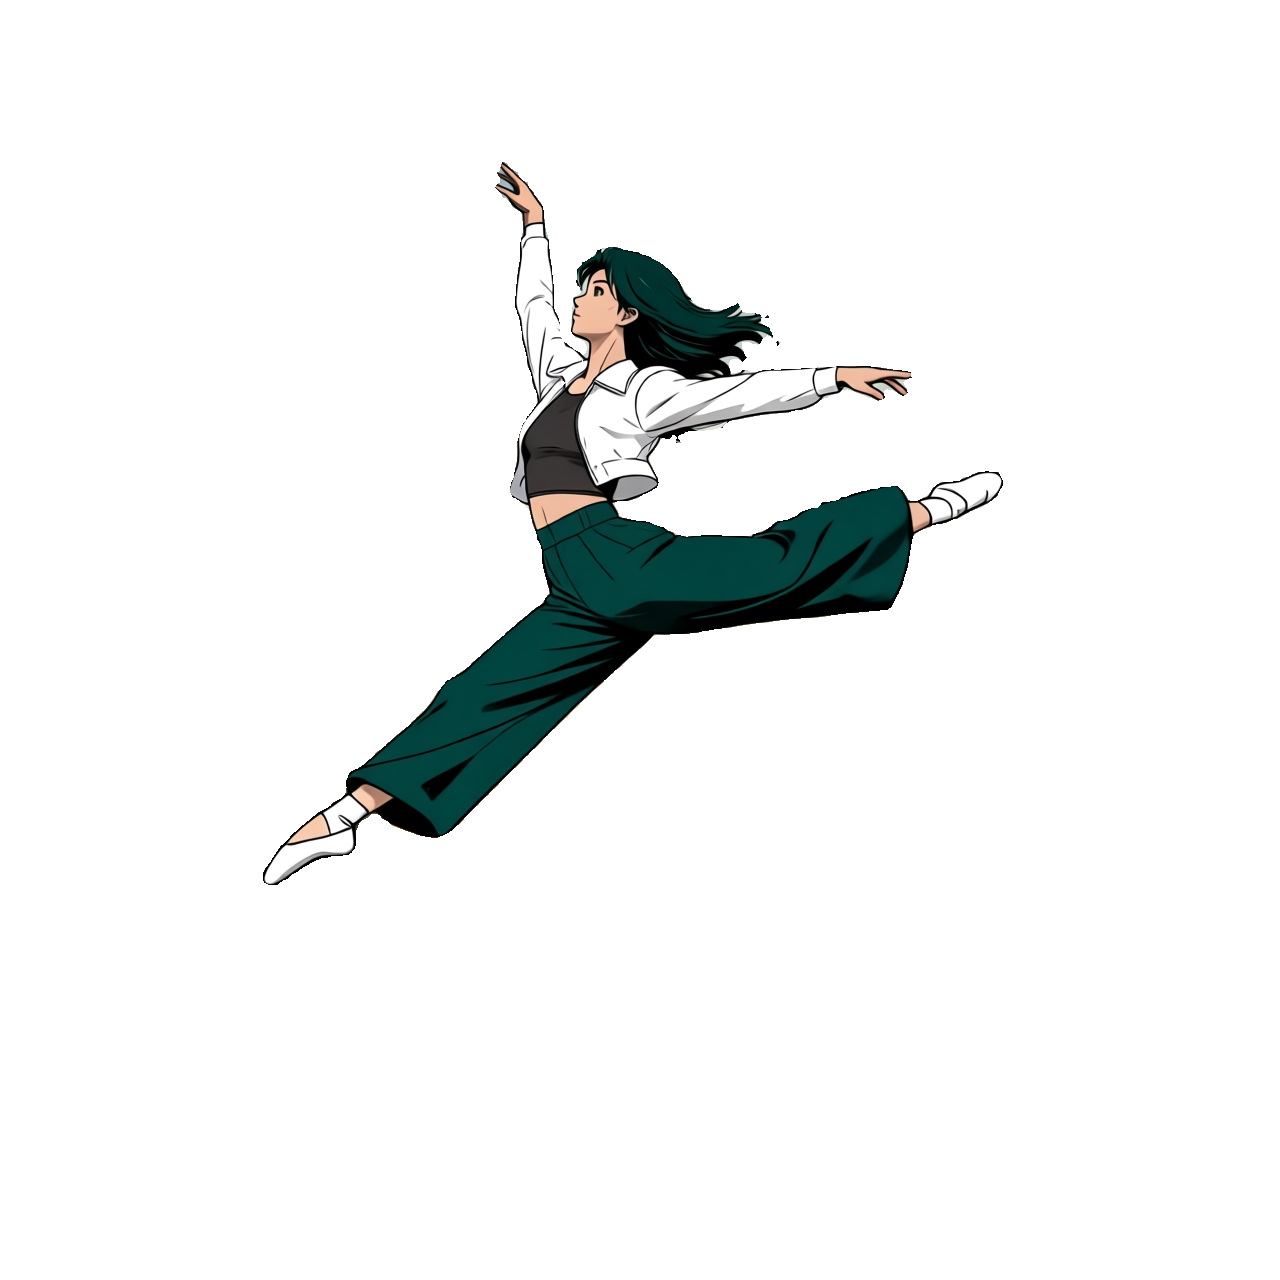 | 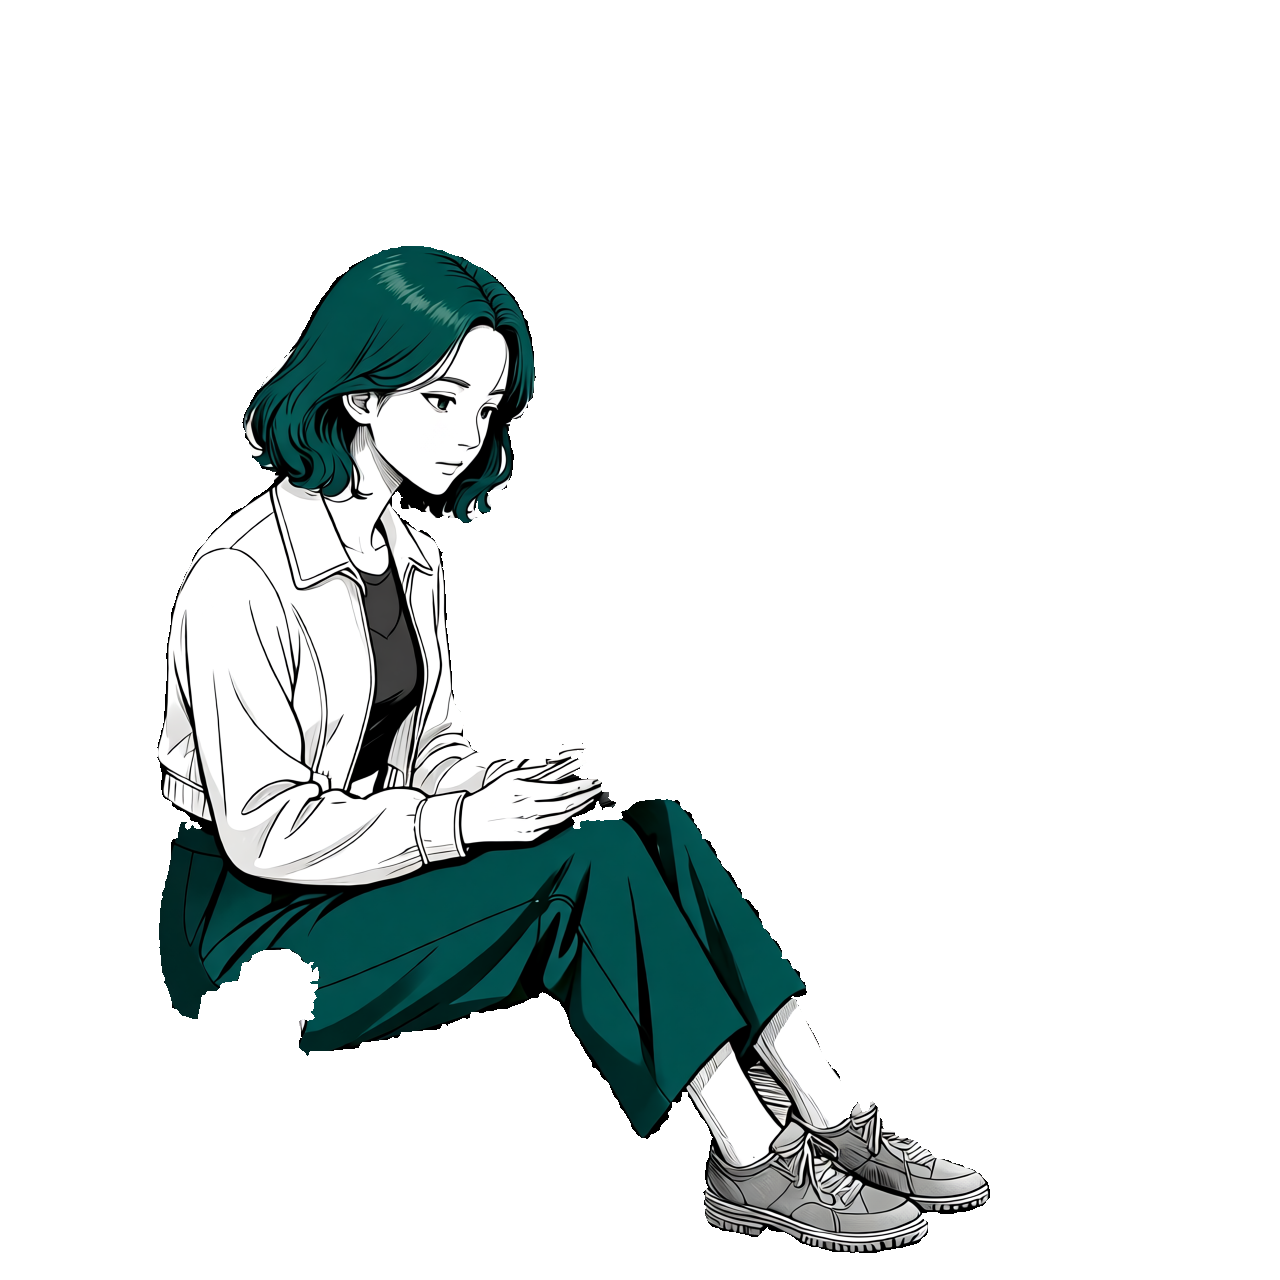 | 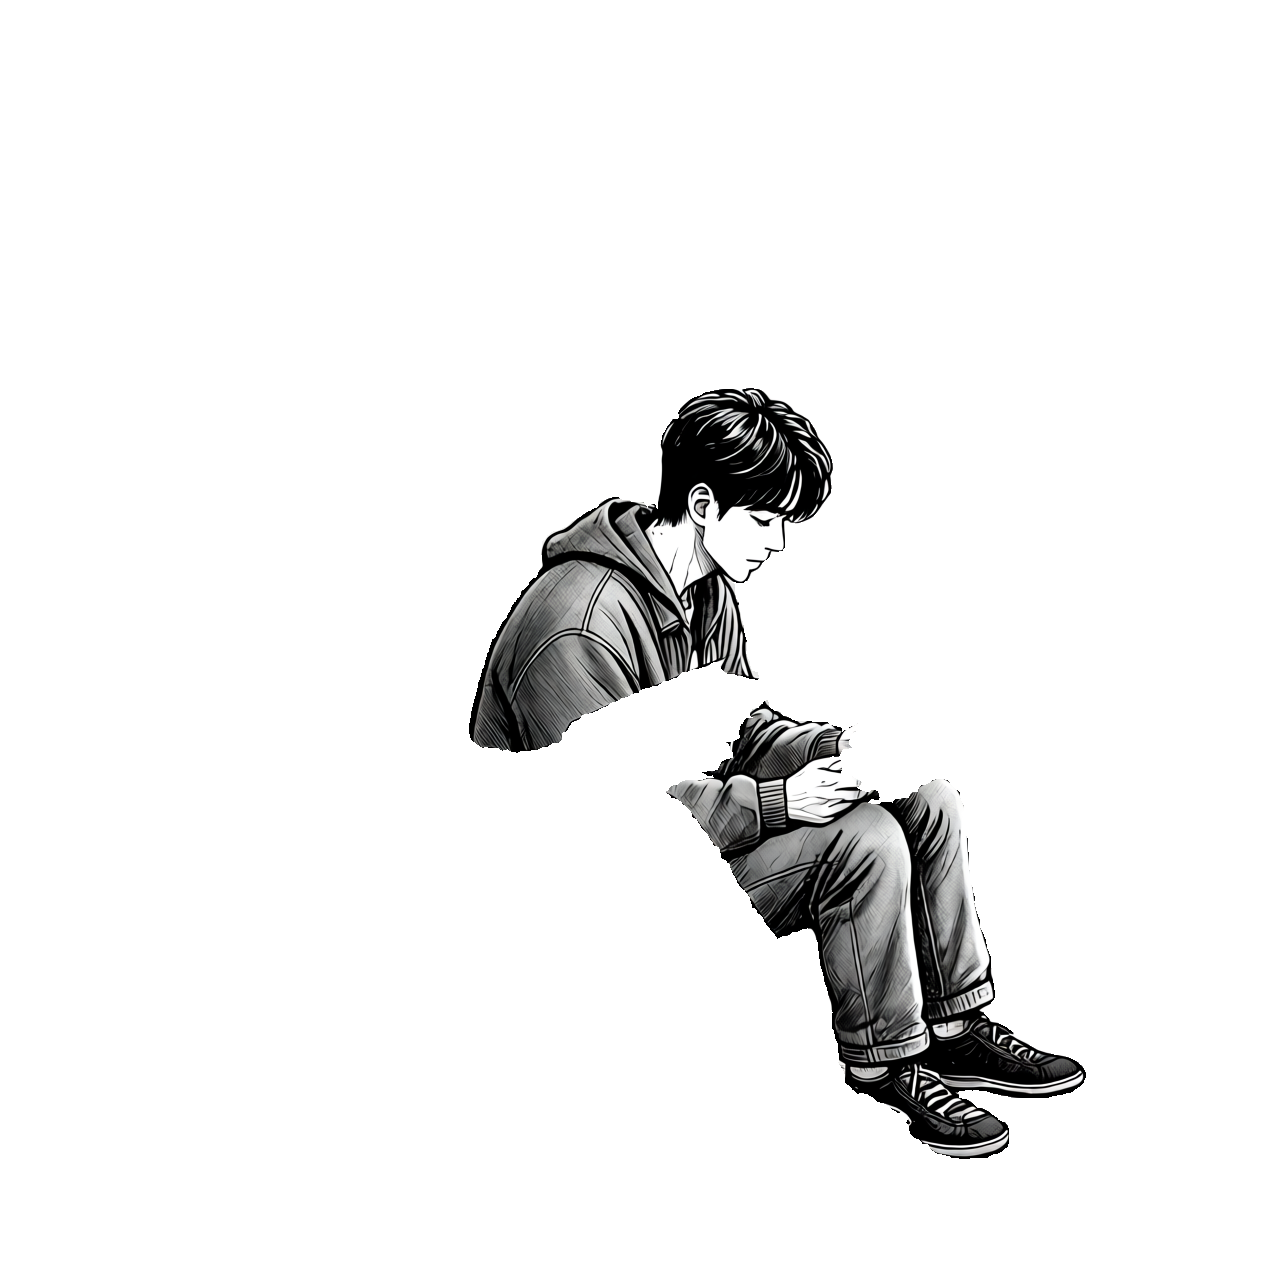 |
Scene A Mira
Scene B Mira
Scene C Mira
Scene C 조연
분리 결과의 한계
C의 빈 부분은 다른 인물·책·새에 가려져 원본에 보이지 않는 영역을 포함한다. 이번 작업은 보이는 픽셀을 분리한 것이며, 가려진 신체를 새로 그리지 않았다. 손과 책, 머리카락과 배경이 맞닿는 경계에는 일부 거친 가장자리와 미세 누락이 남아 있다. 다른 배경에 옮길 때는 이 경계를 다시 확인해야 한다. 두 C 마스크 사이에는 경계의 중복 픽셀 10개가 남아 있다.
인물별 입력·선택 조건과 실행 기록에 네 분리 결과를 모았다.
분리한 캐릭터의 외형과 소품을 적용한다
아이덴티티는 같은 인물로 알아볼 수 있는 얼굴·머리 모양·착장 등의 외형을 뜻한다. 분리 단계가 원본에서 보이는 픽셀을 고르는 작업이라면, 외형 적용은 참조나 텍스트에 따라 다시 생성하는 작업이다. 컷아웃이 전달한 포즈·인물 크기·프레이밍이 그대로 유지되는지는 결과에서 별도로 확인한다.
A·B·C의 Mira는 P7-5.3 최종 착장을 참조하고, C 조연은 텍스트로 새 외형을 지정한다. 같은 컷아웃 단계에서 출발해도 외형·소품을 보강하는 순서는 다르다.
| 대상 | 채택한 캐릭터 처리 경로 |
|---|---|
| A Mira | 컷아웃 → 직접 아이덴티티 적용 → BFS → DeLight |
| B Mira | 컷아웃 → 마네킨 → 착장·신발 1차 적용 → BFS → DeLight |
| C Mira | 컷아웃 → 마네킨 → 착장·신발 1차 적용 → 책 보강 → BFS → DeLight |
| C 조연 | 컷아웃 → 텍스트 아이덴티티 적용 → 책 보강 → DeLight |
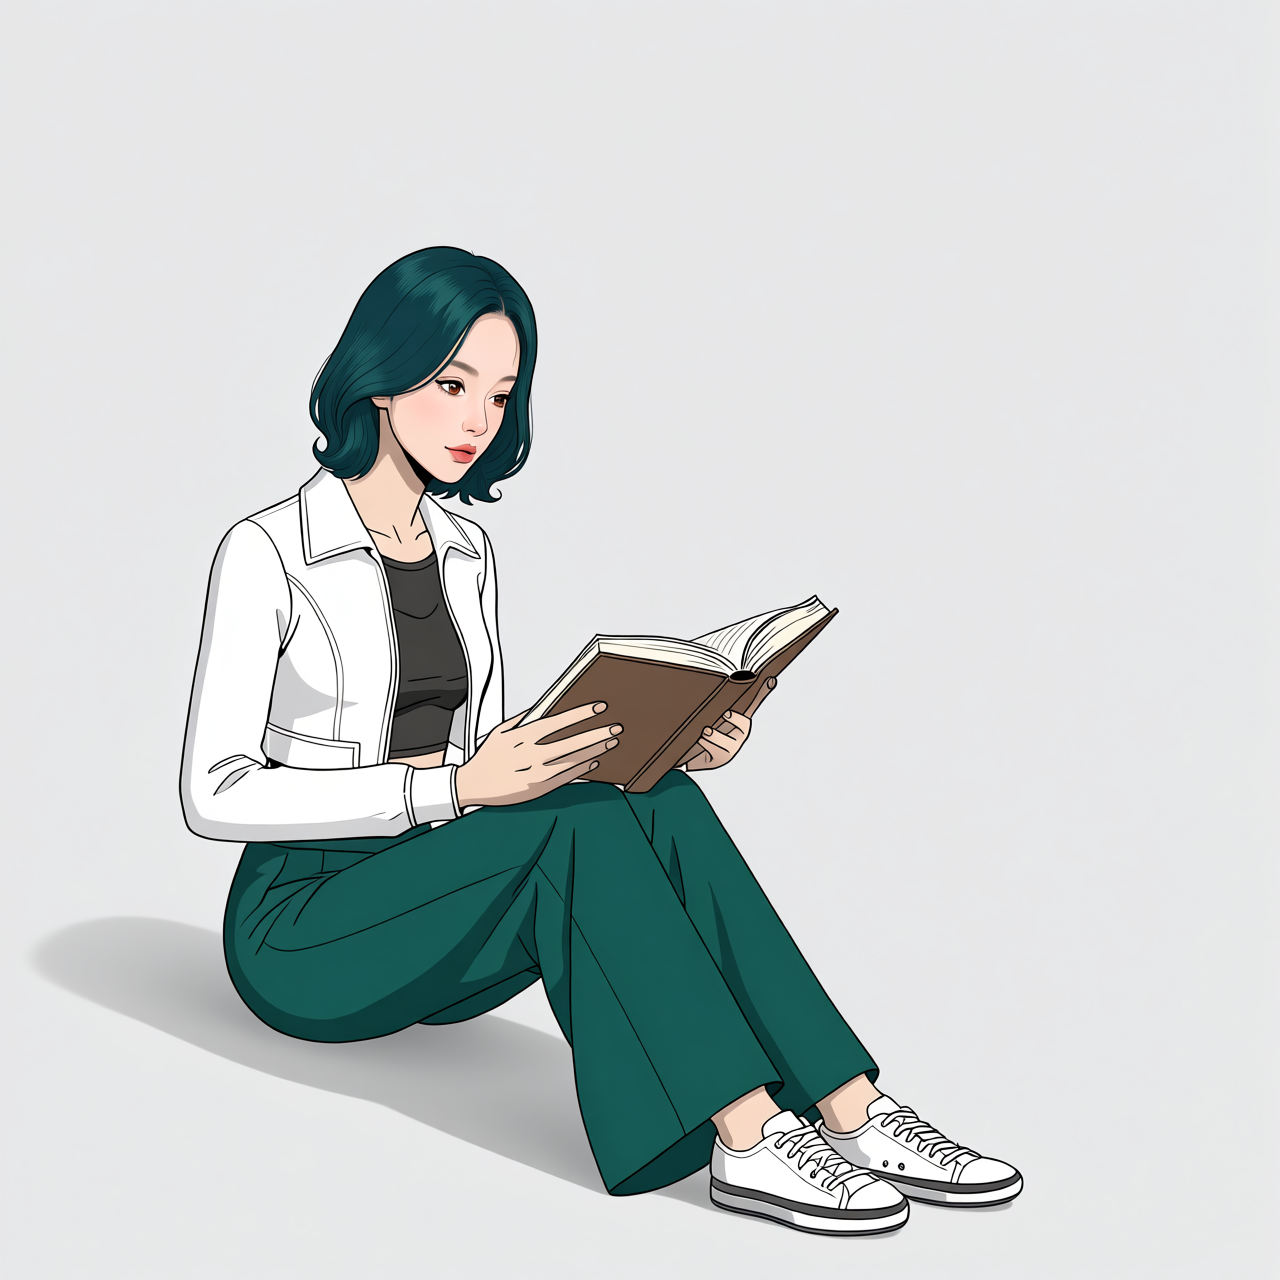
A Mira와 C 조연에 직접 적용한다
A Mira와 C 조연의 흰 배경 컷아웃을 Qwen Image Edit 2511에 각각 넣는다. B·C Mira는 아래의 마네킨 단계를 거쳐 착장을 적용한다. 분리할 때 만든 마스크는 이 편집 단계에 전달하지 않는다. 따라서 결과는 원본 픽셀을 복사한 컷아웃과 달리, 포즈·얼굴·옷·경계가 함께 바뀔 수 있는 생성 이미지다. 출력 PNG도 투명 레이어가 아닌 흰 배경 이미지다.
| 대상 | Picture 1 | Picture 2 또는 텍스트의 역할 |
|---|---|---|
| A Mira | A Mira 컷아웃 | P7-5.3 최종 3단계 착장에서 인물 외형·착장 참조 |
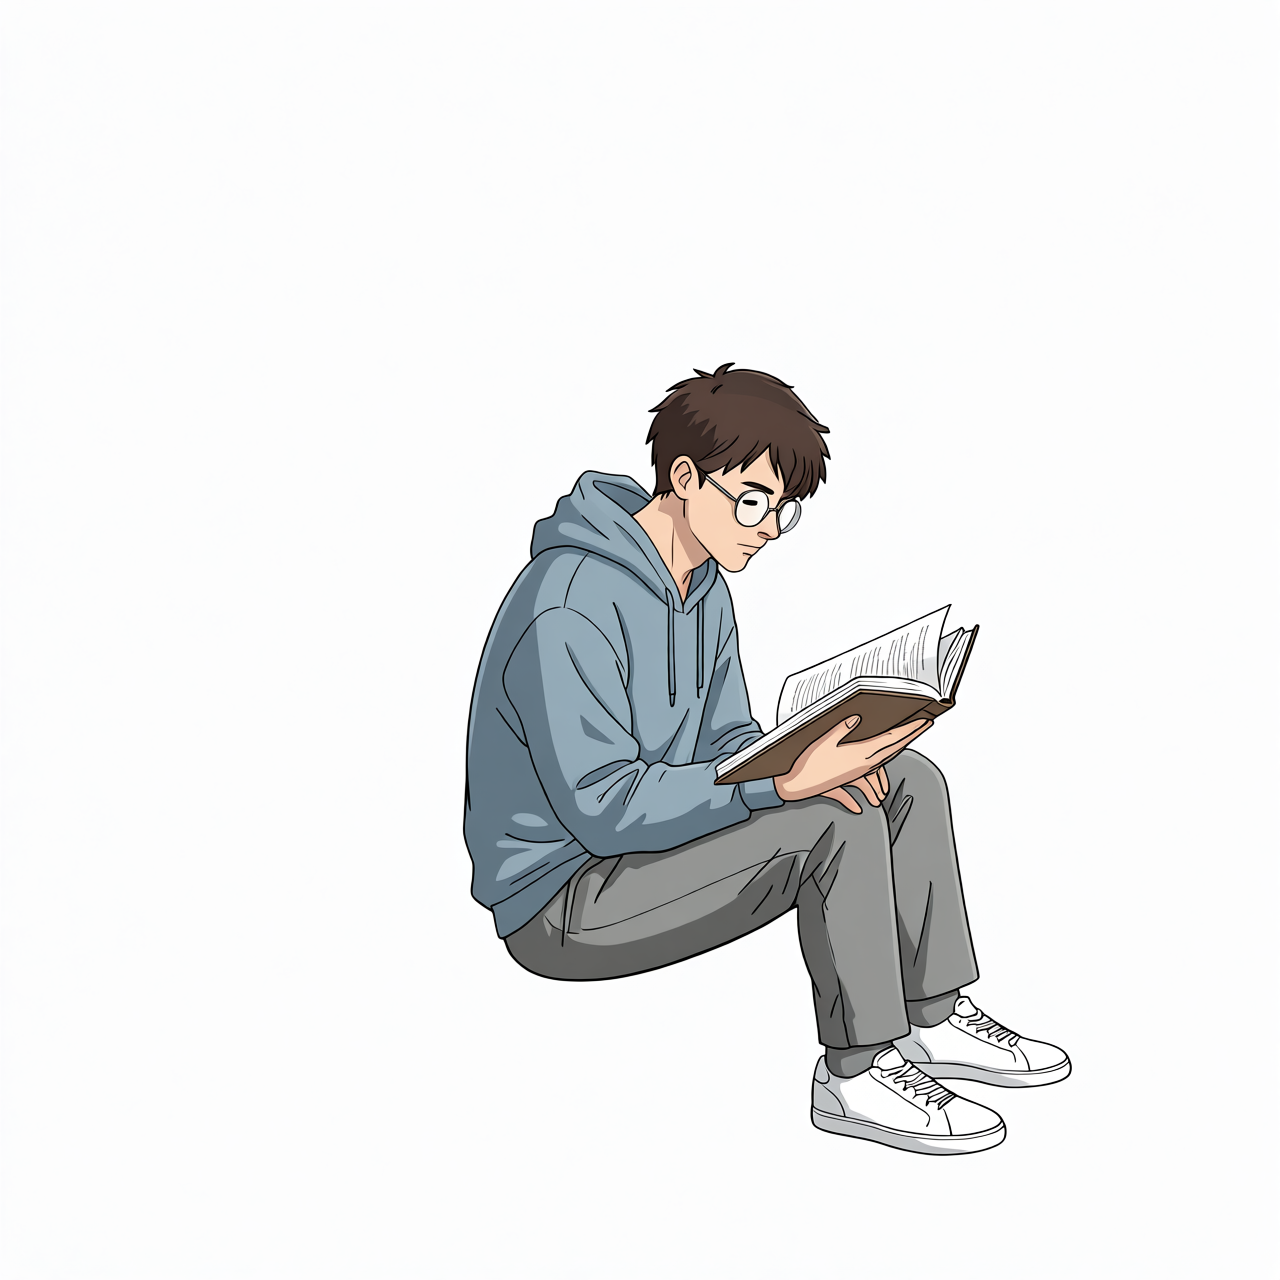
| C 조연 | 신규 조연 컷아웃 | 두 번째 이미지 없이 텍스트로 새 외형 지정 |
Mira의 P7-5.3 최종 3단계 착장 참조를 A Mira의 외형 참조로 사용한다. Mira의 외형을 텍스트로 다시 묘사하지 않고 다음 지시를 전달했다.
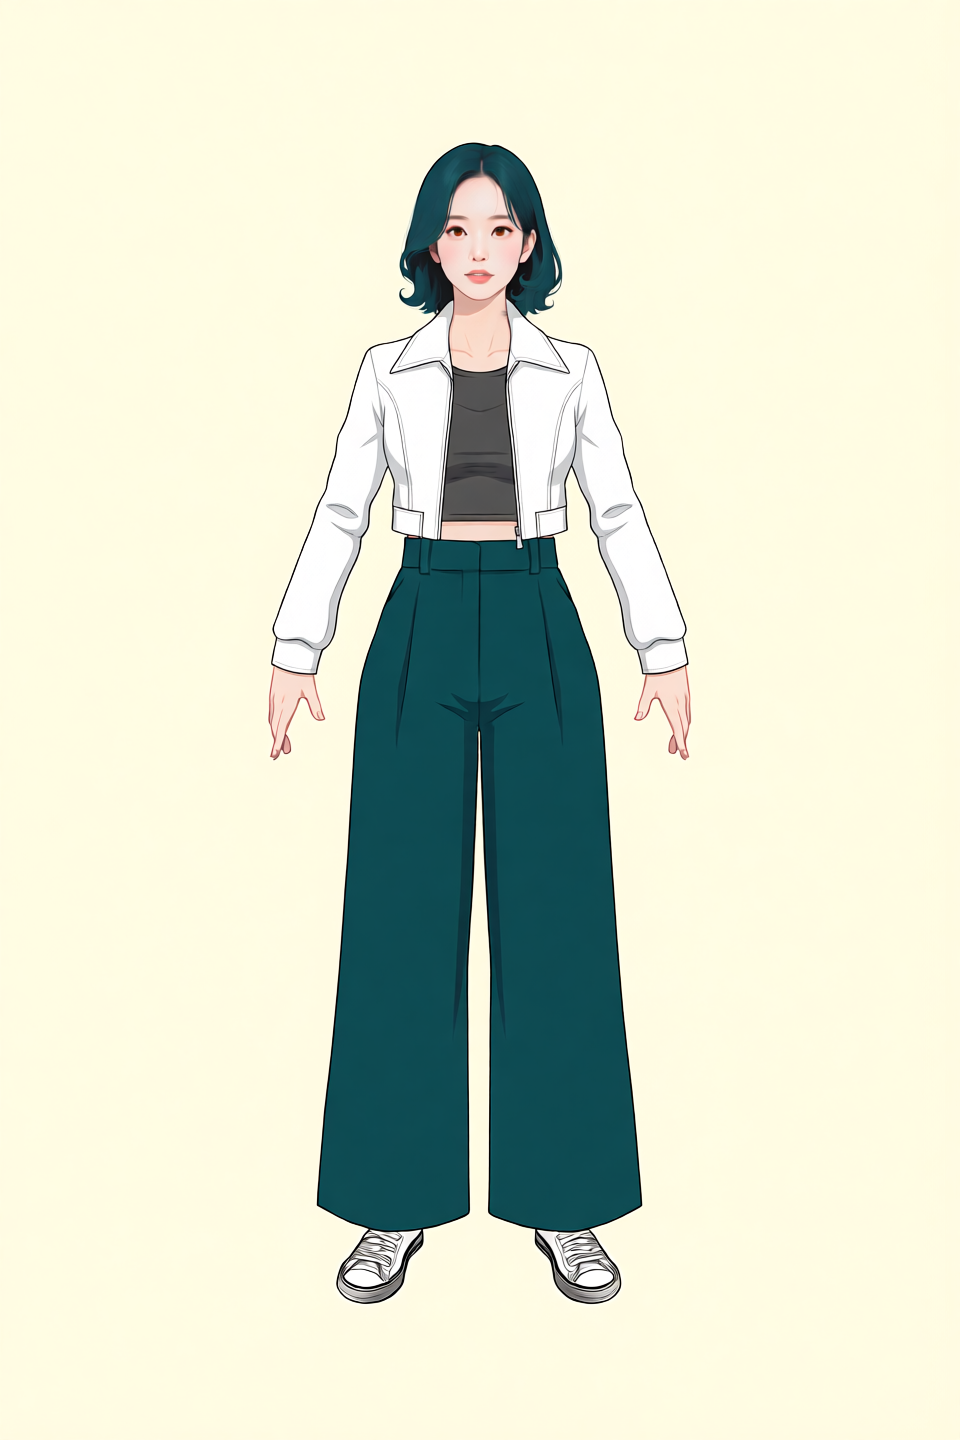
Replace the woman in Picture 1 with the woman in Picture 2, preserving the pose. Preserve the framing and white background of Picture 1.
이는 1번 여성의 포즈를 유지하면서 2번 여성으로 교체하고, 1번의 프레이밍과 흰 배경을 보존하라는 뜻이다. C 조연에게는 별도 인물 참조 대신 다음 지시로 짧은 갈색 머리, 둥근 안경, 파란 후드티, 차콜색 바지와 흰 스니커즈를 지정했다.
Give the man in Picture 1 a new character identity: a young adult man with short dark brown hair, round glasses, a muted blue hoodie, charcoal trousers, and white sneakers. Preserve the seated pose, body proportions, framing and white background of Picture 1.
아이덴티티 적용 결과
| Scene A Mira | Scene C 조연 |
|---|---|
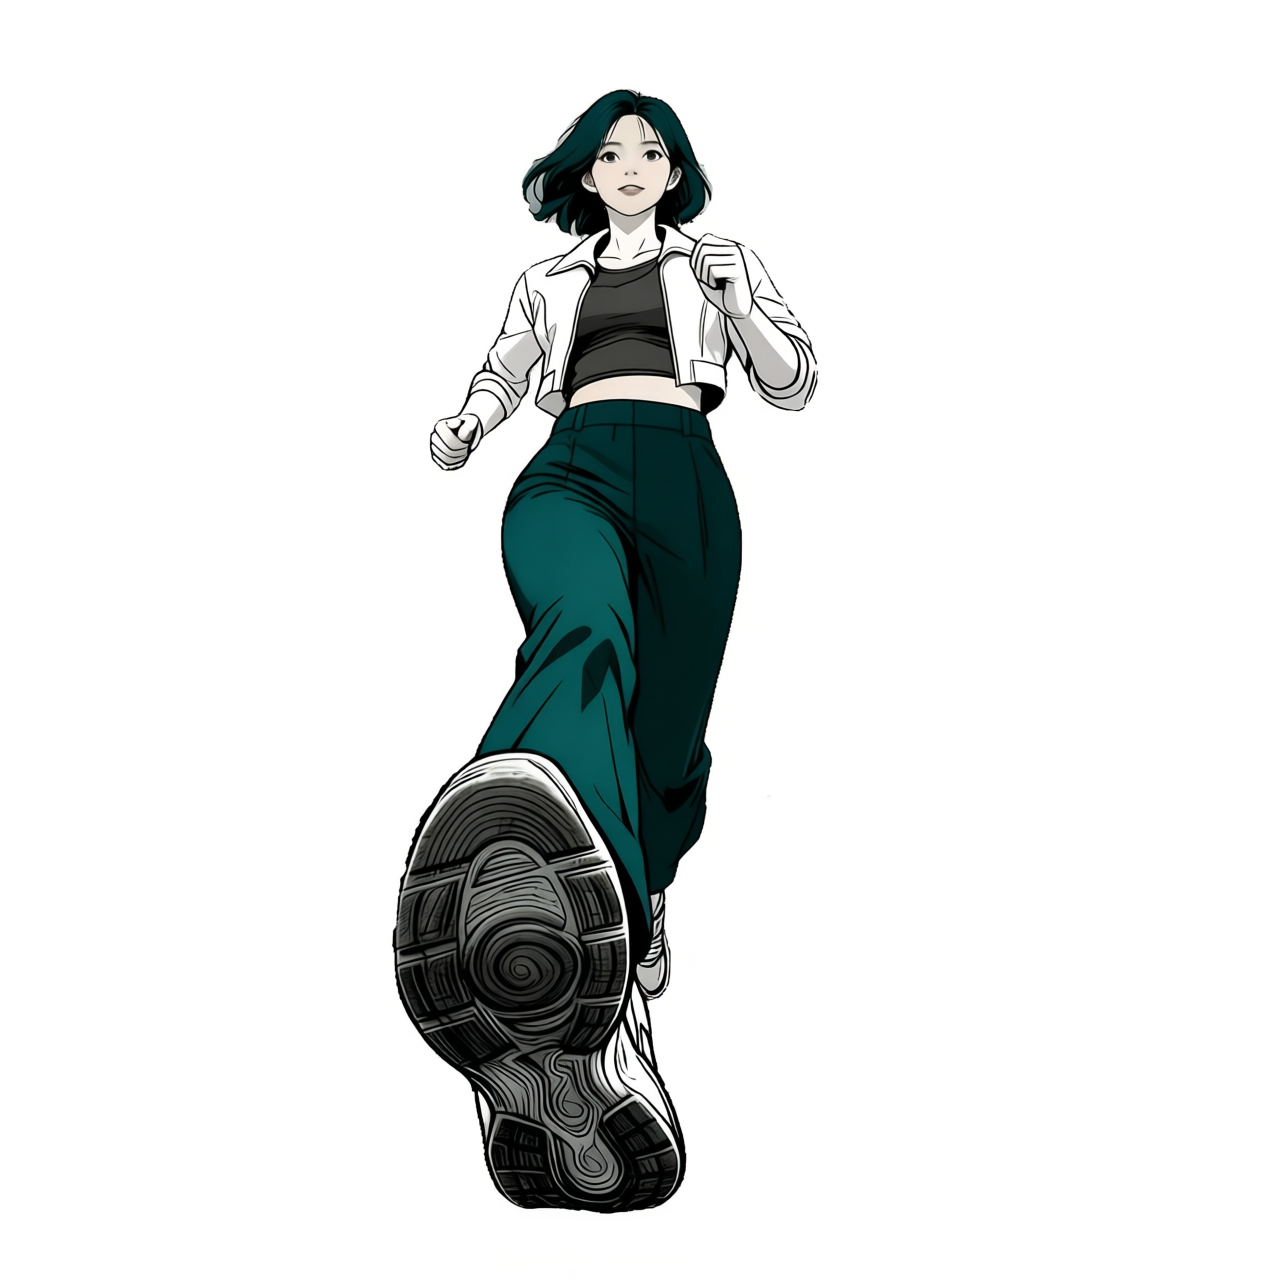 | 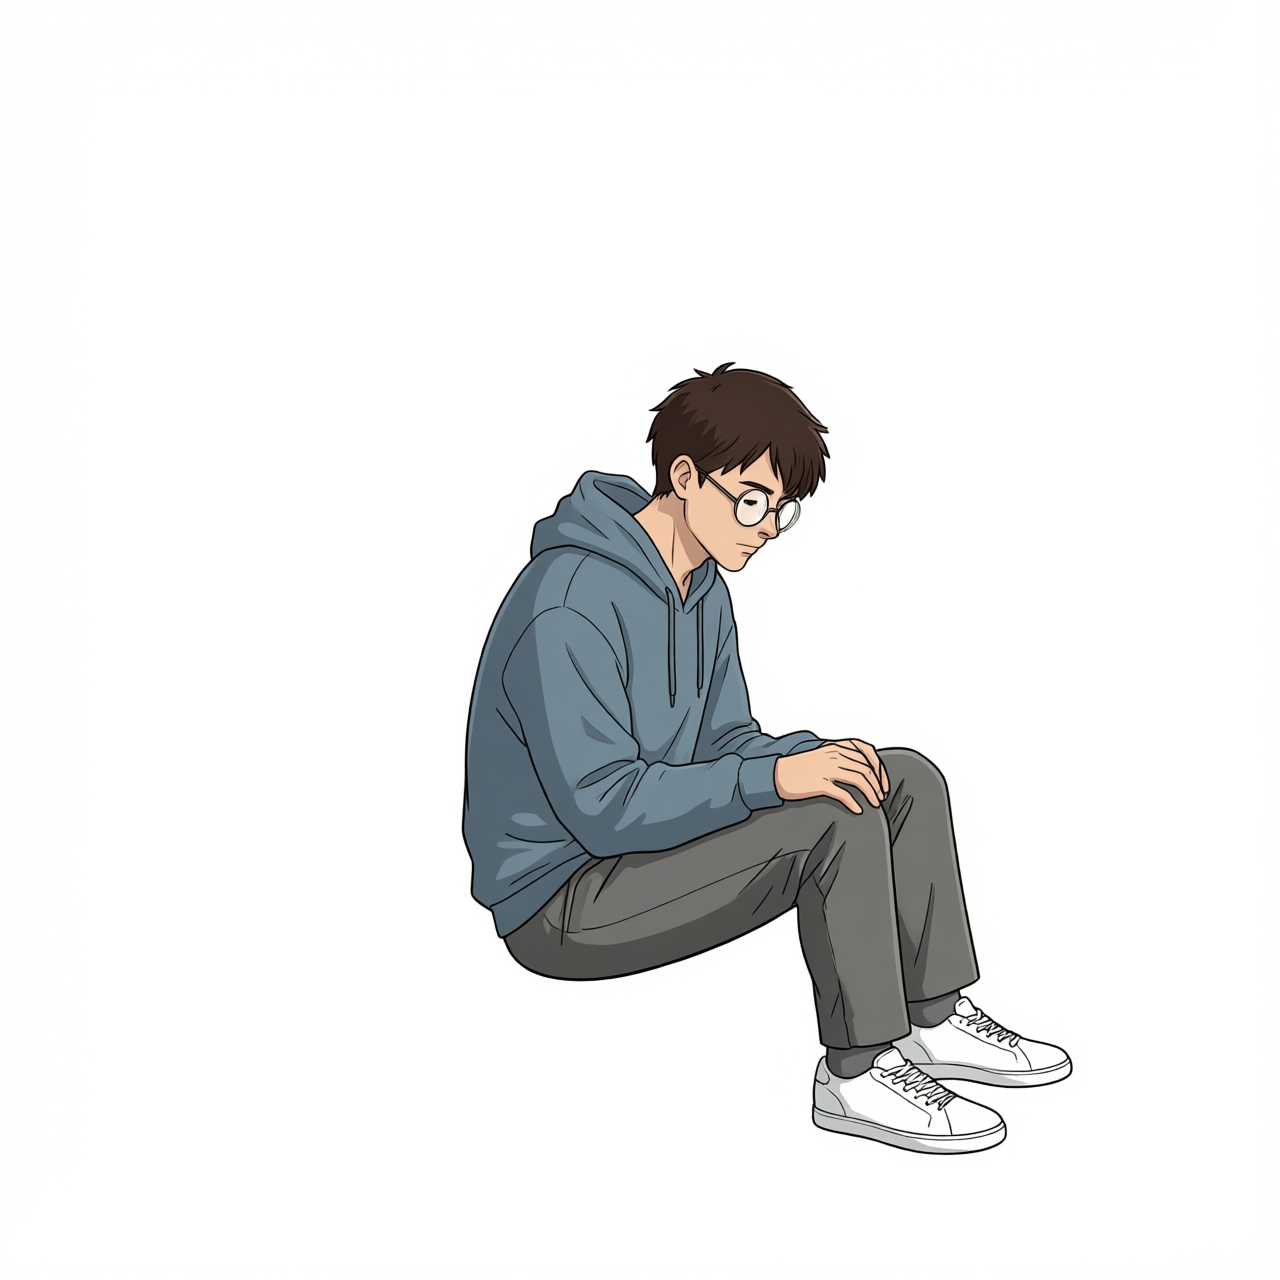 |
A는 신발 부분에 오류가 남았다. 앞쪽 발에서 밑창이 크게 보이는 구조라 신발 형태를 안정적으로 바꾸지 못했고, 이 입력·참조·30스텝 조건에서는 적용 가능한 개선 방안을 확보하지 못했다. 따라서 이 사례는 신발 밑창처럼 큰 전경 구조를 참조 외형으로 바꾸는 데서 드러난 현재 모델 경로의 한계로 기록한다.
C 조연은 외형 적용 중 책이 사라져 다음 책 보강 단계에서 다시 추가한다. A는 30스텝, B·C의 마네킨·착장·책 보강은 20스텝 결과를 비교한다.
B·C 컷아웃을 마네킨으로 바꾼다
B·C에서는 컷아웃에 남은 머리·옷·신발 외형을 줄인 뒤 새 착장을 적용하기 위해 마네킨을 중간 입력으로 만든다. 흐름은 원본 컷아웃 → 마네킨 → 착장 적용이다. 마네킨은 얼굴 없는 회색 모형이 아니라, 얼굴과 관절 방향을 읽을 수 있는 성인 여성의 포즈용 이미지다. 아주 짧은 스포츠머리, 회색 스포츠 브라와 짧은 하의, 맨발을 지정해 원본의 머리·옷·신발 외형을 먼저 줄인다.
두 장면 모두 아이덴티티 적용 결과가 아니라 분리 단계의 원본 Mira 컷아웃을 입력으로 사용한다. 컷아웃 한 장만 로컬 Qwen Image Edit 2511에 넣고, 마스크·캐릭터 참조·추가 LoRA는 사용하지 않는다. B에는 도약 자세, C에는 앉은 자세를 보존하도록 장면별 자세 지시만 더한다. 원본에서 가려진 신체와 옷 아래 형상은 모델이 새로 그리므로, 이 작업의 결과는 착장 적용을 위한 입력이며 원래 자세를 확정한 복원본은 아니다.
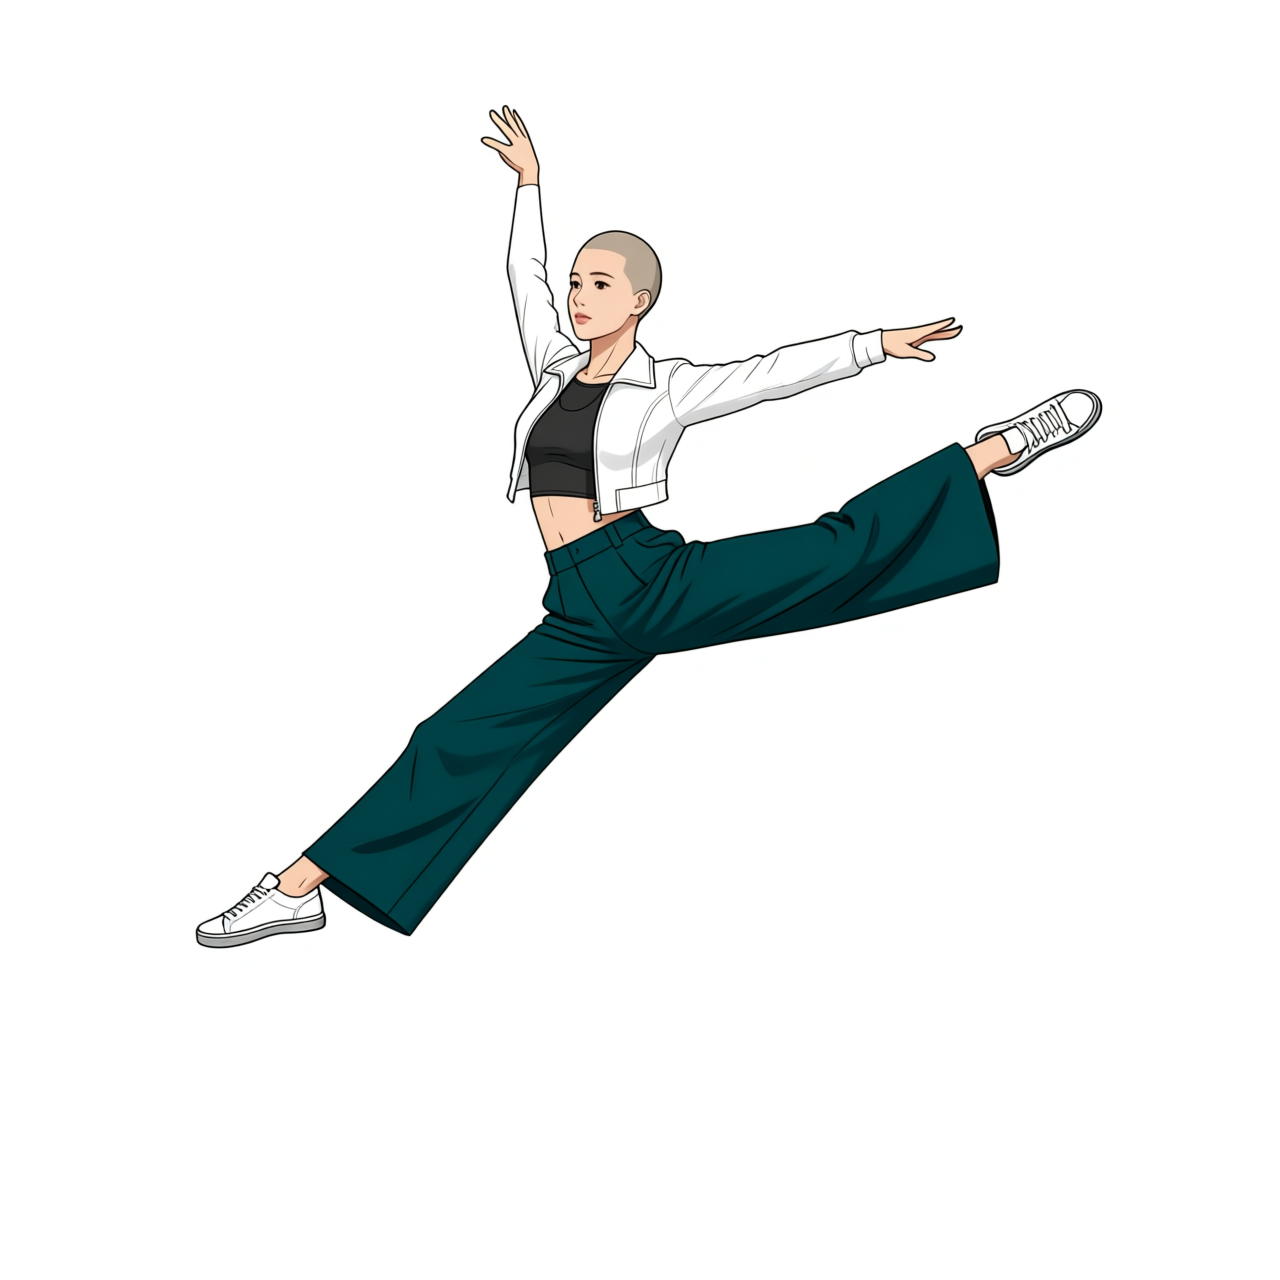
B·C 마네킨 20스텝 결과
| Scene B Mira | Scene C Mira |
|---|---|
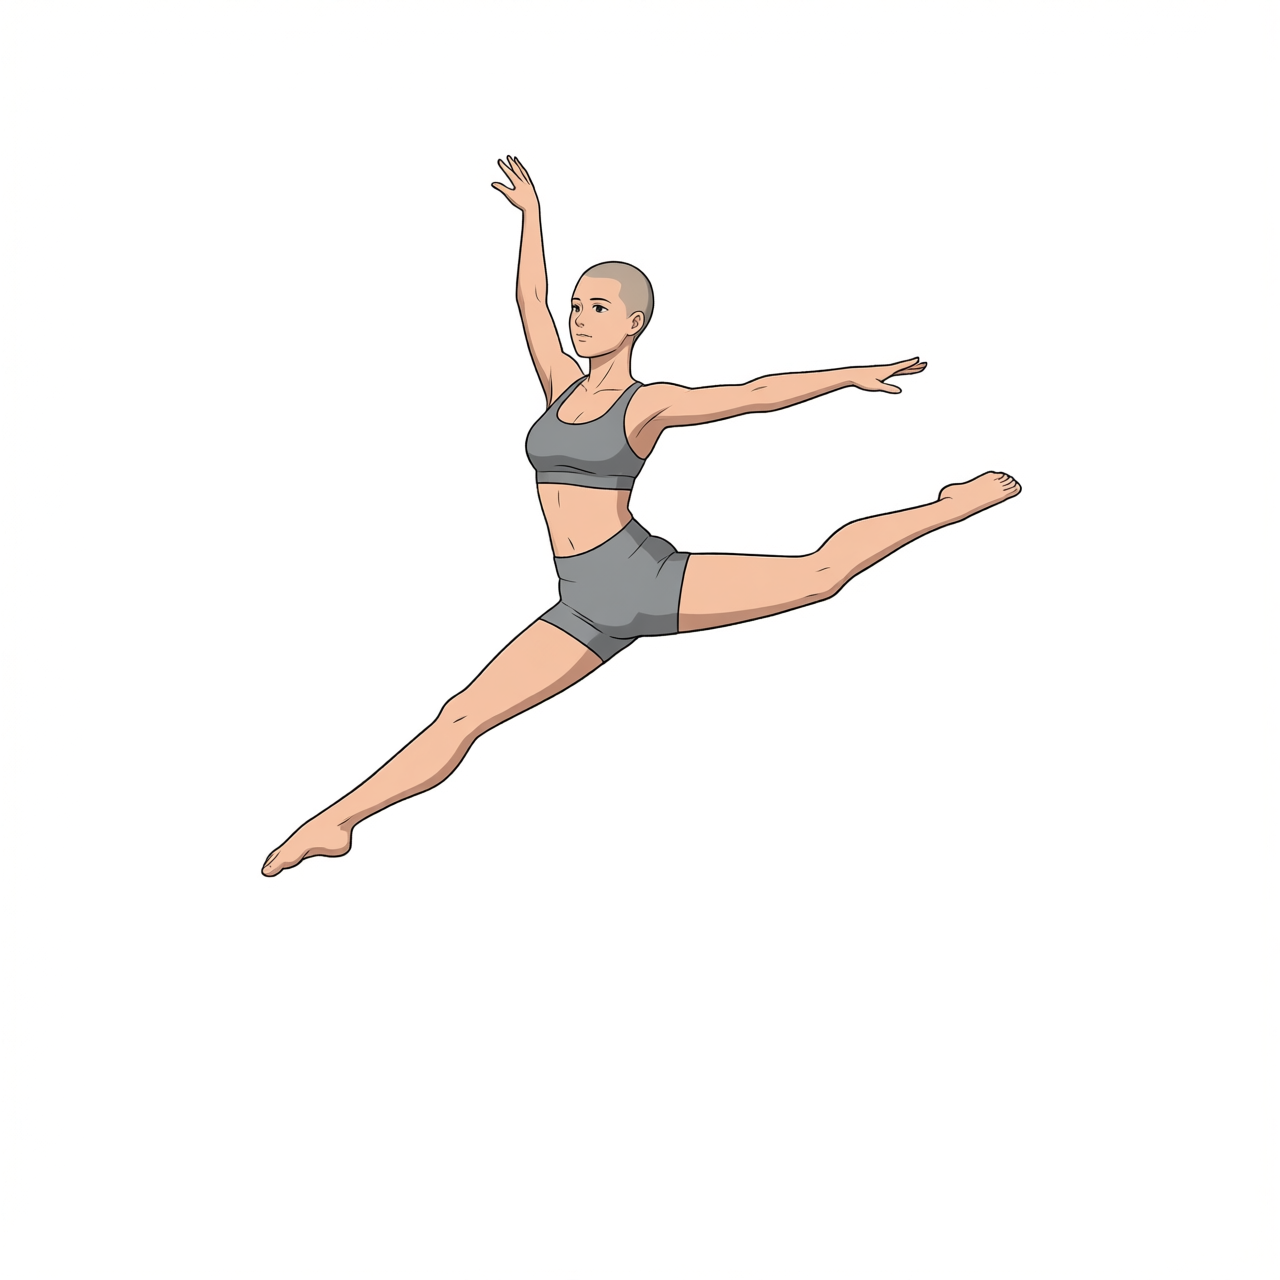 | 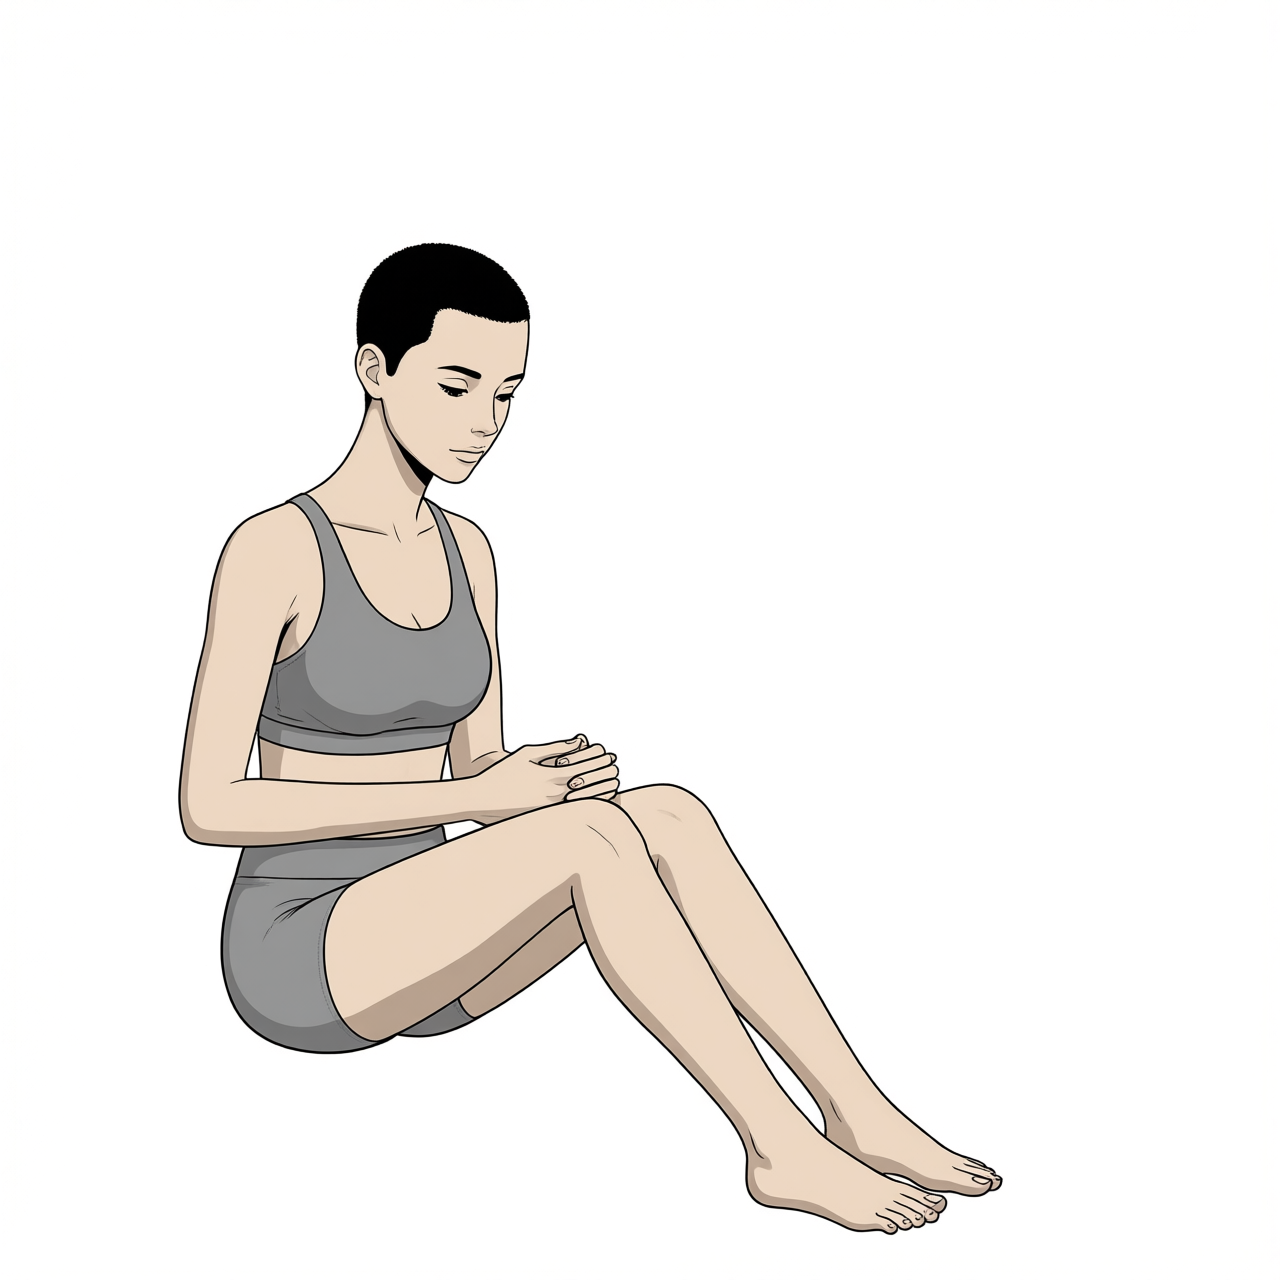 |
B에서는 긴 머리·재킷·바지·신발이 짧은 머리와 회색 운동복·맨발로 바뀌었다. 다리를 벌린 도약 자세의 큰 형태는 남았지만 얼굴 방향과 팔·다리의 세부 각도가 변했다. C에서도 짧은 머리와 회색 운동복·맨발이 반영됐고 앉은 자세는 남았지만, 원본 컷아웃의 빈 가림 영역이 채워지며 손·다리 형태가 변했다. C에서 채워진 신체는 원본에서 확인된 형상이 아니다.
B·C 마네킨에 같은 착장을 적용한다
Picture 1에는 각 장면의 마네킨, Picture 2에는 P7-5.3의 최종 3단계 착장 이미지를 넣는다. 착장·신발 반영과 포즈·크기 보존을 따로 비교하고, 얼굴·머리는 이후 BFS에서 보강한다. 마스크·추가 LoRA·결과 합성은 사용하지 않는다.
공통 3단계 착장 참조를 사용하고, 옷의 색·길이·디자인을 텍스트로 다시 풀어 쓰지 않았다. 실제 프롬프트는 다음 두 문장이다.
Dress the woman in Picture 1 in the complete outfit, including shoes, from Picture 2. Keep the face, hairstyle, pose, perspective, framing and white background of Picture 1.
이는 2번의 전체 착장과 신발을 1번 여성에게 입히되, 1번의 얼굴·머리·포즈·원근·프레이밍과 흰 배경은 유지하라는 뜻이다. B·C 결과에서 착장 반영과 함께 자세·크기 보존을 각각 확인한다.
B·C 착장 1차 적용 결과
| Scene B | Scene C |
|---|---|
 | 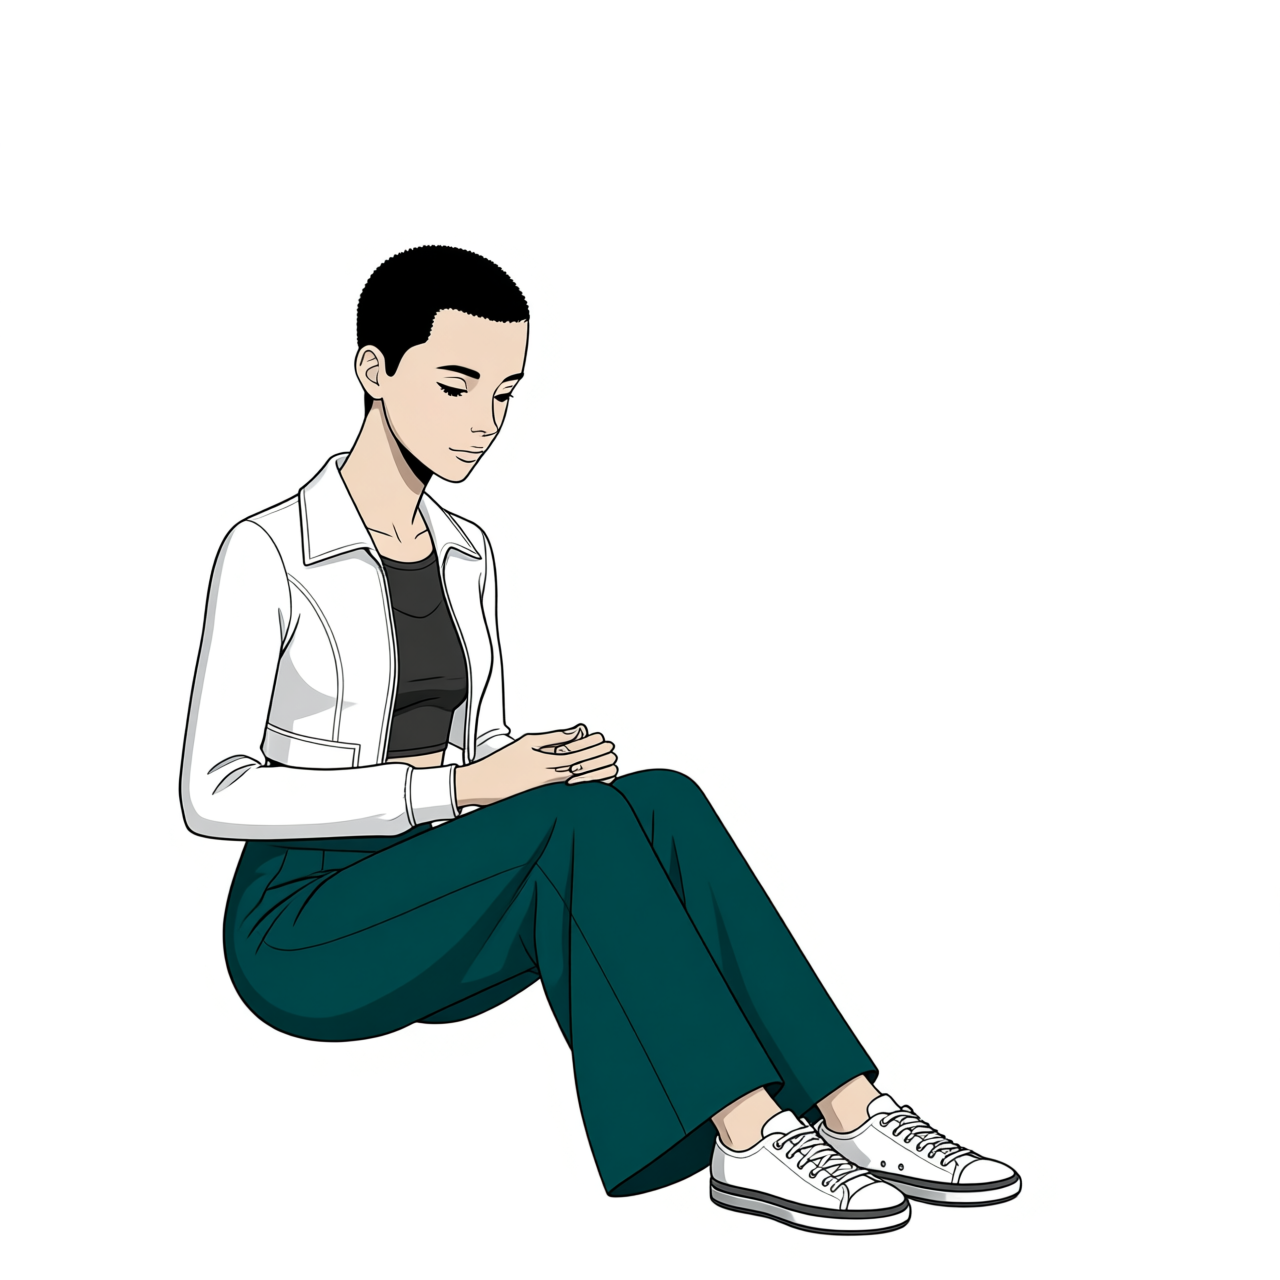 |
B에는 흰 재킷·넓은 바지와 양쪽 흰 스니커즈가 반영됐다. 도약 자세의 큰 형태는 남았지만 마네킨 입력보다 인물이 커지고 팔·다리의 위치가 달라졌다. 착장 반영과 포즈·크기 보존은 별도로 판단한다.
C에도 흰 재킷·넓은 바지와 양쪽 흰 스니커즈가 반영됐고, 앉은 자세의 큰 형태는 대체로 유지됐다. 두 결과 모두 마네킨의 짧은 머리가 남아 있으며, Mira의 얼굴·헤어 아이덴티티까지 완성한 결과는 아니다.
C 두 인물의 책을 보강한다
C Mira는 착장 1차 결과를, C 조연은 텍스트 아이덴티티 결과를 입력으로 사용한다. 두 이미지에 책을 각각 추가한 뒤 Mira는 BFS로, 조연은 DeLight로 연결한다.
C Mira의 책 보강
착장 1차 결과에는 책 없이 두 손만 모여 있다. 다음 지시로 책을 추가하며 착장과 얼굴을 다시 설명하지 않는다. 두 인물 모두 별도 책 참조·마스크·LoRA 없이 Qwen Image Edit 2511로 20스텝 생성했다.
Add an open book held in both hands over the lap of the woman in Picture 1.
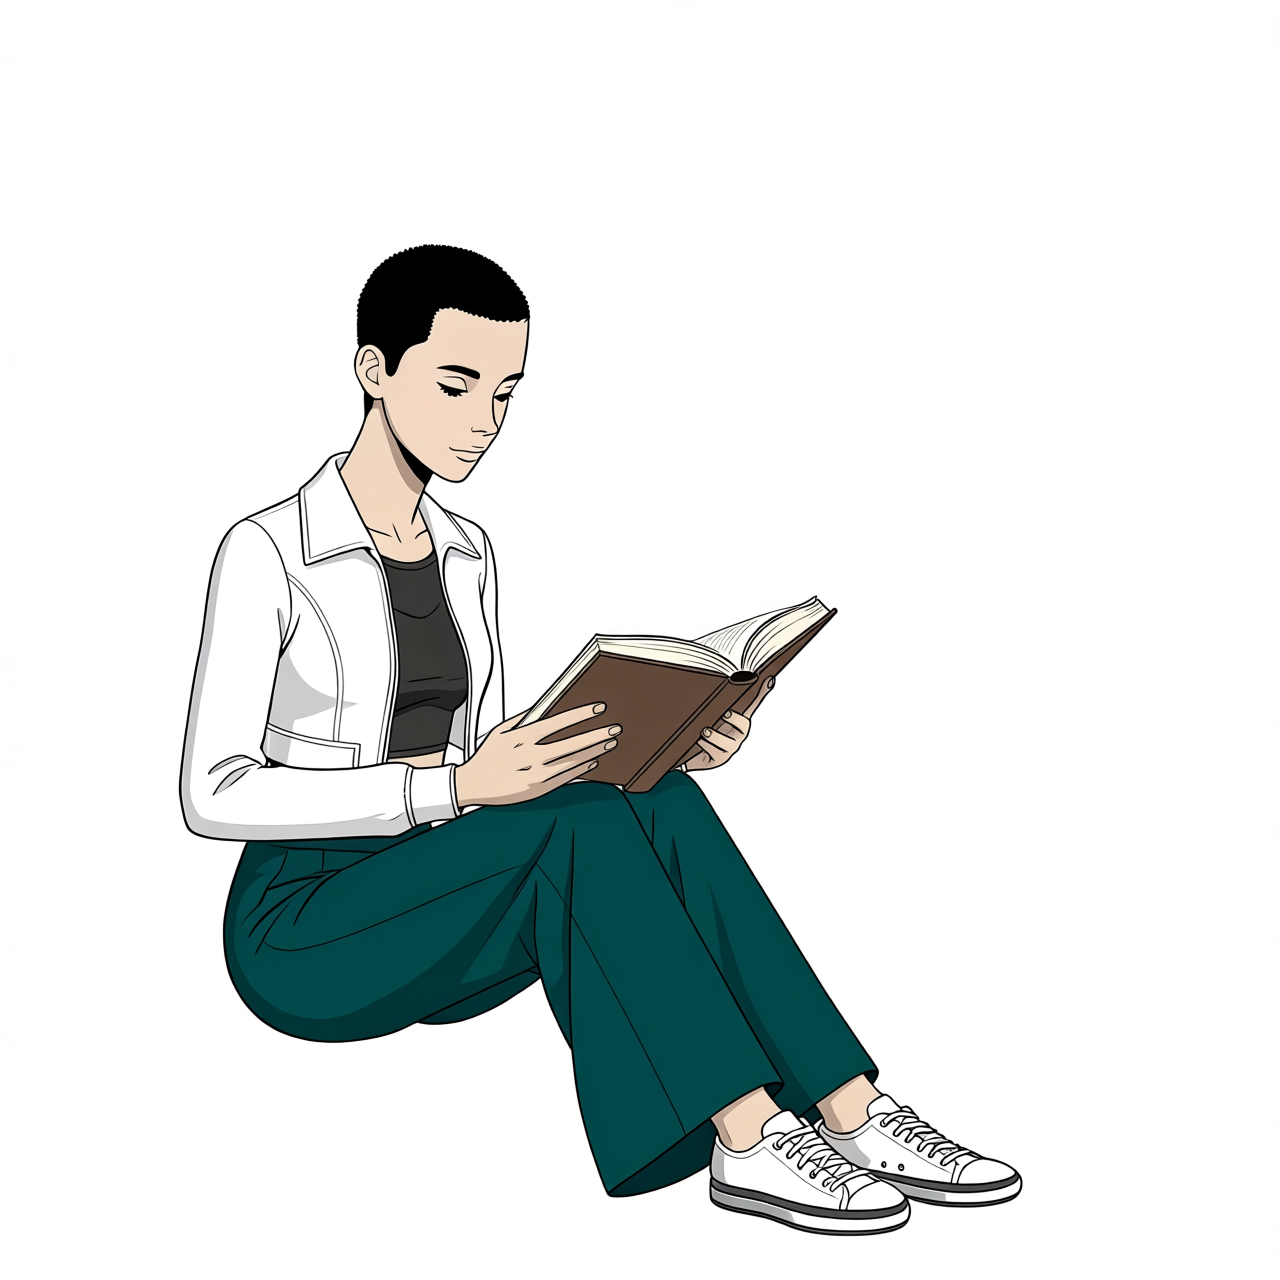
무릎 위에 갈색 표지의 펼친 책이 추가됐고, 두 손은 책을 받치는 모양으로 바뀌었다. 흰 재킷·넓은 바지·양쪽 스니커즈와 앉은 자세의 큰 형태는 대체로 유지됐다. 이 책은 원본 책의 픽셀을 복원한 것이 아니라 지시에 따라 새로 생성한 소품이다. 얼굴·헤어는 이번 보강 대상이 아니므로 Mira의 얼굴·헤어 아이덴티티는 여전히 후속 단계에서 다룬다.
C 조연의 책 보강
조연 아이덴티티 결과 한 장에 Add an open book held in both hands over the lap of the man in Picture 1.을 적용했다.
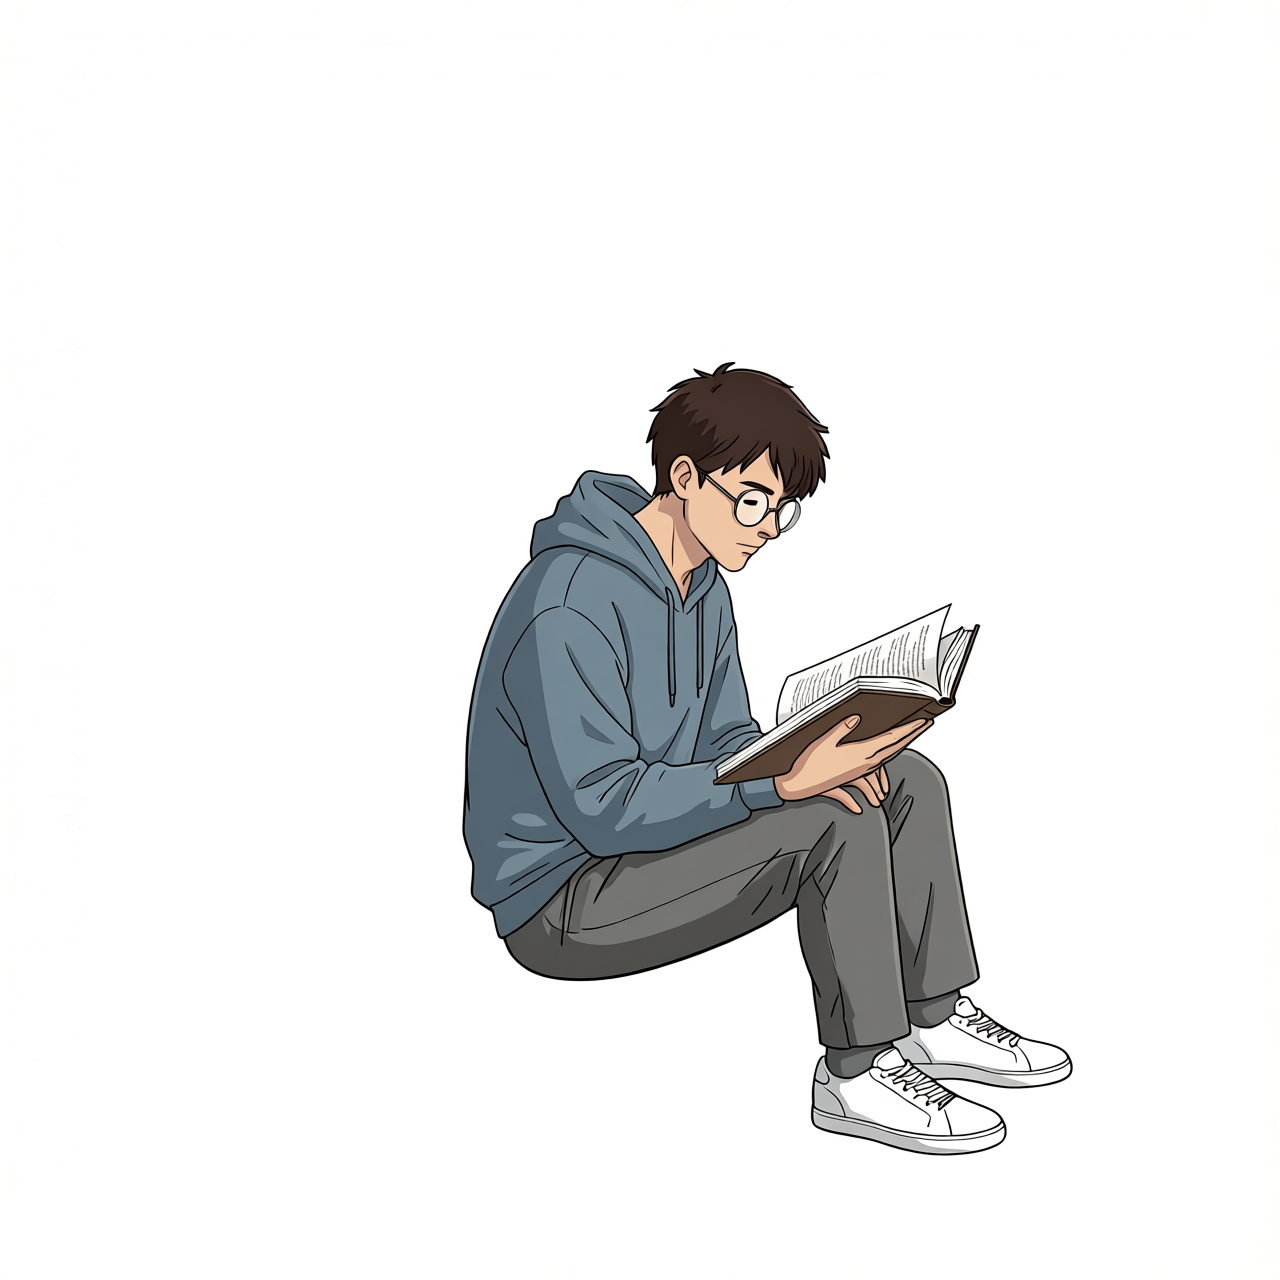
펼친 책이 추가됐고 손은 책을 받치는 형태로 바뀌었다. 갈색 머리·안경·파란 후드티와 앉은 자세의 큰 형태는 유지됐다. 원본 책을 픽셀 단위로 복원한 것이 아니라 새로 생성한 소품이다.
머리 방향에 맞는 얼굴 크롭으로 BFS를 적용한다
이 절에서 사용하는 BFS Head V5는 참조 이미지의 얼굴·머리를 적용하도록 Qwen Image Edit에 추가하는 LoRA다. 착장 적용까지 마친 인물 이미지와 토르소에서 잘라 낸 머리 이미지를 함께 넣어 얼굴·헤어를 보강한다. 머리 크롭은 참조 자료이며 편집 범위를 제한하는 마스크는 아니다. 따라서 머리 방향·표정과 다른 신체 부분이 함께 바뀌는지 결과에서 확인한다.
얼굴 참조는 장면의 카메라 이름보다 실제로 보이는 머리 방향을 기준으로 고른다. 정면인지 쿼터뷰인지, 화면 어느 쪽을 향하는지부터 맞춘다. 그중 얼굴 윤곽과 눈·코·입이 충분히 보이는 아이레벨 자료를 우선한다. 머리를 숙였다는 이유만으로 엘리베이티드 참조를 선택하면 얼굴이 보이는 면적과 구도까지 함께 달라질 수 있다.
장면별 입력과 참조
Picture 1에는 BFS 이전의 아이덴티티 결과를, Picture 2에는 얼굴·머리 크롭을 넣는다. 이는 BFS 모델 카드의 Head V5 입력 순서인 인물 이미지 먼저, 얼굴 참조 다음과 일치한다. 이전 BFS 결과에 편집을 누적하지 않는다. 채택한 A는 P7-5.2의 로우뷰 0°·1280px 토르소에서 512×512 영역을, B는 로우뷰 +45°·1280px 토르소에서 640×640 영역을, C는 아이레벨 쿼터뷰·1280px 토르소에서 640×640 영역을 자른다. 크롭 단계에서는 확대 보간이나 AI 재생성을 하지 않는다.
| 장면 | Picture 1 | 얼굴·머리 참조 선정 |
|---|---|---|
| A | A 아이덴티티 결과 | 로우뷰 0° 머리 크롭을 적용한 결과 채택 |
| B | B 마네킨 착장 1차 결과 | 로우뷰 +45° 머리 크롭의 10스텝 결과 기록; 참조와 얼굴 불일치 |
| C | C 책 보강 2차 결과 | 화면 오른쪽을 향한 아이레벨 쿼터뷰 크롭 |
A·B·C BFS 참조와 결과
| 구분 | A: 로우뷰 0° | B: 로우뷰 +45° | C: 아이레벨 쿼터뷰 |
|---|---|---|---|
| 참조 머리 크롭 | 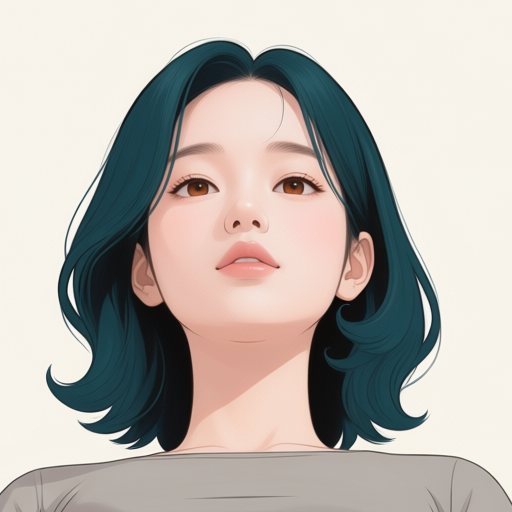 | 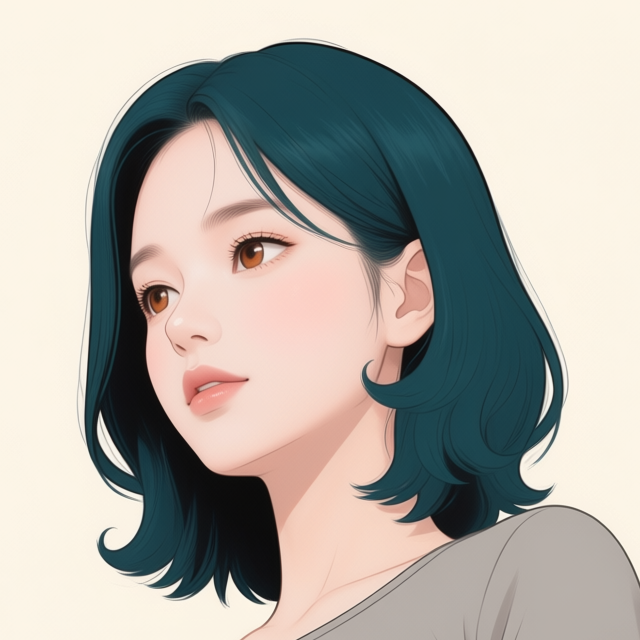 | 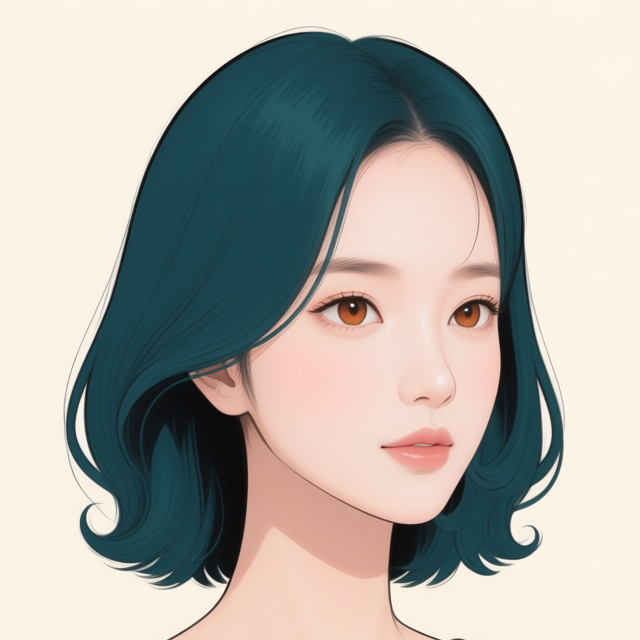 |
| BFS 10스텝 결과 | 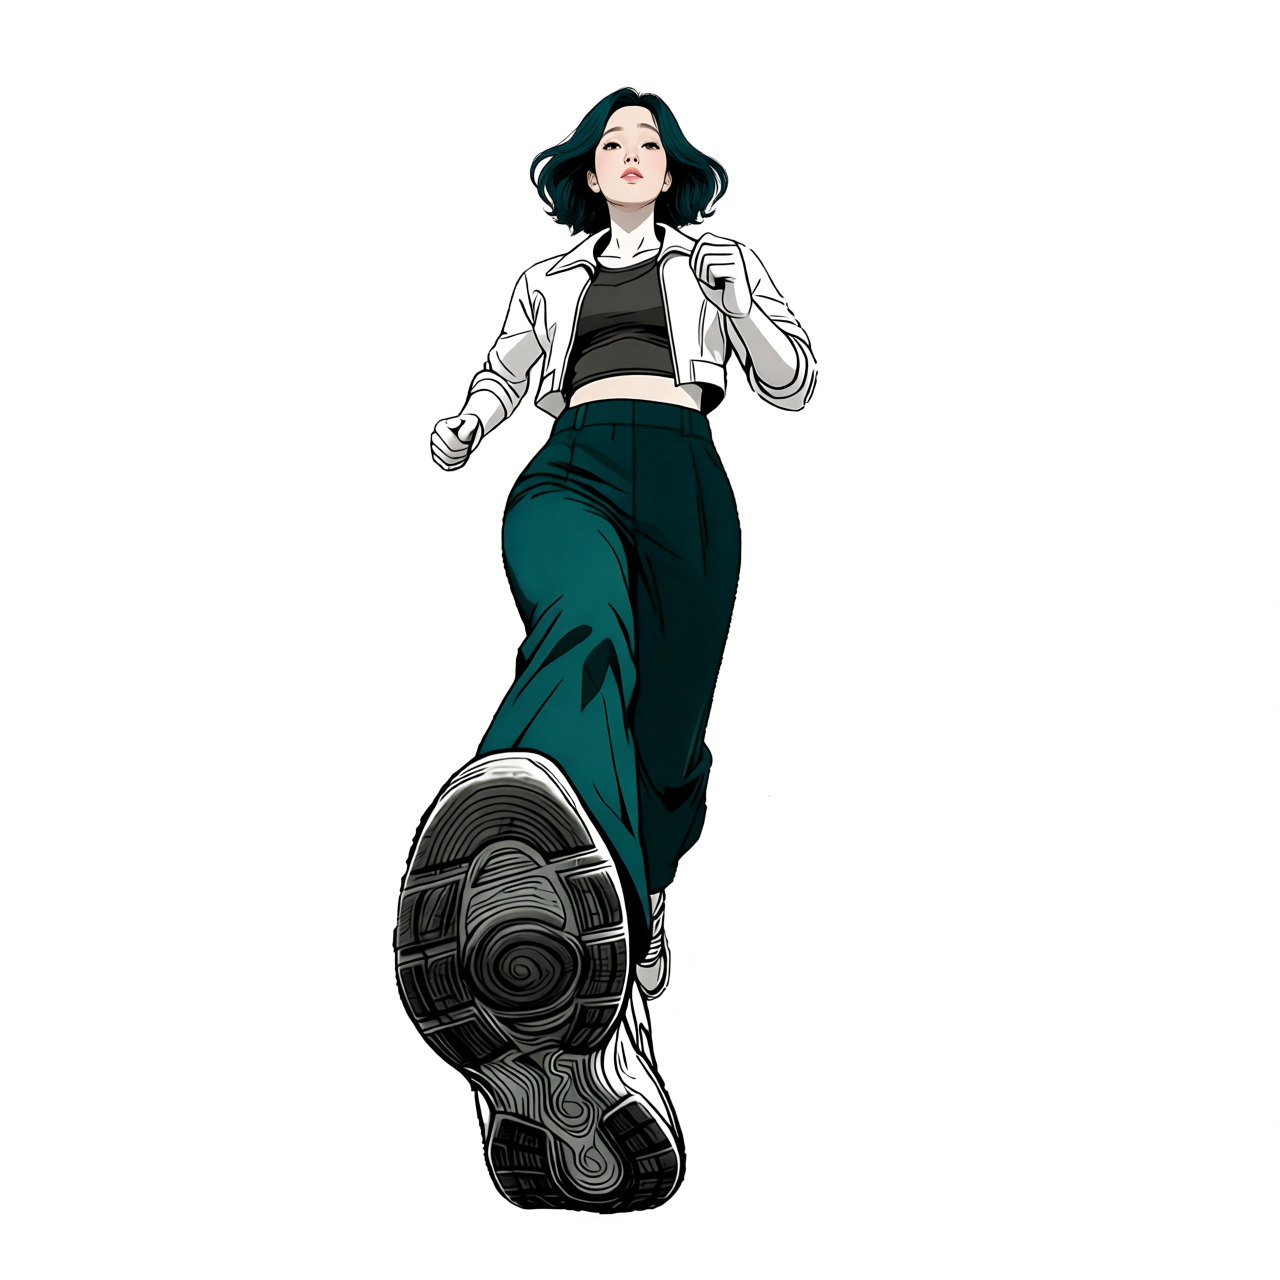 | 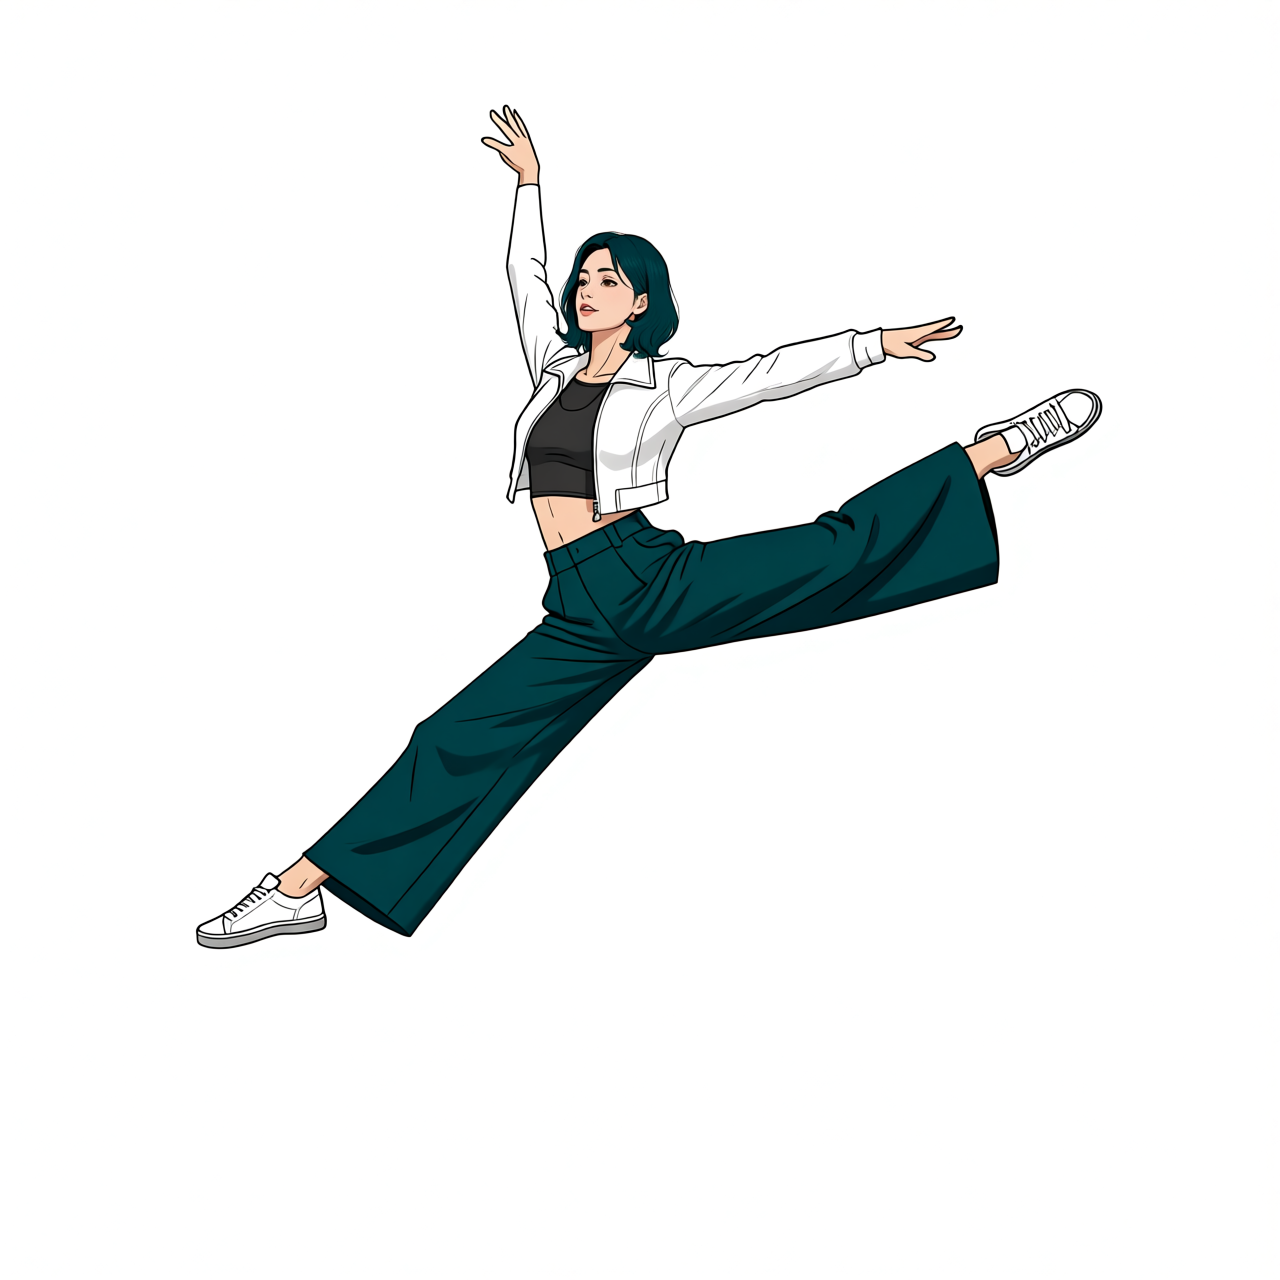 | 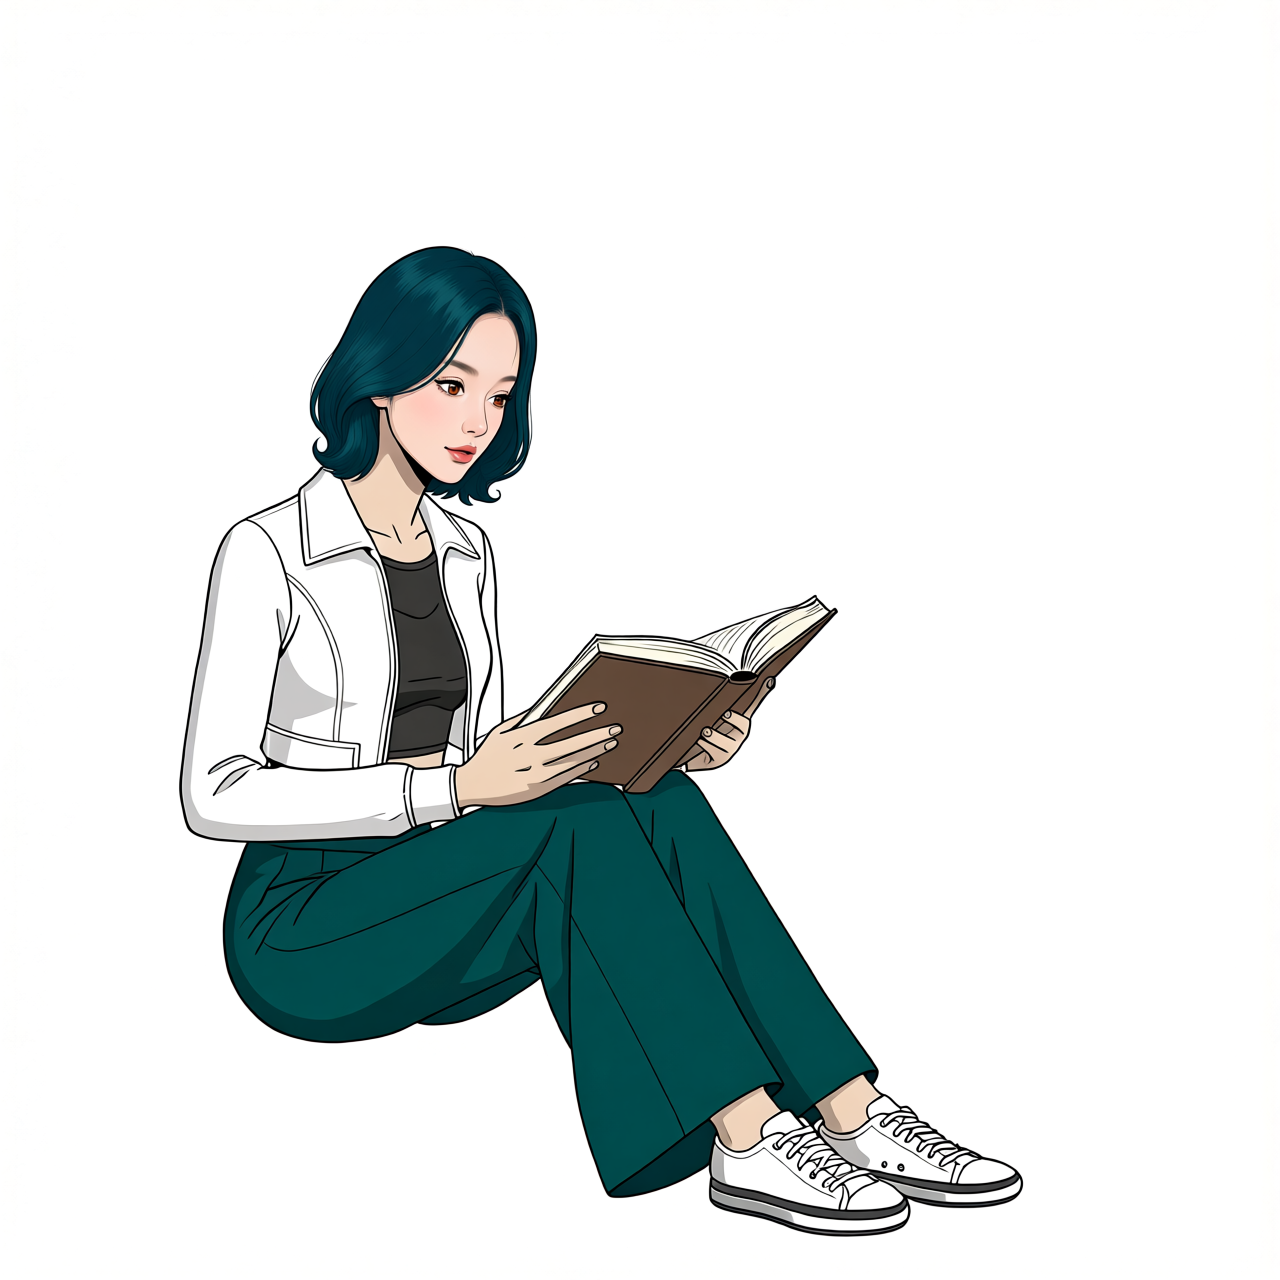 |
B 로우뷰 +45° BFS 10스텝 입력·프롬프트·결과 기록
A 로우뷰 0° 적용 결과
로우뷰 0° 토르소(seed 62295·4스텝)에서 좌표 (400, 40, 912, 552)의 머리 영역을 잘랐다. 달리는 자세와 착장·앞쪽 신발의 큰 형태는 유지됐고, 턱이 들리며 코 아래가 더 보이는 얼굴로 바뀌었다. 이 결과를 채택했지만, 입력의 머리 회전과 표정이 그대로 보존된 것으로 해석하지 않는다.
B 로우뷰 +45° 적용 결과와 얼굴 불일치
로우뷰 +45° 토르소의 좌표 (360, 20, 1000, 660)에서 640×640 머리 영역을 잘랐으며 좌우 반전은 하지 않았다.
검수 판단: 결과의 얼굴은 참조 이미지의 얼굴과 일치하지 않는다. 단발과 머리색이 반영되고 점프 자세의 큰 형태가 유지됐지만, 참조 인물의 얼굴 아이덴티티를 충분히 재현한 결과로 보지 않는다. 머리 방향과 헤어 반영, 같은 사람으로 보이는 얼굴의 일치는 별도로 평가해야 한다. 이 10스텝 결과를 다음 DeLight 단계의 입력으로 사용하며, 얼굴 불일치는 남은 한계로 기록한다.
C 아이레벨 쿼터뷰 적용 결과
단발과 머리색이 적용됐고 책과 앉은 자세의 큰 형태는 유지됐다. 다만 원본보다 눈이 더 열리고 입 모양이 달라졌으며, 참조보다 강한 윤곽선이 남았다. 아이레벨 결과를 채택한 판단과 시선·표정·화풍의 완전한 보존은 구분한다.
네 캐릭터에 Studio DeLight를 적용한다
A·B·C Mira의 BFS 결과와 C 조연의 책 보강 결과를 각각 한 장씩 처리한다.
Qwen Image Edit 2511에 Studio DeLight LoRA만 강도 1.0으로 적용해 각각 10스텝 생성했다. BFS·Lightning LoRA와 마스크·결과 합성은 사용하지 않는다.
프롬프트는 Studio DeLight 모델 카드의 Neutral uniform lighting Preserve identity and composition이다. 인물의 외형과 구도를 유지하면서 조명을 균일하게 바꾸도록 지시한다.
DeLight 10스텝 결과
| A Mira | B Mira | C Mira | C 조연 — 책 보강 후 |
|---|---|---|---|
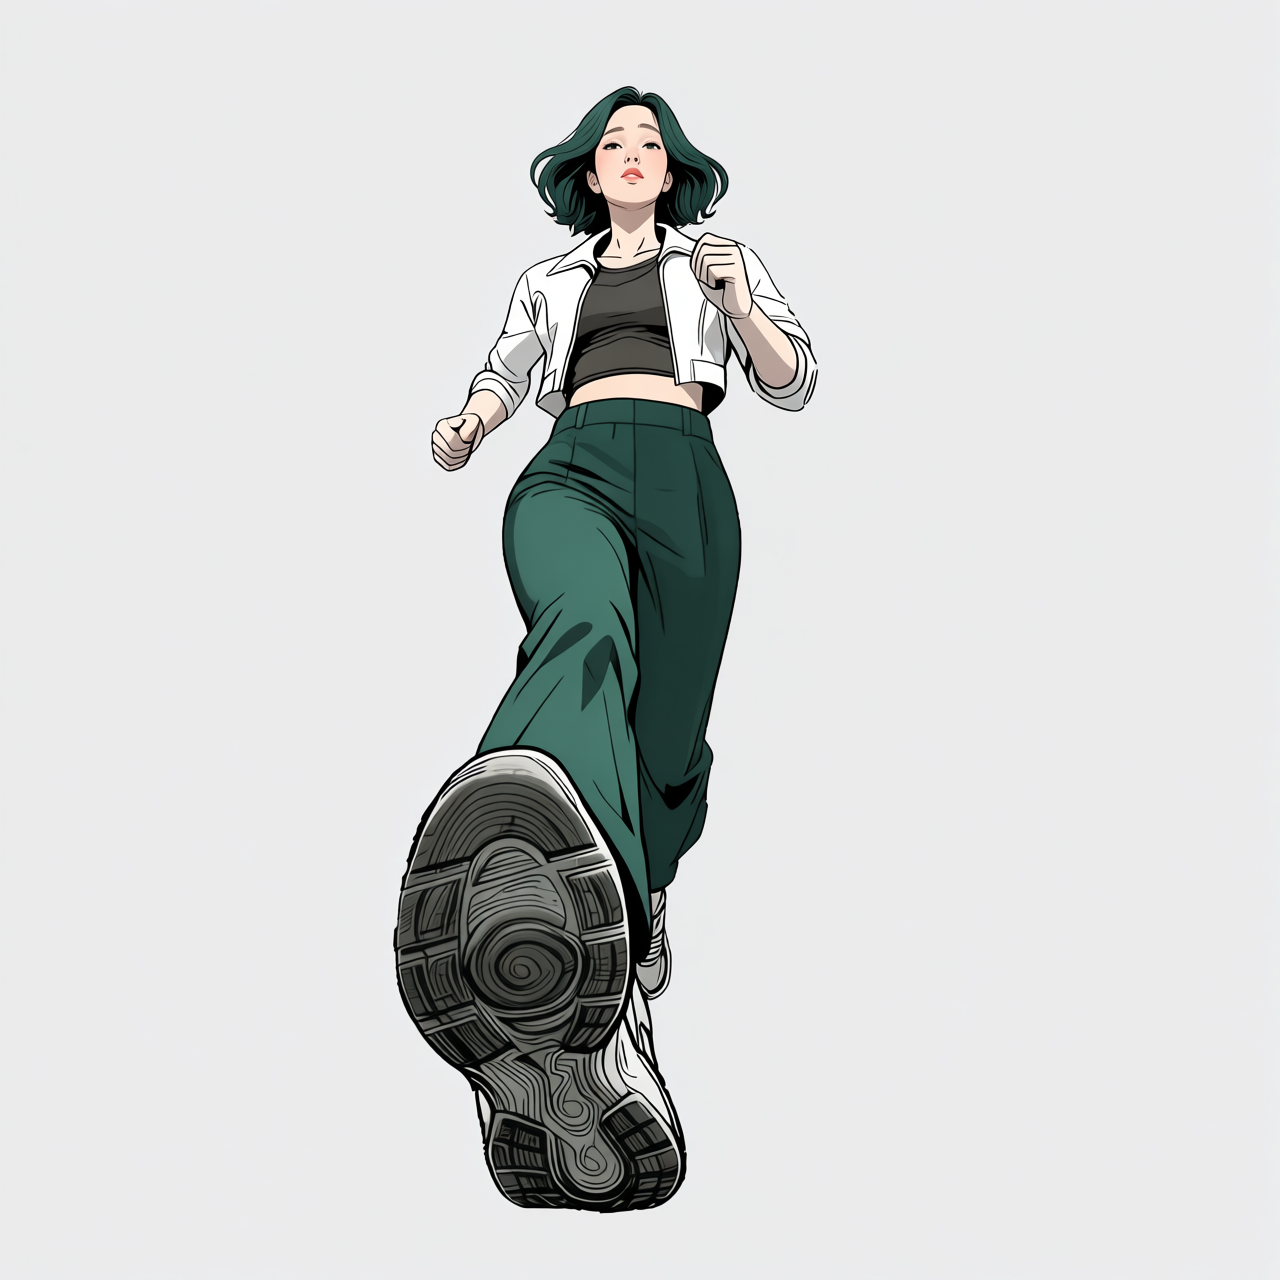 | 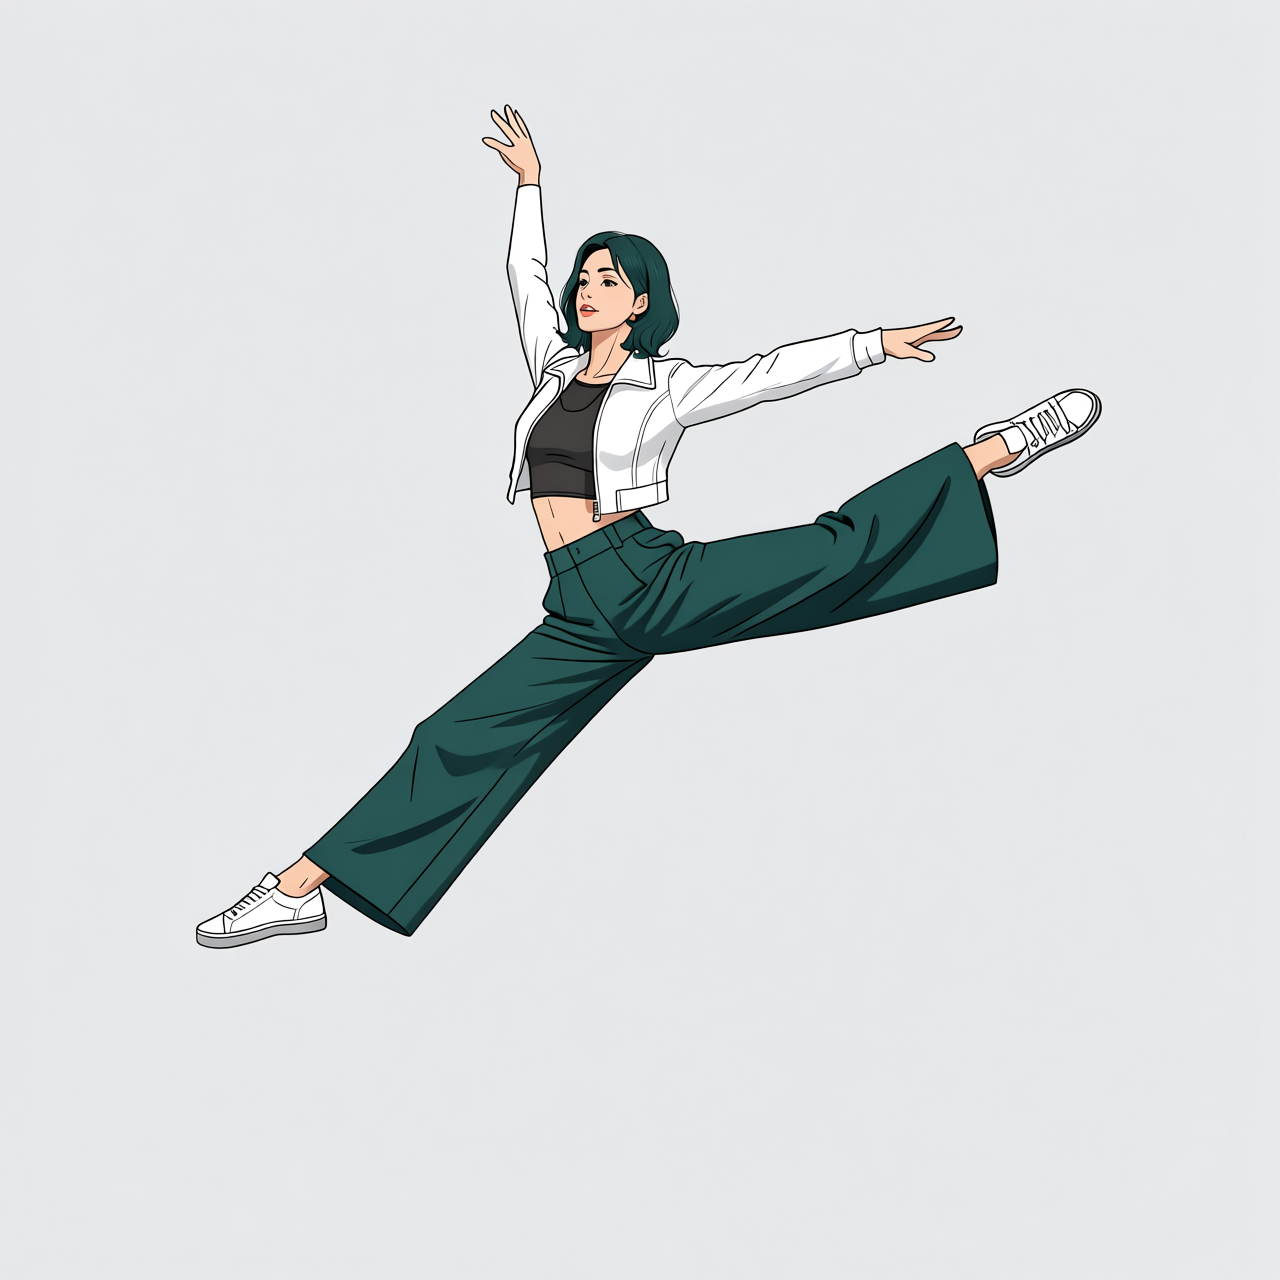 |  |  |
A의 달리는 자세, B의 도약 자세, C 두 인물의 앉은 자세와 책을 확인한다. C 조연은 책 보강 후에도 펼친 책을 유지했다. 별도의 그림자 추가 단계는 두지 않는다. 이후 DeLight·합성·Relight 비교에서도 그림자 유무는 평가에서 제외하고 인물·소품·구도와 색·명암 변화를 본다. B에서 기록한 얼굴 아이덴티티 불일치가 DeLight로 해결됐다고 판단하지는 않는다.
최종 장면에서 인물을 제거해 배경판을 만든다
캐릭터 처리와 별도로 P7-5.4의 최종 A·B·C 장면에서 배경판을 만든다. 입력은 절 앞에서 고정한 extras-audit-20260909-v1 세 장이다. A·B에서는 Mira만 제거하고, C에서는 Mira와 조연 및 두 사람이 들고 있는 책을 함께 제거한다. 주변 인물·동물·새는 배경판에 남긴다.
이 작업은 인물 마스크의 반대 영역을 잘라 내는 작업과 다르다. 인물에 가려져 보이지 않던 도로·하늘·바위·난간 등을 모델이 새로 채운다. 따라서 원래 배경의 픽셀을 복원한 결과로 해석하지 않으며, 가려지지 않았던 주변 대상과 구도가 유지됐는지 함께 확인한다.
Qwen Image Edit 2511에 장면 한 장씩 넣어 10스텝 생성했다. 별도 참조·마스크·LoRA·결과 합성은 사용하지 않는다.
| 장면 | 채택 결과의 실제 프롬프트 |
|---|---|
| A | Remove the large woman in the center of Picture 1, including her foreground shoe. Fill her area with the street and sky. Preserve the six surrounding people, buildings and composition. |
| B | Remove the jumping woman from Picture 1. Fill her area with the forest and sunset sky. Preserve the rabbit, squirrel, trees, ferns and composition. |
| C | Remove the two readers and their books from Picture 1. Preserve the original three birds: one on the left rock and two on the railing. Keep the path empty. |
A·B·C 배경판 결과
| A — 주변 인물 6명 유지 | B — 토끼·다람쥐 유지 | C v2 — 새 3마리 유지 |
|---|---|---|
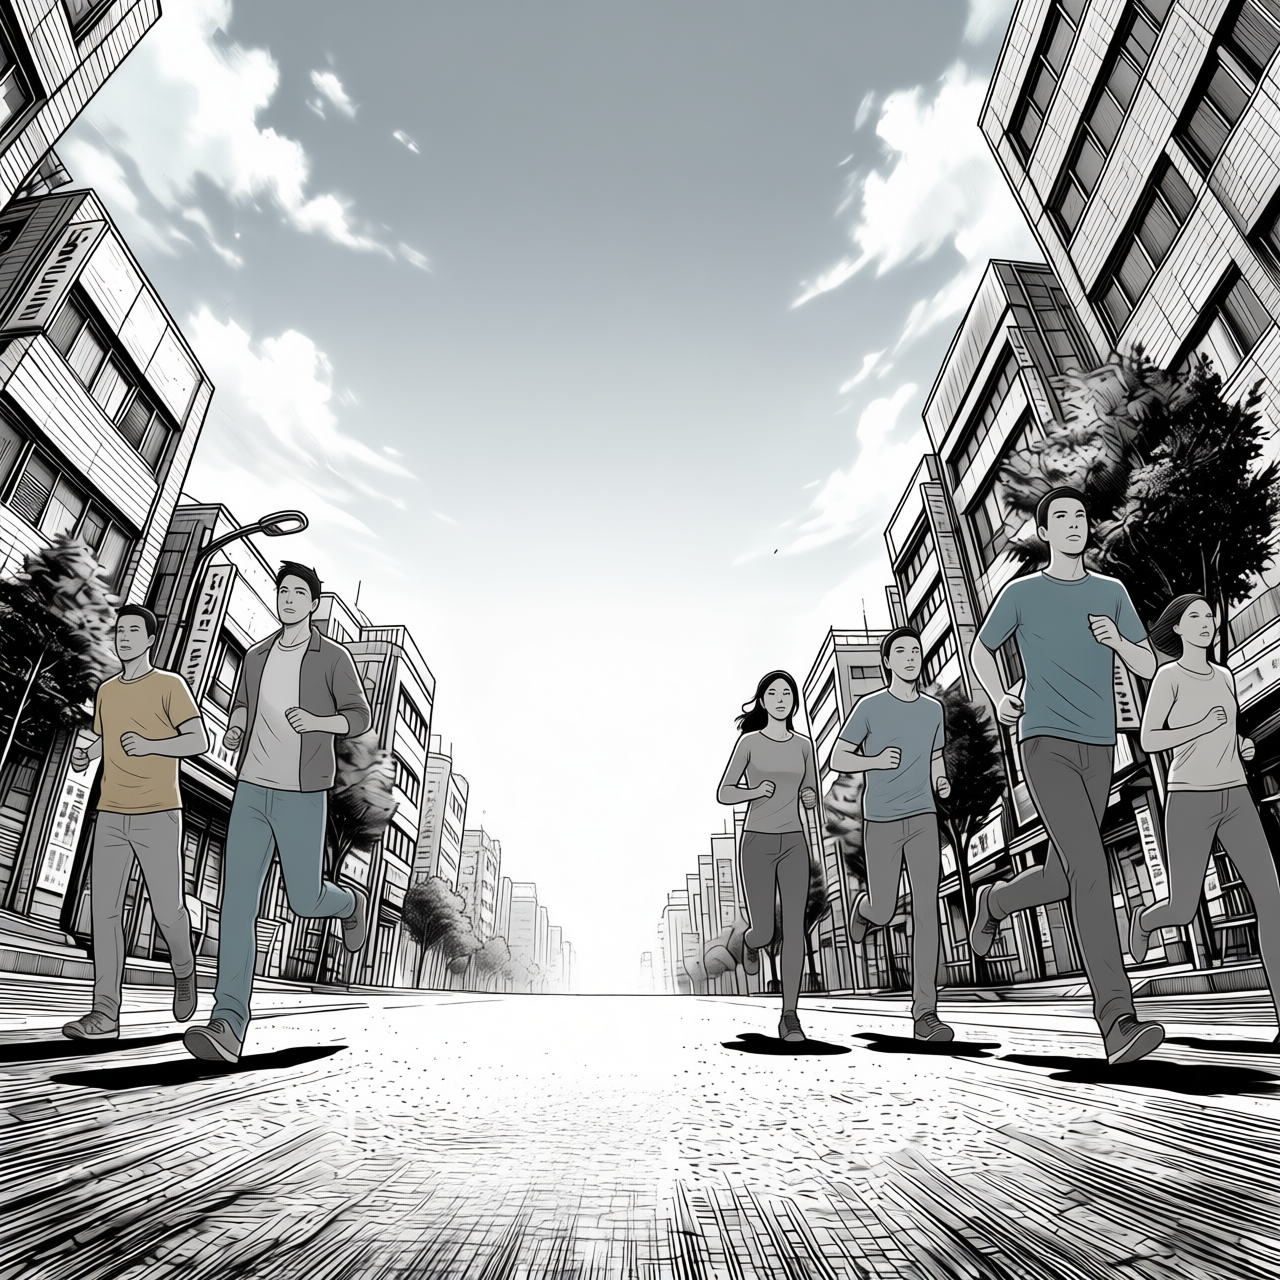 | 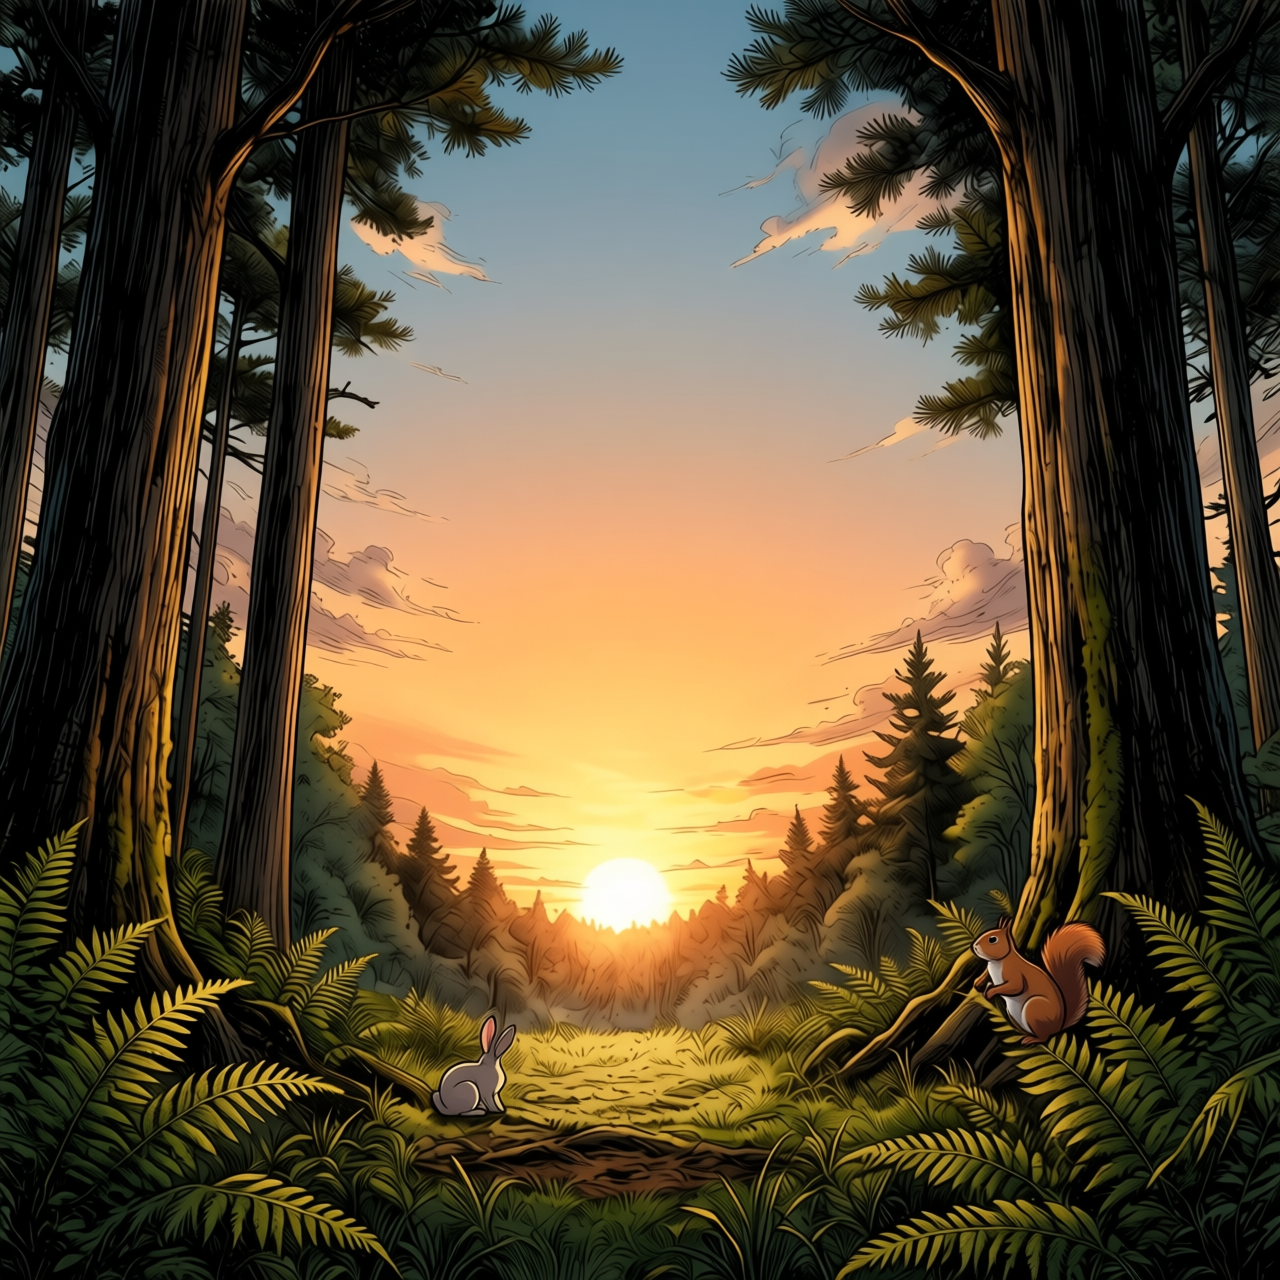 | 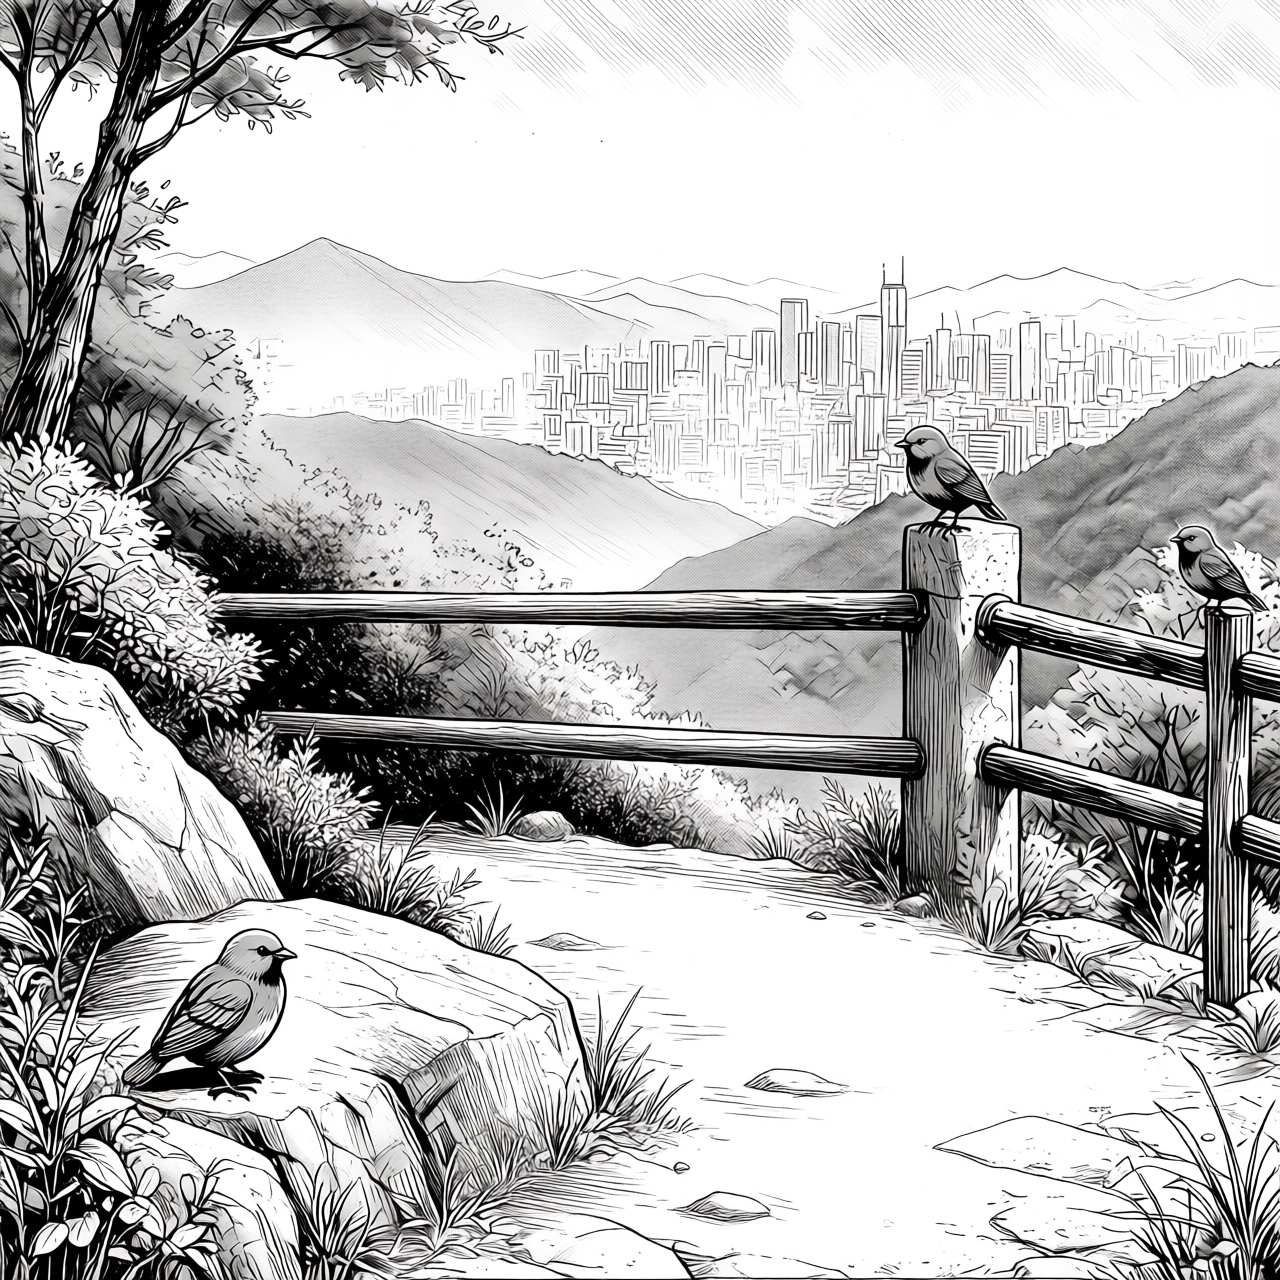 |
A에서는 중앙 Mira와 전경 신발이 제거되고 도로와 하늘이 채워졌다. B에서는 도약하는 Mira가 제거되고 숲과 노을, 토끼·다람쥐가 남았다. C v2에서는 두 인물과 책이 제거됐으며, 왼쪽 바위에 한 마리와 난간에 두 마리의 새가 남았다. 이 배경판은 다음 DeLight 처리의 입력이며, 이후 DeLight 캐릭터와 함께 통합 장면을 생성한다.
배경판에 Studio DeLight를 적용한다
앞서 채택한 A·B v1과 C v2 배경판을 각각 입력으로 사용한다. 흐름은 P7-5.4 최종 장면 → 인물·책 제거 배경판 → 배경 DeLight다. 캐릭터 DeLight 결과는 이 단계의 참조로 넣지 않으며, 배경판 한 장씩 조명 보정을 수행한다.
캐릭터 DeLight와 같은 2511 모델·LoRA 강도 1.0·10스텝 조건을 사용한다. 별도 마스크·Lightning LoRA·결과 합성은 사용하지 않는다.
프롬프트는 Studio DeLight 모델 카드의 Neutral uniform lighting Preserve identity and composition이다. 구도와 대상을 유지하면서 조명을 균일하게 바꾸도록 지시하지만, 실제 결과에서는 하늘과 색조도 달라지는지 확인해야 한다.
배경 DeLight 10스텝 결과
| A | B | C — 배경판 v2 입력 |
|---|---|---|
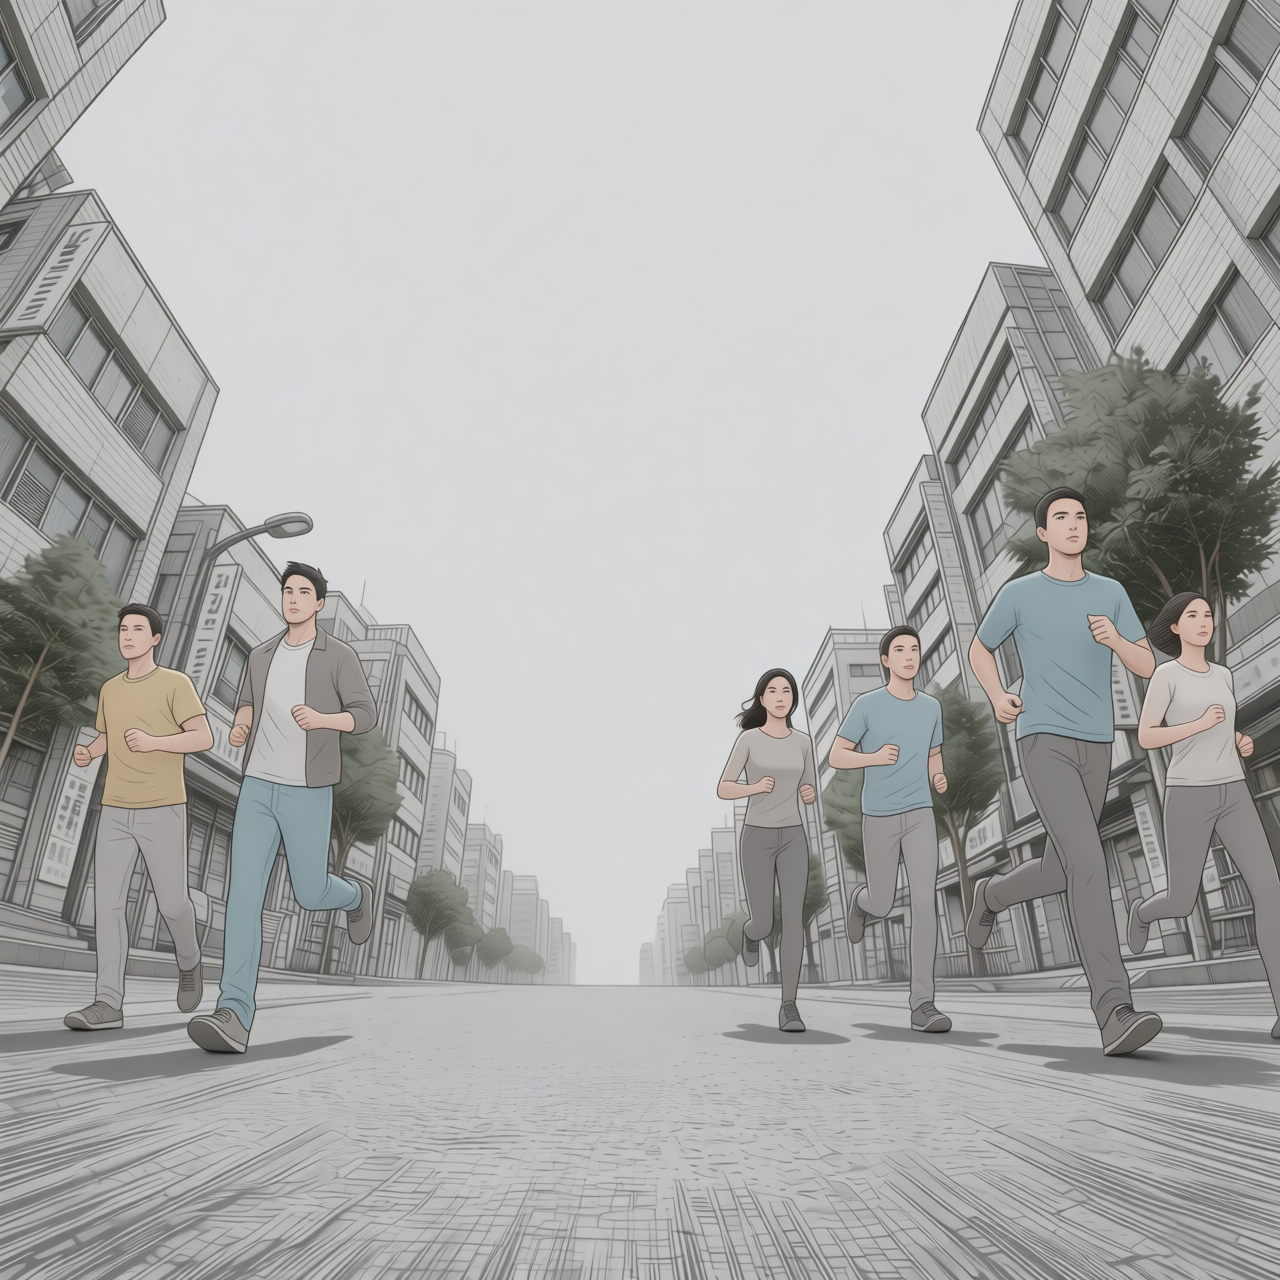 | 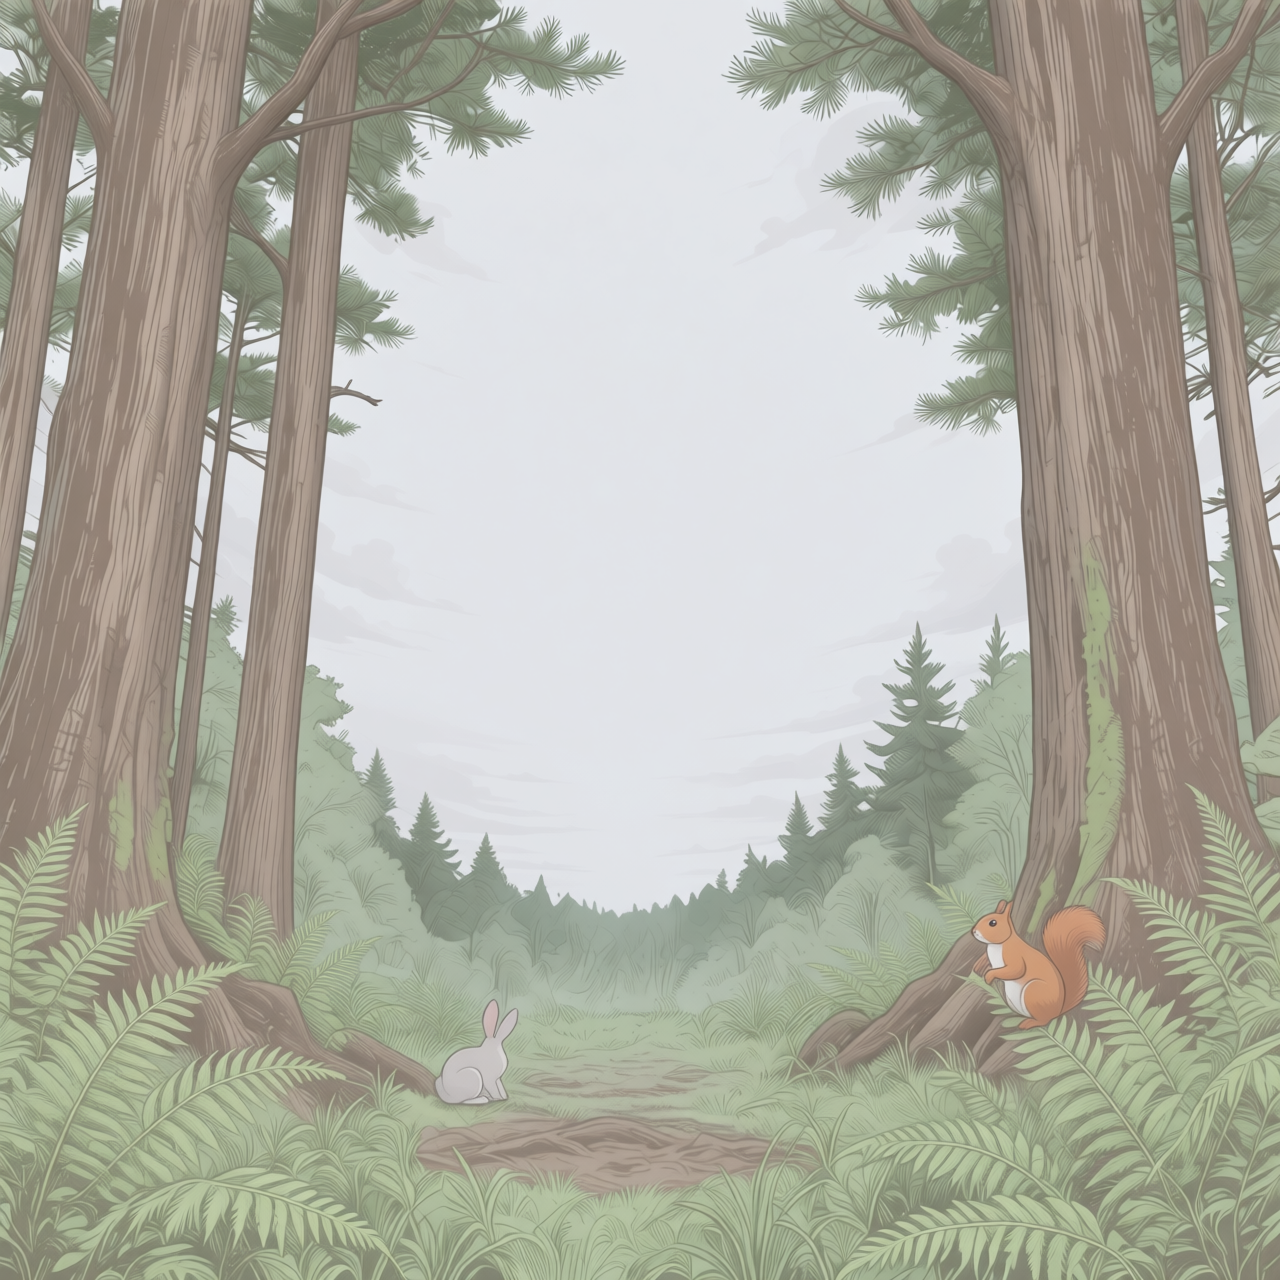 | 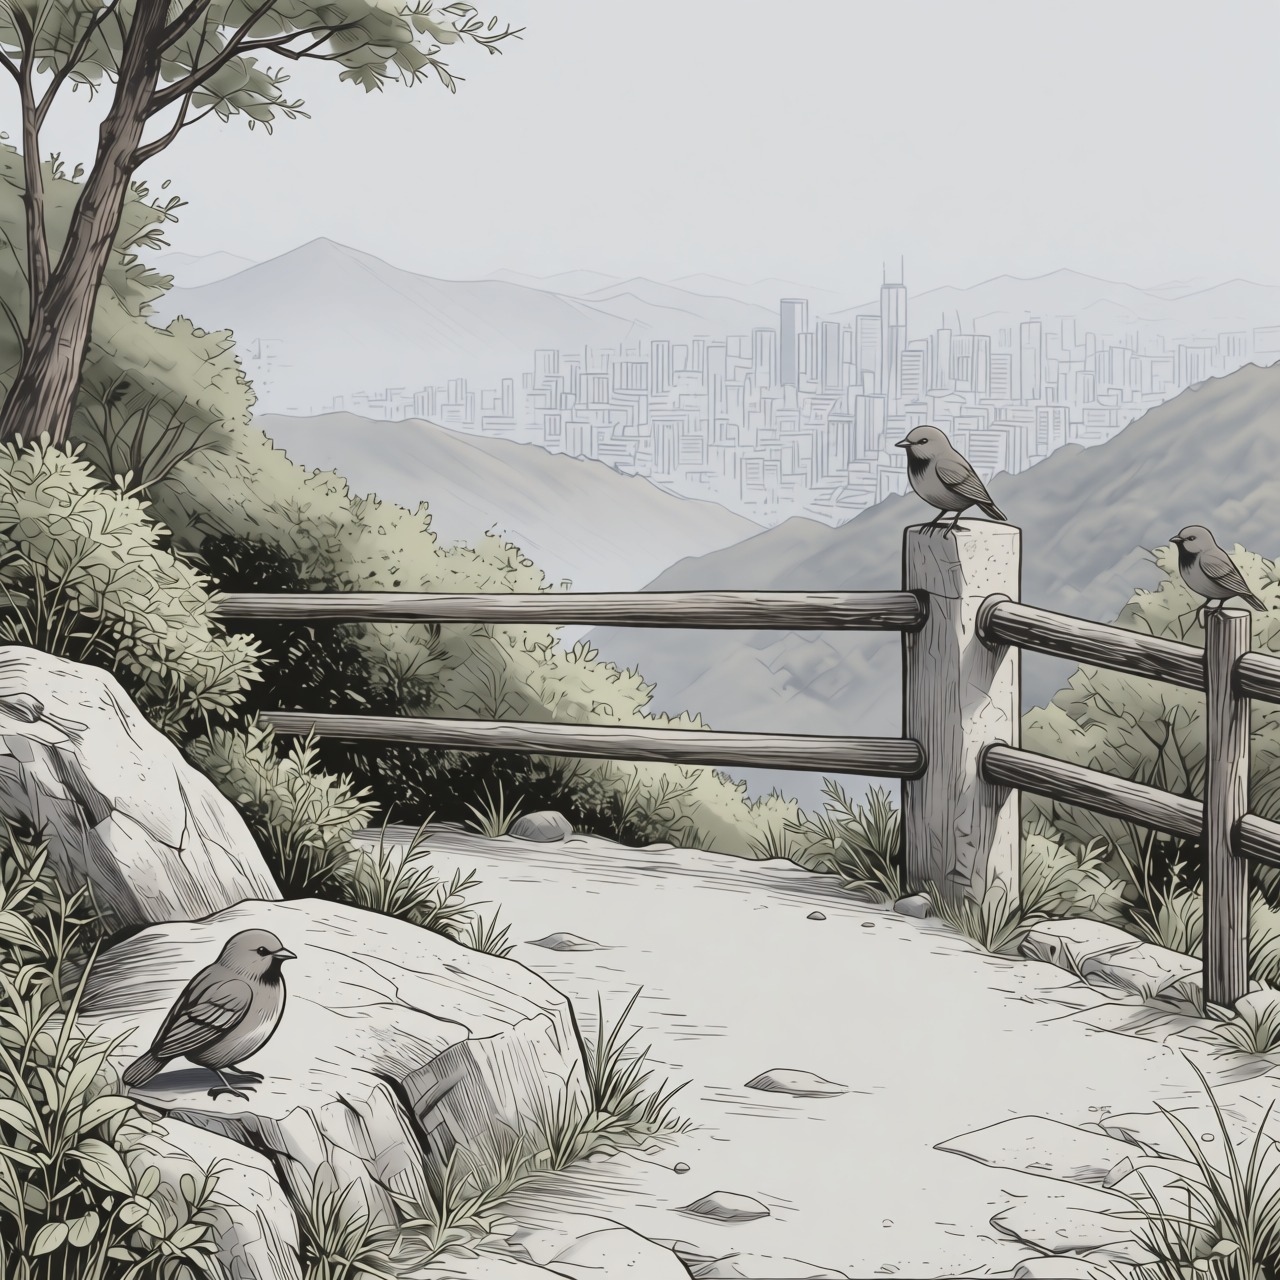 |
A의 주변 인물 여섯 명, B의 토끼·다람쥐, C의 새 세 마리가 남아 있으며 배경의 큰 구도는 유지됐다. 세 장 모두 전체 대비가 낮아졌고, A의 구름과 B의 노을·태양은 사라졌다. C는 흑백 선화 중심 배경에 옅은 색조가 추가됐다. 따라서 이 결과는 밝기만 바꾼 보정이 아니라 하늘·색조 변화도 포함하는 생성 편집으로 기록한다. 모델 카드도 야외 장면에서는 배경이 희거나 비워질 수 있다고 설명한다. 이 안내는 변화 가능성의 근거이며, 위 장면별 변화는 저장된 입력과 결과를 비교한 관찰이다.
DeLight 캐릭터와 배경을 장면별로 합친다
DeLight를 적용한 배경과 캐릭터를 Qwen Image Edit 2511의 다중 이미지 참조로 넣어 통합 장면을 생성한다. A·B는 배경과 Mira 두 장, C는 배경·Mira·조연 세 장을 사용한다. 원래 P7-5.4 장면을 추가 참조로 넣지는 않으며, 배치 위치는 장면별 프롬프트로 지정한다.
| 장면 | Picture 1 | Picture 2 | Picture 3 | 배치 지시 |
|---|---|---|---|---|
| A | A DeLight 배경 | A DeLight Mira | 없음 | 중앙 전경에서 화면 쪽으로 달리는 자세 |
| B | B DeLight 배경 | B DeLight Mira | 없음 | 중앙 공중에서 다리를 벌려 도약하는 자세 |
| C | C DeLight 배경 | C DeLight Mira | C DeLight 조연 | 왼쪽 전경 바위에 Mira, 그 뒤 오른쪽에 조연 |
추가 LoRA 없이 10스텝 생성했다. 마스크나 알파 합성으로 픽셀을 붙이는 대신 참조 이미지들을 모델에 전달해 한 장면을 다시 생성한다.
| 장면 | 실제 프롬프트 |
|---|---|
| A | Place the woman from Picture 2 in the center foreground of Picture 1, running toward the viewer. Preserve her pose, face, hair, outfit and large foreground shoe. Keep the six surrounding people and the background. |
| B | Place the woman from Picture 2 in midair at the center of Picture 1. Preserve her split-leap pose, face, hair and outfit. Keep the rabbit, squirrel and forest background. |
| C | Place the woman from Picture 2 seated on the left foreground rock in Picture 1, and the man from Picture 3 seated just behind her on the right. Preserve both characters, their poses, outfits and open books. Keep the three birds, railing and city background. |
A·B·C 합성 10스텝 결과
| A | B | C |
|---|---|---|
 |  |  |
A에서는 중앙 전경에 Mira가 배치됐고 주변 여섯 인물이 유지됐다. B에서는 Mira의 도약 자세와 토끼·다람쥐가 남았다. C에서는 왼쪽 Mira와 오른쪽 조연, 두 사람의 펼친 책과 새 세 마리가 함께 배치됐다. 인물의 큰 포즈와 착장을 전달한 결과이며, 얼굴 아이덴티티의 완전한 일치를 입증하는 결과는 아니다.
합성 과정에서 DeLight 입력의 밝기가 그대로 유지되지는 않았다. A·C 배경은 상당히 어두워졌고, B는 녹색의 채도와 대비가 강해졌다. 이 단계는 배치뿐 아니라 장면의 색·명암도 다시 생성하는 편집이므로, 캐릭터와 배경을 합친 성과와 중립 조명을 유지했는지는 구분한다.
최초 씬의 조명을 텍스트로 설명해 리라이트한다
위 합성 결과 A·B·C 한 장씩을 입력으로 사용하고, 최초 P7-5.4 씬에서 관찰한 조명을 텍스트 프롬프트로 전달한다. 최초 씬 이미지는 프롬프트 작성에만 참고하며 모델 입력에는 넣지 않는다. 흐름은 DeLight 배경·캐릭터 합성 → 단일 이미지와 장면별 조명 지시 → Relight다.
Qwen Image Edit 2509 및 dx8152/Qwen-Image-Edit-2509-Relight LoRA를 사용한다. 트리거는 重新照明, LoRA 강도는 1.0이다. 10스텝 생성했다. 별도 마스크나 Lightning LoRA는 사용하지 않았다. 이는 저장된 실행 조건이며, Relight 모델 카드의 Lightning 병용 안내와는 구분한다.
조명 설명은 이미지를 보고 작성한 정성적 해석이며 광원 위치나 색온도를 측정한 값은 아니다. 특히 C는 선화에서 읽을 수 있는 부드러운 주광과 나무 그늘을 기준으로 설명했다.
| 장면 | 실제 조명 프롬프트 |
|---|---|
| A | 重新照明, bright neutral daylight from the open sky above, illuminating the street and people, with shaded building sides. Preserve the scene content and composition. |
| B | 重新照明, warm golden sunset backlight from low on the central horizon, with warm rim light on the woman and tree edges and soft cool skylight on the front. Preserve the scene content and composition. |
| C | 重新照明, soft neutral daylight from the open sky, evenly illuminating the readers, books and rocks, with gentle shade beneath the tree. Preserve the scene content and composition. |
텍스트 조명 Relight 10스텝 결과
| A — 밝은 주광 | B — 노을 역광 | C — 부드러운 주광 |
|---|---|---|
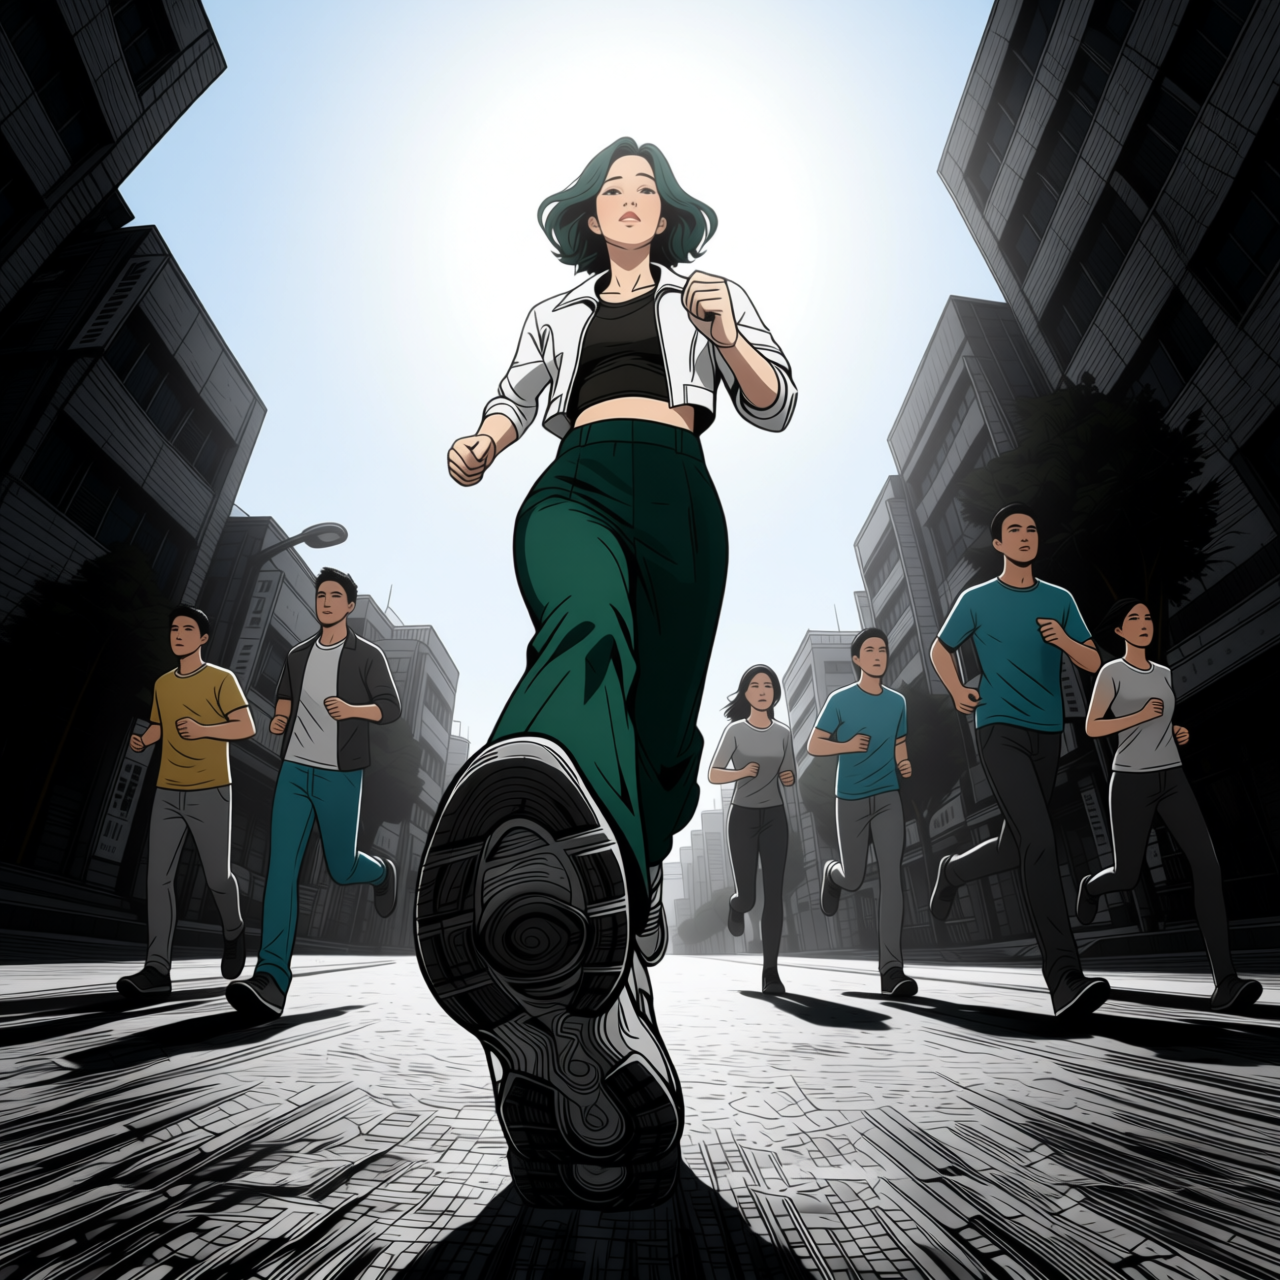 | 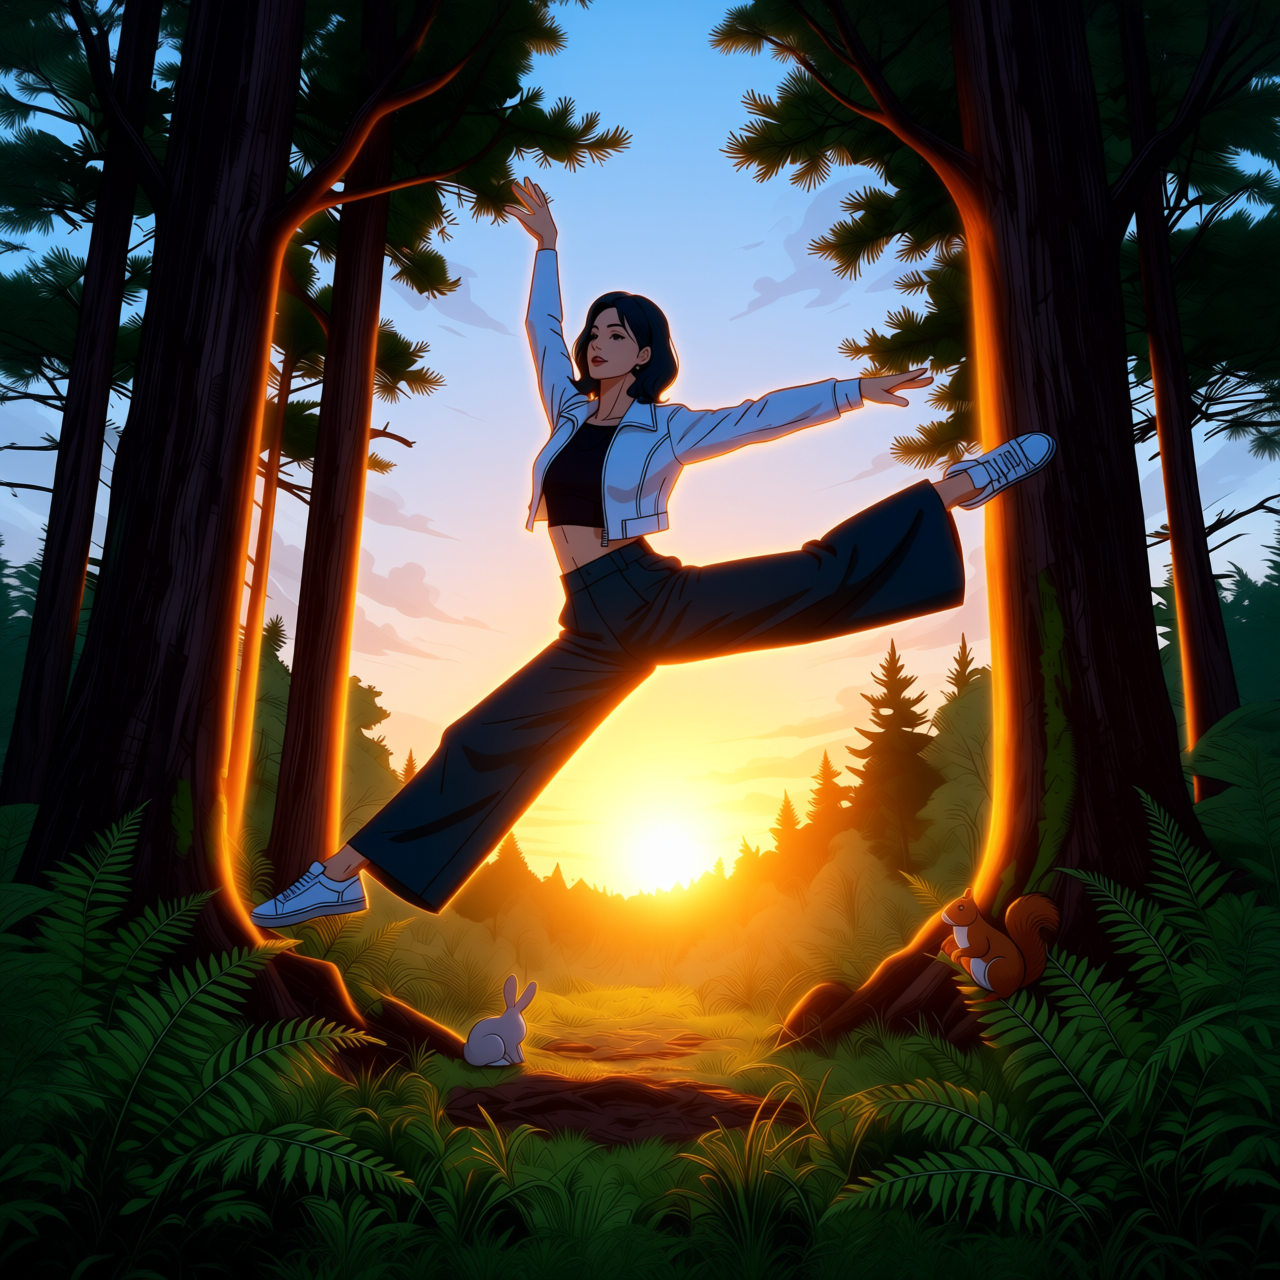 | 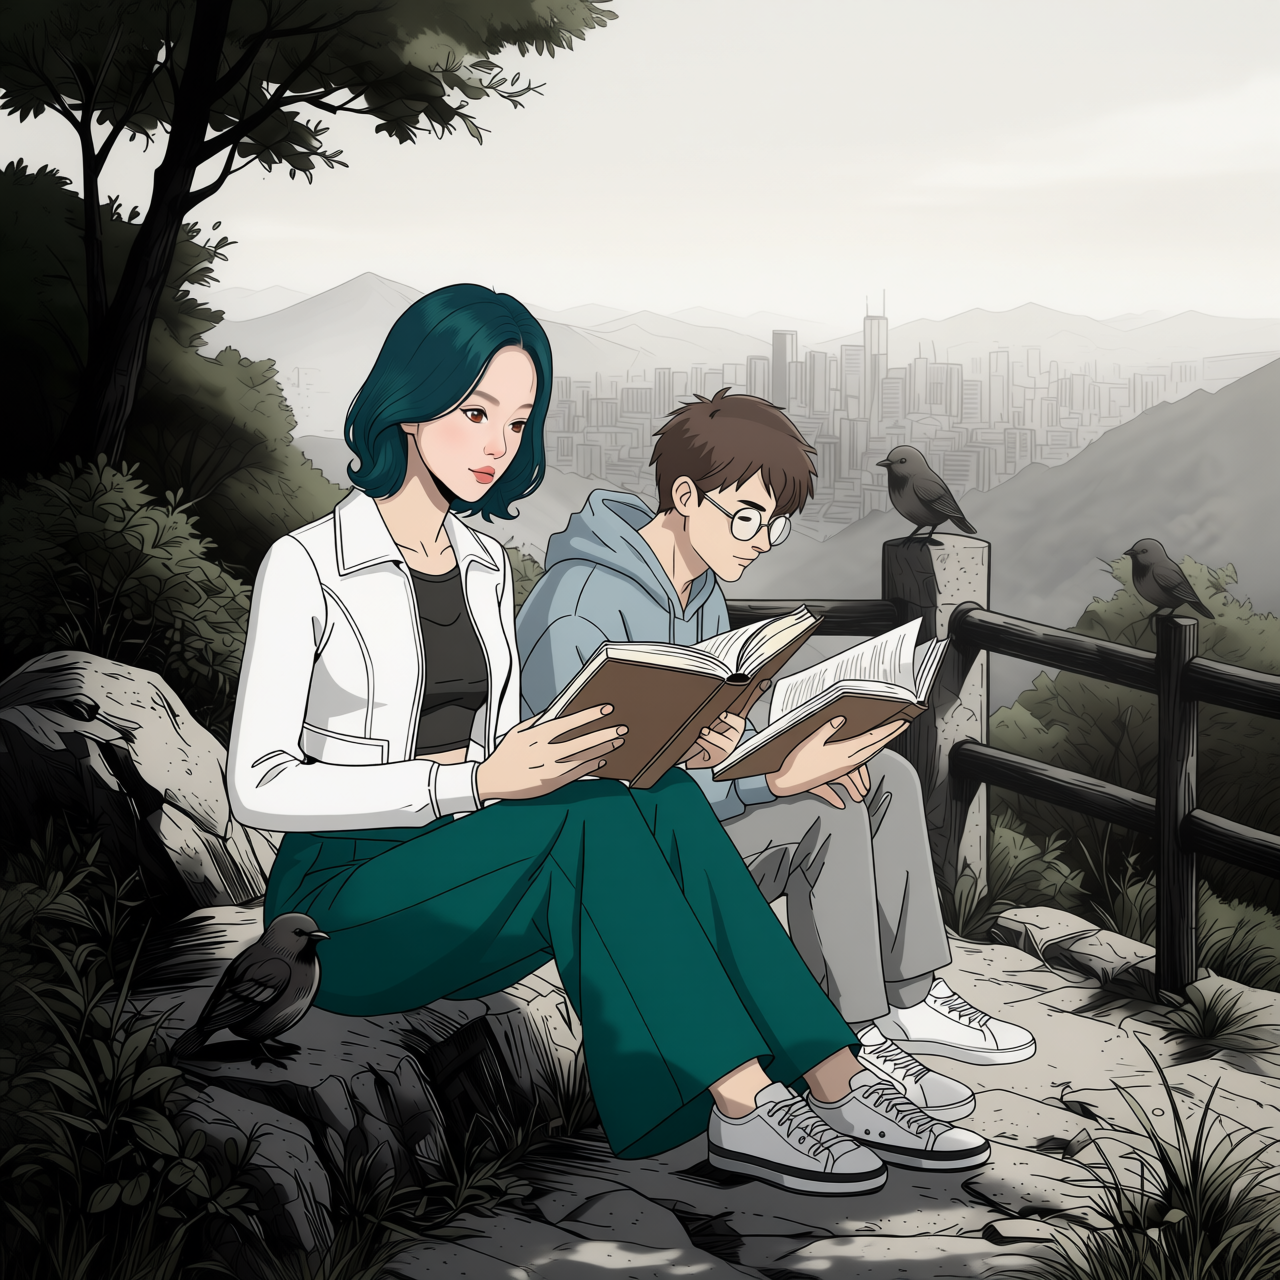 |
A는 하늘과 도로가 밝아지고 건물 측면은 어둡게 남았다. Mira의 단발과 주변 여섯 인물이 유지됐다. B에는 황금빛 역광과 가장자리 빛이 뚜렷하게 반영됐고, 단발·두 신발·토끼·다람쥐가 남았다. 다만 최초 씬에 비해 가장자리 빛이 과장됐다. C는 두 인물·두 권의 책·새 세 마리를 유지하며 하늘과 도시 배경이 밝아지고 부드러운 주광이 반영됐다.
이번 결과에서는 조명 지시에 따른 변화가 보이지만 얼굴·구도·세부 형태도 달라졌다. 최초 씬의 조명을 정확히 복원했거나 다른 픽셀을 모두 보존했다고 판단하지 않는다. 또한 LoRA 미적용 대조군을 생성하지 않았으므로 변화 전체를 LoRA만의 효과로 분리해 설명할 수는 없다.
한 단계의 성공과 다음 단계의 보존을 따로 판단한다
B의 마네킨·착장·BFS·최종 Relight를 차례로 비교해 보자. 착장과 신발이 반영된 시점, 포즈·인물 크기가 바뀐 시점, 얼굴 불일치가 남은 시점을 각각 짚는다. 마지막 장면이 더 밝고 완성도 있어 보여도 앞 단계의 얼굴 문제가 해결됐다는 근거가 되지는 않는다.
C에서는 두 권의 책이 처음 다시 생긴 결과를 찾아 DeLight·합성·Relight까지 추적한다. 이어 배경판과 배경 DeLight를 비교해 새 세 마리의 유지와 하늘·색조 변화를 따로 적는다. 각 비교에서 바꾸려던 것, 유지된 것, 함께 바뀐 것을 한 문장씩 남기면 다음에 수정할 단계를 정할 수 있다.
단계별 입력을 확인하고 재현한다
위 결과를 따라 실행할 때는 저장소 루트의 .venv와 로컬 CUDA GPU를 사용한다. 필요한 패키지와 모델 캐시를 먼저 준비한다. 생성 편집의 공통 조건은 출력 1280×1280, seed 62294, true CFG 4.0, BF16과 sequential CPU offload다. 스텝 수는 직접 아이덴티티 30, 마네킨·착장·책 보강 20, BFS 이후 각 단계와 배경판 생성 10이다. 인물 분리와 머리 크롭 준비에는 이 생성 조건을 적용하지 않는다.
--dry-run이 있는 명령은 모델을 불러오지 않고 입력·프롬프트·출력 계획을 확인한다. 이를 빼면 생성한다. 기존 출력을 덮어쓰지 않도록 재실행에는 새 --run-label이나 지원되는 --output-dir을 지정한다. 새 결과를 다음 생성기에 연결할 때는 계획에 표시된 실제 입력 경로를 확인한다. 각 JSON의 입력·출력 해시, 프롬프트, 모델·코드·실행 환경은 원고의 채택 결과를 추적하는 기준이다.
인물 마스크와 컷아웃을 재현한다
재현 코드는 A·B·C Mira와 C 조연을 각각 마스크·오버레이·흰 배경 컷아웃·투명 PNG로 출력한다. 설정 파일에는 현재 1280×1280 입력의 SHA-256, 대상 인물의 선택점, 추가 포함점·제외점, 상자와 후처리 옵션을 기록한다. 다른 이미지에 그대로 적용하는 일반 좌표가 아니므로 입력 해시가 다르면 실행 전에 중단한다.
Grounding DINO Tiny와 SAM 2.1 Hiera Small 모델은 .tmp/download/huggingface/hub에 준비한다. 먼저 네 인물의 입출력 계획을 확인한다.
다음 명령은 네 인물의 분리 이미지와 인물별 실행 JSON, 전체 검증 JSON을 저장한다.
C 미라와 조연만 재현하려면 대상을 선택한다.
기존 파일이 있는 출력 경로는 전체 실행 전에 거부한다. 다시 실행할 때는 새 출력 폴더 또는 --run-label을 지정한다. 실행 코드는 출력 이름을 기준으로 다음 컷아웃 입력을 연결하므로, 마스크 경로를 따로 고칠 필요가 없다. 인물별 상자와 좌표는 설정 파일의 mask_args에 기록되어 있다.
실제 재실행 검증 기록에서는 네 인물 모두 마스크·흰 배경·투명 PNG가 기준 이미지와 픽셀 단위로 일치했다. 현재 재현 코드는 기존 마스크·흰 배경 컷아웃과 비교하고, 새로 생성한 투명 PNG의 알파와 마스크 일치, 선택된 원본 픽셀의 보존, 흰 배경과 출력 크기를 확인한다. 기존 투명 PNG는 검증 입력으로 요구하지 않는다. 기준과 다르거나 픽셀 검사가 실패하면 결과 JSON을 남기고 오류로 종료한다. 이 재현 확인은 기록된 로컬 환경에서 수행했으며, 모델·패키지 환경이 달라지면 결과 JSON의 실행 환경과 차이 항목을 확인해야 한다. 경계의 미세 누락이나 C의 가림 영역까지 복구됐다는 의미는 아니다.
실제 추론은 인물 마스크 생성 코드가, 픽셀 복사와 알파 저장은 흰 배경·투명 컷아웃 생성 코드가 담당한다.
A Mira와 C 조연의 외형을 적용한다
생성기는 신규 컷아웃 경로와 Mira 참조를 기본값으로 사용하며 추가 LoRA를 불러오지 않는다.
CPU 난수 생성기를 사용하며 각 입력은 비율을 유지해 1280×1280 흰 캔버스에 배치한다.
--targets로 대상, --reference로 Mira 참조, --supporting-prompt로 조연 외형, --steps와 --seed로 생성 조건을 바꿀 수 있다. 조연의 텍스트 전용 실행에서는 참조 경로가 null, text_only가 true다.
B·C 마네킨을 만든다
생성기는 분리 설정 파일에서 각 Mira의 흰 배경 컷아웃을 찾아 원본 캔버스 그대로 입력한다. CPU 난수 생성기를 사용했다.
--scenes로 대상, --prompt로 공통 외형 지시, --steps와 --seed로 조건을 바꿀 수 있다. B·C의 실제 지시는 각각의 JSON으로 확인한다.
B·C 마네킨에 착장을 적용한다
B·C 마네킨과 공통 착장 참조는 비율을 유지해 각각 1280×1280 흰 캔버스에 배치한다. CPU 난수 생성기를 사용했다.
--scenes는 대상, --reference는 착장 참조, --prompt는 편집 지시, --steps와 --seed는 생성 조건을 바꾼다.
C Mira와 조연에게 책을 추가한다
C Mira의 착장 1차 결과 한 장을 입력으로 사용하며 CPU 난수 생성기로 실행했다.
--input으로 보강할 이미지, --prompt로 지시, --steps와 --seed로 생성 조건을 바꿀 수 있다.
머리 크롭을 준비하고 BFS를 적용한다
각 명령쌍에서 --prepare-reference는 크롭 파일이 없을 때만 실행한다. 두 번째 명령으로 BFS 입력과 생성 계획을 확인한다.
B는 다음 명령으로 재현한다.
A 명령의 zero-v3는 로우뷰 0° 크롭을, B 명령의 low45-v4는 로우뷰 +45° 크롭을 선택한다. 두 생성기는 로컬 Qwen Image Edit 2511 BF16과 BFS Head V5 original 강도 1.0을 사용한다. 마스크나 결과 합성 없이 10스텝 실행한다. 프롬프트는 Picture 2의 머리를 적용하면서 Picture 1의 시선·머리 회전·표정을 유지하도록 지시한 기존 BFS 문장을 유지한다. 전문과 입력 순서, 크롭 이력, 모델·입출력 해시는 결과 JSON에서 확인한다. A 결과 JSON의 소스코드 해시는 생성 당시의 기록이다. 이후 코드 변경으로 현재 파일의 해시와는 다르지만, A의 zero-v3 입력·크롭·프롬프트·생성 설정은 유지했다.
네 캐릭터의 조명을 중립화한다
--targets로 처리할 인물을 선택하고 --delight-scale로 조명 보정 강도를 바꿀 수 있다.
장면에서 편집 대상 인물을 제거한다
A·B는 생성기의 기본 프롬프트를 사용한다. C는 원래 새의 위치를 지정한 v2 결과를 사용하며, 이를 재현할 때는 아래 --prompt를 명시한다.
--targets로 장면을 선택하며, --prompt는 한 장면을 선택했을 때만 사용할 수 있다.
배경판의 조명을 중립화한다
--targets로 장면을 선택하고 --delight-scale로 LoRA 강도를 조절한다.
배경과 캐릭터를 합성한다
--targets로 장면을 선택하고, 하나의 장면을 선택한 경우 --prompt로 배치 지시를 바꿀 수 있다.
장면별 조명을 텍스트로 적용한다
--targets로 장면을 선택하고, 한 장면을 선택한 경우 --prompt로 조명 설명을 바꾼다. 위 기본 실행에서는 각 합성 이미지 한 장만 모델에 입력한다. JSON의 inputs에는 실제 입력을 기록한다. prompt_basis에는 프롬프트 작성에 참고한 최초 씬 경로·해시를 기록한다. 이후 코드 변경으로 현재 코드의 해시는 text-v2 생성 당시 기록과 다르지만 위 명령의 입력·프롬프트·생성 조건은 유지한다.
체크리스트
- P7-5.4 입력부터 캐릭터·배경 두 흐름과 합성·Relight까지 실제 파일과 JSON으로 연결할 수 있는가?
- 마스크로 복사한 원본 픽셀과 가림 영역·외형·소품을 새로 생성한 부분을 구분할 수 있는가?
- 직접 적용과 마네킨 경유의 입력 역할을 설명하고, 착장 반영과 포즈·크기 보존을 따로 판단했는가?
- BFS 참조의 머리 방향·표정·얼굴 일치를 구분하고, A의 신발 오류와 B의 얼굴 불일치를 남은 한계로 기록했는가?
- C 두 권의 책, A 주변 인물 6명, B 토끼·다람쥐, C 새 3마리가 후속 단계에서도 유지됐는지 비교했는가?
- DeLight·합성의 밝기·색조 변화를 비교하고, Relight의 실제 단일 이미지 입력과 조명 설명의 근거를 구분했는가?
- 다음에 수정할 한 단계를 고르고, 변경할 조건과 유지 여부를 비교할 대상을 설명할 수 있는가?
출처와 참고 자료
- IDEA Research, Grounding DINO Tiny 모델 카드, Hugging Face, 확인일: 2026-09-11.
- Meta FAIR, SAM 2.1 Hiera Small 모델 카드, Hugging Face, 확인일: 2026-09-11.
- Qwen, Qwen-Image-Edit-2511 모델 카드, Hugging Face, 확인일: 2026-09-11.
- mr2along, BFS 모델 카드, Hugging Face, 확인일: 2026-09-11.
- prithivMLmods, QIE-2511-Studio-DeLight 모델 카드, Hugging Face, 확인일: 2026-09-11.
- Qwen, Qwen-Image-Edit-2509 모델 카드, Hugging Face, 확인일: 2026-09-11.
- dx8152, Qwen-Image-Edit-2509-Relight 모델 카드, Hugging Face, 확인일: 2026-09-11.