P2-3.3 矩阵乘法(matrix multiplication)到底在复用什么
Section ID:
P2-3.3Version:v2026.09.08
矩阵乘法一开始看上去像一种单纯的乘法规则,但实际上,它更接近于 把同一种加权求和(weighted sum)结构反复复用的计算。
- 把输入值和权重绑在一起再相加。
- 先做出一个新值。
- 把同样的计算重复到多个输出上。
- 再一次性应用到多个输入上。
加权求和与维度条件
| 基准 | 为什么重要 |
|---|---|
| 矩阵乘法是在复用加权求和 | 因为它是一次不只生成一个输出,而是能同时生成多个输出的基础计算。 |
| shape 决定计算是否成立 | 因为如果内侧维度对不上,就无法知道哪个值该和哪个权重配对。 |
| 线性变换是在改变表示 | 因为神经网络层和分类器的说明,最终都会连到“把输入变成新表示”的计算。 |
逐位置乘法与矩阵乘法
在 P2-3.1 里,我们说过 shape 相同的向量或矩阵可以逐位置相加。乘法也可以写成逐位置乘法。
这里的 \(\odot\) 表示相同位置上的值直接相乘。这种计算会把每个位置分别处理。
矩阵乘法则不同。矩阵乘法并不是只把相同位置的值拿来相乘,而是通过一边的行(row)与另一边的列(column)相组合,生成新值。
- 逐位置乘法只会把对应位置直接相乘。
- 矩阵乘法会按行和列去“乘并相加”。
这两件事必须先分开。只要把矩阵乘法误读成逐位置乘法,就会同时看错 shape 错误和计算意义。
加权求和与单个输出
先看一个向量和一组权重。
如果把相同位置的值相乘之后再相加,就会得到一个数字。
这个计算可以这样读。
- 把第一个输入值乘上第一个权重。
- 把第二个输入值乘上第二个权重。
- 把结果相加。
- 做出一个输出值。
这就是加权求和(weighted sum)的基本形状。
在 AI 模型里,输入值不一定具有相同的重要性。有些值可以被强调,有些值可以被弱化,也有些值会朝负方向产生影响。权重(weight)就是把这种影响程度写成数字。
多个输出的加权求和
要做出一个输出时,我们需要一组权重向量。如果想做出两个输出,就需要两组权重向量。
这里的 \(W\) 是权重矩阵(weight matrix)。第一列可以读成生成第一个输出值的权重,第二列可以读成生成第二个输出值的权重。
计算后会变成:
这个计算实际上就是把加权求和复用了两次。
矩阵乘法把“乘并相加”这个小计算反复应用到多个输出上。所以,矩阵乘法会成为把一个输入向量改造成另一种形状输出向量的工具。本例中,输入向量长度为 2,权重矩阵的 shape 为 (2, 2),输出向量长度也为 2。
输入长度与矩阵行数
在矩阵乘法里,shape 非常重要。输入向量的值的个数,必须和权重矩阵的行(row)数相匹配。
在这个计算里,输入向量长度是 2,矩阵也有 2 行。因此每个输入值都能与每一行中的权重发生对应。
反过来,下面这个计算就不能直接对上。
输入有 3 个值,但权重矩阵只能接收 2 个输入。
- 输入长度和权重矩阵输入侧的大小必须一致。
- 如果不一致,就无法决定哪个值该和哪个权重相乘。
这正是 AI 代码里 shape 错误经常出现的原因之一。矩阵乘法不管在数学上还是代码里,都是一种 只有形状对得上才能执行 的计算。
多个输入的批量计算
矩阵乘法的力量不只在于处理一个输入。我们还可以把多个输入收集成一个矩阵,一次性计算。
例如,假设有两个输入向量。
每一行(row)都是一个输入样本(sample)。
再乘上同一个权重矩阵 \(W\)。
计算结果会变成:
第一行是第一个样本的输出,第二行是第二个样本的输出。
- 先把多个输入样本收集成矩阵。
- 再乘上同一个权重矩阵。
- 一次得到多个输出样本。
这会直接连到 batch 计算的基础直觉。模型当然可以一个一个地处理输入,但如果把多个输入打包一起算,就能反复复用同一种计算结构。
线性变换与输出维度
线性变换(linear transformation)可以先理解成:通过矩阵乘法,把一个向量变成另一个向量。
- 先准备输入向量。
- 再应用权重矩阵。
- 得到输出向量。
例如,如果输入有 2 个值,输出要有 3 个值,那么权重矩阵就必须具有“接收 2 个输入、生成 3 个输出”的形状。
这可以读成下面这样。
- 接收一个由 2 个值表示的输入。
- 把它变成一个由 3 个值表示的输出。
在二维里,这种变化还能画成图。下面这个例子展示了:输入向量 \(\mathbf{x} = [2,\ 3]\) 乘上一个简单的矩阵 \(W\),被移动到 \(\mathbf{y} = [2,\ 4]\)。
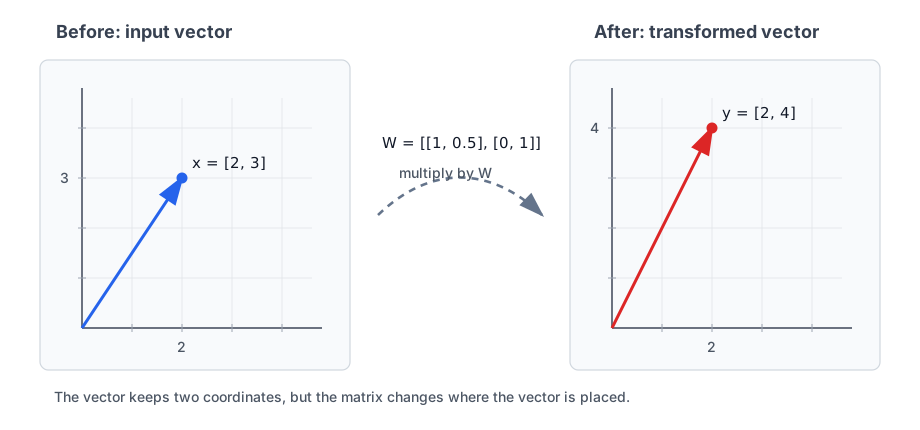
图中的变换保持第一个坐标不变,把第二个坐标从 3 变为 4。
在真实 AI 模型里,这类变换发生在远比二维图更高的空间里。人当然很难直接画出来,但基础思路不变:输入表示会经过权重矩阵,被移动到另一个表示。
这个视角在 AI 里很重要。模型不会把输入表示原封不动地留下,而是通过多步计算,把它不断变成新的表示。
- 先有原始输入表示。
- 经过第一层变换。
- 得到中间表示。
- 再经过下一层变换。
- 朝着更接近最终输出的表示移动。
神经网络(neural network)的层(layer)就可以看成是把这种变换不断叠起来的结构。当然,真实神经网络并不只由线性变换组成。像 activation function、normalization、attention 这样的其他计算也会一起出现。
检查清单
- 能区分矩阵乘法和逐位置乘法吗?
- 能说明加权求和是“输入值乘权重再相加”的计算吗?
- 能把矩阵乘法读成“一次同时计算多个加权求和”的方式吗?
- 能说明输入向量长度必须和权重矩阵输入侧大小一致吗?
- 能解释把多个样本打包成矩阵、再应用同一个权重矩阵的 batch 计算直觉吗?
- 能把线性变换解释成“把输入表示变成另一种输出表示”的计算吗?
- 能说明为什么矩阵乘法会在神经网络层、embedding、classification 里再次出现吗?
-
能把矩阵乘法解释成
输入 -> 权重矩阵 -> 输出的加权求和复用结构吗? -
能同时理解输入维度、输出维度与权重矩阵的 shape,并将矩阵乘法与逐位置乘法区分开吗?
来源与参考资料
- Marc Peter Deisenroth, A. Aldo Faisal, Cheng Soon Ong, Mathematics for Machine Learning, Cambridge University Press, 2020, 确认日期: 2026-07-19.
- Ian Goodfellow, Yoshua Bengio, Aaron Courville, Deep Learning, MIT Press, 2016, 确认日期: 2026-07-19.
- Charles R. Harris et al., Array Programming with NumPy, Nature, 2020, 确认日期: 2026-07-19.
- NumPy Developers, numpy.matmul, NumPy User Guide, 确认日期:2026-07-19. 这个官方参考资料支持矩阵乘法的 shape 条件和
@运算符的含义。 - Google for Developers, Neural networks: Nodes and hidden layers, Machine Learning Crash Course, 确认日期:2026-07-19. 这个官方教育资料说明神经网络节点值由输入与权重的乘积求和计算而来。