P2-5.2 分布(distribution)、均值(mean)、方差(variance)
Section ID:
P2-5.2Version:v2026.09.15
分布显示数值集中在哪里、各处有多少值。均值用数字概括中心,方差概括均值周围的离散程度。两组数据即使均值相同,分布与方差也可能不同。
分数区间与个数
把 10 个考试分数按区间分组,就能看出数值集中在哪里。
40, 45, 48, 50, 52, 55, 58, 60, 62, 90
直方图的横轴表示分数区间,纵轴表示各区间内数值的个数。这里所有区间的宽度都是 10 分。每个区间包含左边界,右边界则归入下一个区间。
| 分数区间 | 区间内的分数 | 个数 |
|---|---|---|
| 35 ≤ 分数 < 45 | 40 | 1 |
| 45 ≤ 分数 < 55 | 45, 48, 50, 52 | 4 |
| 55 ≤ 分数 < 65 | 55, 58, 60, 62 | 4 |
| 65 ≤ 分数 < 75 | 无 | 0 |
| 75 ≤ 分数 < 85 | 无 | 0 |
| 85 ≤ 分数 < 95 | 90 | 1 |
45 分属于第二个区间,55 分属于第三个区间。这样规定边界,就不会把同一个分数计算两次。各区间的个数相加为 10,等于原始分数的总个数。
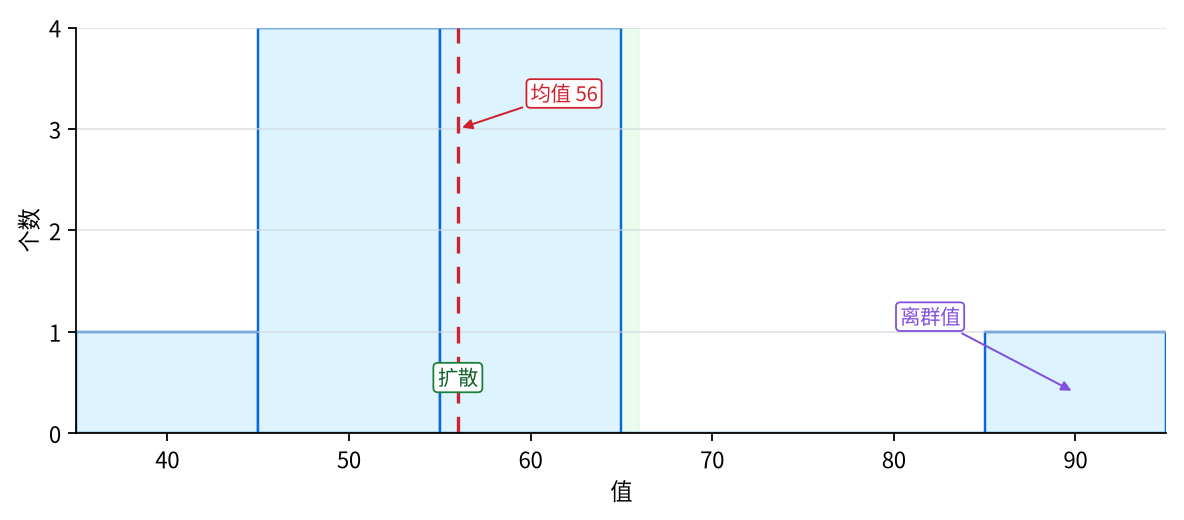
10 个值中有 8 个集中在大于等于 45、小于 65 的范围内,大于等于 65、小于 85 的范围内没有值。90 分与其余数值相隔较远。红色虚线表示均值 56。只看均值线无法知道哪些区间没有值,也看不出相隔较远的分数,因此还要一起观察柱子的排列。
数据分布与概率分布
分布可以指观测数据的排列,也可以指可能取值的概率。
| 表达 | 英语 | 工作用解释 |
|---|---|---|
| 数据分布 | data distribution | 实际观测到的数据值是怎样摆出来的 |
| 概率分布 | probability distribution | 给可能取值分配概率的数学表达 |
例如,假设真实收集到了 10 万个用户年龄数据。如果把这些值画成直方图,我们看到的是数据分布。
而如果我们是在数学上表达“某个值出现的可能性是多少”,那读的是概率分布。
数据分布说的是:已经收集到的值是怎样摆放的;概率分布说的是:可能取值会以什么样的可能性出现。
它们彼此有关,但并不是同一个东西。我们可以看实际数据分布,然后去假设或估计一个概率分布,但这并不表示观测到的数据本身就等于完整的概率分布。
在 AI 里,这个区分很重要。训练数据的分布,是模型真正见过的数据形状;而现实世界的分布,是模型之后可能会遇到的数据形状。如果这两种分布不同,模型性能就可能变得不稳定。
均值计算
均值(mean)是把很多值总结成一个代表中心的值。
假设有下面这些值。
2, 4, 6, 8, 10
均值的做法是:把所有值加起来,再除以值的个数。
如果用 sigma 记号写,就是:
Sigma 压缩了把所有值相加的计算。将总和除以个数 n,就得到均值。
均值之所以被大量使用,原因很简单:它能把很多值压成一个可以比较的数字。比如本月平均响应时间、每个用户平均点击次数、一个 batch 的平均损失、模型的平均准确率,都是这样读取的。
但均值并不会把数据的所有特点都告诉你。
相同均值,不同离散程度
均值能很快显示出中心,但它也可能把值的形状隐藏起来。
假设有两组数据。
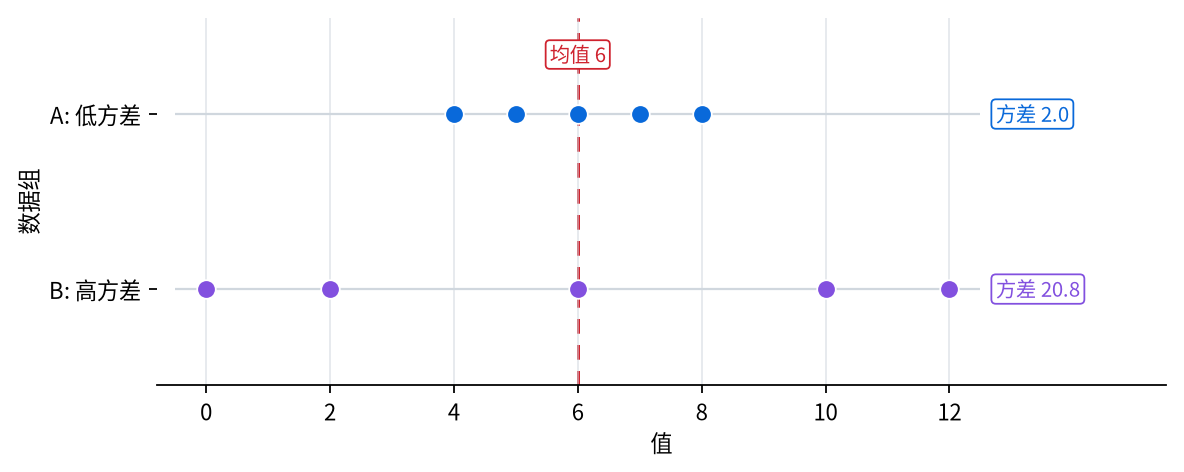
A: 4, 5, 6, 7, 8, B: 0, 2, 6, 10, 12
这两组的均值都是 6。
但这两组数据显然不会给人同样的感觉。A 的值集中在均值附近,而 B 的值离均值散得很远。
如果只看均值,两组数据可能会看起来差不多。但实际上,稳定性、可预测性、风险都可能不同。
下面这张图展示的是:即使均值一样,离散程度也可能完全不同。
与均值的距离及方差
方差(variance)是显示值在均值周围散开多大的那个值。
把每个值与均值的差平方,再求平均,可以概括这组观测数据的离散程度。
计算方差时常见的流程如下。
- 先求均值。
- 用每个值减去均值。
- 把差值平方。
- 再对这些平方值求平均。
将这组数据本身的方差记作 v,可写为:
该式描述给定数据的离散程度,因此除以个数 n。常用于估计总体方差的样本方差则除以 n − 1,计算目的与此不同。
高于均值的值给出正差,低于均值的值给出负差。直接相加会相互抵消,平方后则可以把偏离均值的程度收集为非负值。
两组数据的方差计算
前面的两组数据 A: 4, 5, 6, 7, 8 与 B: 0, 2, 6, 10, 12 的均值都是 6。
| 计算 | A | B |
|---|---|---|
| 与均值的差 | −2, −1, 0, 1, 2 | −6, −4, 0, 4, 6 |
| 差的平方 | 4, 1, 0, 1, 4 | 36, 16, 0, 16, 36 |
| 平方和 | 10 | 104 |
| 方差:总和 / 5 | 2 | 20.8 |
均值相同,但 B 的方差是 A 的 10.4 倍。B 中远离均值的值更多,这个差异通过数字体现出来。
方差与标准差的单位
一旦学方差(variance),通常也会很快遇到标准差(standard deviation)。
标准差就是方差的平方根。
如果数据的单位是秒,方差的单位就是秒²,标准差的单位则是秒。标准差取平方根后,可以用原始数据的单位比较离散程度。
如果 A 和 B 表示响应时间(秒),标准差分别为 √2 ≈ 1.41 秒、√20.8 ≈ 4.56 秒。即使两个服务的平均响应时间都是 6 秒,B 的响应时间也分散得更广。
平均损失与群体差异
模型评估中,只看均值也可能掩盖差异。假设 100 个评估样本中,90 个的损失为 0.1,其余 10 个为 2.1,平均损失就是 (90 × 0.1 + 10 × 2.1) / 100 = 0.3。
整体均值为 0.3,但最后 10 个样本的损失为 2.1。如果它们是在相同拍摄条件下得到的图像,就可以单独检查模型是否难以处理该条件。这就是同时查看平均损失、损失分布和各群体数值的原因。
检查清单
- 能说明分布、均值、方差分别表示形状、中心与离散程度吗?
- 能区分观测数据的分布与概率分布吗?
- 能计算出均值同为 6 的两组数据的方差分别是 2 和 20.8 吗?
- 能区分数据本身的方差与估计总体方差的样本方差所用的分母吗?
- 能说明方差与标准差的关系及单位吗?
- 能说明整体平均损失如何掩盖特定群体的较大损失吗?
来源与参考资料
- Barbara Illowsky, Susan Dean, Introductory Statistics, 2.2 Histograms, Frequency Polygons, and Time Series Graphs, OpenStax, 确认日期: 2026-07-20。用于确认通过直方图读取大数据组的形状、中心、离散程度这一说明。
- Barbara Illowsky, Susan Dean, Introductory Statistics, 2.5 Measures of the Center of the Data, OpenStax, 确认日期: 2026-07-20。用于支撑把均值(mean)说明为数据中心代表值的表述。
- Barbara Illowsky, Susan Dean, Introductory Statistics, 2.7 Measures of the Spread of the Data, OpenStax, 确认日期: 2026-07-20。用于确认方差与标准差围绕均值的离散程度、平方偏差、回到原始单位这一说明。