P2-5.5 补充学习:初读标准差、相关与置信区间
Section ID:
P2-5.5Version:v2026.09.15
均值旁的 ± 数值可能表示标准差、标准误,或置信区间的半宽。标准差描述数据的离散程度,标准误与置信区间描述估计的不确定性。相关系数描述两个变量的关系,假设检验则考察特定假设与观测结果是否相符。
各统计量描述的对象
| 术语 | 描述的对象 |
|---|---|
| 标准差(standard deviation) | 数据值的离散程度 |
| 协方差(covariance) | 两个变量的偏差共同变化的方向 |
| 皮尔逊相关系数(Pearson correlation coefficient) | 两个变量线性关系的方向与强度 |
| 标准误(standard error) | 更换样本时估计值的变化程度 |
| 置信区间(confidence interval) | 按指定方法计算的参数估计区间 |
| 假设检验(hypothesis testing) | 判断是否有依据拒绝原假设的程序 |
标准差与原始单位
标准差是方差的平方根。如果响应时间的方差为 100 秒²,标准差就是 √100 = 10 秒。这样可以用与原始数据相同的单位读取方差所描述的离散信息。
均值为 50 秒、标准差为 10 秒,并不表示所有响应时间都在 40~60 秒之间。要知道该区间包含多少数值,还需检查数据分布。
偏差的乘积与协方差
协方差对两个变量各自减去均值后的偏差乘积进行汇总。两个偏差同号时乘积为正,异号时乘积为负。
| 观测 | x | y | x 的偏差 | y 的偏差 | 偏差的乘积 |
|---|---|---|---|---|---|
| 1 | −1 | 2 | −1 | −2 | 2 |
| 2 | 0 | 4 | 0 | 0 | 0 |
| 3 | 1 | 6 | 1 | 2 | 2 |
x 的均值为 0,y 的均值为 4。样本协方差为 2,即偏差乘积之和 4 除以 n − 1 = 2。在这组数据中,x 增大时 y 也增大,表现为正协方差。
协方差的大小受单位影响。将 y 从米改为厘米,记作 200, 400, 600,同一组观测的样本协方差也变为 200。关系不变,但数字增大了 100 倍。
皮尔逊相关系数与线性关系
皮尔逊相关系数(Pearson correlation coefficient)用协方差除以两个变量标准差的乘积,消除单位的影响。两个变量的标准差均大于 0 时才能计算,其值介于 −1 与 1 之间。
前面数据中,x 和 y 的样本标准差分别为 1 和 2,因此相关系数为 2 / (1 × 2) = 1。把 y 换算成厘米后,仍为 200 / (1 × 200) = 1。
| 皮尔逊相关系数 | 解释 |
|---|---|
| 1 | 递增的直线关系 |
| −1 | 递减的直线关系 |
| 接近 0 | 线性关系较弱 |
相关系数为 0 时也可能存在曲线关系。例如,x = −1, 0, 1、y = 1, 0, 1 满足 y = x²,但皮尔逊相关系数为 0。仅凭相关性强,也不能断定一个变量是另一个变量的原因。
点表示正文中的三对观测值,虚线表示给定的关系式。左图的点位于递增直线 y=2x+4 上,相关系数为 1。右图的点位于 y=x² 曲线上,但负 x 与正 x 对应的偏差乘积相互抵消,因此相关系数为 0。这些值概括的是三个观测值的关系,不能仅凭小样本的相关系数就确定总体关系。
标准差与标准误
标准误是估计量抽样分布的标准差,表示以相同方式重新抽取样本时,样本均值等估计值可能变化多少。
一次抽取的样本包含多个单次响应时间。如果反复抽取相同大小的样本,每次计算均值,就会得到多个均值。标准差描述单个数值的离散程度,均值的标准误描述重复抽样所得均值的离散程度。 并不需要实际开展多次调查才能计算标准误;下面的公式利用一个样本的信息估计这种离散程度。
用从同一总体独立抽取的样本估计均值时,可根据样本标准差 s 和样本量 n,用 s / √n 估计均值的标准误。
如果样本量为 100、样本标准差为 10 秒,均值标准误的估计值就是 10 / √100 = 1 秒。样本量增至 400 且样本标准差仍为 10 秒时,则为 10 / √400 = 0.5 秒。即使数据的离散程度不变,增加样本量也能更精确地估计均值。
下图是一个理论比较,假定总体服从均值50秒、标准差10秒的正态分布。上图表示单次响应时间的分布,下图表示每次独立抽取100个观测值后计算的样本均值分布。这里已知总体标准差,因此均值的标准误恰为 10/√100=1秒。
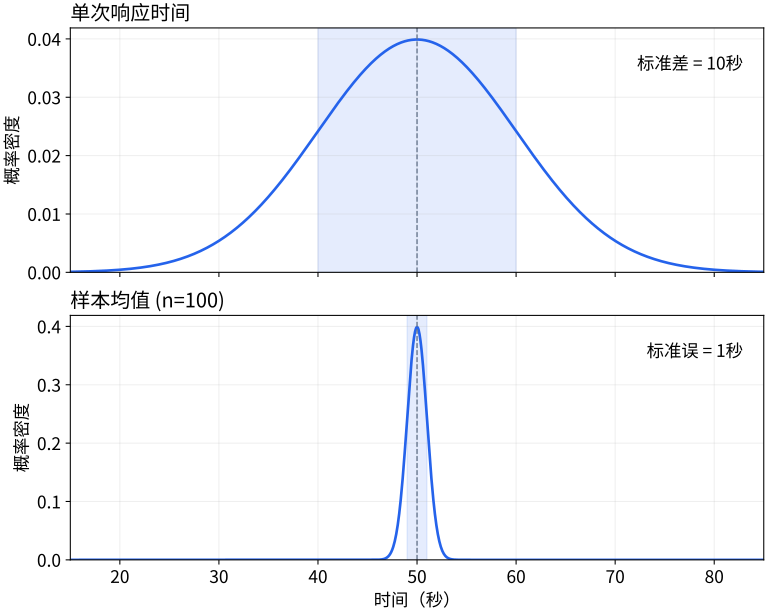
两幅图的横轴单位都是秒,纵轴表示各自分布的概率密度。阴影表示从各自均值向两侧各延伸一个该分布标准差的范围。均值分布变窄,并不意味着单次响应时间变得更加相似,而是100个观测值的平均比单次观测更稳定。这个假想总体的均值50秒,应与下文置信区间计算中的观测均值53.4秒区分。
均值的置信区间
假设从正态分布总体独立抽取的 100 个观测值,其样本均值为 53.4 秒,样本标准差为 10 秒。使用 t 分布,可按下式计算总体均值的 95% 置信区间。
样本均值 ± t 系数 × 标准误
此时自由度为 n − 1 = 99,双侧 95% 区间的 t 系数约为 1.984。自由度在此用于确定 t 分布的形状及相应系数。
因为总体标准差未知,要用样本标准差 s 代替,所以使用t分布。t分布比正态分布的尾部更厚,反映了估计标准差的不确定性。先根据样本算出均值后,各个值与均值之差的总和为0。因此,99个偏差确定后,最后一个不能再自由选择,这里的自由度就是99。
双侧95%区间保留中间的95%,把外侧5%分到两端,每个尾部占2.5%。自由度99的t分布,中间95%的边界约为 −1.984 和 +1.984。t系数来自累积概率表或统计工具,并不是只看观测均值就能确定的数字。
53.4 ± 1.984 × 1 ≈ [51.42, 55.38] 秒
95% 描述的是构造区间的方法。如果在相同条件下反复抽样并计算区间,长期来看,约 95% 的区间会包含总体均值。这并不表示 95% 的单次响应时间落在已经计算出的这个区间内。
在频率学派的置信区间中,总体均值固定,而区间随样本改变。因此,不能把已经算出的 [51.42,55.38] 解释为“总体均值有95%的概率位于其中”。95%描述的是重复应用相同方法时的覆盖率。
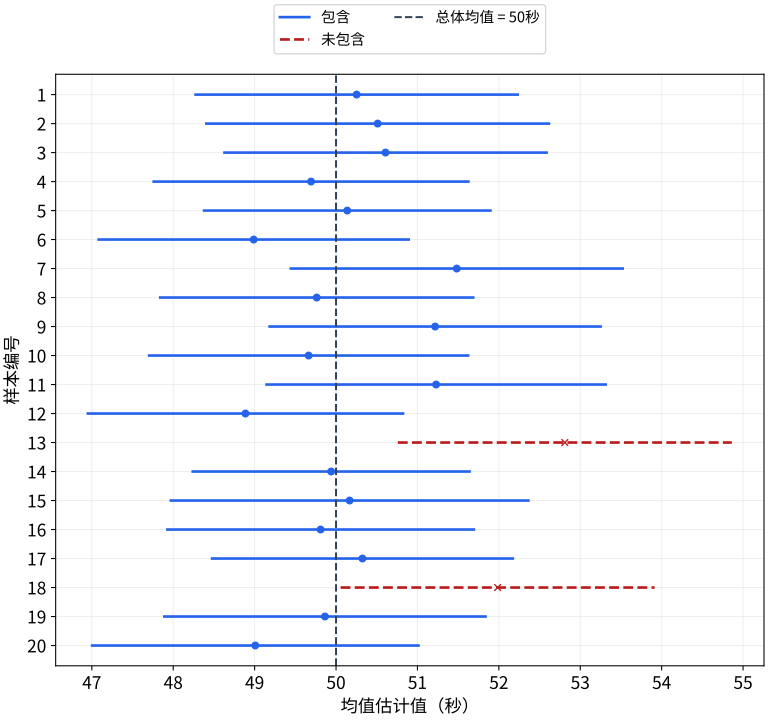
上图从均值50秒、标准差10秒的正态总体中,每次独立抽取100个观测值,模拟重复20次。点表示样本均值,线段表示该样本的95% t置信区间。竖直虚线是模拟中已知的总体均值,未包含它的区间用红色虚线表示。本次模拟中,20个区间有18个包含总体均值。20个区间不必恰好有19个包含总体均值。 95%是长期重复中的比例;实际调查中不知道真值,通常也无法判定某个区间是否成功包含了它。
置信区间窄,并不意味着收集偏差也小。例如,如果只收集响应快的设备记录,增加样本量可以缩窄该群体均值的区间,却仍可能偏离全部设备的均值。上述 95% 的解释,适用于抽样反映目标总体且计算假设成立的情况。计算置信区间之后,仍需要执行P2-5.3 的样本代表性检查。
原假设与假设检验
假设检验利用样本数据判断是否有依据拒绝原假设(null hypothesis)。在响应时间的例子中,可以把原假设设为 总体均值为 50 秒,备择假设设为 总体均值不同于 50 秒。
显著性水平5%是在根据数据作出结论之前选择的错误标准。当原假设及检验假设成立时,这个边界使长期重复检验中错误拒绝真实原假设的比例为5%。它并不意味着“本次结论出错的概率为5%”,也不是“原假设为真的概率为5%”。
观测均值 53.4 秒与假设均值 50 秒相差 3.4 秒。除以标准误 1 秒,得到检验统计量 t = 3.4。在上述假设下,显著性水平为 5% 的双侧 t 检验临界值约为 ±1.984,因此拒绝原假设。
该结果表明观测资料与假定的总体均值 50 秒不太相符。差异在实际应用中是否足够大,需要另行判断。反过来,未能拒绝原假设也不等于证明两者相等。
使用相同的双侧t方法时,95%置信区间与显著性水平5%的检验相互对应。假设均值50秒位于 [51.42,55.38] 之外,因此检验也拒绝它。反过来,用相同样本检验54秒,它位于区间内,且 t=(53.4−54)/1=−0.6 位于临界边界内,因此不拒绝。这不意味着区间中的所有值同样可能,也不证明54秒就是真实均值。
同一均值旁的不同数字
前面的样本可以在报告中写成以下形式。
| 标记 | 解释 |
|---|---|
| 均值 53.4 秒,标准差 10 秒 | 单次响应时间的离散程度 |
| 均值 53.4 秒,标准误 1 秒 | 均值估计值的变动程度 |
| 均值 53.4 秒,95% 置信区间 [51.42, 55.38] 秒 | 按指定方法估计的总体均值区间 |
只写 53.4 ± 10,无法知道所指的统计量。在表格或图中看到 ± 时,应同时确认图例中的统计量名称、样本量和测量单位。
练习:区分离散程度与估计
第一,样本量400、样本标准差10秒时,计算均值标准误。第二,说明仅凭 均值53.4秒 ± 0.5秒 能否判断这是95%置信区间。第三,对于 x=−1,0,1、y=1,0,1,能否因相关系数为0就断定没有关系?
计算与解释
均值标准误的估计值为 10/√400=0.5秒,并不是标准差从10秒缩小到了0.5秒。没有统计量名称,无法确定 ±0.5秒 的含义;95% t置信区间的半宽需要用标准误乘以t系数。最后一组数据满足曲线关系 y=x²,因此皮尔逊相关系数为0不等于没有关系。
检查清单
- 能从方差 100 秒² 算出标准差 10 秒。
- 能说明协方差的大小会随测量单位改变。
- 能说明皮尔逊相关系数表示线性关系,但不能证明因果关系。
- 能区分数据的标准差与均值的标准误。
- 能从重复抽样的角度解释 95% 置信区间。
- 能区分拒绝原假设与差异的实际重要性。
- 能结合统计量名称阅读报告中的
±标记。
来源与参考资料
- Barbara Illowsky, Susan Dean, Introductory Statistics, 2.7 Measures of the Spread of the Data, OpenStax, 确认日期: 2026-07-20。用于说明标准差是方差的平方根,并使用原始数据单位。
- NIST/SEMATECH, Dataplot Reference: CORRELATION, NIST, 确认日期: 2026-09-15。通过偏差乘积 \(S_{xy}\) 与相关系数公式,支持共同变化及相关系数的解释。
- Barbara Illowsky, Susan Dean, Introductory Statistics, 7.1 The Central Limit Theorem for Sample Means, OpenStax, 确认日期: 2026-07-20。用于说明样本均值的抽样分布,以及重复抽样中的标准误。
- Barbara Illowsky, Susan Dean, Introductory Statistics, 8 Introduction, OpenStax, 确认日期: 2026-07-20。用于说明点估计、区间估计、置信区间与误差界限。
- Barbara Illowsky, Susan Dean, Introductory Statistics, 9 Introduction, OpenStax, 确认日期: 2026-07-20。用于说明根据样本证据判断是否拒绝原假设的程序。
- Barbara Illowsky, Susan Dean, Introductory Statistics 2e, 12.4 Testing the Significance of the Correlation Coefficient, OpenStax, 确认日期: 2026-07-20。用于说明相关系数所表达的线性关系强度与方向,以及结合样本量判断可靠性的必要性。
- NIST/SEMATECH, Confidence Limits for the Mean, 确认日期: 2026-09-15。均值的 t 置信区间、重复抽样解释与单样本 t 检验公式的依据。文中数值为解释而自行构造。