P2-9.2 数组、表、树与图的直观理解
Section ID:
P2-9.2Version:v2026.09.15
位置、行列、层级与连接
数组以位置和轴为中心,表以行和列为中心,树以层级为中心,图以连接关系为中心表示数据。
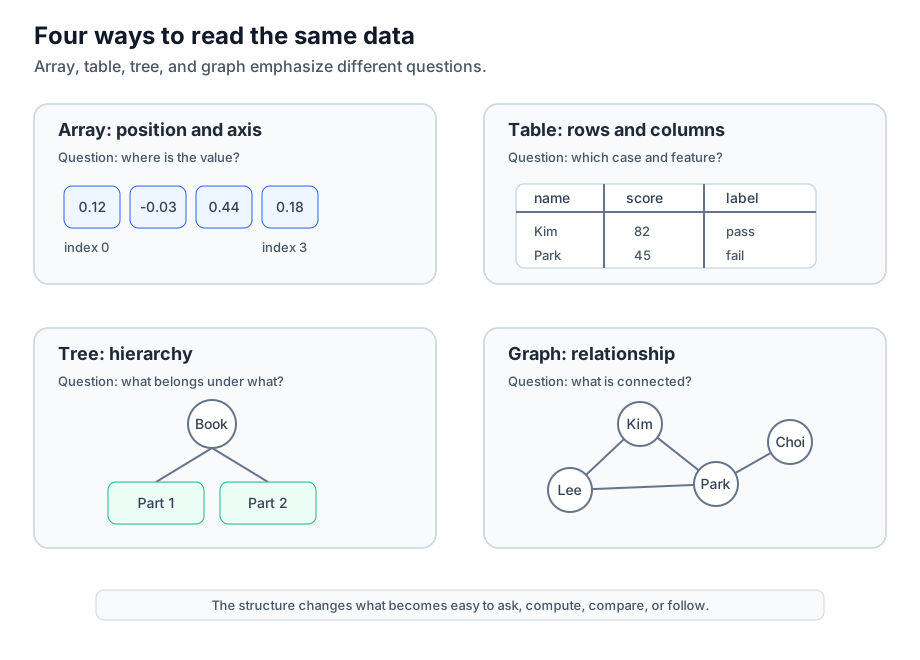
| 结构 | 核心问题 | 基本单位 | AI 示例 |
|---|---|---|---|
| 数组 | 值在哪个位置? | 索引、轴、值 | 向量、矩阵、图像像素、嵌入 |
| 表 | 哪一行、哪一列? | 行、列、单元格 | CSV 数据集、训练数据、评估结果 |
| 树 | 上下级如何组织? | 根、父节点、子节点 | 目录、文件夹、分类体系、决策流程 |
| 图 | 什么与什么连接? | 节点、边 | 链接、推荐关系、知识图谱、搜索 |
这些视角并非完全分离。表的一列可作为数组计算,树是图的一种特殊形式,图也能用 Python 字典和列表表示。
计算平均值、比较学生属性、查询归属与查找朋友,需要的信息各不相同。
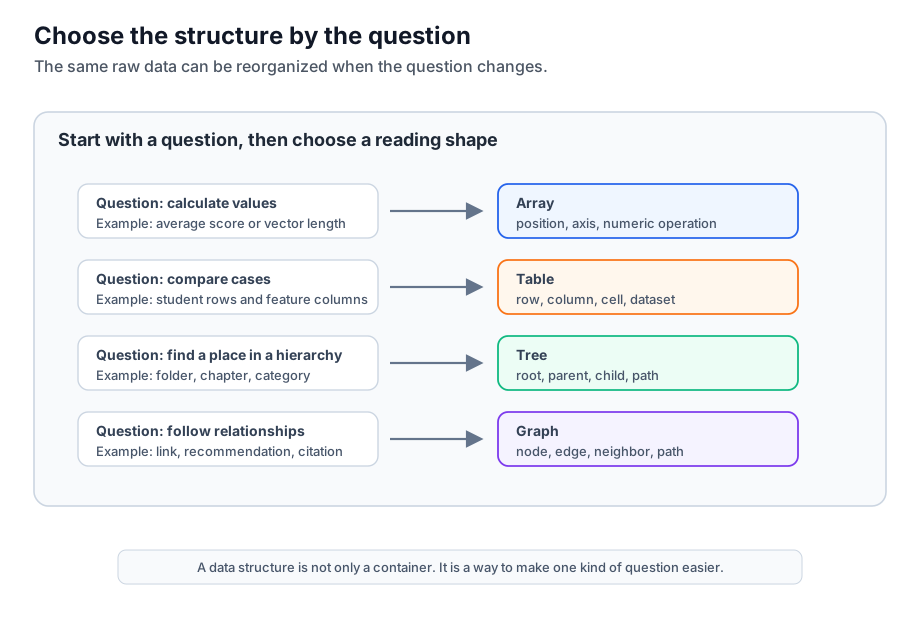
数组:位置与轴
数组按索引处理值。NumPy 将 ndarray 描述为保存相同类型和大小元素的多维容器。数值数组把数字放在规定的位置与轴上。
一维数值数组是一列按顺序排列的数字。
从 NumPy 数组 [0.12, -0.03, 0.44, 0.18] 读取索引 0 和 2,输出 0.12、0.44。
二维数组可视为有行和列的数值网格。
在这个 2 行 3 列数组中,第一行第三个值为 40,第二行第二个值为 30。索引从 0 开始,因此分别用 [0, 2]、[1, 1] 读取。
数组中位置和值同样重要。像素位置改变可能产生不同图像,嵌入向量也需要按规定顺序排列坐标才能计算。
以下 AI 任务经常需要数组视角:
- 将句子转为词元 ID 序列。
- 把词语、句子或图像表示为嵌入向量。
- 将多个样本组成矩阵。
- 按高度、宽度、通道轴处理图像。
NumPy 数组可对多个数字应用同一运算。
例如,求平均分时,从整张表中取出分数数组通常更简单。
分数 [82, 75, 45] 的总和是 202,共 3 项,平均约为 67.33。代码输出 67.33333333333333。
平均值不需要姓名或标签。调整分数顺序不改变平均值,但查找某名学生的分数仍需保留学生与数组位置的对应。
数组形状与按轴计算
2 行 3 列数组的 shape 为 (2, 3)。轴 0 沿行维度变化,轴 1 沿列维度变化;求平均时,沿指定轴合并数值。
输出依次为 (2, 3)、[5.0, 25.0, 45.0]、[20.0, 30.0]。axis=0 合并两行,得到三个列平均值;axis=1 合并每行的三个值,得到两个行平均值。应确认哪些值一起计算,而不是只记轴编号。
patch.reshape(3, 2) 保留六个元素,重新分成 3 行 2 列。它不理解像素位置或学生属性的含义。reshape(2, 2) 需要四个元素,因此引发 ValueError。形状是否合法与是否保留原含义,是两项独立检查。
表:行与列
表通过行与列表示数据。pandas 将 DataFrame 描述为二维、大小可变、可能包含不同类型的表格数据,行轴和列轴均具有标签。
表通常把一个案例放在一行,把一种属性放在一列。
| name | age | score | label |
|---|---|---|---|
| Kim | 21 | 82 | pass |
| Lee | 20 | 75 | pass |
| Park | 22 | 45 | fail |
小型表格可用 Python 列表和字典表示。
用字典表示每一行,再放入列表。代码输出 Kim 82、Lee 75、Park 45。
表中关键的是一行代表什么、一列代表什么。
以下 AI 任务经常需要表格视角:
- 将 CSV 文件读取为数据集。
- 区分输入特征与目标标签。
- 按模型或实验比较结果。
- 检查缺失值、异常值和数据类型。
表组织案例与属性。数值计算时可以转成数组,而供人检查和解释时,表格通常更易读。
选择通过的学生时,使用记录表通常比只看分数数组更自然。
继续使用前面的 students,收集标签为 "pass" 的姓名,输出 ['Kim', 'Lee']。
此处关注的是每个案例的多个属性,而不只是计算,因此行与列所保留的对应关系很重要。
树:父节点与子节点
有根树从根节点开始,沿父子关系向下展开。NIST 将树描述为从根节点访问、内部节点具有一个或多个子节点的结构。
在有根树中,根以外的每个节点都有一个父节点。
可以用 Python 字典和列表表示小型树。
在根 study-course 下放两个主题组,代码输出直接子节点标题 Foundations、Data Work。
树中重要的是层级与路径:某项归属在哪一项之下,以及从哪里开始、如何向下移动。
以下 AI 与服务任务会用到树的视角:
- 阅读文档目录与章节层级。
- 处理文件夹和路径。
- 创建分类体系或类别。
- 理解决策树。
- 阅读 JSON、HTML 等嵌套结构。
树按层级组织关系。并非所有关系都能用树表示,但上下级明确的数据很适合这种视角。
树回答某项下面有哪些内容,例如某个 Part 下有哪些 Chapter。
在前面的 course_tree 中找到 "Data Work" 并输出其子项,会得到 ['Tables', 'Graphs']。
这里关键的是从根到目标位置的路径,而非数值大小或表的列。
图:节点与连接
图表示对象之间的连接。NIST 将图描述为由边连接的项集合,每项称为顶点或节点。
节点代表对象,边代表连接。
Python 中的小型图可用邻接表表示。
用列表保存每个人的邻居。遍历 Kim 的邻居,输出 Kim is connected to Lee、Kim is connected to Park。
图强调连接而非顺序或层级:谁与谁相连,以及有哪些可走的路径。
以下 AI 与服务任务会用到图的视角:
- 沿文档链接移动。
- 在知识图谱中表达概念关系。
- 查看推荐系统中的用户与物品连接。
- 在搜索中连接文档、关键词与来源。
- 在 RAG 中表示片段与元数据的关系。
案例:转班前后的数据
从四种视角看同一份学生数据。
下图把分数表示为数组、记录表示为表、学校归属表示为层级、朋友关系表示为图。
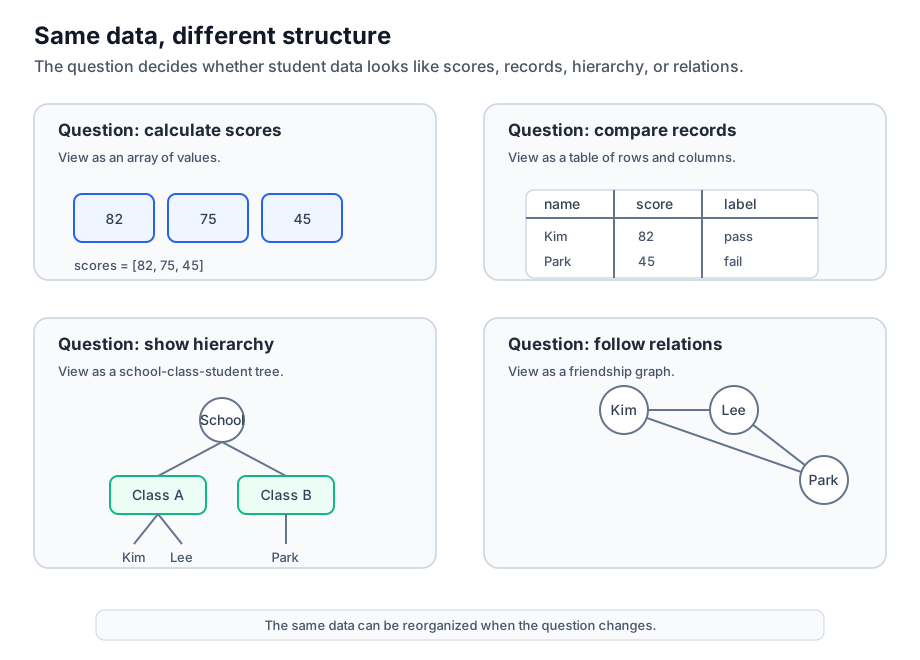
Kim、Lee 属于 A 班,Park 属于 B 班,分数依次为 82、75、45。Kim–Lee、Lee–Park 是朋友。代码从这些记录生成分数数组、通过姓名、班级归属和朋友关系。
names_by_class 表示学校下的班级及班级下的学生,friends 表示跨班连接。A 班 Lee 与 B 班 Park 是朋友,因此仅凭归属树无法知道朋友关系。
把 Park 的 "class" 改为 "A" 后重新运行,班级列表变为 {'A': ['Kim', 'Lee', 'Park']},平均值、通过姓名和朋友关系不变。若只把 Park 分数改为 60,平均变为 72.33,但已有 "label": "fail" 不会自动更新。若标签由分数决定,也应按规则更新标签。
检查清单
- 能从索引、轴和数值计算角度解释数组。
- 能从行、列和数据集角度解释表。
- 能从根、父子节点和层级角度解释树。
- 能从节点、边和关系角度解释图。
- 能说明同一数据如何因问题不同而采用不同结构。
- 能将词元、嵌入、数据集、文档结构和知识关系与这些视角联系起来。
- 能判断当前问题关注数组、记录、层级还是关系。
- 能根据 shape 和 axis 计算平均值合并的元素及结果形状。
来源与参考资料
- NumPy Developers, The N-dimensional array (
ndarray), NumPy Manual,确认日期:2026-07-20。用于确认ndarray的维度、shape、dtype、索引与切片说明,作为数组直觉的依据。 - pandas, pandas.DataFrame, pandas documentation,确认日期:2026-07-20。作为把 DataFrame 说明为具有行和列的二维结构的依据。
- Paul E. Black, tree, Dictionary of Algorithms and Data Structures, NIST,确认日期:2026-07-20。作为把 tree 说明为具有 root 与 parent-child relationships 的层级结构的依据。
- Paul E. Black, graph, Dictionary of Algorithms and Data Structures, NIST,确认日期:2026-07-20。作为把 graph 说明为用 nodes 与 edges 表达关系的结构的依据。
- NumPy Developers, numpy.mean, 核对日期:2026-09-15。确认按轴求平均值及其结果形状。
- NumPy Developers, numpy.reshape, 核对日期:2026-09-15。确认保持元素数量的形状变换条件。