P2-15.1 把公式转换为代码的小步骤
Section ID:
P2-15.1Version:v2026.09.15
符号与计算顺序
先区分公式中的符号代表单个输入值还是一组值,再区分逐个值进行的计算与汇总整组值的计算。
例如,要总结三个预测值的误差,首先要把同一样本的实际值和预测值配对。然后逐样本求差、平方,再对所有样本求和、取平均。在代码中展开公式压缩的顺序,有助于发现配对错误或遗漏的计算。
flowchart TD
  A["对应符号与输入值"]
  B["检查样本顺序与形状"]
  C["逐样本求差并平方"]
  D["求和并取平均"]
  E["检查中间值与图表"]

  A --> B --> C --> D --> E
均方误差
均方误差(mean squared error,MSE)是预测值与实际值之差的平方的平均值。
各符号代表以下量。
| 符号 | 含义 |
|---|---|
| \(n\) | 数据个数 |
| \(y_i\) | 第 i 个样本的实际值 |
| \(\hat{y}_i\) | 第 i 个样本的预测值 |
| \(y_i - \hat{y}_i\) | 第 i 个样本的误差 |
| \((y_i - \hat{y}_i)^2\) | 误差的平方 |
| \(\sum\) | 对所有样本求和 |
| \(\frac{1}{n}\) | 将总和除以样本数 |
这个公式可以读成:“计算每个样本的误差,平方,求和,再除以个数。”
这里每个样本各有一个实际值和预测值,所有样本权重相同。\(n\) 是样本对数,不是特征数,而且必须大于 0。公式中的第一个样本 \(i=1\) 对应 Python 的索引 0。y_hat 中的 hat 是把预测值上方的帽子符号 \(\hat y\) 写进变量名。
用循环计算
将实际值 [3.0, 5.0, 7.0] 与预测值 [2.5, 5.5, 8.0] 按相同位置配对。误差为 [0.5, -0.5, -1.0],平方误差为 [0.25, 0.25, 1.0],总和 1.5 除以 3,MSE 为 0.5。
代码直接对应公式的各个部分。
| 公式部分 | 代码部分 |
|---|---|
| \(y_i\)、\(\hat{y}_i\) | y、y_hat |
| \(y_i - \hat{y}_i\) | error = y - y_hat |
| \((y_i - \hat{y}_i)^2\) | error ** 2 |
| \(\sum\) | sum(squared_errors) |
| \(\frac{1}{n}\) | / len(squared_errors) |
两个列表必须非空、长度相同,并保持相同样本顺序。zip 默认只配对到较短列表结束,长度不同时可能遗漏部分值。
上面的 if 遇到长度不匹配或空列表就停止计算。删除预测列表中的 8.0,会产生 ValueError。没有检查时,仅前两对就会得到 MSE 0.25,让数据遗漏看起来像性能改善。本练习假设输入是有限实数列表。
用 NumPy 数组计算
对相同输入使用 NumPy 求差、平方、取平均,也会得到 0.5。
两个数组都是 (3,),因此相同位置的值相减。向量化将同一操作应用于整个数组。
ndim 是轴数,shape 是各轴长度,size 是全部元素数。np.isfinite 检查每个值是否既非 NaN 也非无穷大,.all() 检查所有元素是否满足条件。这些检查无法判断样本对应顺序,仍需由构造输入的人确认。
误差与平方误差
MSE 最终成为一个数。执行前面的 NumPy 代码块后,在同一会话中输出中间值。
输出如下。
误差具有方向:预测过低或过高会改变符号。平方误差不会为负,因此 MSE 可以避免正负抵消,汇总误差大小。
但 MSE 具体是平方误差的平均值。实际值以分数为单位时,MSE 的单位是分数²。对 MSE 开平方得到 RMSE,回到原始单位;本例为 \(\sqrt{0.5}\approx0.707\)。误差变为两倍,平方误差就变为四倍,因此大误差的影响更大。
np.mean(errors ** 2) 与 np.mean(errors) ** 2 也不同。前者为 0.5,后者约为 0.111。后者先让正负误差抵消再平方,不是 MSE。
逐样本比较差异
在相同样本位置比较实际值与预测值的垂直间距。前两个间距为 0.5,最后一个为 1.0。只画点和逐样本的垂直线段,避免暗示样本之间存在连续变化。以下代码使用前面 NumPy 代码块中的 actual、predicted 和 np。
图片显示每个样本的实际值与预测值之间的距离。
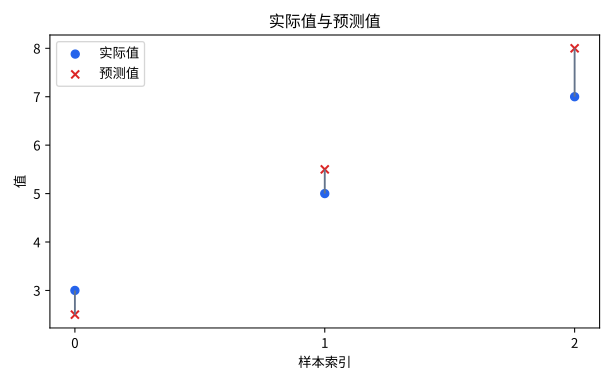
基准源文件可以一起运行循环计算、NumPy 计算与图片保存。发布图片将代码中的英文标签本地化,但点的位置与计算值保持相同。
在已安装 NumPy 和 Matplotlib 的 Python 环境中,从仓库根目录执行。使用与发布图片相同的字体需要安装 Noto Sans CJK JP,也可通过 --font-family 指定其他字体。
脚本输出 loop mse、errors、squared errors 和 numpy mse,并将三种语言的 SVG 保存到指定文件夹。默认的最后一个预测值为 8.0。添加 --last-prediction 7 或 --last-prediction 9,即可复现下面案例中的数值和点位变化。
图表并不替你计算 MSE,而是让你看到差异被压缩为一个数之前的样子。
案例 1. 只修改最后一个预测值
把最后一个预测值从 8.0 改为实际值 7.0,平方误差变为 [0.25, 0.25, 0.0]。MSE 降至 0.5 / 3,约为 0.167,最后两个点重合。
若改成 9.0,最后一个误差是 −2,平方误差是 4。MSE 为 (0.25 + 0.25 + 4) / 3 = 1.5。该样本的误差大小从 1 加倍到 2 时,平方误差从 1 变为 4。
分别修改循环与 NumPy 代码的输入,应该得到相同结果。否则要检查输入顺序、长度、形状和取平均的轴。尤其把一个 (3,) 数组改成 (3, 1) 时,广播可能计算所有组合,而不是原来同样本配对的 MSE。
能运行却计算了另一件事
不使用输入检查,计算 actual.reshape(3, 1) - predicted 会得到 (3, 3)。每个实际值都与三个预测值比较,产生九个差值。第一行为 [0.5, -2.5, -5.0],混入了其他样本的预测值。
| 计算 | 取平均的对象 | 结果 |
|---|---|---|
| 三个同位置样本对 | 3 个平方误差 | 0.5 |
(3, 1) 减去 (3,) | 所有组合的 9 个平方误差 | 约 7.833 |
| 只反转预测值顺序 | 错误配对的 3 个平方误差 | 约 15.167 |
形状检查可以阻止第二种错误,但第三种形状仍相同,无法靠它发现。还要检查学生 ID 等样本标识。不指定轴时,np.mean 会对全部元素取平均,连错误扩展的数组也会压缩为一个数。
先预测实际值和预测值都加 10 时 MSE 是否改变,再运行确认。差值不变,因此 MSE 仍为 0.5。两个数组都乘以 10 时,差值变为 10 倍,平方误差变为 100 倍,MSE 为 50。解释数值大小需要保持单位、样本和计算规则一致。
检查清单
- 能在写代码前区分符号、数据形状和计算步骤吗?
- 能说明 MSE 公式中的 \(y_i\)、\(\hat{y}_i\)、\(n\)、\(\sum\) 吗?
- 能把求和转换为循环或数组计算吗?
- 能用 Python 循环和 NumPy 数组分别表达同一计算吗?
- 能解释实际值与预测值为何需要相同顺序、长度和形状吗?
- 能区分
errors、squared_errors和mse吗? - 能说明为什么检查中间值有助于验证计算吗?
- 能解释图表如何辅助理解,而不替代计算吗?
- 能区分平方的平均与平均的平方,以及 MSE 与 RMSE 的单位吗?
- 能解释形状相同但样本顺序错误为何会改变结果吗?
来源与参考资料
- Python Software Foundation, Built-in Functions: zip 确认日期: 2026-09-15. 配对与默认在较短输入处停止的行为。
- NumPy Developers, numpy.mean 确认日期: 2026-09-15. 未指定轴时对全部元素取平均。
- NumPy Developers, Broadcasting 确认日期: 2026-09-15. 不同形状数组之间的运算规则。
- scikit-learn developers, Regression metrics 确认日期: 2026-09-15. MSE、RMSE、MAE 的定义与解释。
- Matplotlib Developers, Axes.scatter 确认日期: 2026-09-15. 显示逐样本的实际值与预测值。