P3-1.1 数据建模想要达成什么
Section ID:
P3-1.1Version:v2026.09.19
一进入 Part 3,读者很快就会遇到 样本、特征、基准线、输出结构、目标 这些词。它们并不是彼此分开的。真正把 什么算一条记录、哪些值要保留、拿什么去比较、最终要用什么结果格式收口 一起决定下来的外层判断,就是 数据建模。
如果只把数据建模理解为整理存储结构,就容易认为它只是把已有表格整理得更美观。本书 Part 3 在更宽的意义上使用这个词,指按照问题设计样本和表示。这是本书选定的讨论范围,并不是取代数据库领域数据建模定义的标准定义。这里要决定的是:让现有的源数据能够回答哪些问题。
最常见的早期混淆,是把 数据库该怎么存 和 AI 该怎么读这个问题结构 当成同一件事。它们确实有关,但目标不同。
| 比较点 | 先看存储结构的视角 | Part 3 的数据建模视角 |
|---|---|---|
| 最先问的问题 | 如何无遗漏地存下记录,并且之后还能找回? | 应该怎样构造样本和比较结构,才能回答一个问题? |
| 代表单位 | 一条日志、一条事件、一条传感器测量 | 一次动作、一个近期区段、一个实体作为分析样本 |
| 主要关心点 | 是否无遗漏、关联正确、可以追踪 | 能比较什么,还要保留哪些特征 |
| 直接产出 | 原始日志表、事件表、可 join 的存储结构 | 摘要表、特征表、基准线比较表、复核输出结构 |
| 这一 Part 里的问题 | 也许仍然是起点,但不是终点 | Part 3 全程都在处理的中心问题 |
如果说存储结构是 为了不丢记录的框架,那么数据建模更接近 为了回答问题而构造比较结构的框架。需要检查已存资料是否具备当前问题所需的样本单位和信息,并在必要时改变表示。原始记录也是数据集,并非每项分析都需要新的摘要表。
假设这里有一份自动执行动作的记录。源数据里可能有逐时刻的传感器值、控制参数、动作开始与结束时间。这个结构也许已经足够用于存储和追踪。但仅凭这种状态,还是很难立刻回答 这次动作和以往相比是否不同、近期区段的重复性是否在晃动、人应该先看什么 之类的问题。
这里数据建模真正想达成的目标其实很简单:明确问题与记录的联系,让人能够比较,也让模型能够使用。在本节的动作比较案例中,需要作出以下四项决定。
- 决定什么算一条样本。
- 构造描述这条样本的特征。
- 建立近期状态要拿来对比的基准线。
- 决定输出结构,比如结果是给人复核,还是作为预测目标候选。
这四项是本例的设计问题,不是每个数据集都必须具备的四类列。原始时间序列、图像或文档也可以作为输入,有些问题也不与历史基准线比较。
在这里,也需要一起固定数据建模与数据科学的关系。数据科学是一个更大的流程,里面包含数据收集、清洗、探索、汇总、比较、解释、预测,以及和决策的连接。Part 3 聚焦的数据建模,则更接近其中 把源数据改造成适合 AI 学习和分析的问题结构 这一前段判断。换句话说,Part 3 不是在教授整个数据科学,而是通过问题、表示与解释的联系,学习理解 AI 所需的数据处理。
把数据建模实际上要产出的东西并排摆出来,会更清楚。
| 想要达成的结果 | 为什么需要它 | 后面会连到的问题 |
|---|---|---|
| 样本单位 | 因为必须先决定什么算一条记录 | 一行到底表示什么? |
| 特征表 | 因为必须构造可用于比较和学习的描述值 | 哪些值应该留下? |
| 基准线比较结构 | 因为近期状态必须放在平常状态旁边读 | 应该拿什么来比较? |
| 输出结构 | 因为不能把人工复核和预测目标混在一起 | 最终结果该用什么形式输出? |
这张表里最重要的一点是:数据建模还不是 模型选择 阶段。在这一阶段,比起分类器名字或深度学习结构,更早要决定的是要构造什么表、让什么比较成为可能。只有这样,后面机器学习部分里的 X、y、评估、基准模型才不会悬在半空。
下图表示本节动作比较案例所选择的流程,并非适用于所有数据的必经步骤。
flowchart TD
  A["原始时序日志"] --> B["选择一个样本单位"]
  B --> C["汇总成特征"]
  C --> D["与基线比较"]
  D --> E["决定输出结构"]
  E --> F["复核候选或可用于预测的表"]
同一次动作的水平、离散程度和方向是不同的问题
以下是用于说明的虚构记录。action_id 是动作标识,t_sec 是动作开始后经过的秒数,flow_rate 是流量(L/min),pressure 是压力(kPa)。valve_open 为 1 表示阀门打开。假设每次动作在 0、1、2 秒各测量一次。
| action_id | t_sec | flow_rate | pressure | valve_open |
|---|---|---|---|---|
| A-101 | 0.0 | 24.8 | 101.2 | 1 |
| A-101 | 1.0 | 25.1 | 101.0 | 1 |
| A-101 | 2.0 | 23.9 | 102.4 | 1 |
| A-102 | 0.0 | 24.7 | 100.9 | 1 |
| A-102 | 1.0 | 24.8 | 101.1 | 1 |
| A-102 | 2.0 | 24.8 | 101.0 | 1 |
A-101 的流量先略微上升,最后下降。A-102 的三个值很接近,最后两个值相同。为了比较这个差异,我们把一次动作合为一个样本。这里的六行是两次动作的测量记录,不是六次动作。
要用数字说明动作有何不同,首先需要拆开问题。整体流量水平是否不同、测量值是否分散、末尾是否下降,是不同的问题。要保留的数字也随问题而变。
均值:测量值的整体水平是多少
均值是把所有值相加后除以值的个数。本例把每次动作的三个流量值的均值保存在 flow_mean 列中。
- A-101:
(24.8 + 25.1 + 23.9) / 3 = 24.60 L/min - A-102:
(24.7 + 24.8 + 24.8) / 3 ≈ 24.77 L/min
A-101 的平均流量略低。但是,仅凭均值无法知道在哪个时刻下降。例如,23, 24, 25 和 25, 24, 23 的均值都是 24,但一个上升,另一个下降。把水平汇总成均值会丢失时间顺序。
下图对两次动作使用相同的坐标轴。圆点表示观测值,虚线表示均值,粗线表示最后观测区间。连线用于帮助阅读测量顺序,并不证明两次观测之间的实际变化轨迹。
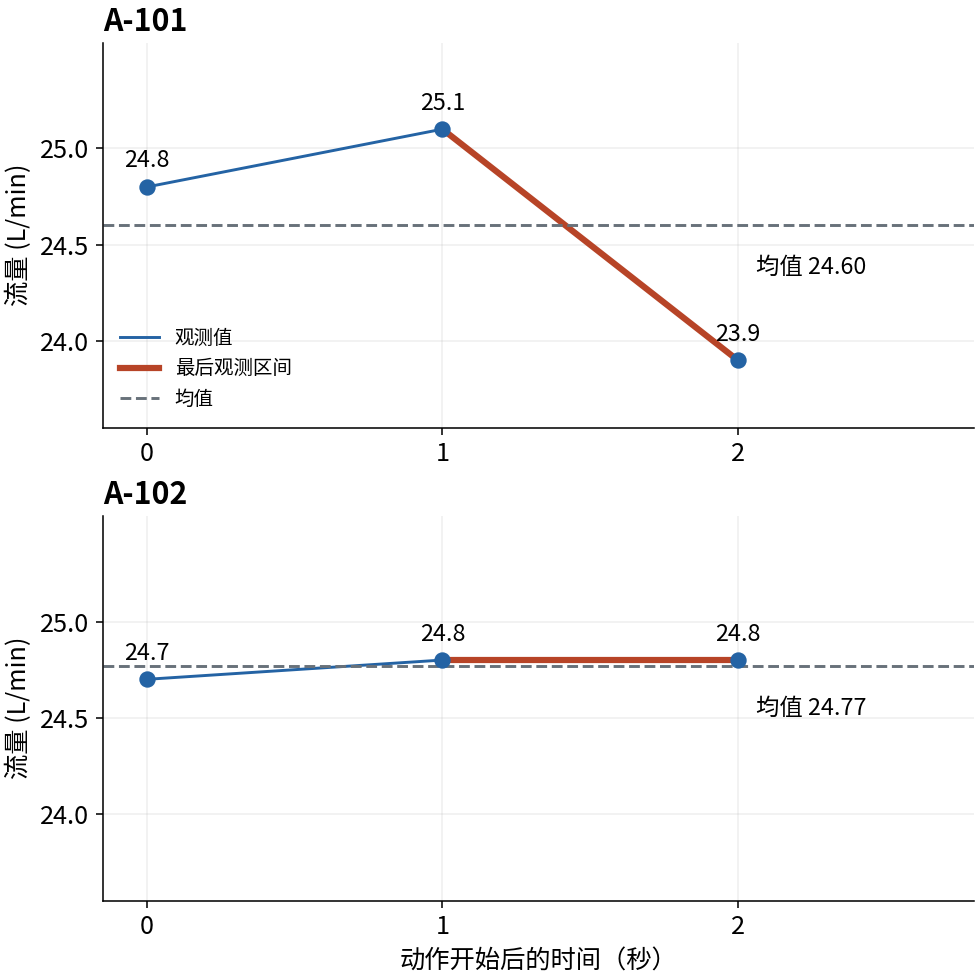
A-101 在均值周围分布得更开,并在最后区间下降。A-102 则靠近均值。只有水平的均值线无法传达这些形状。下面将区分离散程度与变化方向。
压力也按同样方法求均值,保存在 pressure_mean 中。A-101 为 (101.2 + 101.0 + 102.4) / 3 ≈ 101.53 kPa,A-102 为 101.00 kPa。该值用于在流量变化时同时比较压力的整体水平,本身不是故障判定。
标准差:数值在均值周围有多分散
标准差表示数值在均值周围的离散程度。三个值完全相同时为 0;数值在均值周围分布得越开,标准差越大。它不表示数值随时间上升还是下降。
本例的 flow_std 使用样本标准差公式。先计算 A-101 的各个值与均值 24.6 的差。
- 差值为
24.8−24.6 = 0.2、25.1−24.6 = 0.5、23.9−24.6 = −0.7。 - 直接相加会使正负差值抵消,因此分别平方。平方和为
0.2² + 0.5² + (−0.7)² = 0.78。 - 样本标准差把这个和除以
值的个数−1。这里是0.78 / (3−1) = 0.39。 - 再开平方根,得到
√0.39 ≈ 0.62 L/min。标准差的单位与原始流量相同。
这是用样本估计更大总体的离散程度时采用的计算规则,因此分母是 2 而不是 3。这里按该规则汇总三个测量值,并不凭两次动作推断整台设备的状态。对 A-102 使用未四舍五入的均值进行相同计算,结果约为 0.06 L/min。因此,在这组记录中,A-101 的流量值在均值周围分布得更开。
前面的 23, 24, 25 与 25, 24, 23 的样本标准差也相同,都是 1。只改变顺序不会改变各值与均值的距离。因此,标准差大与末尾下降陡峭是两回事。
最后区间的斜率:朝哪个方向、以多快的速度变化
要观察末尾下降,可以使用数值变化量除以经过时间得到的斜率。本例把最后区间定为第 1 秒到第 2 秒,并将其斜率保存在 late_drop_rate 中。虽然列名含有 drop,仍保留正负号,因此上升时也会得到正值。
- A-101:
(23.9−25.1) / (2−1) = −1.2 L/min/s - A-102:
(24.8−24.8) / (2−1) = 0.0 L/min/s
L/min/s 表示以 L/min 为单位的流量每秒变化多少。负数表示下降,正数表示上升,0 表示两个时刻的值相同。在相同时间间隔内,−1.2 比 −0.2 下降得更陡。但这并不说明两个测量点之间始终以恒定速度变化。
基准线差值:与平时相同区间相比有多大差异
仅仅观察到下降,还不能知道是否偏离平时状态。在这个虚构案例中,假设在相同条件下另外确定的平时最后区间斜率为 0.0 L/min/s。这就是比较基准线,并非从上面的六行记录估计得到。
baseline_gap 按 当前动作斜率−基准线斜率 计算。A-101 为 −1.2−0.0 = −1.2 L/min/s,A-102 为 0.0−0.0 = 0.0 L/min/s。负差值表示当前斜率小于基准线。若基准线本身为 −1.0,A-101 的差值就是 −0.2。因此,当前斜率与基准线差值是不同的概念。
接着定义一条用于说明的人工复核规则:若 baseline_gap < −0.5 L/min/s,标记 review,否则标记 no_flag。恰好为 −0.5 时属于 no_flag。该阈值是把指标连接到复核行为的假定规则,不是经过实际设备验证的故障标准。
把为不同问题选择的值合成一行动作摘要
把计算结果合起来,就得到下表。均值与标准差显示到小数点后两位,计算过程中使用未四舍五入的值。
| action_id | flow_mean (L/min) | flow_std (L/min) | pressure_mean (kPa) | late_drop_rate (L/min/s) | baseline_gap (L/min/s) | review_flag |
|---|---|---|---|---|---|---|
| A-101 | 24.60 | 0.62 | 101.53 | -1.2 | -1.2 | review |
| A-102 | 24.77 | 0.06 | 101.00 | 0.0 | 0.0 | no_flag |
现在可以这样阅读 A-101:测得的平均流量为 24.60 L/min,三个流量值的标准差为 0.62 L/min。最后 1 秒的斜率为 −1.2 L/min/s,比假定基准线低 1.2 L/min/s。这个差值触发了示例复核规则,因此标记为 review。
review_flag 既不是测量值,也不是已确认的故障标签,而是应用规则后的复核结果。no_flag 也只表示没有触发该规则,不表示确认正常。仅凭较大的标准差或负斜率不能确诊故障。
本例中的数据建模把原始记录与问题连接起来:用 action_id 汇集一次动作,保留与问题有关的摘要值,与另外确定的基准线比较,再附上供人阅读的复核结果。原始记录仍然保留,供重新检查详细顺序。
flowchart TD
  A["时间步日志"] --> B["人工逐行查看"]
  B --> C["难以比较完整动作"]
  A --> D["把一个动作建模成一个样本"]
  D --> E["构造特征与基线差值"]
  E --> F["输出复核标记或可预测输出"]
数据建模做得好不好,并不是看有没有用上华丽的模型。更关键的是,看下面这些问题能不能回答。
- 现在这张表里的一行到底表示什么?
- 为什么要保留这个值?
- 它应该拿什么来比较?
- 这个结果是自动结论,还是只是给人复核的候选?
每一列都应能追溯到原始记录或计算规则,让别人也能重建同一张表。如果探索中发现信息缺失,或需要另一种比较,就可以重新确定样本和表示。
检查清单
- 你能否解释 A-101 的均值、标准差和斜率各自回答什么问题,又不能回答什么问题?
- 把 A-101 最后一个流量值从 23.9 改成 25.1,重新计算均值、标准差、最后区间斜率和复核结果。哪些值改变了?
- 若只把基准线斜率改为 −1.0 L/min/s,原始 A-101 的
baseline_gap与review_flag会怎样变化? - 能否区分
review与故障确认,以及no_flag与正常确认? - 能否区分数据库存储结构设计与本例的分析输入设计,并说明为什么摘要表不是所有数据集的必需形式?
核对修改后的计算:A-101 的最后流量变为 25.1 时,均值为 25.00 L/min,样本标准差约为 0.17 L/min,最后区间斜率为 0.0 L/min/s。在原基准线 0.0 下,结果为 no_flag。保留原始流量而只把基准线改为 −1.0,差值为 −0.2 L/min/s,结果同样为 no_flag。两种情况都不表示已经确认没有故障。
来源与参考资料
- W3C,
PROV-Overview. provenance framework 说明它应当支持 object identification 和 derivation representation,因此它为这种一般判断提供依据:什么算一条对象、摘要表和比较结构是通过什么过程做出来的,都应该保留可解释性。 https://www.w3.org/TR/prov-overview/ / 确认日期: 2026-07-20 - Google for Developers,
Machine Learning Glossary,example,labeled example. example 可以没有标签;labeled example 同时包含特征与标签。 用于区分样本、输入与结果的作用。 Machine Learning Glossary / 确认日期: 2026-09-15 - U.S. Bureau of Labor Statistics,
Base period. 它提供“拿某个时点或区段作为参考”的一般概念,因此支持这种说明:数据建模必须先建立一个基准线,用来比较近期状态。 https://www.bls.gov/bls/glossary.htm / 确认日期: 2026-07-20 -
Usama M. Fayyad, Gregory Piatetsky-Shapiro, Padhraic Smyth,
From Data Mining to Knowledge Discovery in Databases. 它说明了包含数据收集、选择、预处理、转换与解释在内的更大知识发现流程,因此为这个边界提供背景:Part 3 并不是覆盖全部数据科学,而是聚焦在其中的问题结构设计和表达转换。 https://www.kdnuggets.com/gpspubs/aimag-kdd-overview-1996-Fayyad.pdf / 确认日期: 2026-07-20 -
NIST/SEMATECH, e-Handbook of Statistical Methods,
Measures of Location,Measures of Scale。用于确认均值和样本标准差的定义、计算与单位。动作记录和复核阈值是本书的虚构案例,并非这些资料验证过的设备标准。 Measures of Location / Measures of Scale / 确认日期: 2026-09-19