P3-2.1 为什么要按照分析目的重新组织存储记录
Section ID:
P3-2.1Version:v2026.09.19
在数据库中,数据建模用于表示需要存储的对象及其关系。本 Part 侧重于确定用存储记录回答什么问题,并据此组织样本和列。存储目的与分析目的不同时,同一批记录也需要按不同方式分组。
数据集是汇集起来的一组数据。原始日志、图像集合和无标签记录都可以是数据集。但拥有数据集,并不意味着它已经可以直接用于某个特定分析或学习任务。本节的候选数据集指仍在按照当前问题检查样本单位和列结构的资料。
存储表的一行可以与分析样本相同,也可以不同。如果要预测下一个测量值,可以从逐时点的行出发;如果要比较完整动作,就需要把多行合成一次动作。
假设这里有自动执行动作的源数据。按时间累积的控制参数和传感器值,可以直接放进存储表里。每一行可以放一个时间点、一个传感器名、一个测量值和一个控制设定值。这样的结构适合保存记录,也适合在出问题时回头追踪细节流程。
但直接看这张表,还很难回答这次动作是否比平时更长、后段下降是否特别慢、最近 20 次动作与基准线相比是否变化等问题。因为存储结构中的一行通常表示一个时点的记录,而这些问题要求的比较单位是一次动作,或由多次动作组成的近期区间。因此,有了存储记录,并不等于已经准备好了动作级比较所需的表。
要把这种差别看清楚,可以把存储结构和问题表达结构并排放在一起。
| 区分 | 一行表示什么 | 主要目的 |
|---|---|---|
| 存储结构 | 一个时间点的记录、一次传感器测量、一次控制设定 | 保存源数据和保留可追踪性 |
| 问题表达结构 | 一次动作的摘要、近期区段比较、基准线聚合 | 用于比较、解释和学习准备 |
把这个区分放进真实的表里,可以先用下面三个问题来检查“行”的含义和可比较性。
| 第一次拿到表时先问的问题 | 为什么这个问题必要 |
|---|---|
| 一行表示一个时间点记录,还是一次动作的摘要? | 因为如果行的含义不同,后面的样本单位也会跟着不同 |
| 现在这张表能不能直接拿来比较? | 因为存储结构可能擅长保存记录,却不擅长比较 |
| 如果出现奇怪的值,要回到哪里去看? | 因为单靠问题表达结构,并不能解释所有细节原因 |
这三个问题可以帮助我们快速判断:手头的数据集能否直接用于当前问题,还是需要重新组织。第一个问题问行的含义,第二个问可比性,第三个问什么时候需要重新打开原始日志。数据建模就是把存储记录重新表示成能够回答这三个问题的形式。
在存储结构里,重要的是尽可能完整地保留下来。反过来,在问题表达结构里,则必须判断 什么要留下、什么可以舍弃。例如,一旦决定把一次完整动作看成一条样本,就可以在保留原始记录的同时,另行生成观测时间跨度、平均流量和最后观测区间斜率等摘要列。这不是在破坏存储结构,而是在为了回答别的问题,重新设计一种表达方式。
下面这个小表,会立刻看出同一份源数据会因为目的不同而被读成不同结构。
| 结构 | 示例列 | 一行表示什么 |
|---|---|---|
| 存储结构 | timestamp, sensor_name, value | 一个时间点记录 |
| 问题表达结构 | event_id, mean_flow, last_interval_slope | 一次动作的摘要 |
从保存记录到按问题重组
如下图区分保存记录与按照问题重新分组,就更容易理解为什么存储记录可能还需要按问题重新组织。
flowchart TD
    A[已存储的时点记录] --> B{是否符合问题所需的样本单位?}
    B -->|是| C[保留当前行单位]
    B -->|否| D[按问题重新分组]
    C --> E[确认所需列与比较条件]
    D --> E
    E --> F[检查数据集候选是否符合当前目的]
从一行摘要追溯原始记录
下面是虚构记录 A、B、C,与前一章的 A-101 不同。event_id 是动作标识,second 是动作开始后经过的秒数,flow 是流量(L/min)。先看 A 的三条记录。
| event_id | second | flow (L/min) |
|---|---|---|
| A | 0 | 0.8 |
| A | 1 | 1.4 |
| A | 2 | 1.2 |
把 A 汇总成一行,记录数为 3,观测时间跨度为 2−0 = 2 秒,平均流量为 (0.8+1.4+1.2)/3 ≈ 1.13 L/min。最后观测区间的斜率为 (1.2−1.4)/(2−1) = −0.2 L/min/s。均值与斜率的计算含义与 P3-1.1 相同。
| 摘要行保留的内容 | 仅凭摘要无法还原的内容 | 需要重新查看的依据 |
|---|---|---|
| 标识 A、点数 3、观测跨度 2 秒 | 每个时刻的全部测量值 | 原始表中 event_id=A 的各行 |
| 均值 1.13 L/min、最后斜率 −0.2 L/min/s | 包括第 1 秒上升到 1.4 在内的完整变化顺序 | 按时间排列的 A 的时刻与流量记录 |
| 已存点数是否通过条件 | 是否观察到实际结束,中间是否缺少记录 | 动作结束记录,以及测量间隔和缺失检查 |
保留标识,就能从摘要回到原始记录。如果动作 ID 在不同设备中重复,还需要同时使用设备 ID。本例假设 A、B、C 分别唯一标识不同动作。
改变点数条件,观察候选集合的变化
问题情境:A、B 各有 3 个观测点,C 有 2 个。应用同一段聚合代码后,把点数条件从 3 改为 2,查看哪些动作通过条件。
输入:按 event_id 组织的时点记录,以及最少观测点数 min_points_per_event。
期望输出:原始表、动作摘要表和通过点数条件的行。通过条件不等于动作完整,也不等于这些动作最终可以互相比较。
要确认的概念:有可计算的数值、通过点数条件、观察到完整动作,是三件不同的事。两个点就能计算最后观测区间的斜率。默认值 3 是本实验的候选筛选条件,并非所有指标在数学上都至少需要三个点。
这份输入没有缺失值或重复时刻,观测间隔均为 1 秒。下面的斜率计算以固定间隔为前提。如果修改时刻,计算也必须改为除以实际时间差。observed_span_seconds 是最后与最早已存时刻之差,应与确认结束后的实际动作时长区分。
期望输出:
第一张表的一行是一个时点记录,第二张表的一行是与一个动作标识关联的摘要。passes_point_count 为 True 只表示通过了点数条件。默认值为 3 时,只有 A、B 通过;降为 2 后,C 也通过。但 C 的斜率 +0.1 对应 0~1 秒,A、B 的斜率对应 1~2 秒。同名列指向不同区间,不能仅凭这些值比较动作末尾的差异。
下图用相同坐标轴对齐三次动作。圆点表示观测值,粗线表示各自的最后观测区间。连线表示测量顺序,并不证明观测之间的实际变化轨迹。
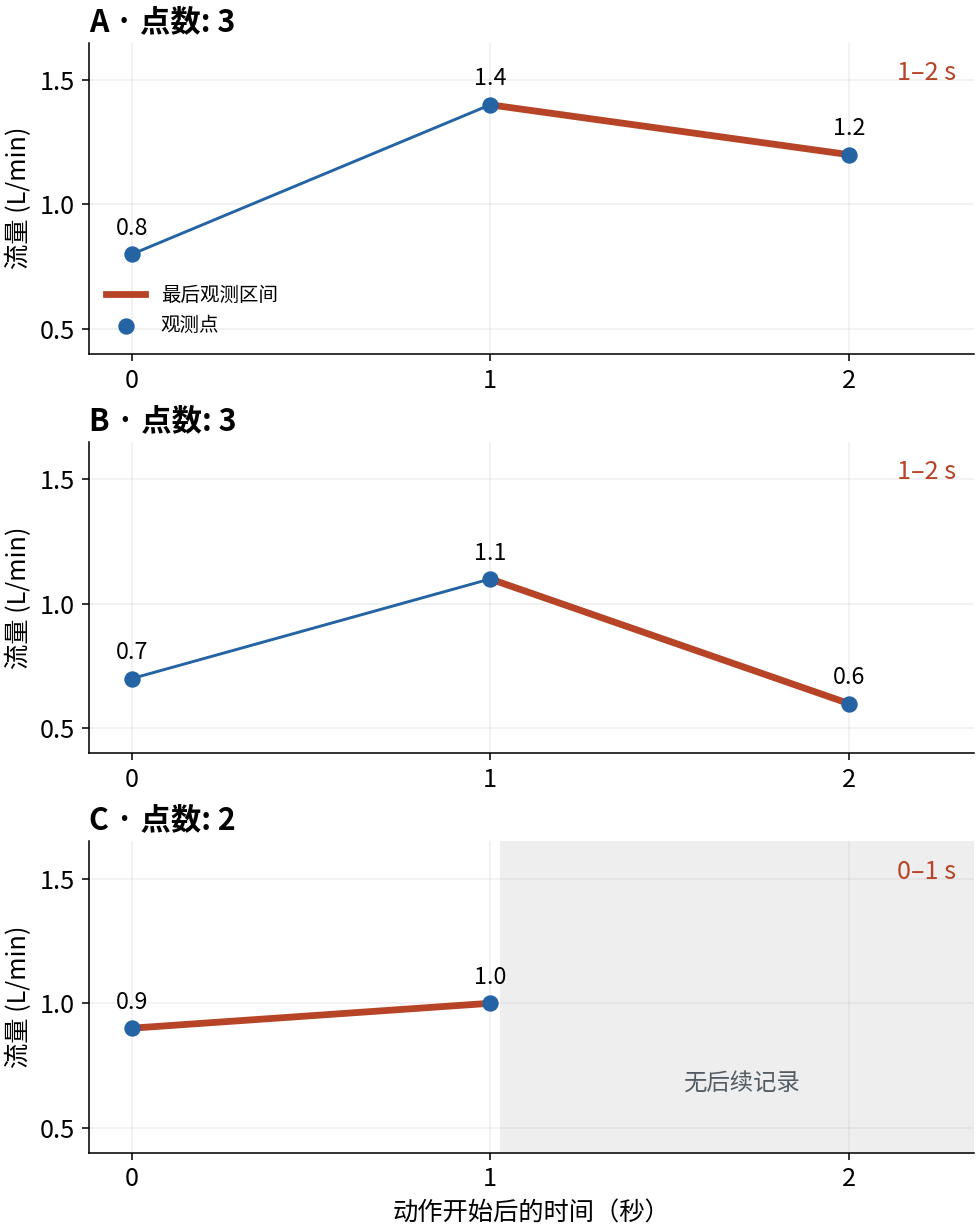
C 在第 1 秒之后的灰色区域表示没有后续记录,不表示流量为零,也不表示动作已经结束。因此,没有把线延伸到该区域。
特别是,不能因为 C 的 observed_span_seconds=1 就认定动作在 1 秒时结束。它可能确实在那时结束,也可能仍在继续,只是后续记录缺失。A、B 也不能仅凭三个点就确认已观察到结束。这份输入没有结束确认信息。
还需要区分点数与测量间隔。如果只把 A 的时刻改为 0、1、4 秒,点数仍是 3,平均流量也不变。但观测跨度变为 4 秒,最后斜率是 (1.2−1.4)/(4−1) ≈ −0.067 L/min/s。仍使用假定 1 秒间隔的代码会得到 −0.2,导致错误解释。这个对比说明:点数足够不能代替时间轴检查。
下面两个面板的坐标范围和流量值相同,只把最后一次观测的时刻从 2 秒改为 4 秒。
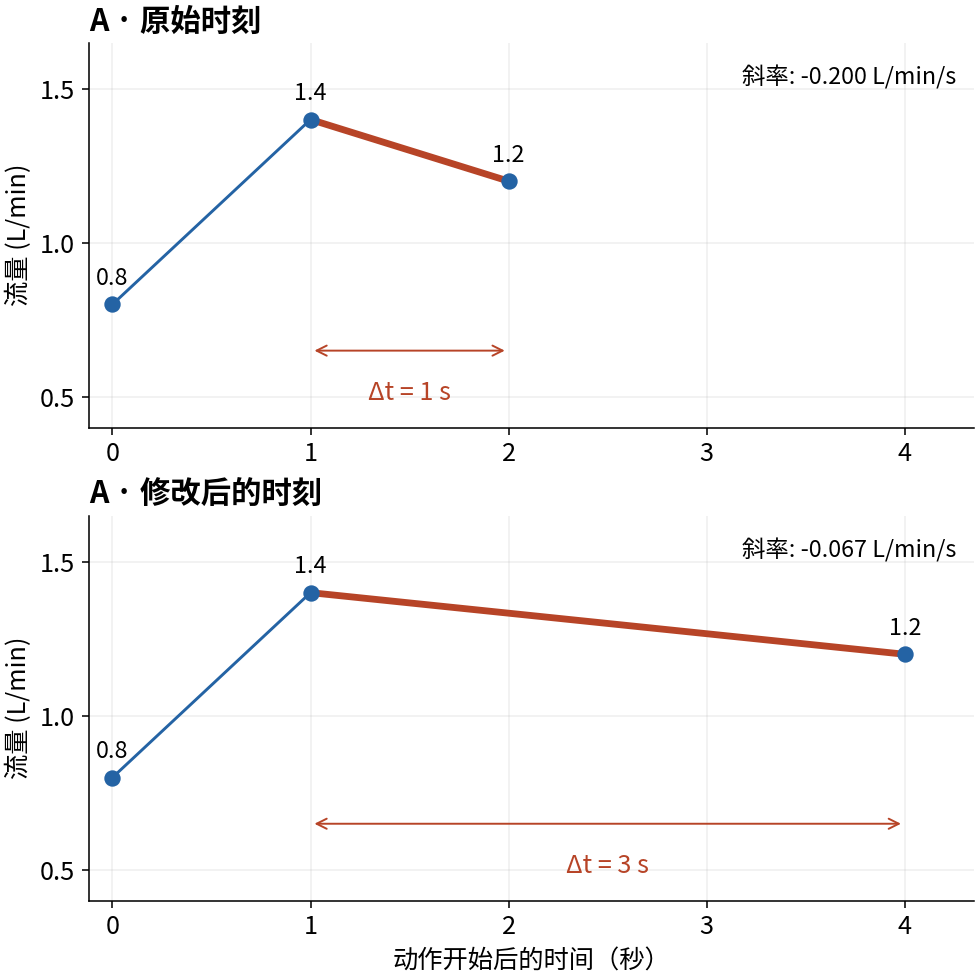
两个面板的流量差都是 −0.2 L/min,但上图经过 1 秒,下图经过 3 秒。斜率变缓是因为时间分母改变,而不是点数或流量差改变。连接线段也不证明整个区间内始终匀速变化。
如果把同一份数据继续保持成存储结构不改,也可以很短地看出实际会卡在哪里。
| 我们马上想问的问题 | 直接使用存储结构时会出现的问题 |
|---|---|
| 这一次完整动作是不是比平时更长? | 仅凭时点记录无法确认实际结束,还需要开始与结束记录 |
| 能不能只挑出后段下降较慢的动作? | 如果不先把后段区间聚合成摘要,就没有比较列 |
| 能不能直接比较最近 20 次和此前 200 次? | 即使有动作标识,也需要另行确定近期与历史分组的时间范围和条件 |
所以,存储结构擅长展示 记录了什么,却不会自动决定 什么该按一条案例来比较。所谓重新构造数据集候选,填补的正是这个空白。
这里有一点必须注意。问题表达结构并不会取代存储结构。做出了摘要表,并不意味着原始日志就不再需要。恰恰相反,一旦摘要表里出现奇怪变化,我们还得回到存储结构,重新检查细节时间点。存储结构负责保存证据,问题表达结构负责让比较成为可能。它们不是竞争关系,而是角色不同的连接结构。
把这种关系再压缩一点,可以写成下面这样。
| 问题 | 存储结构在这里强吗? | 问题表达结构在这里强吗? |
|---|---|---|
| 实际记录下来的值是什么? | 是 | 只有一部分 |
| 这一次动作整体是什么结构? | 很难 | 是 |
| 最近区段和以往相比是不是变了? | 很难 | 是 |
这张表说明,存储结构和问题表达结构的差别,不只是 表长得不一样,而是 能回答的问题不一样。因为“这张表是怎么存的”和“这张表能回答什么问题”并不是同一个问题。所以在 Part 3 的前段,第一件事不是看着记录去想模型名字,而是追问:这些记录应该被重新读成什么样的数据集候选。
从更宽一点的角度看,这一节把 保存源记录、重设分析单位、生成派生表达 区分成不同层次的工作,据此判断当前问题需要怎样重组以及哪些额外检查。
因此,首先要检查的不是资料叫什么,而是回答当前问题所需的单位和派生表示是否已经定义。
检查清单
- 能否从 A 的摘要行找到三条原始记录,并重新计算均值和最后区间斜率?
- 能否各写出一项摘要保留的信息,以及一项需要重新打开原始表才能获得的信息?
- 把
min_points_per_event降为 2 后,即使 C 通过,为什么仍不能说其斜率与 A、B 对应相同区间? - 即使已有三个点,要避免断言已观察到完整动作,还需要确认什么结束信息和测量间隔?
- 能否从输出确认:C 未通过点数条件时,原始记录与摘要候选本身并没有消失?
来源与参考资料
- Google for Developers,
Machine Learning Glossary中的example、labeled example、feature。它把 example 单位和 feature 角色分开说明,因此支持本节的核心判断:存储表中的一行,和可比较样本表中的一行,可能不是同一个意思。 https://developers.google.com/machine-learning/glossary / 确认日期: 2026-07-20 - Oracle,
Introduction to Data Warehousing Concepts. 它说明 data warehouse 是为了 business intelligence activities、query and analysis、维护历史记录和数据分析而设计的结构,因此可作为存储结构本身也能为分析而设计的背景资料,并不意味着存储表始终不适合分析。 https://docs.oracle.com/en/database/oracle/oracle-database/26/dwhsg/introduction-data-warehouse-concepts.html / 确认日期: 2026-07-20 - W3C,
PROV-Overview. 它同时处理 provenance、derivation、traceability,因此强化了这个上位框架:存储结构保留原始证据,问题表达结构则为不同问题构造派生表达。 https://www.w3.org/TR/prov-overview/ / 确认日期: 2026-07-20 -
Hadley Wickham,
Tidy Data, Journal of Statistical Software 59(10), 2014. 它整理了变量、观测值、表结构之间的关系,因此提供了一般原理,说明为什么存储结构中的一行和分析表中的一行不一定表示同一件事。 https://www.jstatsoft.org/article/view/v059i10 / 确认日期: 2026-07-20 -
Google Machine Learning Glossary。用于确认数据集、有标签样本与无标签样本之间的区别。确认日期:2026-09-15。