P5-7.6 补充学习:学习率调节策略
Section ID:
P5-7.6Version:v2026.07.26
在 P5-7.2 里,我们把 learning rate 读成了一次 update 的步幅。但一旦去看真实训练设置,就会遇到 learning rate 不是从头到尾固定不变,而是以 warmup、decay、cosine schedule 等名字不断变化的场景。
此时读者首先要抓住的问题,不是是不是又来了一个新 optimizer?,而是:即使用的是同一个 optimizer,为什么步幅运营策略还要随着时间变化? 这个视角以后也会继续被复用在训练日志、fine-tuning 设置与论文实验表里,因为它能把optimizer 选择和步幅运营策略分开来读。
需要 learning rate schedule 的问题
- 为什么要区分固定 learning rate 与会随时间变化的 learning rate?
- 为什么 warmup 应该被读成:在开始阶段慢慢放大步幅的装置?
- 为什么 decay 应该被读成:在后期逐渐缩小步幅的装置?
- 能不能不用死背公式,而用
步幅运营模式去区分 scheduler 家族?
这一节的重点,不是 scheduler 的实现 API,而是解释:在学习前期、学习中期、学习后期,步幅到底该怎样运营。
warmup 与 decay 的判断标准
- 能把 learning rate scheduler 解释成
步幅运营策略。 - 能说明 warmup 和 decay 各自想缓解的是哪一类学习阶段问题。
- 能大体区分 step decay、linear decay、cosine decay。
- 能说明:在读训练日志时,什么时候应该先提出 scheduler 问题。
为什么不能只用固定 learning rate 讲完
固定 learning rate 对 P5-7.2 的入门说明非常合适。但在真实学习里,并不是整个过程的每个区间都适合用同样的步幅。
- 在前期,参数还可能很粗糙地摇摆
- 在中期,较大的前进步幅可能有利于快速下降
- 在后期,更小的步幅则可能更适合细致调整
因此,更安全的读法不是把 scheduler 看成某种会更换 optimizer 的装置,而是把它看成:同一个 optimizer 在学习的时间轴上,要采用什么样的步幅政策。
如果把这句话再拆开,就是:optimizer 决定怎么移动,scheduler 决定什么时候大步、什么时候小步。 它们不是同一层位。可以在不改 optimizer 的情况下改 scheduler,也可以保持 scheduler 一样而只更换 optimizer。只有先抓住这条区分,用 Adam、用 cosine decay、加 warmup这些句子才不会又被读成同一种选择。
还有一点也很重要。理解 scheduler 时,并不需要从第一秒就钻进复杂公式。最先该问的是:我是在整个学习过程中一直保持同一个步幅,还是按不同区间来运营它? 只要这个问题先清楚,以后即使遇到库函数名字,也不容易迷路。
如果换成一个小场景,会更直观。假设你把同一个模型训练 10 分钟。前 1 分钟可能还在找方向,中间 6 分钟可能是快速下降阶段,最后 3 分钟则可能已经在不错的位置附近慢慢打磨。如果这三个区间在感觉上本来就不同,那么真的有必要全程都用同一个步幅吗? 这就正是 scheduler 的起点问题。
这个小场景之所以重要,是因为初学者第一次学 learning rate 时,往往只停在先选一个数字。 但 scheduler 一旦出现,问题就会变成:这个数字是不是要在整个训练过程中保持不动? 只要迈过这一步,scheduler 文档看起来就不会那么突兀。
一个很小的数字例子:固定 learning rate 与 schedule 的差别
例如,假设总共训练 6 个 step,基础 learning rate 候选是 0.1。
| step | 固定 learning rate | warmup + decay 例子 |
|---|---|---|
| 1 | 0.1 | 0.02 |
| 2 | 0.1 | 0.06 |
| 3 | 0.1 | 0.10 |
| 4 | 0.1 | 0.08 |
| 5 | 0.1 | 0.05 |
| 6 | 0.1 | 0.02 |
这张表最核心的意思很简单。固定 learning rate 会把每一步都按相同步幅来读;而 warmup + decay 则会把它读成一开始先谨慎、中间充分推进、结尾再重新谨慎。 初学者只要抓住这个感觉,scheduler 这些名字就已经会少很多抽象感。
如果再用图来看,差别会更直接。
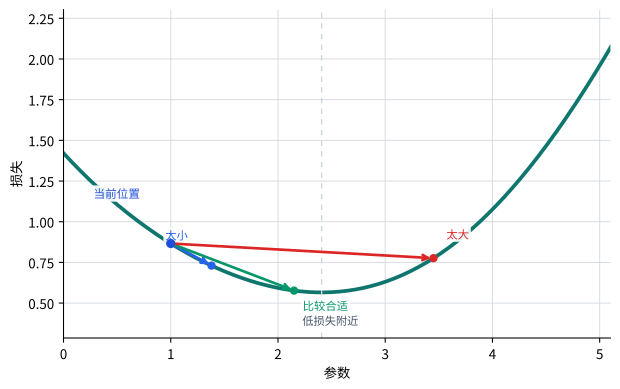
即使在同一条损失曲线上,步幅太小会几乎走不动,比较合适时能靠近更低损失区域,太大时则可能直接越过去。scheduler 做的,正是把这条步幅问题扩展成:在整个学习时间轴上,步幅应该怎么运营?
为什么需要 warmup
warmup 指的是:learning rate 不从一开始就设得很大,而是从一个较小值出发,在若干 step 或 epoch 里慢慢升上去。
这个装置之所以需要,原因很简单。学习刚开始时,参数状态还不稳定,gradient 模式也可能很粗。若一开始就给很大的步幅,模型还没来得及摸清方向,就可能已经被大步推得太猛。
如果压成一句话,就是:
warmup 是为了缓解学习前期的粗糙摆动,而让步幅慢慢变大的装置。
换成更日常一点的说法,warmup 更像是不要一开始就全速奔跑。 在训练最开始,参数还很粗糙,gradient 模式也还没稳定。如果此时立刻给一个很大的 learning rate,模型可能在刚开始辨认方向时,就因为步子过大而大幅晃动。warmup 更像是一个前期防超速装置,让学习先找到节奏。
例如,假设你打开训练日志,发现前几十个 step 里,loss 大幅上下起伏,之后才逐渐稳定。读者此时也许会先想:是不是模型结构有问题? 或 optimizer 选错了? 但从 warmup 视角看,问题其实更简单:它现在还处在开头,会不会步幅太大了? 这个问题,就是把 warmup 想起来的最容易入口。
再说得更短一点,warmup 更接近:在还没足够看清方向之前,不要一上来就迈太大步。 只要这句先固定,warmup 就不再像陌生技巧,而会像前期防过冲的自然装置。
为什么需要 decay
decay 指的是:随着学习推进,逐渐缩小 learning rate 的政策。入门阶段,先留下下面这个感觉就足够。
- 在前期,较大的步幅常常是可以接受的
- 在后期,既然已经靠近一个不错的位置,较小步幅更适合细调
也就是说,decay 可以先读成:进入后期微调模式时,主动缩小步幅。
如果再展开一点,decay 反映的是:持续用很大的步子,并不总是好事。 在学习前期,也许重要的是尽快削掉那些粗大的误差;但到了后期,模型可能已经在不错的区域附近了。此时如果仍然每次都走得很大,就可能越过目标区域,或让细小振荡拖很久。decay 正是在这种后期阶段表达:现在该更谨慎地走了。
把它换成一个小场景会更好理解。前期看到 loss 从 16 -> 9 -> 4 快速下降,是令人高兴的;但后期更令人注意的,常常是类似 0.8 -> 0.6 -> 0.7 -> 0.5 这种在目标附近上下摆动的情形。此时更重要的,不再是更快,而是别越过去。 decay 正是对应这种后期感觉的装置。
更短地说,decay 更接近:已经靠近好位置了,就把步子缩小。 如果说 warmup 是抑制前期过快加速,那么 decay 则是在抑制后期的过度振荡。
scheduler 模式应该怎样区分
| 名字 | 先抓住的感觉 | 步幅是怎样变化的 |
|---|---|---|
| step decay | 像楼梯一样降下去 | 在某些固定时点突然降一级 |
| linear decay | 像直线一样慢慢降低 | 随时间持续均匀下降 |
| cosine decay | 越到后面越柔和地下降 | 像平滑曲线一样减小 |
| warmup + decay | 先升后降 | 先有上升区间,再接下降区间 |
这张表并不是在说哪个公式更优雅,它是在帮读者看到名字时,先想到:步幅到底是在什么时候变大,什么时候变小。
对初学者来说,最好不要把它读成公式表,而更像一张学习时间轴上的步幅运营表。
再按步幅运营模式重新绑起来
| 学习区间 | 步幅运营问题 | 常见装置 |
|---|---|---|
| 前期 | 一开始就迈很大步,会不会太粗? | warmup |
| 中期 | 是不是需要一段更快前进的区间? | 维持相对较大的基础 learning rate |
| 后期 | 靠近目标时,是不是该缩小步幅,避免越过去? | decay |
这样来看,scheduler 不是新的 optimizer,而是在同一个 optimizer 之上,按时间来运营步幅的规则。
如果忽略这条区分,读者就很容易把已经定了 learning rate和已经定了 learning rate schedule读成一句话。但其实不是。前者是在决定当前步幅的基本大小,后者是在决定这个步幅要怎么沿着整个训练过程变化。 只有这两者被分开看见,之后看到像 optimizer=Adam, scheduler=cosine, warmup=5% 这样的设置句子时,才会自然分解开来。
案例与示例
案例. 用的是同一个 optimizer,但前期和后期出现了不同问题
即使只选了一个 optimizer,比如 Adam 或 momentum,前期和后期也可能出现完全不同的问题。比如前期 loss 会猛烈地跳,中期下降很快,而后期则会在目标附近留下细小振荡。
如果把所有这些场景都读成是 optimizer 不好,解释就会过于粗。scheduler 视角会把问题拆小。
| 看见的场景 | 先想到的 scheduler 问题 | 阅读标准 |
|---|---|---|
| 前期 loss 摇得很厉害 | 一开始的步幅是不是太大? | 是否需要 warmup |
| 中期下降不错,但后期振荡很强 | 后期的步幅是不是还太大? | 是否需要 decay |
| 整个训练都显得太慢 | 是不是从头到尾步幅都太保守? | 基础 learning rate 或整体 schedule 是否过小 |
这一节真正要闭合的,不是哪个 scheduler 出名,而是:能不能把步幅运营问题放到时间轴上分开来读。
如果把这个案例再展开一点,初学者读真实日志时真正困难的往往不是数字,而是时点。同一条 loss 曲线里,前期的大幅摇摆与后期的小幅振荡,未必来自同一种原因。所以 scheduler 视角会逼着我们先问:现在的问题到底发生在哪个学习区间? 如果是前期过猛,warmup 问题就先出来;如果是后期细振荡,decay 问题就先出来。只要先把时间轴切开,对原因的猜测就会少很多混杂。
练习与例子
读下面这些日志解释句子,写出应该先点亮哪一种步幅运营问题。
| 日志解释句子 | 先要检查的 scheduler 问题 | 先想到的装置 |
|---|---|---|
| 前几百个 step 里,loss 曲线非常粗糙 | 前期步幅是不是应该更慢地升上去? | warmup |
| 已经够好了之后,目标附近仍然上下晃得很大 | 后期步幅是不是还应该再缩小? | decay |
| 过了某个 milestone,想改成更细致的调整 | 是否该按区间阶梯式降低步幅? | step decay |
| 想让整个训练过程都更平滑地往下走 | 是否该连续下降,而不是台阶式下降? | linear / cosine decay |
这个练习的目的,不是背 scheduler 名字,而是养成:先把步幅运营问题提出来。
检查清单
- 能把 learning rate scheduler 解释成
步幅运营策略吗? - 能把 warmup 解释成
防止模型在前期一下子迈太大步的装置吗? - 能把 decay 解释成
后期微调时缩小步幅的策略吗? - 能把 step decay、linear decay、cosine decay 读成不同的
步幅模式吗? - 在看训练日志时,能把前期不稳定、后期振荡、整体过快或过慢,先连接到 scheduler 问题吗?
来源与参考资料
- PyTorch,
torch.optim, PyTorch documentation. 用于确认lr_scheduler会根据 epoch 或验证指标调整 learning rate,并提供StepLR、LinearLR、CosineAnnealingLR等 scheduler。确认日期:2026-07-19. https://docs.pytorch.org/docs/stable/optim.html#how-to-adjust-learning-rate - Ilya Loshchilov, Frank Hutter,
SGDR: Stochastic Gradient Descent with Warm Restarts, ICLR 2017. 用于确认 cosine annealing 与 restart 类 learning rate schedule 的背景。确认日期:2026-07-19. https://arxiv.org/abs/1608.03983