P5-7.7 补充学习:optimizer state 与逐参数 update
Section ID:
P5-7.7Version:v2026.07.26
在 P5-7.3 里,一讲到自适应 update,最近 gradient 流向和按坐标调节这两个表达就不断出现。顺着这个解释,自然会留下一个问题:这些信息到底会被留在哪里?为什么即使当前 gradient 看起来一样,下一次 update 仍然会不同?
若要回答这个问题,就必须把 parameter、gradient、update、optimizer state 当成四种不同东西来分开。 这个区分以后也会继续被复用在 checkpoint 保存、训练重启、更换 optimizer、fine-tuning 设置等场景里。
初学者会觉得这一节压得比较紧,不是因为它真的很高深,而是因为这四个词看上去都像是在说某些数字。实际代码里,它们常常又紧挨着出现,所以很容易让人误以为:是不是同一种东西换了几个名字。
optimizer state 怎样改变 update 的问题
- parameter、gradient、update、optimizer state 分别是什么?
- 为什么 optimizer state 和模型参数不是同一种东西?
- 说到 parameter-wise update 时,到底是什么意思在按坐标分别保存?
- 为什么 adaptive optimizer 不只看
当前 gradient,还要把累积下来的内部状态一起看?
这一节的重点,不是库实现细节,而是说明:optimizer 到底额外记住了什么。
parameter-wise 状态与应用单位的判断标准
- 能区分 parameter、gradient、update、optimizer state。
- 能说明 optimizer state 可以按坐标分别维护。
- 能说明:即使 gradient 相同,只要 state 不同,下一次 update 也可能不同。
- 能把 adaptive optimizer 里的
adaptive和内部状态的累积联系起来。
先把四样东西分开
| 项目 | 它是什么 | 它在什么时候变 |
|---|---|---|
| parameter | 模型真正持有的权重值 | optimizer 把 update 反映上去时 |
| gradient | 在当前 parameter 上算出来的方向信号 | 执行 backward 时 |
| update | 这一 step 真正要施加到 parameter 上的移动量 | optimizer 读 gradient 和 state 时 |
| optimizer state | optimizer 为下一步保留的内部记忆 | 每个 step 后都可能一起更新 |
如果把这张表压成一句话,就是:
gradient 是信号,update 是移动量,parameter 是真实值,而 optimizer state 是为了下一次移动而保留下来的记忆。
这句话很重要,因为初学者在看学习代码或说明文时,常常会把这四样东西都感觉成同一种对象。尤其当gradient 算出来了、optimizer 跑了、模型更新了这样的句子连着出现时,更容易让人误以为它们是在说同一件事。但实际上,它们分属不同层位。gradient 是当前位置上的信号,update 是收到这个信号之后,这一 step 里真正要施加的移动量,parameter 是这个移动量反映之后的结果,而 optimizer state 则是为了下一 step 单独留下的内部记忆。
只有这条区分先沉下来,后面读 adaptive optimizer 时,像Adam 会带更多 state、它会做 parameter-wise update、即使 gradient 相同,update 也会不同这些句子,才会自然接在一起。
读学习代码里的三句话时,该怎样拆开
初学者很容易把下面三句话读成几乎同一件事。
| 在代码或说明里看到的话 | 实际发生的事情 |
|---|---|
| 计算了 gradient | 在当前位置算出了朝哪边更好的信号 |
| optimizer 做了一步 | 利用那个信号和 state,算出并应用了这一 step 的移动量 |
| 模型被更新了 | parameter 数值本身真的改变了 |
只要先摆出这张表,就会更清楚地看到:gradient 已经算出来了和parameter 已经改变了之间,还隔着 optimizer 与 update。
如果把它再压成一张图,那么即使都发生在同一个学习循环里,这四个东西也还是占着不同位置。
flowchart TD
  A["forward pass<br/>用当前参数做预测"]
  B["loss<br/>把误差变成数字"]
  C["backpropagation<br/>计算梯度"]
  D["optimizer<br/>把梯度变成 update"]
  E["参数更新被应用<br/>权重真正发生变化"]

  A --> B
  B --> C
  C --> D
  D --> E

  B -. "哪里出错了" .-> C
  C -. "该朝哪个方向改" .-> D
  D -. "把算出来的结果作为真实移动应用" .-> E
对这一节尤其重要的,是图里的 gradient 计算 -> optimizer -> parameter 反映 这一段。optimizer state 就是在这个中间,被当成:这一回该把这个信号翻成多大的移动量? 的内部记忆。
为什么 optimizer state 要单独存在
如果只是最基本的直接 update,那么当前 gradient 加 learning rate 就足以形成 update。但如果想像 momentum、RMSProp、Adam 那样,把最近流向或按坐标尺度也考虑进去,就必须把前面几步的信息留在某个地方。这个地方,就是 optimizer state。
例如,下面这些值都属于 state。
- 前面移动方向的累积值
- 按坐标累计的平方 gradient 平均
- step 数或 bias correction 需要的辅助信息
也就是说,optimizer state 不是模型用来表达世界的知识,而更像是 optimizer 为了决定下一步怎么走而随手带着的工作备忘录。
如果把这个比喻再展开,model parameter 更接近于当前模型怎样在表示世界,而 optimizer state 则更像是下次该怎样继续修这份表示的辅助记录。两者之所以容易混淆,是因为它们都是数字,保存格式看起来也很像。但角色不同。parameter 是模型内容,state 是移动规则的上下文。
所以理解 optimizer state 时,最重要的态度就是:不要把它和模型学到的知识混成同一句话。模型学到的内容存放在 parameter 里,而 optimizer 为了更稳定地把学习继续下去而暂时带着的信息,存放在 state 里。只有这条分离先清楚,checkpoint、optimizer 重启、微调这些场景之后才不会更乱。
如果换成一个小场景,这种差别会更明显。保存模型文件时,通常最重要的是当前模型手里到底拿着哪些值。但如果想从中途继续训练,那么除了模型值,还可能需要 optimizer 到目前为止记住了什么流向。也正是在这个地方,parameter 是模型内容,state 是学习过程语境这条区分才变得有实际意义。
一个很小的数字例子:把 parameter 与 state 一起看
假设现在有两个坐标:risk_weight 和 recovery_weight。
| 项目 | risk_weight | recovery_weight |
|---|---|---|
| 当前 parameter | 1.4 | 0.8 |
| 当前 gradient | -1.0 | -1.0 |
| 累积 state 的例子 | 最近很多步都收到较大的 gradient | 最近一直比较安静 |
表面上看,两者当前 gradient 都是 -1.0。但只要把 state 这一行一起读进去,它们就已经不再站在同一种语境里。也正因为这个差别,在 adaptive optimizer 里,更安全的读法就不再是:当前 gradient 一样,所以 update 也应该一样。
parameter-wise update 到底是什么意思
parameter-wise update 的意思,并不是所有 parameter 都永远只按一个共同数字来移动,而是每个坐标都可能根据自己的信息,收到不同大小的 update。
这里最重要的一点是:不同 parameter 可以拥有不同 state。 某个坐标最近可能连续收到过很多大 gradient,而另一个坐标几乎没怎么动。adaptive optimizer 正是为了反映这种差异,才会按坐标分别保存 state。
所以看到 parameter-wise update 时,更安全的做法,是先问下面这些问题。
- 每个坐标分别保存了什么?
- 这些保存下来的值,怎样进入下一次 update 的大小?
- 即使所有坐标共享同一个 learning rate,为什么真实移动量还是可能不同?
这些问题之所以重要,是因为同一个模型里的所有参数都总是以同一种方式移动这个直觉,本来就和 adaptive optimizer 对不上。参数越多,就越可能出现:有的坐标经常收到大 gradient,有的几乎没有信号,有的则是最近才突然大幅反应。parameter-wise update 正是在承认这些差异。它不会把所有坐标都当作同样的处境,而会把各自的语境一起读进去。
如果把这句话再说得更实际一点,parameter-wise update 更接近于:并不会把所有权重都一视同仁地对待。 这不是在偏心,而是在承认:每个坐标到目前为止的反应历史不同。有的坐标已经动了很多次,有的几乎还没动,有的只是最近突然开始反应强烈。adaptive optimizer 就站在不忽略这些差异的一边。
如果这仍然抽象,可以想象:给全班同样作业和按每个学生不足之处布置不同补充练习之间的区别。parameter-wise update 更接近后者。它不会把每个坐标都看成在同一种情况里,而会按坐标去读不同上下文。
把时间轴 state 与坐标轴 state 分开
| 区分 | 它的意思 | 例子 |
|---|---|---|
| 时间轴 state | 把前几 step 的信息带到当前 step 的记忆 | momentum 里的方向累积 |
| 坐标轴 state | 按 parameter 分别积累的记忆 | Adam 里的按坐标 second moment |
真实的 adaptive optimizer 往往会同时拥有这两种轴。因此,有 state 这句话并不只是意味着需要更多存储空间,而是意味着:update 规则已经开始同时读取时间与坐标。
为什么同样的 gradient,下一次 update 还是会不同
即使当前再次收到相同的 gradient,只要前面几步留下来的 state 不一样,下一次 update 就仍然可能不同。比如某个坐标之前已经连续收到过很多大 gradient,因此 state 让它更谨慎;另一个坐标则几乎没怎么动,所以还可能更强烈地响应。
也就是说,在 adaptive optimizer 里,现在 gradient 是什么并不足以单独决定下一次 update。现在的 gradient与到现在为止留下来的 state一起,才会生成真实移动量。
只要抓住这句话,下面这条区分就会更清楚。
- gradient 是这一 step 的输入信号
- optimizer state 是前面 step 留下来的语境
- update 是把两者合在一起之后,生成的这一 step 真实移动量
一旦理解了这个结构,为什么 Adam 在相同 gradient 下也会有不同移动这个问题就会简单得多。答案并不藏在神秘算法名里,而是因为:当前 gradient 前面本来就拖着已经累积好的上下文。换句话说,adaptive optimizer 不是只对当前信号立刻反应,它还会把到目前为止的移动历史和按坐标反应记录一起读进去。
案例与示例
案例. 为什么 gradient 一样,update 却看起来不同
假设两个参数此刻都收到了 gradient = -1.0。表面上看,它们似乎都应该朝同一方向、以同样大小移动。但在 adaptive optimizer 里,这并不一定成立。一个参数可能在前几步已经连续收到了很多大 gradient,另一个则可能几乎直到现在才第一次收到明显信号。
如果用 state 视角重读这个场景,会变成下面这样。
| 现在眼前看到的 | 如果不看 state,会怎么读 | 把 state 也一起读进去之后 |
|---|---|---|
| 两个坐标的当前 gradient 一样 | 会觉得下一次 update 也应该一样 | 只要累积 state 不一样,update 就可能不同 |
| 某个坐标动得比较小 | 会像是 optimizer 忽略了它 | 也可能只是因为它已经积累了更保守的 state |
| 某个坐标动得更大 | 会看起来像更不稳定 | 也可能只是因为它的累积还少,所以能反应得更明显 |
这一节真正要闭合的,就是:在 adaptive optimizer 里,相同 gradient = 相同 update并不会自动成立。
如果要让读者真正接受这句话,还得再慢半步。对初学者来说,输入相同,输出就该相同本来是很自然的直觉。但在 adaptive optimizer 里,当前 gradient 并不是唯一输入。前面 step 留下来的 state,也同样是输入的一部分。因此即使当前 gradient 一样,只要挂在它前面的 state 不一样,update 就会不同。这个点一旦看见,adaptive optimizer 相关句子就会一下子少很多抽象感。
如果再补一个很小的数字场景,就更容易接受。假设两个坐标现在都收到 -1.0。但第一个坐标在前五步里可能连续见过 -3.0、-2.0、-2.5 这样的较大信号,而第二个坐标则长期接近 0.0,只是这一次才第一次收到 -1.0。若只看当前这一行,二者看起来完全一样;可一旦把 state 读进去,第一个坐标可能已经累积出了需要更谨慎移动的语境,而第二个坐标则仍然有更强响应空间。只要想象这个场景,同样的 gradient,为什么 update 却不同? 这个问题就会不再奇怪。
如果把这个小场景写成表,就是下面这样。
| 坐标 | 当前 gradient | 之前的语境 | 更自然的解释 |
|---|---|---|---|
| 第一个坐标 | -1.0 | 前几步持续收到较大信号 | 可能已经积累出更谨慎移动的 state |
| 第二个坐标 | -1.0 | 长时间比较安静 | 仍然可能更明显地响应这一次信号 |
也就是说,即使当前输入数字一样,若想不误读 adaptive optimizer,就必须连着一起读:这个数字后面挂着怎样的上下文?
再用图看一次,差别会更直接。
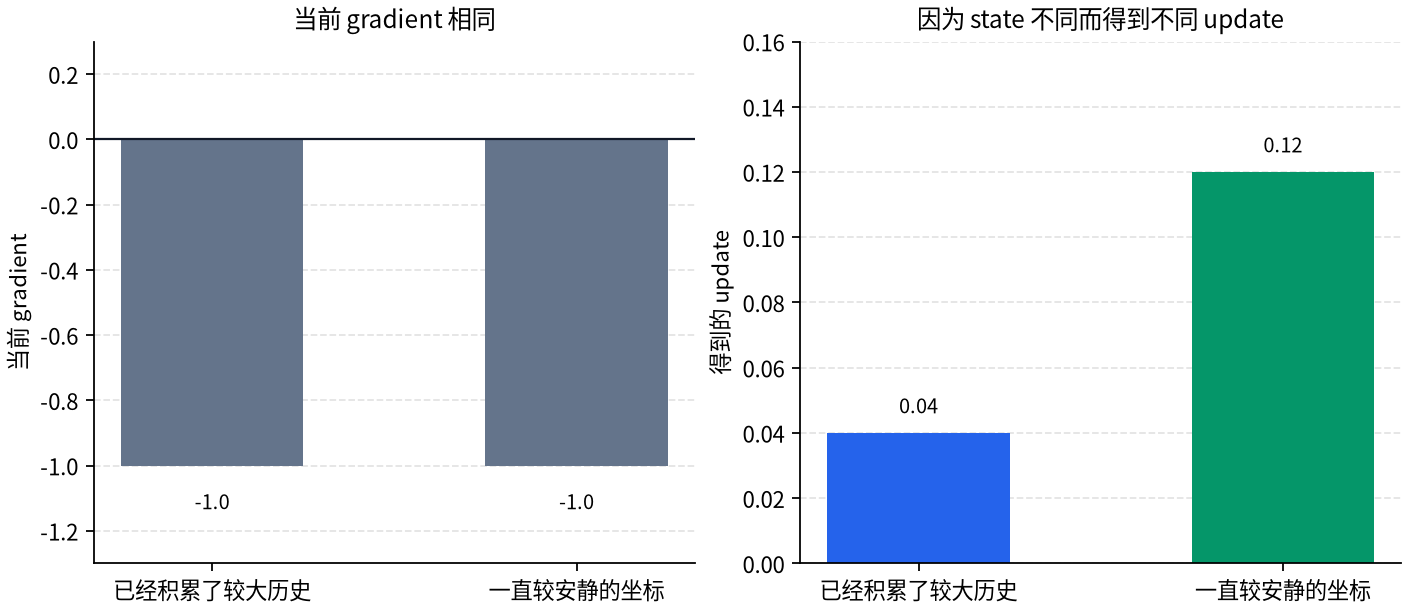
左侧面板显示的是:两个坐标都收到相同 current gradient -1.0 的场景。右侧面板则说明:即使这样,update 仍然可能分成 0.04 与 0.12。这里真正变的,不是当前 gradient,而是挂在它前面的 state。这张图再次用可视方式确认:即使输入一样,只要语境不同,输出也会不同。
练习与例子
读下面这些句子,写出其中缺失了什么区分。
| 句子 | 缺失的区分 | 重新阅读时的标准 |
|---|---|---|
| gradient 算出来了,所以参数现在已经改变了 | gradient 与 update 的区分 | optimizer 做出的移动量真的被反映了吗? |
| Adam 只是自动决定 learning rate | state 与 parameter-wise update 的区分 | 它是不是通过按坐标累积 state 来调节步幅? |
| 两个坐标收到相同 gradient,所以 update 也必须一样 | current gradient 与 stored state 的区分 | 前面累积下来的 state 也一样吗? |
| optimizer state 是模型学到的知识 | parameter 与 optimizer state 的区分 | 有没有把模型内容与移动规则用的工作记忆分开? |
这个练习的目的,不是背实现 API,而是区分:optimizer 到底把哪些数字当成模型参数保存,又把哪些当成工作记忆保存。
检查清单
- 能把 parameter、gradient、update、optimizer state 解释成四种不同东西吗?
- 能说明 optimizer state 是
为了生成下一次移动而留下的内部记忆吗? - 能说明 parameter-wise update 与
按坐标拥有不同 state这件事是连在一起的吗? - 能说明:即使 gradient 相同,只要 state 不同,下一次 update 也可能不同吗?
- 能把 adaptive optimizer 里的
adaptive和时间轴累积、坐标轴调节这两类 state 联系起来吗?
来源与参考资料
- PyTorch,
torch.optim, PyTorch documentation. 用于确认 optimizer 对象会持有 parameter、per-parameter options 与 optimizer state,并通过step()执行 update。确认日期:2026-07-19. https://docs.pytorch.org/docs/stable/optim.html - PyTorch,
torch.optim.Adam, PyTorch API Reference. 用于确认 Adam 会维护 first moment 与 second moment 状态,并按 parameter 计算 update。确认日期:2026-07-19. https://docs.pytorch.org/docs/stable/generated/torch.optim.Adam.html