P6-3.4 补充学习:ANN 检索的速度与候选遗漏折中
Section ID:
P6-3.4Version:v2026.07.26
在 P6-3.2 中,我们抓住了寻找邻近候选这个比较标准;在 P6-3.3 中,我们看了怎样学习表达空间,才能让这种比较成立。现在还剩一个问题。
在那么多向量中,怎样以真实服务速度快速找到邻近候选?
只要先不把生成好的向量的问题和快速找到那些向量的问题混在一起,问题就已经整理了一半。
快速候选搜索的成本和遗漏
- nearest neighbor 和 ANN(approximate nearest neighbor) 有什么不同?
- 为什么只靠全量比较(full scan)很难支撑服务速度?
- ANN 稍微放弃什么,又得到什么?
- 可以先用什么信号区分质量问题和速度问题?
这里先抓住足够快速地缩小邻近候选的问题。实际向量数据存储结构、index 选择、检索质量调整,会在后面的检索系统小节中更广地处理。
| 当前焦点 | 再次扩展阅读的位置 |
|---|---|
| 快速候选搜索 | P6-3.4, P6-13.1, P6-13.2 |
| 存储和 index 结构 | P6-13.1, P6-13.2 |
因此,中心问题是为什么即使采用近似方式,也需要更快缩小邻近候选。
区分好的表达空间和快速搜索
- 可以说明 nearest neighbor 和 ANN 的差异。
- 可以说明为什么候选数越大,全量比较越慢。
- 可以把 ANN 说明为
获得速度,同时接受一部分候选可能遗漏的方式。 - 可以按信号区分表达质量问题和搜索速度问题。
为什么需要单独的 ANN
如果文档只有几十个,全部向量都比较一遍也可能没问题。如果只以这种经验为标准,就容易觉得想最准确,就应该一直比较到底。
但文档增长到几十万、几百万时,问题本身没变,比较成本却会急剧变大。于是,以实践速度快速找到足够好的上位候选会比精确比较更先成为运营问题。
nearest neighbor 和 ANN 有什么不同
| 方式 | 最短直觉 | 先改善什么 | 同时要接受什么 |
|---|---|---|---|
| nearest neighbor 全量比较 | 看完所有候选,再找最近的 | 候选遗漏风险小 | 可能变慢 |
| ANN 检索 | 更快缩小足够接近的候选 | 响应速度和比较成本 | 可能漏掉部分候选 |
这里重要的是,不要把 ANN = 随便找 来读。更安全的说明是:
ANN 是用实践中可用的速度,更快找到可用上位候选的折中,而不是完美全量比较。
速度问题先在什么场景显现
速度问题通常会先出现在下面场景中。
| 先看到的现象 | 实际上先怀疑什么 |
|---|---|
| 候选质量看起来合理,但响应太慢 | 需要比较的候选是否太多 |
| 文档数越多,延迟越急剧增加 | 全量比较结构是否成为瓶颈 |
| ANN 调得很强后速度变快,但文档消失 | 速度收益和候选遗漏是否一起增加 |
这时也不要把问题压成检索很奇怪一句话,而要先分开读质量是否晃动和速度是否先崩掉。
案例与示例
案例 1. FAQ 很少时,全量比较也能撑住
如果 FAQ 只有 20 条,全部候选都比较一遍也可能没有大问题。如果只以小 FAQ 的经验为标准,就容易想:是不是一直这样做也可以?
但这个场景中要确认的结果是,小的时候撑得住和变大之后也撑得住不是同一句话。候选只有 20 个时,全量比较安全而简单;候选增加到 20 万个时,同一种方式会快速增加响应时间和成本。
这个案例支持本节,是因为它说明 ANN 不是从一开始就必须使用的神奇技术。它是在候选数变大、全量比较难以支撑服务速度时出现的折中。
这个案例最后要关闭的判断,是不要把小数据中可行的全量比较泛化成运营规模的标准。候选数变大时,要把候选数增长和延迟增长一起看。
案例 2. 文档数变大后突然变慢
当政策文档和 FAQ 增长到几十万条时,过去还可以的比较方式可能突然成为瓶颈。这里首先要纠正的误解是可能是 embedding 质量变差才慢。
实际上,即使候选本身是对的,也可能因为比较成本太大而变慢。这个场景中,先成为问题的是搜索速度,而不是表达质量。
这个案例支持本节,是因为它说明是否生成了好的向量和能否在那么多向量中快速缩小邻近候选是两个不同问题。即使表达空间不错,只要全量比较成为瓶颈,就要检查 ANN 这样的快速候选缩小结构。
这个案例最后要关闭的判断,是分开候选质量和搜索速度。候选是对的但很慢时,先看全量比较瓶颈和 index 调整,而不是先重新训练表达质量。
案例 3. 速度变快,但重要文档消失
如果把 ANN 设置调得更激进,速度确实变快了,但包含最新例外条款的文档总是从上位候选中消失,就需要纠正速度变快就是无条件改善这种感觉。
所以这个案例中先要关闭的句子是:
ANN 是一种在获得速度的同时,也必须管理候选遗漏可能性的结构。
这个案例支持本节,是因为它不让我们只把 ANN 读成快速找到,而是回到近似搜索中要同时管理速度收益和 recall 损失这个中心问题。
这个案例最后要关闭的判断,是检查快速结果是否仍保持足够的候选质量。ANN 设置不仅要测延迟时间,还要一起测候选遗漏和 recall 损失。
把三个案例重新整理如下。
| 情况 | 先要变好的东西 | 不要混入的误解 |
|---|---|---|
| 候选数很少 | 简单比较结构 | 把小例子泛化成运营标准 |
| 文档数越大越慢 | 搜索速度 | 先断定是质量问题 |
| 速度变快但文档消失 | 速度-质量平衡 | 把速度改善当作成功 |
区分搜索速度问题
从 ANN 视角重新看实践现象,即使还不了解具体 index 名称,也可以先像下面这样区分现在先晃动的是不是速度问题。
| 当前看到的现象 | 容易先想到的误解 | 先改问的问题 |
|---|---|---|
| 上位候选看起来合理,但响应太慢 | 容易觉得要重新训练 embedding,先归到质量问题 | 缩小邻近候选的比较成本是否先成为瓶颈? |
| 文档数增加后延迟急剧增加 | 容易觉得稍微加硬件就结束 | 全量比较结构本身是否已经碰到极限? |
| ANN 调得更激进后文档消失 | 容易觉得只要速度变快就是变好 | 速度收益同时带来了多少候选遗漏? |
这张表的目的不是让人背更多 ANN 算法名称。它是为了在实践场景中短暂区分:现在是不是搜索速度信号比表达质量信号更先出现?
练习与示例
这一节不能只靠直觉结束。需要看到 coarse_window 值改变时,比较候选数和候选遗漏是否真的变化。因此先用一个短练习抓住应该预期什么,再用 Python 示例确认全量比较和快速候选缩小的输出差异,最后再在练习中把这个结果转成运营判断。
练习 1. 执行前先预测比较标准
执行示例前,先回答下面问题。
- 全量比较更能减少候选遗漏风险,还是比较成本?
- 快速候选缩小先想减少比较成本,还是候选遗漏风险?
coarse_window太窄时,可能出现什么问题?
解说:全量比较会看完所有候选,所以能减少候选遗漏风险;但候选数越大,比较成本也会照样增加。快速候选缩小先想减少比较成本,但条件太窄时,可能漏掉一部分邻近候选。因此执行示例时,不要只看什么更快,还要一起看漏掉了什么。这就是 P6-3.4 的中心轴:管理速度收益和候选遗漏。
示例. 用 coarse_window 实验候选缩小
这个示例的目标,是把全量比较和快速候选缩小并排放在一起,直接看到为什么实践中需要 ANN。它没有实现真正的 ANN index,但如果用 scikit-learn 的 NearestNeighbors 找出基准上位候选,再用一阶条件只留下部分候选,并重新应用同一个 search API,核心感觉会更清楚。
这个示例不是学习 Python 用法的说明型示例,而是改变数值并观察结果差异的实验型示例。这里可以直接改的值是 coarse_window。这个值越宽,会比较更多候选,候选遗漏风险会降低;这个值越窄,比较候选数会减少,但也可能漏掉一部分邻近候选。
先看下面三项来阅读执行结果。
| 要确认的东西 | 示例中看的值 | 为什么看 |
|---|---|---|
| 全量比较的基准结果 | full_top5 | 建立看完所有候选时的基准上位候选。 |
| 快速候选缩小的比较成本 | candidates | 查看实际只比较了多少候选。 |
| 激进缩小的损失 | recall@5, missed | 确认为了速度漏掉了多少邻近候选。 |
下面代码使用一个 query 向量、几个手动放入的近邻 FAQ 候选,以及 3,000 个随机生成的背景 FAQ 候选。执行结果中,要并排比较用 NearestNeighbors 建立的全量比较基准线,以及改变 coarse_window 时的快速候选缩小结果,并确认各设置实际比较的候选数、recall@5、漏掉的上位候选。关键是直接读出:看完所有候选是安全的,但候选数变大时可能变慢;快速候选缩小如果设置太激进,可能漏掉重要候选。
执行结果示例可以这样阅读。下面输出使用本地 .venv 的 Python,以和正文代码相同的值确认过。
这个示例要阅读的核心如下。
- 全量比较会看完
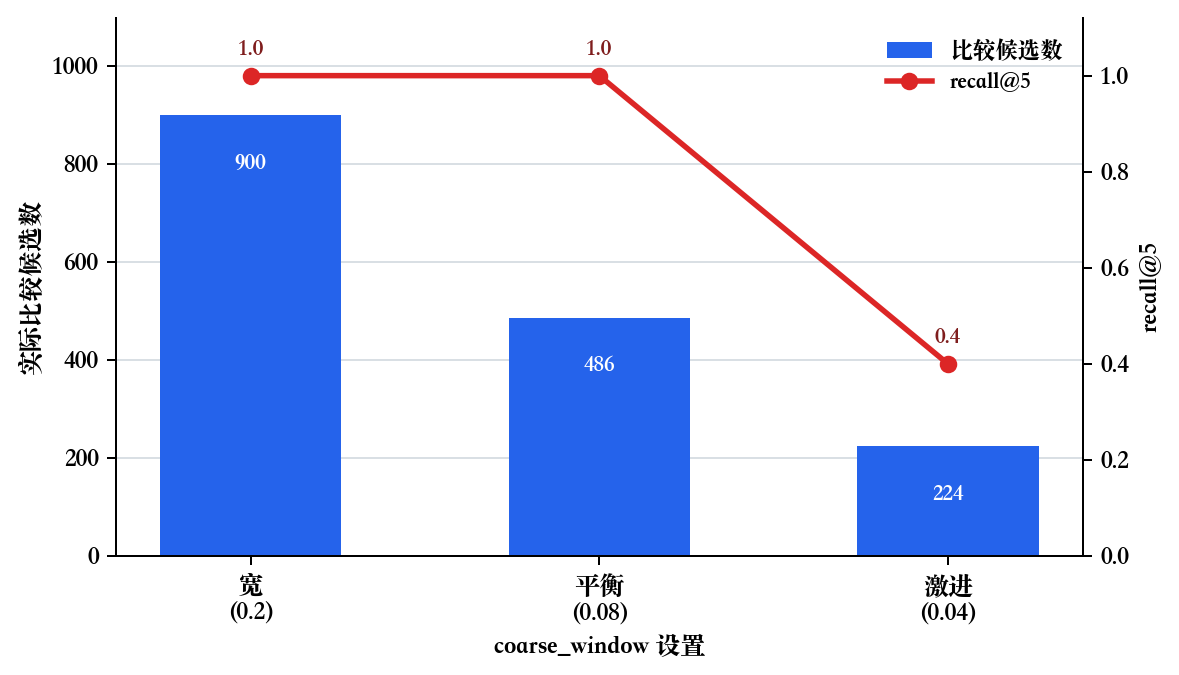
3,007个候选,所以作为基准线很安全,但候选数越大越慢。 coarse_window=0.20把比较候选减少到900个,同时仍保留全量比较的前 5 个。coarse_window=0.08把比较候选进一步减少到486个,并且在这个示例中仍保持recall@5 = 1.0。coarse_window=0.04把比较候选进一步减少到224个,但recall@5降到0.4,并漏掉cancel_payment、payment_receipt、refund_exception。- ANN 的实践感觉也与此类似:它不是
完美全量比较,而是快速找到足够好的近邻候选,同时管理候选遗漏。
只画数值变化时,可以像下面这样阅读。到 balanced 为止,即使候选数减少,也仍保留基准前 5 个;但在 aggressive 中,候选数继续减少的同时,recall@5 也一起崩掉。
练习 2. 从输出中阅读基准线和损失
读完示例后,先回答下面问题。
- 全量比较比较了多少个候选?
balanced设置只比较了多少个候选,recall@5是多少?aggressive设置漏掉了什么?- 这个示例中 ANN 的核心感觉是什么?
解说:全量比较中 doc_count = 3007,因此比较了全部 3,007 个候选。balanced 设置只比较了 486 个候选,在这个示例中以 recall@5 = 1.0 保留了全量比较的前 5 个。相反,aggressive 设置把候选进一步减少到 224 个,却漏掉了 cancel_payment、payment_receipt、refund_exception。因此,这个示例中 ANN 的核心感觉是:不把每个向量都比较到底也能获得实践速度,但必须同时观察设置是否制造候选遗漏。
练习 3. 区分全量比较和快速候选缩小
观察值:
| 情况 | 候选数 | 上位候选质量 | 响应时间 |
|---|---|---|---|
| A | 30 个 | 好 | 快 |
| B | 300,000 个 | 好 | 慢 |
| C | 300,000 个 | 差 | 快 |
先自己回答。
- A、B、C 中,哪个场景应该先检查 ANN 这样的快速候选搜索?
- C 是速度问题,还是表达质量问题?
解说:B 的候选质量好,但响应时间慢,所以应该先检查快速候选搜索。A 的候选数小,响应也快,因此全量比较也可能足够。C 的响应很快,但上位候选质量差,所以要先看表达质量或候选遗漏设置,而不是 ANN 速度。这个区分就是 P6-3.4 的中心:分开搜索速度问题和质量问题。
练习 4. 一起看速度收益和候选遗漏
观察值:
| 设置 | 平均响应时间 | 重要文档遗漏 |
|---|---|---|
| 全量比较 | 900ms | 几乎没有 |
| ANN 温和设置 | 180ms | 少见 |
| ANN 激进设置 | 70ms | 经常发生 |
先自己回答。
- 哪个设置无条件最好?
- 运营判断要一起看什么?
解说:没有无条件最好的设置。全量比较安全但慢,ANN 激进设置很快但经常漏掉重要文档。运营判断必须一起看响应时间和候选遗漏。ANN 不是只提高速度的装置,而是同时管理速度收益和 recall 损失的近似搜索方式。
练习 5. 改变 coarse_window 值并解释
观察值:
| 设置 | coarse_window | 比较候选数 | 全量比较前 5 个中的遗漏 |
|---|---|---|---|
| 激进设置 | 0.04 | 224 个 | cancel_payment, payment_receipt, refund_exception |
| 平衡设置 | 0.08 | 486 个 | 无 |
先自己回答。
- 把
coarse_window从0.04增大到0.08后,什么变好了? - 反过来,什么增加了?
- 这个变化是表达质量问题,还是搜索设置问题?
解说:增大到 0.08 后,全量比较中的上位候选 cancel_payment、payment_receipt、refund_exception 又被包含进来,因此 recall@5 从 0.4 上升到 1.0。但实际需要比较的候选数从 224 个增加到 486 个。这个变化没有重新训练句子向量本身,而是调整了候选集合要保留多宽,所以它是搜索设置问题,不是表达质量问题。这个练习的边界是:速度越快,越要一起看候选遗漏。
因此,本节最后的判断很简单。候选正确但慢时,看搜索成本;速度变快但重要文档消失时,把速度收益和候选遗漏一起看。
检查清单
- 能否说明 nearest neighbor 和 ANN 的差异?
- 能否说明候选数越大,全量比较越慢的理由?
- 能否把 ANN 说明为
获得速度,同时接受一部分候选可能遗漏的方式? - 能否按信号区分表达质量问题和搜索速度问题?
来源与参考资料
- Arya et al., An Optimal Algorithm for Approximate Nearest Neighbor Searching Fixed Dimensions, Journal of the ACM, 1998, 确认日期: 2026-07-19. 用作区分 ANN 和精确最近邻搜索的经典近似搜索背景依据。
- Yu A. Malkov, D. A. Yashunin, Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs, arXiv, 2016, 确认日期: 2026-07-19. 用作说明基于 HNSW 的 ANN 检索会作为速度和候选质量折中的背景依据。