P6-4.4 补充学习:KV cache 与重复生成
Section ID:
P6-4.4Version:v2026.07.26
副标题:KV cache 在重复生成中复用哪些 attention 计算?
在 P6-4.2 中,我们看到 attention 和 context window 会连接到输入范围限制;在 P6-4.3 中,我们整理了 multi-head attention 和位置表示如何补强上下文读取方式。接下来经常让人卡住的名称是 KV cache。
为什么长对话或长生成中,即使结构相同,也会越来越慢?
回答这个问题时,要抓住 是否复用一部分先前计算这一视角。这里把 KV cache 读成这种复用装置。
KV cache 复用的计算
- KV cache 为什么会连接到对话式生成速度?
- KV cache 是改变模型含义的装置,还是减少重复计算的装置?
- context window 越长,KV cache 为什么越重要?
这里首先要收束的问题是:在重复生成中,已经计算过的前半部分如何被重新使用。
| 现在处理的内容 | 留给后面章节或后面 Part 的内容 |
|---|---|
| 保存一部分先前计算,并在下一 step 复用的 KV cache 基本含义 | 实际 serving engine 各自的 cache 管理方式 |
| 在保持相同结果的同时减少 projection 负担的感觉 | 运营延迟和成本优化判断 |
context window 限制本身已经在主线 P6-4.2 中说明,KV cache 对运营延迟和成本的影响会在 P6-18.1 中再次回收。更好地维持长上下文本身的问题,以及 sparse attention,是另一个长上下文设计问题。
抓住这个区分之后,才能把 KV cache 读成 用更少重复计算制造相同结果的装置,而不是 改变答案含义的功能。在长对话或长代码生成中,KV cache 为什么会连接到体感速度,也能用这个标准解释。
KV cache 为什么重要
在对话式生成中,模型先生成一个词元,再继续生成下一个词元。此时,如果每次都从头重新做先前计算,就非常低效。
KV cache 可以理解为一种装置:它复用前面已经计算过的一部分 attention 相关值,让下一个词元生成得更快。
把这个标准压缩成一句话,就是:
在保持相同结果的同时,什么不应该重新计算?
context window 越长,重复生成的负担也越大,所以 KV cache 尤其容易在长对话或长代码生成中连接到体感速度。
把这个说明换成生活场景会更清楚。继续写一段很长的消息对话,或者一边看长代码文件一边继续生成下一行时,人通常会觉得自己是 记着前面已经看过的内容继续写。所以也容易期待响应能以差不多的速度继续。但如果模型每生成一个新词元,都要把之前看过的所有词元从头按同样方式重新计算,那么对话越长,生成下一个词元的负担也会一起变大。
也就是说,第一次阅读 KV cache 时,可以这样抓住。
生成新词元时,前半部分是否完全从头重新计算?- 还是
把前面已经计算过的一部分保存下来,只加上新需要的部分?
KV cache 更接近第二种。核心不是 改变意义的新智能,而是 避免重新计算已经看过的前半部分的复用装置。
有了这个标准,才不容易把 KV cache 误解成 让模型理解得更好的功能。首先要看的不是 答案是否更聪明,而是 为了生成相同答案,重复计算减少了多少。
什么改变,什么不改变
第一次阅读 KV cache 时,最重要的区分是把 模型是否更聪明和 同样的计算是否少重复分开。
KV cache 首先改变的不是答案的含义或推理能力,而是得到同样答案之前所需的重复计算量。对话越长,先前词元数越多;如果每次都把前半部分重新投影成 key 和 value,那么生成每个新词元时负担都会变大。cache 会保存这段前半部分计算,把流程改成只追加新接上的词元所需的计算。
因此,开启 KV cache 后答案会更准确吗、会突然做出更聪明的推理吗、关闭就错、开启就对吗这类问题,稍微偏离了核心。更稳妥的标准是,把 答案内容和 生成答案之前的重复工作量分开看。
也就是说,理解 KV cache 时,要同时看 输出了什么答案和 为了做出这个答案,前半部分被重新计算了多少次。
为什么 context window 越长体感差异越大
说 KV cache 在长上下文中特别重要时,人们有时只会理解成 长上下文本来就慢。但这里有更具体的理由。
文脉较短时,前面已经看过的词元数本身不多,所以重新计算前半部分的负担可能相对小。相反,当对话变长或长代码生成持续进行时,每生成一个新词元,已经经过的前半部分也会一起变长。没有 cache 时,前面已经看过的长 prefix会在每个新词元上被反复重新计算。
这个差异可以这样理解。
- 短文脉:需要重新计算的前半部分还很短
- 长文脉:需要重新计算的前半部分已经很长
- 所以文脉越长,
前半部分是否不再重做带来的体感差异越大
也就是说,context window 越长 KV cache 越重要,并不是说 它能更好理解长输入,而更接近于 不反复重新计算已经看过的长前缀,其价值会变大。
案例和示例
案例 1. 聊天式代码助手逐渐变慢
想象一个代码助手围绕同一个代码文件连续进行多个回合。人会期待它一直看着同一个文件,下一次回答也能以类似速度继续。但如果每次都从头重新计算先前词元关系,回合越长,响应延迟就可能越明显。
生成第一条回答时,前文较短,所以差异可能不明显。但如果文件说明、函数修改、测试失败日志、再次修改请求累积了几轮,那么 生成当前新回答之前已经经过的前半部分就会变长。没有 cache 时,这段长前文必须在每个下一词元上重新计算;有 cache 时,已经计算好的前半部分会被保存,只追加新需要的部分。
这个案例要确认的结果是:对话越长,cache 复用与否是否会显现为体感延迟差异。要抓住的标准,是不要把 对话变长为什么变慢读成 模型累了,而要换成 是否每个新词元都重新计算已经看过的前半部分这个问题。
案例 2. 基于长文档持续生成草稿
想象放入一份长政策文档,先生成摘要草稿,再润色草稿,接着只解释例外条款。因为一直参考同一份文档,人很容易期待速度大体保持类似。但如果每次都从头重新计算之前看过的词元,文脉越长,下一 step 的负担也会越大。
草稿生成如果不是一次结束,而是像 摘要 -> 润色 -> 再解释特定例外这样继续,实际会在多个 step 中反复参考相似的长前文。这里重要的不是 长时间参考文档是否让模型更聪明,而是 是否避免反复重新计算同一段长前文。
这个案例要确认的结果是:同一文脉持续被使用时,复用装置为什么更重要。KV cache 的实用价值,比起放入长文档的那一刻,更清楚地出现在基于该文脉的生成累积多个 step 时。
从失败场景重新看判断标准
要让前面的说明更扎实,一起看 KV cache 试图避免的失败场景会更有帮助。
| 先看到的失败场景 | 从 KV cache 视角重新读的问题 | 为什么重要 |
|---|---|---|
| 对话越长,答案越慢 | 已经看过的长 prefix 是否在每个新词元上又被计算? | 因为重复计算会累积 |
| 长代码生成中,前半部分越长,下一行生成越卡 | 已经计算过的前半部分是否被保存? | 因为每一行都会增加前文重新计算负担 |
| 长文档草稿修改持续进行时速度下降 | 同一文脉持续使用时,是否有复用装置? | 因为相似的长文脉会在多个 step 中重新被看见 |
这张表的目的不是用 KV cache 解释所有速度问题。它只是让人在看到 越长越慢这种现象时,先想起 结构是否在反复重新计算已经看过的前半部分。
练习和示例
这个例子的目标是展示:KV cache 实际保存什么,以及生成越长时它能阻止多少重新计算。我们把词元 ID 通过小型嵌入和 query/key/value 投影,确认最后词元的 attention 结果无论是否使用 cache 都相同,但重新投影量会减少。接着还会改变 prefix 长度,看看节省幅度如何变化。
核心比较如下。
- 没有 cache 时,每生成一个新词元,都要把到目前为止的所有词元重新转换成 K/V。
- 有 cache 时,先前词元的 K/V 会保存下来,只追加新词元的 K/V。
- 两种方式的最后 attention 输出应该相同。改变的是
重新计算了多少。
下面代码使用已经看过的 prefix 词元和接下来生成的新词元。结果中要一起确认:没有 cache 时每个 step 重新计算的 K/V 矩阵 shape 和最后词元 attention 结果;使用 cache 时维持的 K/V cache shape 和最后词元 attention 结果;两种方式在每个 step 的 projection 对象词元数;总 projection 对象词元数和节省比例;prefix 长度改变时,重新投影节省比例如何变化。
要确认的核心是:KV cache 通过复用先前词元的计算结果,减少后续 step 的 projection 负担。attention 结果不会因为有没有 cache 而改变;为了制造同样结果而重新投影的词元数会改变。prefix 越长,或生成 step 越多,不重新计算前半部分的效果越明显。
下面的图先压缩了这个例子要比较的计算流程。没有 cache 时,每生成一个新词元,都要把前半部分重新变成 K/V;有 KV cache 时,已经看过的 prefix 的 K/V 会被保存,只追加新词元的 K/V。
flowchart TD
  A["已经看过的 prefix 词元"]
  B["没有 cache<br/>重新投影整个 prefix"]
  C["有 KV cache<br/>复用已保存的 K/V"]
  D["只追加新词元的 K/V"]
  E["相同的最后 attention 结果"]
  F["减少重复 projection 工作"]

  A --> B
  A --> C
  C --> D
  B --> E
  D --> E
  D --> F
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 | |
下面的输出已用本地 .venv 的 Python 按正文代码确认了相同数值。
执行结果示例可以这样阅读。
这个例子要读出的核心如下。
- 两种方式在相同 step 的
attention_weights和context都一致。 - 也就是说,KV cache 不是为了改变最后 attention 结果,而是
用更少重新计算制造相同结果的装置。 - 差异在于是否重新投影前面已经看过的 prefix 词元的 K/V。
- 没有 cache 时,第一个新词元要重新投影 4 个词元,第二个新词元要重新投影 5 个词元;有 cache 时,每个新词元只追加投影 1 个词元。
- 同样生成 5 个词元时,prefix 为 20、100 时的
without_cache与with_cache差距,比 prefix 为 3 时大得多。 - 因此 prefix 越长,或生成 step 越多,
projected_token_count差异会迅速变大。
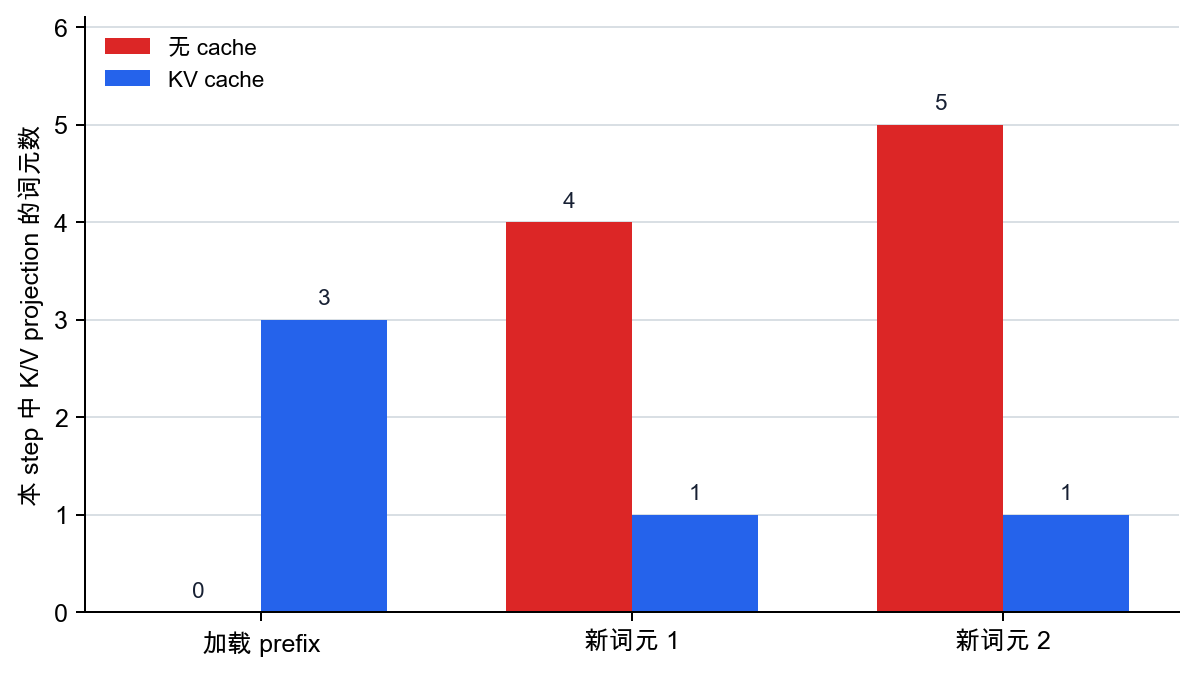
把 prefix 长度带来的重新投影量差异画出来,会像下面这样拉开。没有 cache 时,已经看过的 prefix 越长,每个新词元需要重新投影的量会快速增加;使用 KV cache 时,在相同条件下增长幅度要小得多。
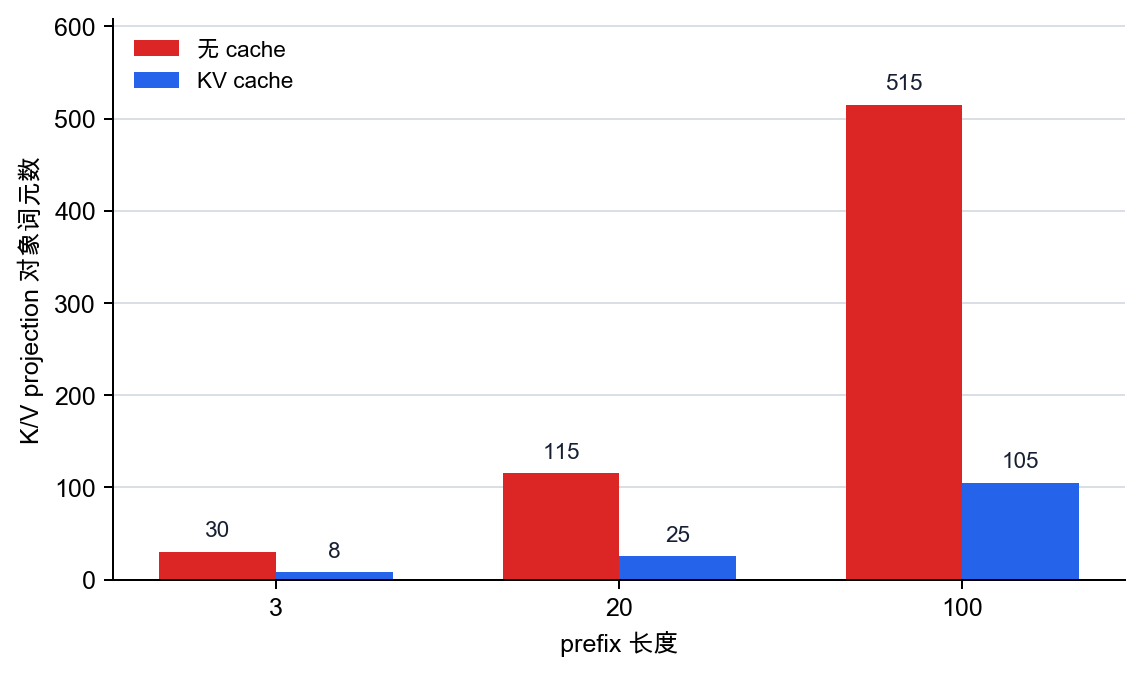
这里比起数字本身,更重要的是阅读比较方向。
是否得到了相同 context?重新计算的词元数差了多少?前文更长时,这个差异是否会继续变大?- 把
generated_length从 5 改成 20 时,节省比例和总重新投影量会怎样改变?
如果能回答这些问题,就已经开始把 KV cache 读成 长生成中不再重复计算同一前半部分的实用装置,而不是只读成 模型内部的困难名称。
检查清单
- KV cache 是在长生成中减少重复计算成本的实用装置。
- KV cache 与其说改变模型含义,不如说用更少重新计算制造相同结果。
- 在长对话和长代码生成这类文脉不断累积的场景中,KV cache 的体感价值会变大。
- 应该能够把 KV cache 和长上下文设计问题区分为
通过复用减少的计算和长输入中必须维持的线索。
来源和参考资料
- Ashish Vaswani et al., Attention Is All You Need, NeurIPS 2017, 确认日期:2026-07-19。作为 attention 中 query、key、value 计算的基本背景依据,用于说明 KV cache。
- Hugging Face, Cache strategies, Transformers documentation, 确认日期:2026-07-19。作为依据,用于说明 autoregressive generation 会保存 key-value vectors 来减少重新计算并提升生成性能。