P6-4.5 补充学习:长上下文与稀疏 attention
Section ID:
P6-4.5Version:v2026.07.26
副标题:sparse attention 与 long-context 如何区分计算负担和线索保留
在 P6-4.2 中,我们看过 attention 与 context window 会连接到输入范围限制;在 P6-4.4 中,我们整理了 KV cache 是在重复生成中处理“哪些内容不再重新计算”的装置。现在剩下的问题在另一侧。
处理长输入时,真的必须保留所有连接吗?
沿着这个问题阅读时,经常会看到 sparse attention 和 long-context 这两个名称。二者都与长输入问题有关,但并不是同一个技术名称。这里我们把它们放在 长上下文的计算与维持问题 这个大背景下,分别阅读 如何减少连接数量 和 如何在长上下文中把关键线索保留到最后 这两个不同层位的问题。
长上下文中剩下的计算负担
- sparse attention 想减少什么?
- long-context 为什么常被单独命名?
- 为什么这两个名称不是同一个技术名,而是分别指向
连接数量调节与长上下文整体设计这两个不同层位的问题?
这里首先要关上的问题,是不要把 长输入问题 压缩成一个词,而是把它拆成计算负担和线索维持两个问题。
| 这里处理的内容 | 留给后续章节或后续 Part 的内容 |
|---|---|
| 不把所有连接都以相同密度查看的 sparse attention 方向 | 具体架构比较与最新 benchmark 竞争 |
| 即使输入很长,也要把前面线索维持到后面阶段的 long-context 问题 | 实际 RAG、运营策略、长上下文产品设计选择 |
只有先抓住这个区分,才能把 sparse attention 说明为 不以相同密度维持所有连接的方向,把 long-context 另行说明为 实际维持并重新参考长输入的整体设计问题。
sparse attention 想减少什么
如果把基本 self-attention 读得非常简单,每个 token 会与许多其他 token 计算相关度。上下文越长,比较数量就越快增加,于是自然会出现下面的问题。
真的每次都要以相同密度仔细查看所有位置吗?
sparse attention 是回答这个问题的一种方向。
- 更密集地查看附近邻居
- 只选择一部分较远的位置
- 按既定规则减少连接,从而降低计算负担
也就是说,sparse attention 更接近 不维持所有连接的相同密度,而不是 丢掉 attention。
这个句子最好再展开一次。非常简单地说,基本 self-attention 接近于 当前位置把其他所有位置都看一遍 的感觉。句子很短时,这个图景不会太沉重。但如果输入变成长达数千行的日志、很长的代码文件、很长的合同时,当前位置需要检查的其他位置数量 也会快速增加。sparse attention 正是在这时追问:是否真的每次都要平等地检查所有位置。
因此,第一次阅读 sparse attention 时,可以这样理解。
- 它不是
把所有连接都去掉。 - 它更接近
哪些连接必须保留,哪些连接可以少看一些,或按规则减少。 - 核心是调节
连接密度,降低计算负担。
有了这个标准,才不容易把 sparse attention 误解成 粗略阅读上下文的技术。真正关心的是 能否在减少不太重要的比较时,仍然保留必要连接。
long-context 为什么被单独命名
long-context 常常比 输入很长 这句话有更宽的含义。核心不只是模型能否放入更长文档,还包括它能否在这个长输入中同时维持前面的线索和后面的线索,并在需要时重新参考它们。
long-context 通常把下面这些问题一起叫出来。
- context window 数字变大的问题
- 在长输入中更少丢失重要线索的问题
- 在这个过程中成本、延迟、内存负担一起变大的问题
也就是说,long-context 不是 炫耀长度,而更接近 实际处理长上下文的整体设计。
这个句子也可以换成场景来读。阅读 3 页合同时,把前面的定义条款重新连接到后面的例外条款还比较容易。但阅读 300 页文档时,单纯知道 可以放入很多页 并不充分。前面的定义是否真的会在后面的例外处重新连接,中间出现很多不必要内容时关键线索是否不会变弱,处理这样长输入的成本和延迟是否可承受,这些都会一起留下来。
因此,long-context 不是单纯夸耀 window 数字很大的模型 的名称。更准确地说,它是把下面这些问题合在一起的名称。
- 长输入能否进入计算?
- 进入计算后,前面线索和后面线索是否真的能一起维持?
- 这个维持过程在成本和延迟上是否可承受?
换句话说,long-context 不是 接收更长输入的一个功能,而更适合看成 在实际任务中把长上下文维持到最后的一组设计问题。
为什么不能把 sparse attention 和 long-context 看成同一个词
第一次看到这两个名称时,它们都像是 解决长输入问题的技术,所以很容易被归成一类。实际上,二者也确实都与长上下文问题有关,因此并非完全无关。但它们并不是直接指向同一个问题。
更安全的区分如下。
- sparse attention 先问的是
连接要维持得多密。 - long-context 先问的是
在整个长输入中,重要线索是否真的能维持到最后。
也就是说,sparse attention 可以是帮助 long-context 的一个方向,但它并不等于 long-context 的全部。减少连接数量,并不会自动解决关键线索维持问题。反过来,思考维持长上下文的设计,也不意味着一定只使用 sparse attention。
把这个差异抓得最短,可以写成下面这样。
| 先问的问题 | 更直接连接的名称 | 为什么不同 |
|---|---|---|
真的需要仔细查看所有位置吗? | sparse attention | 因为这是比较数量和连接密度的问题 |
前面的线索是否真的能活到后面的工作中? | long-context | 因为这是在整个长输入中维持关键线索的问题 |
成本降低后,关键线索是否也一起变弱了? | 二者都有 | 因为计算节省与线索维持会同时纠缠在一起 |
这个表的目的不是把两个名称完全切开。相反,它要留下的是 二者相互连接,但不是同一层位 的感觉。
sparse attention 与 long-context 的差异
| 名称 | 先提出的问题 | 作用 |
|---|---|---|
| sparse attention | 真的需要仔细查看所有 token 对吗? | 通过减少连接数量来降低计算负担的方向 |
| long-context | 即使输入很长,前面的线索也能维持到后面吗? | 处理长上下文的整体设计问题 |
有了这个区分,就能减少 sparse attention 是不是去掉 attention、long-context 是不是只是长度数字 这类误解。
下面的图示展示同一个 长输入问题 如何分成两个问题。sparse attention 主要接近 要减少多少用于比较的连接,long-context 则接近 如何把必要线索保留到最后。
flowchart TD
  A["长输入问题"]
  B["计算负担<br/>token 比较过多"]
  C["线索保留<br/>前面的关键线索变弱"]
  D["sparse attention<br/>降低连接密度"]
  E["long-context 设计<br/>把必要线索保留到最后"]
  F["实际处理长文档"]

  A --> B
  A --> C
  B --> D
  C --> E
  D --> F
  E --> F
案例与示例
案例 1. 需要 sparse attention 的长日志分析
想象一下,正在阅读数千行系统日志并寻找故障原因。起初很容易觉得 把所有行彼此全部比较最安全。但在实际中,往往只要密集查看相邻时间段的日志,再远距离回看几个关键错误代码或会话切换点,就已经足够。
人阅读日志时,通常也不会把每一行都与每一行比较。相反,会先像下面这样缩小范围。
- 先把同一时间段的连续日志合在一起看。
- 重新寻找相同 session ID 或相同 error code。
- 只把状态发生变化的点重新查到较远位置。
这里变化的标准,是从 所有行都以相同权重查看 移到 保留核心连接,同时减少不必要比较。sparse attention 也与这种感觉相通。需要检查的结果不是 是否什么都不看,而是 能否在保留必要连接的同时减少不重要的比较。
案例 2. 需要 long-context 的合同阅读
想象一下,在审阅一份长合同时,不能漏掉前面的定义条款和后面的例外条款。文档越长,重要的就越不是 放入了多少页,而是 前面的定义和后面的例外是否在同一个任务中重新连接。
假设合同开头定义了 服务中断,而后面的附件写着 定期维护不视为中断 这一例外。文档越长,危险的失败就不只是 文档放得不够多。即使已经放入相当长的文档,如果前面的定义没有活到阅读后面例外的时刻,审阅结果仍然可能出错。
所以 long-context 案例中的标准,比起 放入了多少页,更应是 前面的线索是否真的延续到后面的判断。需要检查的结果是,即使文档长度变长,早期定义和后面例外是否真的一起存活。
把两个案例放在一起,也能整理一个常见误解。context window 数字变大时,人很容易觉得 long-context 问题会自动解决。但即使输入长度变长,如果关键线索没有维持到后续工作,长上下文设计问题仍然存在。反过来,降低计算负担的方式可以帮助处理更长输入,但不能仅凭这一点就立刻得出 关键线索会很好地维持到最后 的结论。
也就是说,这里最需要警惕的误解是 只要长度数字变大,长上下文问题就结束了。sparse attention 主要问 要减少多少比较,long-context 则问 重要的东西是否留到了最后。
从失败场景重新看标准
一开始,计算负担、长度数字、关键线索维持很容易在 长输入问题 这个表达下混在一起。此时,与其继续背名称定义,不如先区分当前失败场景首先在问什么。
| 现在首先可见的场景 | 先提出的问题 | 更直接连接的对象 |
|---|---|---|
| 输入越长,响应越卡,需要比较的位置数量看起来太多 | 真的在以相同密度查看所有位置吗? | sparse attention |
| 文档放得很长,但前面的定义或例外在后面判断时经常变弱 | 关键线索是否真的活到了后续阶段? | long-context |
| context window 数字变大了,但重要的前面线索仍然变模糊 | 是不是把装下很多内容的问题和把重要内容留到最后的问题混在一起了? | long-context |
| 既要减少计算负担,又不能漏掉远处的关键线索 | 现在更急的瓶颈是比较数量、线索维持,还是二者都有? | 二者都有 |
这个表的目的不是把 sparse attention 和 long-context 完全分离。它是为了让我们在看到实际失败场景时,先把 要维持多少连接 和 重要线索能抓住多久 分开阅读。
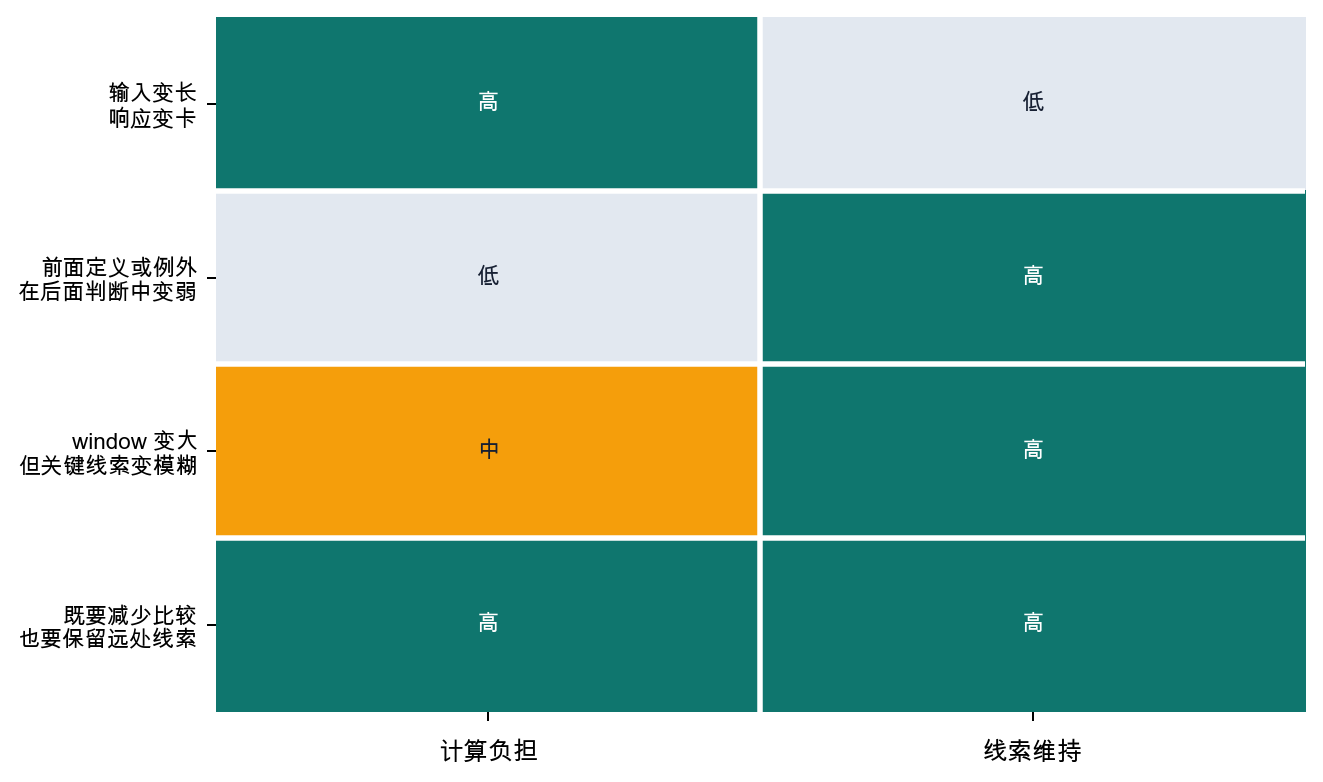
看到这个区分,也能同时看出两个名称在哪里相接。长输入中,计算负担与线索维持很容易同时纠缠。但 要减少什么 和 要把什么保留到最后 仍然是不同的问题。
练习与示例
请阅读下面的场景,把问题分成 计算负担 和 线索维持 来标记。
假设把长故障日志和部署文档一起放入模型,用来寻找原因。日志有数千行,部署文档前半部分说明了 token signature method change,后半部分写有 old-version sessions are allowed for 30 minutes 这个例外。若不希望模型变慢,就需要一种不必以相同密度比较所有日志行的结构;若不希望答案出错,前面的变更说明和后面的例外条件就必须一直保留下来。
这里 sparse attention 侧的问题是 是否必须以相同密度比较所有日志行和文档片段。long-context 侧的问题是 前面的签名方式变更和后面的例外条件,是否真的保留到原因判断时刻。如果两个问题同时可见,那么当前场景就与 二者都有 相连。
这里最好再追问自己一次。
- 我现在笼统称作
长输入问题的东西,是计算负担问题吗? - 还是关键线索维持问题?
- 还是两个问题同时混在一起?
如果能先提出这些问题,就能大幅减少把 sparse attention 和 long-context 读成同一个技术名称的错误。
检查清单
- sparse attention 是不以相同密度维持所有连接,从而减少计算负担的方向。
- long-context 指的是实际维持并重新参考长输入的整体问题。
- 减少连接数量和良好维持长上下文不是同一个问题。
- 仅仅让 context window 数字变大,并不会自动解决 long-context 问题。
来源与参考资料
- Ashish Vaswani et al., Attention Is All You Need, NeurIPS 2017, 确认日期:2026-07-19。用于说明基本 self-attention 会计算输入位置之间关系这一出发点。
- Rewon Child et al., Generating Long Sequences with Sparse Transformers, arXiv 2019, 确认日期:2026-07-19。用于支撑通过 sparse factorization 减少 attention matrix 计算负担以处理长序列的方向。
- Manzil Zaheer et al., Big Bird: Transformers for Longer Sequences, NeurIPS 2020, 确认日期:2026-07-19。用于支撑通过 sparse attention 降低 full attention 对 sequence length 的依赖负担,并处理更长输入的研究脉络。
- Iz Beltagy, Matthew E. Peters, Arman Cohan, Longformer: The Long-Document Transformer, arXiv 2020, 确认日期:2026-07-19。用于支撑以 local window attention 和 task-motivated global attention 处理长文档任务的 long-document Transformer 案例。