P6-5.1 从 decoder 基础的累积生成结构看 GPT 系列
Section ID:
P6-5.1Version:v2026.07.26
到这里为止,我们已经从 LLM 视角重新阅读了 Transformer,并确认了 context window 和 attention 的约束。现在,即使在同一个 Transformer 系列内部,也需要区分 读取输入的流程 和 持续接着生成的流程。
如果只把 GPT 系列读成产品名称,就容易错过这个系列为什么会成为生成式 LLM 的代表性路径。这里我们把 GPT 读成 以 decoder 为中心的生成流程,并先区分它与 BERT 那种读取整个输入后再作判断的流程有什么不同。
持续接着生成的模型,在 Transformer 系列内部位于哪里?GPT 系列是以 Transformer 的 decoder 为中心,查看先前 token 上下文,预测下一个 token,并通过重复这个过程生成长文本的流程。
decoder 基础的顺序生成结构
顺序生成结构从下面的问题开始。
- GPT 系列在 Transformer 内部处于什么位置?
- 为什么 GPT 看起来像
持续接着生成的模型? - 与 BERT 系列相比,最大的不同是什么?
只要先抓住 GPT 的生成结构,pretraining、next-token prediction、instruction tuning、alignment 问题也都可以在同一条流程上阅读。也就是说,这里需要的不是产品谱系,而是把 GPT 看作 decoder 基础生成结构 的标准。
我们不把 GPT 当作产品名称,而是从 decoder 基础生成模型 这个结构位置来阅读。因此,首先要抓住的不是 著名模型名称,而是 为什么 GPT 会被读成顺序生成结构。
| 现在阅读的内容 | 后续会扩展的问题 |
|---|---|
GPT 为什么在 Transformer 系列中被读成 持续往后写的生成流程 | pretraining 如何扩大这个结构 |
| 如何从输入阅读和顺序生成角度区分 BERT 与 GPT | instruction tuning、alignment、商用模型版本差异还会改变什么 |
这一节在 Part 6 主线请求流程中的作用,是展示 Transformer 计算引擎如何变成 持续往后写的生成流程。这个结构先立住,才能在 P6-7.1 的 next-token prediction 和 P6-8.1 的 pretraining 中,不直接跳到用户体验,而是在计算流程上继续阅读。
decoder 基础累积生成的区分
- 可以把 GPT 系列说明为以 decoder 为中心的 Transformer 流程。
- 可以说明 GPT 为什么与 next-token prediction 直接相连。
- 可以从
阅读整句对顺序生成的角度说明 BERT 与 GPT 的差异。 - 可以说明改变用户体验的调节层可以附加在这个生成结构之上。
必须把 GPT 理解成生成结构,才能解释为什么用户用自然语言写下请求并得到结果的体验成为可能。不过,GPT 的顺序生成结构和对话式 LLM 的用户体验并不是同一层位。GPT 是基于先前 token 追加下一个 token 的结构;对话体验则是在这个结构之上加入遵循指令、角色、安全约束、界面之后形成的。
顺序生成结构的比较标准
如果不把 GPT 读成产品名称,而是读成顺序生成结构,就需要区分四个层位。
| 需要区分的层位 | 要确认的标准 |
|---|---|
| 结构位置 | 能否把 GPT 读成以 decoder 为中心的 Transformer 流程,而不是 encoder 流程 |
| 生成方式 | 能否不用“输出完成句子”,而用重复 next-token prediction 来说明 |
| 比较标准 | 能否把它与 BERT 的差异区分为读取整个输入与继续写出输出 |
| 实际场景 | 能否在案例中确认早期选择会持续推动后面的生成路径 |
GPT 是什么的缩写
GPT 是 Generative Pre-Trained Transformer 的缩写。名称里已经包含三个核心。
- Generative
- Pre-Trained
- Transformer
也就是说,它表示:
- 以生成(generation)为目标
- 先在大规模数据上做预训练(pretraining)
- 使用 Transformer 结构
为什么 GPT 会被读成 生成模型
GPT 系列通常被说明为 autoregressive language model 流程:查看先前 token,然后预测下一个 token。
例如,假设输入如下。
今天会议在下午
模型会在这里预测下一个候选。
三点两点一点
选择其中一个之后,再把这个新 token 包含进去,重新预测下一个 token。
也就是说,GPT 系列的核心感觉如下。
它不是一次拿出完成句子,而是不断接着预测下一个 token 来生成输出。
为什么说它以 decoder 为中心
如 Part 6 前面所见,Transformer 可以分成 encoder、decoder、encoder-decoder 结构来阅读。
把 GPT 系列看作其中的 decoder 中心流程会更安全。
这个结构的核心是:
- 查看到目前为止的上下文
- 在当前位置生成下一个 token
- 设置符合生成方向的 attention 约束
可以这样理解。
GPT 与其说是一次读完整个句子后作判断的模型,不如说是基于前面已经写出的内容继续往后写的模型。
与 BERT 相比有什么不同
再整理如下。
| 区分 | BERT 系列 | GPT 系列 |
|---|---|---|
| 中心结构 | encoder | decoder |
| 基本感觉 | 读取整个输入上下文并生成表示 | 基于先前 token 生成下一个 token |
| 代表使用流程 | 分类、搜索、embedding | 生成、对话、摘要、草稿撰写 |
| 输出性质 | label、score、representation | 新 token、新句子、新段落 |
这个表的核心如下。
BERT 更自然地位于读取输入并判断的一侧,GPT 更自然地位于持续接着生成输出的一侧。
为什么 GPT 系列大幅改变了用户体验
GPT 系列在结构上适合生成。因此,用户可以用自然语言向模型写请求,模型则接着生成很长的回应。
例如:
- 撰写问题答案
- 撰写邮件草稿
- 摘要文档
- 代码自动补全
- 基于角色的对话
这些体验都可以用 下一个 token 生成的重复 来说明。
也就是说,从技术上看,GPT 系列是 next-token prediction 模型;但从用户角度看,它像是 不断替你写句子的界面。
极简画出来
flowchart TD
  A["上下文 token"]
  B["预测下一个 token"]
  C["追加 token"]
  D["以更长上下文重复"]

  A --> B
  B --> C
  C --> D
这个图示中要确认的结果是:GPT 系列不是一次拿出完成句子的结构,而是基于前面的 token,反复接上下一 token 候选的生成结构。
案例与示例
下面的图示不是按 生成结果是什么,而是按 初始 token 选择如何推动后面的路径 这个共同问题,重新捆起本节的三个案例。
flowchart TD
  A["同一个下一个 token 问题"]
  B["撰写邮件草稿<br/>第一句话会定下什么语气?"]
  C["撰写摘要<br/>第一句会抓住什么焦点?"]
  D["生成代码<br/>哪些早期 token 会限制后面结构?"]

  A --> B
  A --> C
  A --> D
这个图示中要确认的是,即使任务不同,生成的感觉也相似。它们都有 现在选出的 token 或句子会成为后续输出的下一段输入的一部分 这一结构,因此早期选择会持续推动整个后续路径。
案例 1. 自动补全
当用户只写到 会议是明天下午 时,很容易觉得模型一次想出了整个句子。但在实际自动补全中,模型会先摆出 两点、三点、四点 这样的下一候选,选择其中一个之后,再继续计算下一 token 候选。也就是说,模型不是把完成句子整体拿出来,而是查看已经出现的 token,按顺序接上最可能出现的下一 token。
这里变化的是:不再期待 一次完成的句子,而是看见 前面选择会持续推动后面句子的结构。如果前一阶段选错了时间,后面整句也会以这个时间表达为基准继续下去。
例如,如果先选择的是 下午四点 而不是 下午三点,后面的会议室通知或参会请求也可能以那个时间为前提继续展开。这里需要纠正的误解是 早期一个词之后很容易被覆盖 的感觉。
所以,这个案例中要确认的结果是:如果最初几个 token 选择变了,后面整句是否也会跟着改变;以及早期选择是否真的锁住后面句子的方向。
案例 2. 摘要草稿撰写
用户放入很长的会议记录,并要求 用三句话总结 时,很容易以为摘要整体先被确定,然后照原样输出。但在内部,会先生成第一句,而这句话本身又成为下一段输出的上下文一部分,第二句和第三句再接着生成。也就是说,摘要最终也是建立在不断接续 next token 的生成结构之上。
这里变化的是:比起 摘要结果一次决定 的感觉,更要看见第一句选择会连锁决定后面句子的方向。如果第一句抓错了核心,后面的句子也可能继承这个错误焦点,使整个摘要方向偏掉。
例如,如果第一行错误断定 部署日程已经确定,那么实际中心是延期讨论的会议,也可能在后续句子中继续强化这个错误结论。这里要纠正的误解是 第一句稍微偏了,后面会重新找回平衡 的期待。
所以,这个案例中要确认的结果是:第一句焦点一旦摇晃,后面的摘要句子是否也会向同一方向连锁倾斜;以及早期断定是否连后面句子的强调顺序也会改变。
案例 3. 代码生成
开发者可以给出函数名、输入说明、期望行为,并请求实现。代码生成也容易让人感觉像是一次拿出完整答案块,但实际上,函数定义、缩进、条件语句、返回语句都是按 token 顺序接续的。因此,前面错误生成的变量名或条件式会持续影响后面的代码。
这里变化的是:比起期待 一次完成的代码,更应先看到一个早期 token 会拉动后面的整个结构。例如,如果一开始把 user_id 错抓了,后续查询、异常处理、返回语句都可能连锁沿着同一个错误走。
即使只是一个括号错位,也可能让后面整个 block 以语法错误崩掉,这一点也展示了同一结构。这里要纠正的误解是 早期变量名或条件式只是小选择 的感觉。
所以,这个案例中要确认的结果是:早期 token 选择错误是否会连锁摇晃后续代码的变量名、分支、语法;以及前面一个选择是否真的固定了后面多行。
把三个案例用累积生成视角重新捆起,可以得到下表。
| 情况 | 早期选择特别强地推动什么 | 后面一起摇晃的内容 |
|---|---|---|
| 自动补全 | 时间、主题等第一个表达 | 后面整句的展开 |
| 摘要草稿撰写 | 第一句的焦点 | 后续摘要句子的强调顺序 |
| 代码生成 | 变量名、条件式、括号结构 | 分支、返回、语法稳定性 |
累积生成结构显露出来的场景
读完这一节之后,即使还不了解 next-token prediction 或 instruction tuning 的细节,也可以先像下面这样练习区分 现在看到的场景是否是 GPT 的累积生成结构问题。
| 现在看到的场景 | 容易先想到的误解 | 先换成什么问题 |
|---|---|---|
| 句子第一个表达改变后,后面说明的语气和流程也一起改变 | 容易觉得模型已经一次定好了整句 | 这是前面 token 选择持续改变后面候选路径的结构吗 |
自动补全很自然,但 用三句话回答 这种格式经常违反 | 容易觉得 GPT 结构只要变大,聊天机器人体验也会立刻解决 | 现在卡住的是生成结构问题,还是对话式调节层问题 |
| 长代码生成中,前面一个变量名摇晃了后面的分支和返回语句 | 容易觉得前面错误会在后面轻易覆盖 | 早期 token 选择是否实际固定了后面的代码结构 |
这个表里重要的不是把 GPT 作为产品名称背下来,而是把 前面生成的内容会成为后面输入的一部分 这个结构套回具体场景。
这里经常混在一起的也有两点。
- 容易把 GPT 的累积生成结构和对话式调节层捆成同一个问题。
- 容易低估前面一个 token 的选择会多强地推动后面整条路径。
- 容易把自动补全、摘要、代码生成看成彼此不同的魔法,却错过它们其实都位于同一个顺序生成结构之上。
因此,本节的收束点,是把 GPT 是持续接着写的生成结构 这句话转成实际案例中的区分标准。
这个区分的目的不是一次确定原因。它是为了不把情况压成 GPT 很奇怪 一句话,而是短暂区分眼前现象首先来自 顺序生成结构,还是首先来自 对话式调节层。
练习与示例
这个例子的目标,是确认 GPT 系列生成不是 一次拿出完成句子,而是查看目前为止的 token 序列并反复选择下一个 token 候选的结构。尤其要直接看到,第一选择一旦改变,后面的候选表和最终句子流程也会一起改变。
下面的代码使用起始 token 序列、根据当前最后 token 改变的下一 token 候选表、以及第一选择不同的两条生成路径。结果中会确认每条路径的逐 step 当前上下文、下一 token 候选与分数、累积分数合计,以及第一选择改变时累积生成结果如何分岔。
要确认的核心是:在 autoregressive generation 中,一个早期选择会大幅分开后面的候选路径和最终句子。
下面的输出,是用本地 .venv 的 Python 执行正文代码后确认的相同数值。
执行结果示例可以这样阅读。
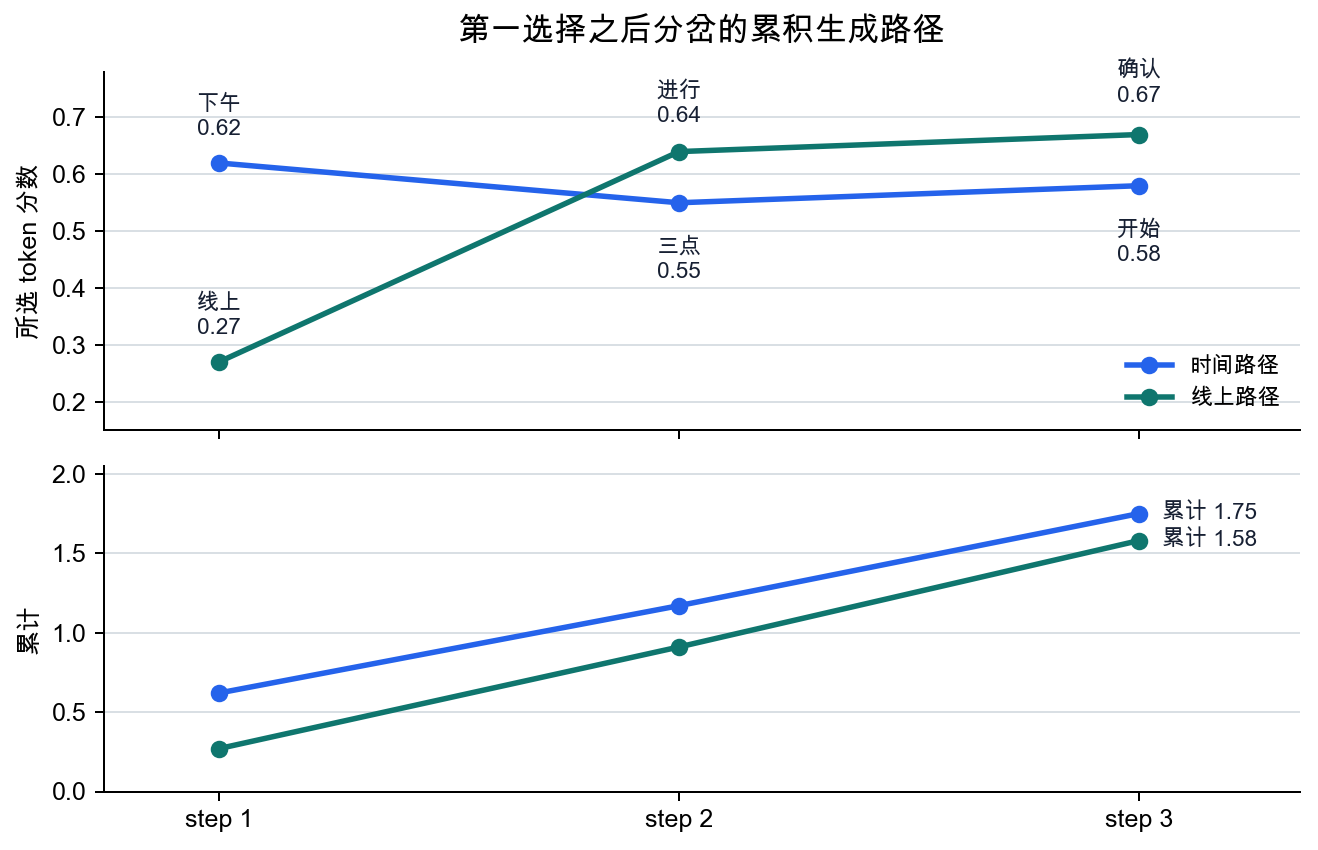
所以,这个例子中要确认的结果是:生成不是一次拿出完成句子,而是先前输出会改变下一候选群,并逐 token 累积。尤其是第一选择为 下午 还是 线上,从第二个候选表开始就已经不同,cumulative_score 也沿着不同路径累积。GPT 系列生成在这个意义上,更准确地说,是 前面选择会持续推动后面路径与累积分数流动的结构。
累积生成路径分岔的地点
前面的例子不是实现 GPT 的代码,而是最短地展示:生成不是 一次拿出完整句子,而是 先前输出成为下一输入的一部分的累积过程。这里要阅读的核心,是在句子质量之前,生成本身就是一步步接上的结构。
GPT 系列之所以重要,是因为 Transformer decoder 基础生成模型最终接上了改变实际用户界面的流程。
从历史上看,重要地点如下。
- generative pretraining 显示它可以迁移到多种任务
- 模型规模越大,zero-shot、few-shot 使用体验越明显
- 为后来的 instruction tuning 和对话式界面打下基础
如果把这个例子重新压缩成判断标准,下面三个问题应该先浮现出来。
| 场景 | 要先回答的问题 |
|---|---|
| 第一个表达为什么会推动后面整句 | 这是先前输出成为下一输入一部分的累积生成结构吗 |
| 为什么自动补全能做到,但像聊天机器人那样遵守格式却做不好 | 是否把生成结构和对话式调节层分开看了 |
| 为什么只把 BERT 和 GPT 归为同一个 Transformer 还不够 | 是否看见了比读取整个输入更强调顺序生成的结构差异 |
检查清单
- 能否把 GPT 说明为
先前输出成为下一输入一部分的累积生成结构? - 能否按结构和任务标准重新区分 BERT 与 GPT?
- 是否准备好区分生成结构和对话式调节层来阅读后续说明?
来源与参考资料
- Alec Radford et al., Improving Language Understanding by Generative Pre-Training, OpenAI 2018, 确认日期:2026-07-19。用于支撑 GPT 的 Generative Pre-Training 名称、Transformer decoder 基础 language model、next-token conditional probability 说明。
- OpenAI, Improving language understanding with unsupervised learning, 确认日期:2026-07-19。用于支撑早期 GPT 研究通过结合 Transformer 与 unsupervised pre-training,在多种语言任务上展示迁移的背景。
- Alec Radford et al., Language Models are Unsupervised Multitask Learners, OpenAI 2019, 确认日期:2026-07-19。用于支撑 GPT-2 作为 Transformer 基础 language model 的规模扩展和 zero-shot task transfer 脉络。
- Tom B. Brown et al., Language Models are Few-Shot Learners, arXiv 2020, 确认日期:2026-07-19。用于支撑 GPT-3 的 autoregressive language model 和 text interaction 基础 few-shot 使用流程说明。
- Jacob Devlin et al., BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, arXiv 2018, 确认日期:2026-07-19。用于支撑 BERT 以 bidirectional encoder representations 为目标这一点,并作为与 GPT 结构比较的依据。
- Daniel Jurafsky, James H. Martin, Speech and Language Processing, 3rd ed. draft, online manuscript released January 6, 2026, 确认日期:2026-07-19。用于支撑 language model 与 Transformer language model 说明的一般 NLP 背景。