P6-5.2 加在生成结构之上的指令遵循与对话界面
Section ID:
P6-5.2Version:v2026.07.26
在 P6-5.1 中,我们把 GPT 系列说明为以 decoder 为中心、基于先前 token 继续生成下一个 token 的流程。可是,我们实际遇到的聊天机器人、copilot、对话式助手,并不只是让人感觉像简单续写。
如果只用模型规模增长来解释对话式 LLM,用户实际感受到的变化就会变模糊。关键在于,在生成结构之上加入了指令遵循、对话格式、安全调节、界面之后,续写模型 开始看起来像 回答问题的系统。
这个结构是如何变成今天的聊天机器人、copilot、对话式助手这类用户体验的?对话式 LLM 是在简单自动补全模型之上,叠加 instruction following、对话格式、安全调节、工具连接等层之后形成的用户体验。
变成对话式体验的地点
对话式转变从下面的问题开始。
- 自动补全式生成模型和对话式 LLM 有什么不同?
- 为什么用户会把 LLM 感觉成
回答问题的系统? - 为了做出对话式体验,结构之外还需要什么?
如果先抓住对话式转变的大流程,后面的 instruction tuning、alignment、prompt 设计、tool use、AI agent loop 也可以分成 模型本身 和 制造用户体验的调节层 来阅读。
用户体验的变化并不只是模型参数增加带来的。如果 P6-5.1 的 GPT 说明处理的是 用什么生成结构接上下一个 token,那么这里要读的是,在这个生成结构之上加入了哪些调节和界面,才让用户感觉它像 回答问题的系统。
因此,核心差异是 生成结构本身 与 把这个结构变成用户体验的调节层 之间的区分。
| 当前焦点 | 接续的问题 | 再次扩展的位置 |
|---|---|---|
| GPT 基础生成结构 | 文本以什么方式接着生成? | P6-5.1、P6-7.1、P6-8.1 |
| 对话式 LLM 体验 | 为什么用户把它感觉成回答系统? | P6-5.2 |
| instruction tuning 与 alignment | 这种体验经过什么调节阶段形成? | P6-10.1、P6-10.2 |
| prompt 与工具连接 | 如何把调节后的模型接到实际请求和执行结构上? | P6-11.1、P6-14.1、P6-14.2 |
也就是说,本章的核心在于从 这是什么生成结构 过渡到 这个结构为什么看起来像对话式体验。这个转变先抓住,才能把 next-token prediction、pretraining、instruction tuning 读成学习原理和后续调节阶段,而不是只读成用户体验表面的变化。
自动补全、指令、安全调节的区分
- 可以说明自动补全式 GPT 与对话式 LLM 的差异。
- 可以说出对话式体验需要 instruction tuning、安全调节、界面设计一起参与。
- 可以说明聊天机器人体验并不是只靠一个模型结构就能完成。
- 可以自然连接到后续的 pretraining、instruction tuning、prompt、AI agent 说明。
这里要确认的结果是:是否开始把对话式 LLM 体验读成不是简单自动补全,而是指令解释、对话历史、安全性修正捆在一起的结构。
- 因为它会制造后面 instruction tuning、alignment 的必要性
- 因为它会说明 prompt engineering 为什么不是单纯输入句子
- 因为它会为把 agent、tool use、MCP 与
模型本身区分开来打下基础
自动补全与对话式体验的差异
自动补全和对话式 LLM 都位于生成结构之上,但用户期待的成功标准不同。必须像下面这样区分这个差异,后面的 instruction tuning、alignment、prompt、tool use 才不会被混到同一层位。
| 需要区分的层位 | 自动补全式体验 | 对话式 LLM 体验 |
|---|---|---|
| 基本期待 | 是否自然接在前一句后面 | 是否反映用户的问题和意图 |
| 追加约束 | 语气和句子连接是否不别扭 | 是否遵守格式、角色、安全约束 |
| 界面角色 | 像输入框的一部分 | 像包含对话记录和系统角色的助手 |
| 后续问题 | 为什么能自然接续? | 什么调节层制造了回答体验? |
从自动补全变成对话是什么意思
早期生成模型的用户体验大体如下。
- 给出文本前半部分
- 让模型继续往后写
这很强大,但还不一定让人感觉像 回答问题的助手。
对话式 LLM 体验是在这里加入下面的层之后出现的。
- 问题与回答的格式
- 遵循用户意图的指令理解
- 减少不必要重复的回应调节
- 安全性与政策约束
- 对话状态维持
也就是说,模型仍然生成下一个 token,但用户不再把它看成 自动补全器,而是感觉成 对话式助手。
什么改变了体验
只用一个原因解释对话式转变是不够的。更安全的说明如下。
- 更大的预训练模型
- 让模型遵循指令的追加学习
- 对话式界面设计
- 安全性(safety)与政策调节
- 有时还包括工具使用(tool use)与搜索连接
也就是说,用户遇到的体验是 模型结构 + 后续调节 + 产品界面 的结合。
为什么自然语言指令变得重要
GPT-3 时期之后,用户更强烈地体验到,可以在 prompt 里放入说明和示例来改变模型行为。
这之所以重要,是因为可以:
- 不必另外替换模型
- 只用自然语言
- 指定要完成的工作
例如:
用三句话总结整理成表格解释到小学生也能理解
这类指令变得可行。
从这个地点开始,模型不再像单纯语言生成器,而是开始被感觉成 遵循自然语言指令的界面。
为什么安全调节也一起变得重要
对话式体验比单纯生成更直接地暴露风险。
- 看似合理的错误
- 攻击性表达
- 敏感信息处理问题
- 错误建议
这些问题会更直接地暴露给用户。
因此,对话式 LLM 通常在结构之外也需要安全调节。
可以这样理解。
好的对话式 LLM 不只是知道很多的模型,也是一个连“哪些回答不该给”都一起调节过的系统。
为什么界面也像模型的一部分
用户通常把下面这些作为一个整体来体验。
- 输入框
- 对话记录
- 系统指令
- 模型回应
- 有时还有搜索/工具执行结果
但从结构上看,它们并不都是同一个东西。
例如:
- 模型生成下一个 token
- 应用维持对话记录
- 系统 prompt 约束回应方向
- 工具连接执行外部计算或搜索
必须区分这些差异,后面才不会在说明 AI agent、MCP、harness 时混淆。
制造对话式体验的三层
把到这里为止的流程一次捆起来看,对话式 LLM 体验并不会被一个 next-token generation model 关闭。
- 模型仍然生成下一个 token。
- 调节阶段会改变这种生成遵循什么指令和格式。
- 界面会把对话记录、角色、工具结果捆在一起,作为用户体验展示出来。
也就是说,用户看到的聊天机器人,最好读成 生成模型 + 调节 + 界面 合在一起的结果。
极简画出来
flowchart TD
  A["预训练的 GPT 系列模型"]
  B["指令 / 对话调优"]
  C["聊天界面与安全层"]
  D["面向用户的对话式 LLM"]

  A --> B --> C --> D
这个图示中要确认的结果是:今天的对话式体验不是一次完成的功能,而是经过自动补全、指令执行、对话对齐等阶段累积出来的结构。
案例与示例
下面的图示不是按 句子是否接续,而是按 用户意图和格式约束是否实际反映到回应结构中 这个共同问题,重新捆起本节的三个案例。
flowchart TD
  A["同一个对话式问题"]
  B["自动补全<br/>文本是否自然接续?"]
  C["聊天机器人<br/>回答是否遵守请求格式?"]
  D["Copilot<br/>建议是否反映周边上下文?"]

  A --> B
  A --> C
  A --> D
这个图示中要确认的是,三种体验即使都位于生成之上,评价标准也会不同。自动补全以 是否自然接续 为中心,但对话式 LLM 还必须一起看 意图、格式、安全约束是否实际反映到回应结构中。
案例 1. 一般自动补全
想象一下,在邮件撰写框里只写到 您好,上次会议中讨论的内容是,然后收到下一句推荐。人在这个功能中最先看的标准通常是 句子是否自然接续。这里,比起问题意图理解或角色区分,更重要的是前一句后面是否接上了合适的后续表达。
例如,如果接上 我已附上会议资料 或 我整理如下 这类自然的后续句,用户会觉得功能运作良好。但在这个阶段,系统并不会深入解释用户到底好奇什么,或应该按什么格式回答。
这种体验更接近 接着写下一句,而不是 回答问题。这里变化的是,标准并没有转到 是否解决问题,而仍然停留在 前一句后是否接上自然的下一句。
所以,这个案例中要确认的结果,不是是否深入解释用户的问题,而是前一句之后是否真的接上了自然的后续句。
这个案例的核心,是不要把自动补全和聊天机器人放进同一个成功标准。自动补全首先看的是 意图是否解决,而是 续写体验是否顺滑。前一句后面接上无碍的后续句,用户就会感觉功能做得不错;反过来,即使系统很好地理解了问题,如果句子连接别扭,作为自动补全也会让人不舒服。因此,一般自动补全虽然位于生成之上,也必须分离出它的评价标准不同于对话式指令回应。
即使是同一个生成结构,自动补全中先看的标准也更窄。
| 场景 | 容易期待的内容 | 自动补全中实际先看的内容 |
|---|---|---|
| 接着写邮件草稿 | 似乎也会理解问题并解决意图 | 前一句后是否接上自然后续表达 |
| 推荐会议后续通知句 | 似乎会像回答系统一样全部处理 | 语气和续写顺滑度是否维持 |
| 推荐短句 | 容易期待它连意义解决也做到 | 下一句候选是否无碍且快速接上 |
这个表要纠正的误解是 只要是生成模型,就应该立刻像聊天机器人一样工作。一般自动补全即使位于同一个生成之上,评价标准也更停留在 续写体验 这一层。
案例 2. 聊天机器人
想象一下,打开公司内部政策文档后询问 请用三句话说明这项政策。人们通常只会期待简单自动补全工具给出 下一句候选,但对聊天机器人,则会一起期待问题理解、长度匹配、语气维持、回避危险回答。
如果模型只是长长地续写政策句子的一部分,用户会把它感觉成 续写句子的工具,而不是 听懂问题的系统。反过来,如果系统角色、对话历史、摘要长度约束、安全规则一起工作,用户就会感觉 三句话说明 这个请求真的被反映了。
这个差异是自动补全和对话式 LLM 体验的核心分界线。这里变化的是,从 是否自然接续 的标准,移动到 问题意图和格式约束是否实际反映在回答结构中 的标准。
所以,这个案例中要确认的结果,不是单纯续写,而是长度约束和问题意图是否反映在实际回答结构中。
这个场景在实际产品体验中也很重要。聊天机器人从用户感觉自己 对它说话 的瞬间开始,就会比自动补全承担更多期待。三句话请求就真的应该是三句话,政策说明就应该少带无关补充而整理核心,危险引导则应该避开。也就是说,聊天机器人不能只因句子自然就通过,被要求做什么 和 不能做什么 都必须反映在实际结构中。因此,即使是同一个生成结构,自动补全和对话式回应的评价层也不同。
把同一个生成模型读成聊天机器人时,还要加上下面的标准。
| 场景 | 只用自动补全标准时容易漏掉的内容 | 聊天机器人标准下还要看的内容 |
|---|---|---|
用三句话说明 请求 | 句子自然就容易看起来没问题 | 是否真的遵守三句话格式 |
| 政策摘要回应 | 续写自然似乎就够了 | 是否反映问题意图和核心信息 |
| 有安全约束的回应 | 又长又亲切就容易看起来不错 | 禁止内容回避和角色约束是否实际工作 |
这个案例的重要标准,是把 自然句子 和 符合问题的回答结构 分开看。聊天机器人不是续写工具,而是在这里显露为必须同时反映意图、格式、安全约束的生成体验。
案例 3. Copilot
想象一下,开发者在函数里写下 这里验证用户输入,失败时返回错误 这样的注释。人在简单自动补全中通常期待的是 接下来的几个字符,但对代码助手,则期待它一起读取函数名、参数、返回格式、周边文件上下文。
如果模型只接对下一行,却漏掉异常处理或返回结构,开发者很难感觉它 理解了代码上下文。反过来,如果它一起读取编辑器上下文和签名,把条件语句、错误消息、返回语句作为一个块来建议,那么同一个生成结构也会看起来更像贴合目的的工具。
这里变化的是,从 下一行是否接续 的标准,移动到 是否反映周边代码上下文并提出更完整的 block 的标准。
所以,这个案例中要确认的结果,不是完成一行,而是反映整个函数上下文的建议是否真的接成更完整的代码 block。
把三个案例从用户体验角度重新捆起来,可以得到下表。
| 情况 | 只有自动补全时不足的内容 | 对话式或上下文反映结构还要看的内容 |
|---|---|---|
| 一般自动补全 | 自然续写 | 有些情况下这本身就足够 |
| 聊天机器人 | 单纯后续句生成 | 问题意图、格式约束、安全条件 |
| Copilot | 下一行建议 | 函数上下文、返回格式、异常处理 block |
需要调节层的场景
读完这一节之后,即使还不了解 instruction tuning 或 alignment 的细节,也可以先像下面这样练习区分 现在看到的场景是单纯续写体验,还是需要对话式调节层的体验。
| 现在看到的场景 | 容易先想到的误解 | 先换成什么问题 |
|---|---|---|
| 前一句后面只要自然接上一句就足够 | 容易觉得生成模型就应该立刻像聊天机器人一样解决问题 | 当前标准是意图解决,还是续写顺滑度 |
经常违反 用三句话总结,或者语气忽高忽低 | 容易觉得模型更聪明后,格式和角色也会自动对齐 | 现在卡住的是生成能力,还是指令·格式调节层 |
| 代码一行推荐还可以,但函数整体上下文和异常处理经常漏掉 | 容易觉得 next-token generation 做好后,周边上下文反映也会自动解决 | 现在需要的是更长上下文反映和产品界面结合吗 |
这个表里重要的不是背下 聊天机器人 这个名称,而是把同一个生成结构之上,用户期待的评价标准也会改变这一点套回实际场景。
这里经常混在一起的内容如下。
- 容易把自然续写和问题意图解决捆成同一个成功标准。
- 容易把格式遵守、角色维持、安全约束只看成一个模型结构的问题。
- 容易无法把 copilot 或聊天机器人这类产品体验中附加的界面层与模型本身区分开。
因此,本节的收束点,是把 对话式 LLM 是生成模型 + 调节 + 界面的结合 这句话转成实际判断标准。
这个区分的目的不是一次确定原因。它是为了不把 对话式 LLM 很奇怪 压成一句话,而是短暂区分眼前现象先显露在 续写体验、调节层、产品界面结合 中的哪一处。
练习与示例
这个练习的目标,是确认同一个生成结构之上,自动补全体验 和 对话式指令回应体验 如何不同。我们将比较两个回应候选,并直接标记格式约束、角色、安全约束、结构化是否实际反映。
用户请求如下。
请用三句话总结这份文档。
系统角色是 平静说明学习内容的助手,要避免的是断定不确定事实和攻击性表达。这些条件就是本练习的输入。也就是说,表中的回应候选 A 和 B,是收到同一用户请求、同一系统角色、同一安全条件后可能出现的两种输出例。
第一张表展示输入条件下的两个输出候选。回应候选 列是比较对象的名称,输出例 列是用户实际会看到的句子。先看见的性质 列帮助初步判断这个输出更接近自动补全,还是更接近对话式指令回应。
| 回应候选 | 输出例 | 先看见的性质 |
|---|---|---|
| A | 这份文档讨论了重要内容,也会断定一些不确定事实... | 更接近接着前文写下去的自动补全 |
| B | 第一,整理核心概念。第二,同时说明主要案例和局限。第三,提供连接到下一学习阶段的视角。 | 更接近符合请求格式和角色的对话式回应 |
第二张表是评价第一张表输出候选的标准表。左侧的 判断标准 是对话式 LLM 体验中需要额外确认的条件,A 和 B 列标记各候选是否满足条件。最后一列说明为什么会出现这样的判定。
请按下面标准直接标记。
| 判断标准 | A | B | 为什么分开 |
|---|---|---|---|
| 是否遵守三句话格式 | 否 | 是 | A 更像一行续写,B 符合请求的句子数量。 |
| 是否看得出说明助手角色 | 否 | 是 | A 在延续上下文,B 显示出整理学习内容的角色。 |
| 是否避开应避免的表达 | 否 | 是 | A 包含不确定事实断定,B 减少了断定风险。 |
| 是否是结构化回应 | 否 | 是 | B 用 第一、第二、第三 制造回应结构。 |
这个练习的重要点,不是 B 永远是更优秀的句子。在自动补全场景中,像 A 那样自然接在前文之后就可能足够。但是,在用户请求 用三句话总结 的对话式场景中,只是自然续写还不够,请求格式、角色、安全约束必须实际反映在回应结构中。
对话式体验中改变的输出标准
前面的练习最短地展示了:即使是同一个生成结构,接着写下一句的体验 和 遵循用户指令、同时匹配回应格式、角色、安全条件的体验 也不同。这里要阅读的核心,不是模型是否说得更长,而是 用三句话总结 这个格式条件、平静说明学习内容的助手 这个角色,以及应避免的表达,是否反映在实际回应结构中的调节体验。
这个例子中要读的核心如下。
- 二者都是生成
- 自动补全更接近自然续写
- 对话式 LLM 是更明确地遵循用户指令格式、角色、安全约束的调节后体验
- 因此,即使在同一个生成模型之上,
format_followed、role_followed、safety_ok等项目也会实际显示出用户体验差异
如果把这个差异逐项分开看,可以读成下面这样。自动补全型回应更接近自然接下一句,无法满足四个标准;指令回应型则把格式、角色、安全条件、结构化都纳入回应评价标准。
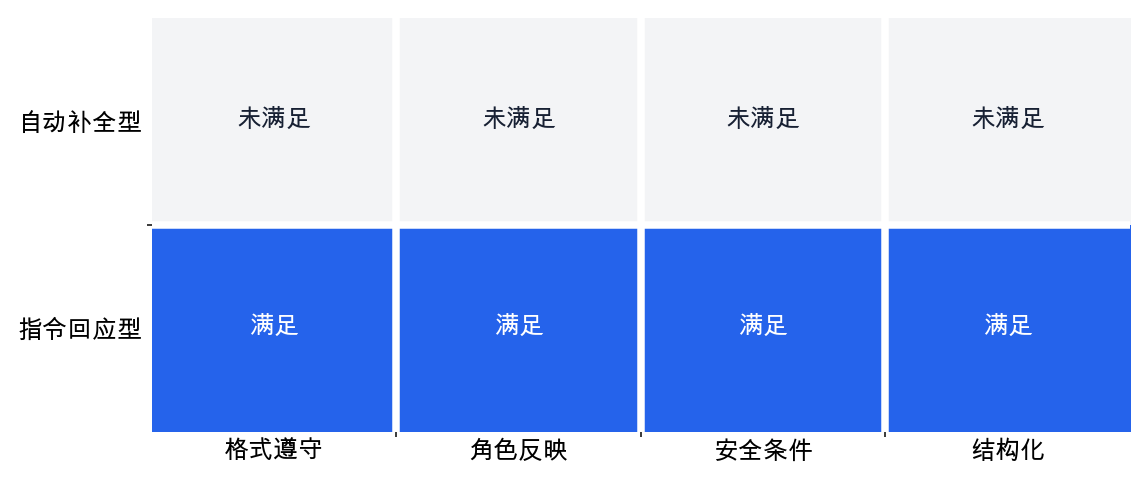
对话式 LLM 转变很难只用简单的模型规模增长来说明。实际用户体验之所以大幅改变,是因为:
- 大型生成模型
- 指令遵循调节
- 对话式产品界面
- 安全性修正
被捆在了一起。
如果把这个例子重新缩成判断标准,下面三个问题应该先浮现出来。
| 场景 | 要先回答的问题 |
|---|---|
| 为什么自然的自动补全仍然不像聊天机器人那样令人满意 | 现在期待的是格式、意图、角色反映,而不是续写吗 |
为什么同一个生成模型中,三句话、平静语气、回避禁止表达 会分开 | 生成结构之上加了什么调节层和界面 |
| 为什么 copilot 应该不只读下一行,还要读周边函数上下文 | 是否需要超出简单 token 生成的产品上下文结合 |
检查清单
- 能否把对话式 LLM 说明为
生成模型 + 调节 + 界面的结合? - 能否用格式遵守、角色、安全约束标准区分自动补全和对话式回应?
- 是否准备好把后续章节分成模型本身、调节层、工具层来阅读?
来源与参考资料
- Alec Radford et al., Language Models are Unsupervised Multitask Learners, OpenAI 2019, 确认日期:2026-07-19。用于支撑 GPT-2 的 language model 基础生成流程,作为对话式转变之前的生成模型背景。
- Tom B. Brown et al., Language Models are Few-Shot Learners, arXiv 2020, 确认日期:2026-07-19。用于支撑 GPT-3 通过 text interaction 接收 task specification 与 few-shot demonstrations 的说明。
- Long Ouyang et al., Training language models to follow instructions with human feedback, arXiv 2022, 确认日期:2026-07-19。用于说明仅靠模型规模不会自动保证遵循用户意图,InstructGPT 是通过 human feedback fine-tuning 制作的。
- OpenAI, Aligning language models to follow instructions, 确认日期:2026-07-19。作为 InstructGPT 与 RLHF 是处理指令遵循、安全性、alignment 问题的后续调节层这一说明的辅助依据。
- OpenAI, Introducing ChatGPT, 确认日期:2026-07-19。用于支撑对话格式使后续问题、承认错误、拒绝不适当请求等用户体验成为可能这一说明。
- OpenAI Help Center, How can I use the Chat Completion API?, 确认日期:2026-07-19。用于支撑 developer instructions、message role、instruction following 会调节对话 session 的角色与约束这一当前 API 使用说明。