P6-8.2 同时扩大能力和运营负担的规模
Section ID:
P6-8.2Version:v2026.07.26
在 P6-8.1 中,我们把预训练(pretraining)说明为 先建立宽广语言基础的阶段。那么下一个问题会自然出现。为什么在建立这个基础时,总是会同时伴随大数据集、大模型和大量计算?
也就是说,本节的出发点不是 大模型看起来更好。更准确地说,是 为什么要建立宽广基础时,规模会成为问题,以及 这种规模扩大让什么变得可能,又留下什么负担。
规模(scale)指数据量、模型大小、计算量一起变大的现象。它和 LLM 性能提升强相关,但也会同时扩大成本和风险。
规模扩大时一起看的标准
规模扩大判断从下面几个问题开始。
- 规模(scale)是什么意思?
- 为什么要把数据、参数(parameter)、计算量(compute)一起看?
- 为什么规模变大时,性能可能变好,同时成本和风险也会变大?
规模是 数据、参数、计算量一起变大,并同时改变性能可能性和成本负担的结构。有了这个标准,才不会把大型基础模型的故事读成单纯的性能竞赛。
下一个词元预测是 把什么作为学习目标 的问题,运营约束是 作为服务运行时必须承担什么 的问题。规模位于两者之间,是基础越大,能力和负担就越一起变大的连接环。
需要避免 越大就一定越好 的印象。如果 P6-8.1 处理的是 先学习什么,这里要读的是 为什么这种学习会以那么大的规模运行。在进入 prompt 或 RAG 等服务连接之前,需要能够判断为什么后续微调和指令调优通常会叠加在 大的基础模型 之上。
因此,首先要抓住的不是 大模型更好,而是 规模越大,能力和负担会一起改变。
为什么在预训练之后马上读规模
这里很容易把 先建立宽广基础 的说明和 所以大模型很重要 这句话当成一件事。但两者并不相同。P6-8.1 说明的是 先学习什么,本节说明的是 为了建立这个基础,实际会有哪些东西一起变大。
必须把这个差异分开,后续微调和指令调优才会读得更准确。如果不知道先建立基础的成本和负担是什么,就很容易看不清为什么调整阶段通常被解释为 在已经很大的基础上再叠加,而不是 从头把所有东西重新学习一遍。
可以这样阅读脉络:前一节抓住模型先学习什么,这里则看建立这个基础时,数据、参数、计算量为什么会一起变大。如何在大的基础之上进一步贴合特定任务和用户请求,会在后面的微调、指令调优、prompt、RAG、运营政策中再分开阅读。
也就是说,本节不是 赞美大模型,而是阅读 建立大基础这句话实际同时意味着什么能力和成本 的位置。我们先区分当数据、参数、计算量一起变大时,什么可能变好,以及性能可能性、成本、风险为什么会一起变大。
这里要建立的基线,是把 大模型更好 这种单纯印象,改写为 数据、参数、计算量一起变大,性能可能性和成本负担也一起变大的结构。
区分规模带来的能力和负担
- 能从数据、模型、计算量扩大的角度解释规模。
- 能说出性能提升和成本增加会一起出现。
- 能说明数据质量和验证责任会随着规模变得更重要。
- 能在规模的能力·负担平衡之上阅读后续调整和运营判断。
这里要同时记住两件事。
- 规模是重要的性能转变因素
- 规模也会同时扩大数据质量、验证、成本、政策问题
必须把这两点一起放进去,才能把前面 P6-8.1 的预训练目标和 为什么要以那么大的规模运行 连接起来,也才能在后面的 P6-17.1、P6-18.1 评估和运营约束章节中,自然延续 性能越大,成本和控制问题也越大 的视角。这样阅读,Part 6 后续章节和 Part 7 项目中的判断才会更平衡。
能力和负担的判断标准
规模不能只用模型大小一个因素判断。要同时看规模扩大让什么成为可能,又让我们必须多承担什么。
| 判断标准 | 要确认的问题 |
|---|---|
| 扩大的轴 | 数据、参数、计算量是否一起变大 |
| 能力变化 | 是否能处理更长上下文、更复杂请求、更宽广的模式 |
| 运营负担 | 成本、延迟时间、故障应对负担是否一起变大 |
| 数据责任 | 数据质量、重复、版权、偏见审查范围是否也一起变大 |
规模会一起扩大什么
在 LLM 语境中,规模通常不是只指一个东西变大。通常下面几项会一起变大。
- 训练数据量
- 模型参数数量
- 训练计算量(compute)
把模型做大,通常意味着看更多文本、使用更多参数、投入更多计算资源。
为什么规模变大时性能可能变好
对这个问题的直观回答如下。
- 更多数据让模型看到更多样的语言模式
- 更大的模型给出容纳更复杂模式的表达能力
- 更多计算让这个结构实际被学习
也就是说,规模不是简单的大小竞赛,而是和 更宽、更细地容纳模式的条件 相连。
因此,在 LLM 发展史中,模型规模和数据规模经常和性能转变一起被提到。
为什么成本和延迟也一起变大
但规模越大,并不会只出现好处。
- 训练成本会变大
- 推理成本也可能变大
- 响应延迟时间(latency)可能增加
- 运营复杂度和故障应对负担会变大
也就是说,规模既是性能问题,也是服务运营问题。
这一点也和 Part 6 后半部分的运营、评估、约束说明直接相连。
数据越多就一定越好吗
必须一起看这一点,才能判断规模如何在提高性能方向的同时,也扩大数据质量、成本、政策负担。
数据量增加很重要,但质量问题不会因此消失。
例如:
- 过时的信息
- 重复数据
- 有偏的表达
- 版权问题
- 错误事实
这些问题即使数据变多,也可能原样留下,甚至变得更大。
因此,更稳妥的说明如下。
规模会扩大性能可能性,但不会消除数据质量和验证责任。
为什么规模改变了用户体验
随着规模变大,用户会更直接地感受到下面这些变化。
- 看起来能更自然地处理长上下文的回答
- 对更多样任务指示的反应
- zero-shot、few-shot 使用体验的提升
- 只用自然语言提问也像是在执行多种任务的感觉
但这仍然不直接保证 理解 或 事实性。
也就是说,规模会大幅改变用户体验,但不会消除验证责任。
规模判断中一起变大的东西
把到这里为止的内容最短地整理如下。
- 规模会扩大
处理更宽广模式的可能性。 - 同时也会扩大
更大的成本和运营负担。 - 因此,
更大这句话必须总是和什么变好、还要多承担什么一起阅读。
非常简单地画出来
flowchart TD
  A["更多数据"]
  B["更大的模型"]
  C["更多计算资源"]
  D["更宽的能力可能性"]
  E["更高的成本和风险"]

  A --> D
  B --> D
  C --> D
  A --> E
  B --> E
  C --> E
这个图的核心只有一个。
规模会同时扩大性能可能性和成本/风险。
案例与示例
下面的图把规模扩大决策重新归到一个问题上:它不是 更大的模型是否更好 这一行判断,而是同时看能力、成本、数据验证负担的问题。
flowchart TD
  A["规模扩大决策"]
  B["能力轴<br/>哪些请求会变得可处理?"]
  C["成本轴<br/>延迟和成本会增加多少?"]
  D["数据轴<br/>验证负担会变大多少?"]

  A --> B
  A --> C
  A --> D
从这个图中要确认的是,规模扩大不会用 性能改善 一句话结束。同一个变化,对用户来说可能表现为能处理更长请求;对运营团队来说可能表现为成本和延迟增加;对数据负责人来说可能表现为需要验证的源数据增加。
案例. 规模扩大决策会议
假设客户支持团队正在开会,讨论是否把当前使用的 small 模型提升到 medium 或 large。现在的模型能快速回答短 FAQ,但在摘要长合同条款,或同时读取代码错误日志的请求中经常失败。会议中人们首先容易看的标准是 换成 large 就会做得更好吧。但从规模视角看,必须先把问题拆开。
第一,在能力轴上,看哪些请求会新变得可处理。如果 context window 变宽,模型表达力变大,就可能更好地处理长合同、长错误日志、多个条件混在一起的复杂请求。第二,在成本轴上,看处理这些请求时延迟时间和推理成本会增加多少。第三,在数据轴上,看随着更多数据被用于预训练或后续调整,重复、过时信息、版权、偏见等质量问题也必须被更宽地审查。
这个案例中要确认的结果,不只是 large 是否能处理更多请求。即使能处理更多请求,如果成本和延迟超过服务限度,或数据验证负担无法承担,这个选择也未必最好。相反,如果 medium 虽然放弃一部分长请求,但能在成本和运营负担之内给出足够改善,那么对当前服务来说可能更现实。
| 规模阶段 | 得到什么 | 同时要承担什么 |
|---|---|---|
维持 small | 用低成本和快速响应处理短 FAQ | 长合同、长代码日志、复杂请求可能继续失败 |
转为 medium | 有可能处理部分长请求和复杂请求 | 成本和延迟增加,需要验证的数据范围也变大 |
转为 large | 有可能处理长合同和部分代码日志 | 推理成本、延迟时间、数据质量审查负担明显变大 |
转为 frontier | 有可能把最长的多文档请求也放进上下文 | 成本、延迟、验证负担最大,必须重新设定运营标准 |
这张表会成为阅读后面 Python 示例的标准。案例展示 为什么必须一起比较三个轴,示例则用分阶段数字确认三个轴如何变化。
需要规模判断的场景
读完本节之后,即使还不知道实际模型价格表或基准测试,也可以先练习区分现在需要的是 更大能力,还是 先降低成本、延迟、验证负担。如果在同时读取长合同和长日志的请求中经常失败,在认为一个更大的模型能解决所有问题之前,应先问实际需要的是不是更长上下文和更大表达力。如果回答质量变好了,但响应变慢、成本急剧增加,就要把性能变好这件事和能否在服务限度内承担成本与延迟分开看。如果使用更多数据后性能提高了,但需要验证的数据束大幅增加,也要同时看现在变大的不只是能力,还有验证责任和政策负担。
这里重要的不是背诵 大模型好 或 小模型便宜 其中一句,而是先把 能多处理什么 和 必须多承担什么 一起阅读。
这里经常混在一起的还有下面几点。
- 容易只用同一条轴看性能提升和运营可行性。
- 容易分不清需要更大 context window 的问题和单纯成本问题。
- 容易把数据规模扩大感觉成质量保证。
因此,规模会同时扩大性能可能性和成本·风险 这句话应该成为实际服务判断标准。
练习与示例
这个示例的目标,是在规模变大时按阶段拆开看 能多处理什么 和 必须多承担什么。它不是一次性比较小模型和大模型并选胜负,而是跟踪当规模从 small -> medium -> large -> frontier 变大时,数据量、参数数量、训练计算量、上下文范围、推理成本、延迟、验证负担如何一起移动。
输入:
下面的代码使用两个输入 CSV。
- 请求列表:p6-7-scale-requests.csv
- 规模阶段:p6-7-scale-steps.csv
请求列表的一行是一个用户请求。request_type 表示 FAQ、摘要、合同审查、代码辅助、多文档请求等请求性质,input_tokens 是把该请求放进上下文时所需输入长度的简化值。规模阶段 CSV 的一行是假设的一个模型规模,context_window、cost_per_1k_tokens、latency_per_1k_tokens、review_batches 是本示例中可直接改变的操作变量。
结果中会确认每个规模阶段可处理的请求数、超出上下文限制的请求数和类型、虽然优先级高却仍超出上下文的请求数、预计总推理成本和延迟时间、数据验证待处理批次数。这里的数字不是某个商用模型的真实价格表或性能表,而是为了分离阅读规模的轴而设定的运营判断练习值。
要确认的核心是,规模是数据、模型、计算量一起变大的现象。context window 变大后,可以处理更长请求,但推理成本和延迟也可能增加;数据量变大后,验证数据质量的负担也会一起变大。
这个示例已用本地 .venv 的 Python 执行,并确认与正文输出一致。
执行结果示例可以这样阅读。
这个示例中要读出的核心如下。
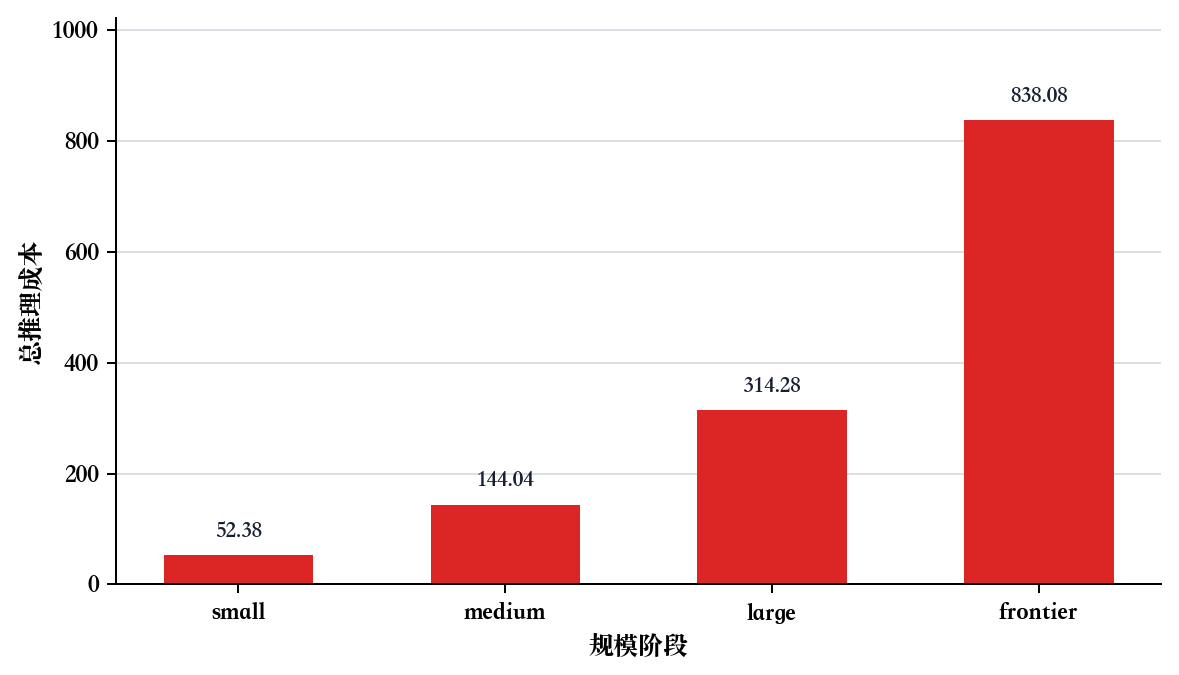
small只把 8 个短 FAQ 放进上下文,剩下 28 个请求仍超出上下文限制。medium可以处理到部分摘要请求,但 16 个高优先级请求仍然超出上下文。large可以处理 24 个请求,但 12 个长合同、代码、多文档请求还会留下。frontier可以把 36 个请求全部放进上下文,但总推理成本、延迟时间、数据验证批次最大。review_batches简化地显示:数据量越大,需要验证的批次也会一起变大。
分成图来看,三个轴以不同意义变大这一点会更清楚。首先,上下文范围变大后,可处理请求数会增加。
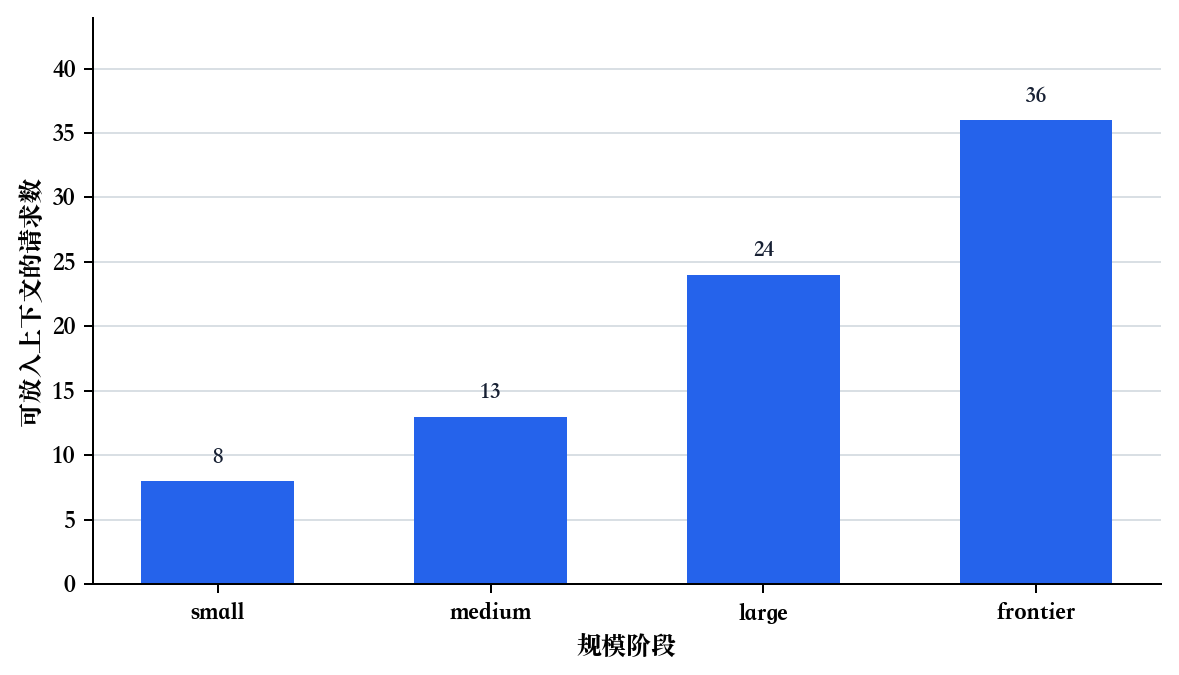
但处理同一组请求时的总推理成本也会一起变大。这张图要确认的不是 large 能处理更多请求,而是这个选择伴随着成本增加。
数据量变大后,需要验证的数据质量负担也会一起变大。下面的图不是实际风险测量值,而是为了展示数据越多、需要审查的批次也越多这一结构的简化图。
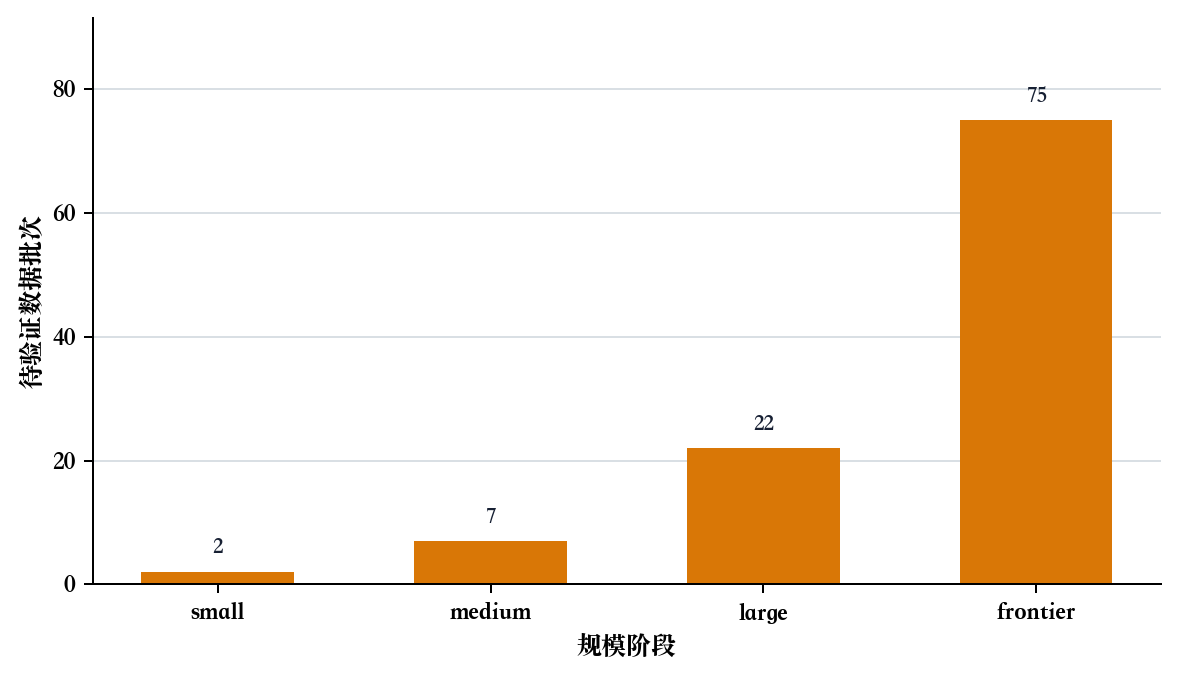
在这个示例中,可以直接修改请求 CSV 的 input_tokens 和 priority,以及规模阶段 CSV 的 context_window、cost_per_1k_tokens、latency_per_1k_tokens、review_batches。例如,如果增加长合同请求,small 和 medium 的上下文超限会更明显;反过来,如果只留下短 FAQ,就可以重新思考 frontier 的额外成本是否真的必要。
规模-成本平衡中分开的选择
这个比较会帮助我们避开 更大的模型更好 这种单线理解。实际选择总是要一起阅读能力扩大和训练·推理成本增加,所以后面的模型选择和运营章节中,规模应被看作 性能、上下文范围、成本、延迟 的同时判断轴。
理解 LLM 时代时,规模是不能省略的主题。尤其在 GPT-3 之后,许多讨论把 模型为什么开始表现出这些能力 和规模联系起来说明。
把这个示例重新压缩成判断标准时,应该先浮现下面三个问题。
| 场景 | 首先要回答的问题 |
|---|---|
| 为什么更大的模型在某些请求中显得必要? | 当前失败原因是不是需要更长上下文和更大表达力的问题? |
| 为什么性能变好也不会马上成为运营最优解? | 成本和延迟时间是否超过服务限度? |
| 为什么数据越多,验证负担也会一起变大? | 随着能力扩大,质量、版权、偏见审查范围是否也在变大? |
检查清单
- 能否把规模解释成
什么变好和必须多承担什么这一对? - 能否把长上下文、性能提升、运营成本放在同一条轴上一起看?
- 读后续章节时,是否准备好把大型基础模型的性能和后续调整成本分开看?
来源与参考资料
- Tom B. Brown et al.,
Language Models are Few-Shot Learners, arXiv, 2020, 确认日期:2026-07-19. https://arxiv.org/abs/2005.14165 - Jared Kaplan et al.,
Scaling Laws for Neural Language Models, arXiv, 2020, 确认日期:2026-07-19. https://arxiv.org/abs/2001.08361 - Jordan Hoffmann et al.,
Training Compute-Optimal Large Language Models, arXiv, 2022, 确认日期:2026-07-19. https://arxiv.org/abs/2203.15556 - OpenAI Docs,
Models, model-specific price and context window examples, 确认日期:2026-07-19. https://developers.openai.com/api/docs/models