P6-9.2 减轻全量微调负担的 LoRA
Section ID:
P6-9.2Version:v2026.07.26
在 P6-9.1 中,我们看到微调(fine-tuning)是把经过预训练的模型进一步调整为更适合特定目的的过程。但这里马上会出现一个现实问题。
每次都重新调整整个巨大模型,成本是不是太高了?
本节从这个问题出发。
所以在实务中,不只会问 是否需要微调,还会一起问 应该用什么方式做这个调整,成本才承担得起。
这时出现的大脉络是高效参数微调(parameter-efficient fine-tuning)。LoRA 是这个脉络中最常被提到的代表方法之一。
LoRA 是一种不大幅重新改变整个巨大模型,而是通过小的追加调整量来高效适应的方法。
降低高效调整成本的标准
高效调整成本从下面几个问题开始。
- 为什么需要高效参数微调(parameter-efficient fine-tuning)?
- LoRA 试图减少什么问题?
- 全量微调和高效调整有什么差异?
理解 LoRA 时,首先需要的感觉是 在大的基础模型之上只加小的调整量,以降低成本。low-rank 公式、调整量接到哪个矩阵、adapter·LoRA·QLoRA 在实际约束场景中如何区分,是更深入的实现判断。这里先抓住 不重新调整全部,也能否做出目的适应 这种成本感觉。
比起先区分 adapter、LoRA、QLoRA 的名称,更重要的是 什么保持不变,只有什么被重新学习。LoRA 不应理解为 小模型,而应理解为 在大的基础模型之上添加小调整量的方式。
因此,核心不是 把模型做小,而是 用更少的调整成本适应同一个大的基础模型。本节会先抓住为什么全量微调会变得过重,以及在保持大基础模型的同时只添加小适应量的想法。LoRA 名称的直觉和 low-rank 规模感,会在 P6-10.4 继续看;adapter·LoRA·QLoRA 的细部约束区分,会在 P6-10.5 继续看。
轻量小模型 这种误解,需要改读为 在大的基础模型上只加小调整量,以降低适应成本的方式。
区分全量权重调整和小变化量
- 能说明为什么需要高效调整。
- 能以入门水平说出 LoRA 的基本想法。
- 能从概念上区分全量微调和 LoRA 的成本差异。
- 能连接到后续 instruction tuning 或领域适应说明。
需要这个标准,是因为它:
- 避免把前面的 P6-9.1 微调马上理解成
重新训练整个模型 - 让我们在 LLM 服务实务中同时思考成本和结构选择
- 为后续 P6-10.1 instruction tuning、P6-10.2 alignment、P6-18.1 服务运营约束章节中阅读
模型调整成本建立基础
高效调整的判断标准
高效调整是一个和是否需要微调分开的的问题:它问的是应该用什么成本结构来承担这个调整。
| 判断标准 | 要确认的问题 |
|---|---|
| 调整范围 | 即使需要微调,是否必须调整整个模型 |
| 要保留的部分 | 能否保留基础模型本体,只重新学习小的调整量 |
| 运营成本 | 学习成本、存储空间、版本管理负担是否成为瓶颈 |
| 实验方式 | 是否需要在同一个基础模型上快速比较多个目的适应 |
为什么需要高效调整
P6-9.1 中看到的微调方向本身很自然。问题在于 LLM 太大。
如果尝试更新模型的全部权重,下面这些负担会马上变大。
- 内存使用量
- 学习时间
- 存储空间
- 多版本管理成本
在实务中,可能想基于同一个基础模型,按下面几种目的进行调整:
- 客服用途
- 搜索辅助用途
- 文档摘要用途
- 代码助手用途
这时每次都重新调整并存储整个模型,可能非常低效。
也就是说,想把模型改得适合我们的目的 这个想法是对的,但成本可能变得太大。
在这里,脉络会转折一次。
- P6-9.1 的问题:
是否要让模型更适合我们的目的? - P6-9.2 的问题:
能否不重新改变整个模型,也完成这个调整?
换句话说,LoRA 不是和微调竞争的完全另一个世界的方法,而是在 需要微调,但触碰全部太重 这个现实中出现的下一个选项。
因此,下一个问题会自然接上。
能否不每次重新学习整个基础模型,只更轻地做出需要的目的适应?
LoRA 想做什么
LoRA 正是这个问题的代表性答案。
把核心想法压到最简单,可以这样说。
不要大幅重写原本的大权重,而是只学习并接上一个小的追加调整量。
也就是说,LoRA 更接近 降低微调负担,而不是 放弃微调。
把这句话换成更实务的表达,如下。
- 全量微调:
本体也一起大幅重新调整 - LoRA:
尽量保留本体,只额外学习小的适应量
因此,在 low-rank 公式之前,应该先抓住 LoRA 中 什么保持不变,只有什么重新学习。
再展开一点,可以这样说。
- 基础模型(base model)大体保持
- 只单独学习小的调整参数
- 给特定目的反应加上适应
所以,LoRA 最好理解为 让一个大的基础模型高效适应多个目的的方法,而不是 从头另做一个新模型的方法。
和全量微调有什么不同
| 方式 | 核心差异 |
|---|---|
| 全量微调(full fine-tuning) | 直接更新大量权重 |
| LoRA | 主要更新小的追加调整量 |
可以这样记住。
全量微调是直接大幅修改本体的方式,LoRA 是在本体之上叠加小调整模块来形成目的适应的方式。
为什么在实务中有吸引力
LoRA 这样的方式有吸引力,原因如下。
- 成本相对较低
- 更容易复用同一个基础模型
- 更容易单独管理按目的调整的版本
- 更容易提高实验速度
也就是说,LoRA 不是单纯的理论想法,而是和 LLM 运营现实 相连的选项。
要小心什么
但 LoRA 也不是万能的。
- 并不一定在所有任务中总是最好
- 因为调整范围受限,可能不如全量微调贴合
- 数据质量问题仍然存在
- 如果没有评估,只因为
轻就选择它,会有风险
更稳妥的说明如下。
LoRA 是改善成本和灵活性的强实务选项,但不能替代质量验证。
LoRA 减少的调整成本
把到这里为止的内容最短地整理如下。
- 全量微调更接近
大幅重新调整本体的方式。 - LoRA 更接近
尽量保留本体,只学习小调整量的方式。 - 因此,LoRA 的核心不是
小模型,而是让大的基础模型更轻地适应的运营方式。
非常简单地画出来
flowchart TD
  A["基础模型"]
  B["小型可学习更新"]
  C["任务适应型模型行为"]

  A --> C
  B --> C
这个图的核心,是在概念上把基础模型本体和小调整量分开看。
案例与示例
下面的图把本节的三个案例重新归到共同问题上:不是 是否更轻,而是 在保持同一个基础模型的同时,能承担多少目的适应。
flowchart TD
  A["相同的 PEFT 问题"]
  B["共享基础模型<br/>多个任务能否复用同一个骨干?"]
  C["受限预算<br/>能否先启动实验?"]
  D["快速比较<br/>能否尝试更多假设?"]

  A --> B
  A --> C
  A --> D
从这个图中要确认的是,LoRA 的优点并不止于 参数数量少。还要一起看复用同一个基础模型、在有限资源中运行更多适应实验、把多个业务用调整件更轻地管理起来的运营脉络。
案例 1. 同一个基础模型,不同业务
假设一家公司用一个基础模型同时实验客户回复、文档摘要、代码辅助。人们容易先认为,业务不同,模型也必须整个分开制作。如果只坚持全量微调,实际就会为每个业务分别制作巨大的模型副本,并分别存储学习结果。这样,每增加一个新业务,成本和版本管理负担就会一起变大。例如,即使只是多做一次摘要实验,也可能需要单独管理数 GB 到数十 GB 规模的结果物。
LoRA 方式让基础模型本体保持共用,只按业务分别接上并管理小的调整量。这里发生的变化,是从 每个业务是否都要有自己的本体模型 的标准,移动到 能否在同一个本体之上只分离管理调整量 的标准。因此,可以在同一个基础模型上,更轻地分开实验 客户回复用、摘要用、代码用 调整件。这个案例中要确认的结果是:即使业务数量增加,也不一起增加巨大模型副本数量,而是通过替换按目的调整件来实际减少版本管理负担。
| 问题 | 全量微调侧的图景 | LoRA 侧的图景 |
|---|---|---|
| 要同时运营客户回复用和摘要用 | 每个业务都单独管理大的模型结果物 | 一个共用基础模型,只分离管理按业务的调整件 |
| 又新增一个业务时 | 大副本和学习结果一起增加 | 主要通过添加小调整件应对 |
| 追踪版本差异时 | 必须一起处理整个本体差异 | 先看按目的调整量的差异即可 |
案例 2. 成本约束很大的团队
假设一个小型创业团队想试验内部文档摘要模型,但 GPU 预算并不宽裕。人们容易先认为 要提高性能,全量微调不是正统方法吗? 但如果尝试全量微调,学习中的内存使用量和存储空间会很快变大,连一次实验本身都可能成为负担。例如,第一次实验失败后如果已经没有资源再跑,性能讨论之前,实验文化本身就会被堵住。这个团队首先需要的,可能不是 最高性能,而是 能否开始实验并比较。
LoRA 不重新调整整个模型,而是以小调整量为主进行实验,把第一次尝试放进更现实的成本范围内。这里发生的变化,是从 是否马上得到最高性能 的标准,移动到 能否在有限资源内开始并重复实验 的标准。因此,对资源紧张的团队来说,先用 LoRA 看目的适应是否可行 是自然选择。这个案例中要确认的结果不是一个最高性能分数,而是能否在有限 GPU 预算内实际开始第一次实验,并在失败后继续做比较实验。
| 这个团队首先要确认的事 | 只坚持全量微调时容易卡住的点 | LoRA 打开的选项 |
|---|---|---|
| 能否开始第一次实验 | 内存和存储负担大,尝试本身很重 | 用更小调整量降低进入门槛 |
| 失败后能否再跑 | 一次失败成本高,重试困难 | 更容易多做几次比较实验 |
| 最高分之前是否有运营可行性 | 性能讨论之前可能先耗尽资源 | 先在有限资源中验证可能性 |
案例 3. 快速比较实验
假设运营团队想用同一个基础模型比较 稳定回答格式、反映内部术语、维持特定领域文体 中哪一个更有效。人们可能先想一次大幅调整后结束。但在实务中,比起从一开始就命中唯一正确答案,更重要的往往是快速运行并丢弃多个调整方向的过程。如果只使用全量微调,每跑一个实验,准备时间和存储成本都会变大,比较回转数本身会减少。例如,一周内必须测试三个调整假设,但一个实验太重时,比较本身就可能变慢。
LoRA 相对容易制作多个小调整件并接上或拆下,因此适合更快比较哪种调整实际有价值的脉络。这里发生的变化,是从 是否一次大幅调好 的标准,移动到 同一时间内能否实际比较更多调整假设 的标准。因此,LoRA 的优点不止于 理论上轻,还会连接到 更容易增加实验回转数 这种运营感觉。这个案例中要确认的结果是:比起长时间抓住一个调整,是否能在同一期间实际运行更多调整假设并制作比较表。
把三个案例从运营效率角度重新归在一起,可以整理如下。
| 情况 | 走向全量微调时容易变大的东西 | LoRA 想减少的负担 |
|---|---|---|
| 同一个基础模型,不同业务 | 模型副本数量和版本管理成本 | 共用本体复用、小调整件分离 |
| 成本约束很大的团队 | 第一次实验进入成本和重试负担 | 有限资源内的开始可能性 |
| 快速比较实验 | 实验准备时间和存储空间 | 假设回转数和比较速度 |
需要 LoRA 判断的场景
读完本节之后,即使还不知道 low-rank 公式或 QLoRA 细节,也可以先区分现在需要的是 大幅重新调整整个模型,还是 用小适应量快速运行实验。如果要用同一个基础模型制作多个业务用调整件,不应先认为每个业务都必须拥有整个大模型,而应看能否不复制本体,只分离管理小调整件。如果 GPU 预算紧张,第一次实验本身就很重,那么比起最高性能分数,能否开始并重复实验可能更靠前。如果一周内要比较多个调整假设,那么比起一次大幅调整,假设回转数和比较速度可能是更重要的瓶颈。
这里重要的不是背诵 LoRA 更轻,而是先把 什么是瓶颈 分成 内存、存储、版本管理、实验回转速度 来读。
这里经常混在一起的还有下面几点。
- 容易把 LoRA 误解为
小模型。 - 容易把质量问题和运营成本问题看成同一个问题。
- 容易觉得“全量微调是否可行”和“全量微调是否总是最优”是同一句话。
因此,LoRA 是让大的基础模型更轻地适应的运营方式 这句话应该成为实际选择标准。
练习与示例
这个示例的目标是直接观察,当运营多个业务用调整件时,全量微调 和 LoRA 方式 会产生什么差异。不是手工数三个业务,而是读取多个团队一个月内计划的目的适应实验列表,比较全量微调时和 LoRA 调整件方式下的追加存储负担。
输入文件是 P6-9.2 目的适应组合。一行表示一个团队正在审查的目的适应任务。核心列是 team、task、monthly_experiments、expected_change。这里不预测各业务的质量分数,只看在同一个基础模型上必须反复做多个调整实验时,存储和版本管理负担会以什么结构增长。
下面的代码读取 CSV,按团队合计月度实验次数。结果中会比较每次全量微调都存储大结果物时的追加存储大小,以及 LoRA 只存储小调整件时的追加存储大小。
要确认的核心是,随着业务数量增加,全量微调和 PEFT/LoRA 方式之间的管理成本差距会明显拉开。LoRA 类方式会在业务数增加时,让追加学习量和存储量远小于全量微调。
这个示例已用本地 .venv 的 Python 执行,并确认与正文输出一致。
执行结果示例可以这样阅读。
这个示例并不主张某个真实产品的具体数值。它只是让读者直接确认下面的感觉。
- 即使用同一个基础模型,如果多个团队反复做调整实验,全量微调的月度结果物管理负担也会快速变大。
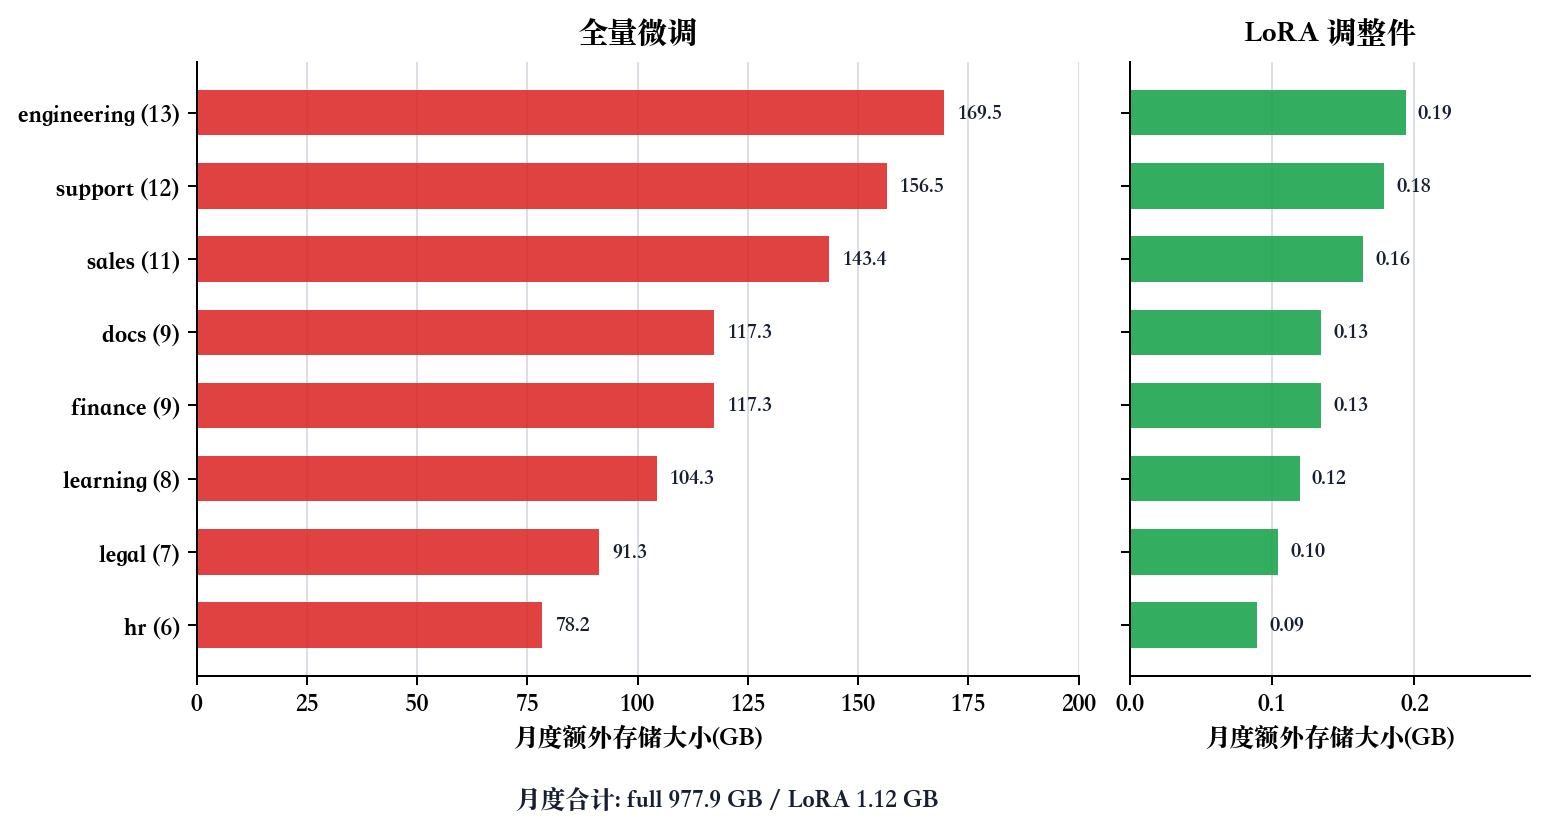
monthly_runs是该团队一个月内需要反复确认的目的适应实验数。即使任务数相同,实验回转数越多,存储和版本管理负担也越大。gap显示在本示例假设下,全量微调需要学习的参数数和 LoRA 调整件参数数会拉开多大差距。- 月度合计分成
full=977.89 GB、LoRA=1.12 GB,不是因为 LoRA 省略质量验证,而是因为它共享基础模型本体,只单独管理小调整件。
在这个示例中,可以修改 CSV 的 monthly_experiments,观察实验回转数增加的情况;也可以修改代码中的 lora_trainable_per_task,假设每个业务调整件变大。不管改哪个值,要确认的问题都一样:全量微调是反复生成并管理大结果物的结构,而 LoRA 是在同一个基础模型上反复接上小调整件并比较的结构。
下面的图按团队月度实验数重新绘制同一个 CSV 输入。左侧是走全量微调时的月度追加存储大小,右侧是只存储 LoRA 调整件时的月度追加存储大小。两个面板的轴范围不同,是为了让 LoRA 的柱形能看见;核心是读取哪些团队实验回转数多,以及这些回转数如何转化为存储和版本管理负担。
调整成本降低中看到的规模差异
这个示例的目的不是背 LoRA 数值。核心是形成一种感觉:不重新触碰整个模型,也能只添加需要的变化。正是这一点,会同时改变实验速度、内存负担和部署策略。
LoRA 不是突然出现的一次性技术,而是在试图以更低成本让大型预训练模型按目的适应的脉络之中。adapter、prefix tuning、prompt tuning 等系列也一起出现在这个脉络中。
检查清单
- 能否说明为什么
需要微调和必须重新调整整个模型不是同一句话? - 能否把 LoRA 解释为
保留本体 + 学习小调整量? - 阅读指令调优和对齐时,能否把 LoRA 分离为降低调整成本的实现选项,而不是单独目的?
来源与参考资料
- Neil Houlsby et al.,
Parameter-Efficient Transfer Learning for NLP, ICML, 2019, 确认日期:2026-07-19. https://proceedings.mlr.press/v97/houlsby19a.html - Edward J. Hu et al.,
LoRA: Low-Rank Adaptation of Large Language Models, arXiv, 2021, 确认日期:2026-07-19. https://arxiv.org/abs/2106.09685 - Hugging Face,
PEFTdocumentation, 确认日期:2026-07-19. https://huggingface.co/docs/peft/index