P6-10.1 建立符合请求格式回应习惯的指令调优
Section ID:
P6-10.1Version:v2026.07.26
在 P6-9.2 中,我们看到 LoRA 这样的高效调整方式为什么在实务中重要。但能够以更低成本稍微调整模型,并不意味着马上就会产生很好遵循人类指令的回答。
让模型超越单纯续写句子,并更好遵循用户指令的过程是什么?
指令调优(instruction tuning)是进一步调整模型,使其更好理解自然语言指令,并按该格式回应的过程。
换成更容易的话,可以这样说。
指令调优是让模型不只是接着写,而是更强地形成按照人的请求方式回答的习惯。
调整回应习惯的层
回应习惯调整从下面几个问题开始。
- 指令调优想改变什么?
- 预训练、微调、指令调优如何连接?
- 为什么在对话型 LLM 体验中,指令调优会显得重要?
指令调优是 指令跟随调整层。这一层比起存储更多新事实,更接近改变回应习惯,让已有语言能力按照用户请求格式被拿出来使用。对齐(alignment)则是在下一步另外询问 这样很好地遵循的回答是否可接受 的问题。
对话型 LLM 的用户体验,会因这种指令跟随能力而大幅改变。预训练建立宽广语言基础和表达感觉,微调收窄领域表达和任务标准,指令调优则让请求格式和回答结构更贴近用户反应。最新信息连接、外部文档依据、实际执行,是之后通过 RAG 和 tool use 添加的单独服务连接。
因此,这里首先要看的不是 是否放入更多新知识,而是 同一个生成结构会获得什么回应习惯。如何更细致地处理对齐问题,如何把外部文档依据和工具执行接到实际回应中,会在后续章节和服务连接章节中再分开讨论。
对话型 LLM 原本就会很好遵循人的请求 这种印象,需要改读为 额外调整回应格式和反应习惯的结果。
也就是说,本节的中心是 怎样让它更像 assistant 一样回应。从这里开始,再进入 这个回答是否可接受、它应以什么为依据回答、它应实际执行什么 这些问题。
区分新增知识和回应习惯调整
- 能以入门水平解释指令调优。
- 能重新整理预训练、微调、指令调优的差异。
- 能说明为什么对话型 LLM 和一般语言模型感觉不同。
- 能把对齐(alignment)读作不同于
是否很好遵循指令的可接受性问题。
这种区分重要,是因为它:
- 让我们超越只把生成式 AI 理解为单纯自动补全的视角
- 把 assistant behavior 分离为单独层
- 把 P6-10.2 的 alignment 问题连接到
为什么需要它这个问题
指令调优的判断标准
指令调优不是加入新知识的阶段,而是让同样的语言能力按照用户请求格式被拿出来的回应习惯调整。
| 判断标准 | 要确认的问题 |
|---|---|
| 调整对象 | 是否是改变回应格式和反应习惯,而不是新增事实 |
| 阶段区分 | 能否分清预训练、微调、指令调优分别改变什么 |
| 用户体验 | 为什么同样的生成结构开始看起来像对话型 assistant |
| 观察场景 | 摘要、步骤、表格、限制告知等回应习惯是否实际改变 |
指令调优想改变什么
经过预训练的模型会学习宽广语言模式。但只有这一点,并不总能让它按用户期待的方式回应。
用下面几个短问题来读,会更容易。
| 问题 | 简短回答 |
|---|---|
| 为什么还需要这种调整? | 因为懂语言和很好遵循指令不是同一件事 |
| 想让它更擅长什么? | 请求格式理解、回答结构、限制告知 |
| 哪里会不同? | 比起下一个词元预测本身,更是回应习惯和格式适配性 |
例如,用户会期待下面这些反应。
- 对问题给出回答
- 请求表格时用表格形式整理
- 请求分步骤说明时按顺序展开
- 对无法完成的请求明确说明限制
这些期待不能只靠很好预测下一个词元就充分保证。指令调优可以看作强化这种符合 用户指令格式 的回应习惯的过程。
也就是说,本节的核心是把 接着写话的能力 和 按请求回答的能力 分开看。
和预训练有什么不同
这个差异最好再次分离。
| 阶段 | 核心问题 |
|---|---|
| 预训练(pretraining) | 是否先学习一般语言模式? |
| 微调(fine-tuning) | 是否按特定任务或领域调整? |
| 指令调优(instruction tuning) | 是否调整为更好遵循自然语言指令? |
指令调优通常可以说明为更好匹配 用户的请求格式 和 期望的回答格式。
也就是说,可以这样整理。
预训练是宽广学习语言的阶段,指令调优是调整回答习惯,使模型更好回应人的请求方式的阶段。
如果把微调也放在一起,可以这样读。
- 预训练:语言的宽广基础
- 微调:特定任务和领域适应
- 指令调优:面向用户请求格式的回应适应
为什么在对话型 LLM 中显得重要
对话型 LLM 中,用户直接用自然语言提出请求。因此,用户期待模型表现出下面这些能力。
- 像是理解了我的问题的反应
- 符合请求格式的回答
- 不过分冗长,或在需要时足够详细的回答
- 结构化的步骤、摘要、示例、警告
这种体验比单纯语言模型更接近 对话型助手式反应。指令调优正是解释这种变化的重要层。
从读者角度看,这一点最容易体感到。即使属于同一模型系列,有些模型会让人感觉 在继续写像样的句子,另一些则会让人感觉 在结构化地跟随我的请求。解释这种差异时,需要指令调优。
指令调优不是万能的
但也不能夸大指令调优。
即使完成指令调优,也不意味着:
- 自动保证事实性
- 自动消除偏见
- 自动完全处理危险请求
- 自动反映外部最新信息
更稳妥的说明如下。
指令调优会强化符合用户请求格式的反应,但不能单独解决事实验证、最新性、安全性整体。
必须先抓住这个边界,才不会把 回答格式变好了 这个事实,和 事实验证、最新性、安全性也一起解决了 的判断混在一起。
指令调优改变的回应习惯
把到这里为止的内容最短地整理如下。
- 预训练是
宽广学习语言的阶段。 - 微调是
更适合特定任务和领域的阶段。 - 指令调优是
调整回应习惯,使模型更好回应人的请求格式的阶段。
必须区分这三者,才不会把 模型知道什么 和 模型如何回答 混成同一个问题。
加上回应格式调整的脉络
flowchart TD
  A["预训练模型"]
  B["指令-回应示例"]
  C["指令调优"]
  D["更像 assistant 的回应"]

  A --> C
  B --> C
  C --> D
这个图让我们把指令调优读作在 语言模型本体 之上加上 回应格式调整 的脉络。因此,在这个图中要确认的结果是,基础模型的一般语言能力和之后叠加的回应格式调整,是否实际被区分为不同层位。
这张图中要读出的核心如下。
- 基础模型已经知道语言
- 追加示例展示
应该怎样回答 - 结果更接近
像 assistant 一样的回应
案例与示例
案例 1. 摘要请求
假设用户在摘要团队文档时请求 请只用三行整理核心。这种请求初看容易觉得 内容正确就可以吧。因为只要模型没有漏掉核心事实,就已经显得相当不错。但实际用户会同时期待长度和格式。指令调整较弱的模型,可能只会继续写一段长说明,而无法符合三行格式。例如,核心事实都在,但如果写成一个很长的段落,用户会觉得难以直接贴到聊天工具或报告中。
这里发生的变化,是从 核心事实是否包含 的标准,移动到 请求的长度和格式是否也一起符合 的标准。指令调优会帮助模型不仅匹配 要说什么,也匹配 用什么长度和结构回答,把同样内容变成用户可以直接复用的回应。这里要纠正的误解是 只要事实正确,请求满足度就会自动跟上。因此,这个案例中要确认的结果不是核心事实是否正确而已,还要看三行摘要格式是否实际符合,以及这种格式是否让回答可直接复用。
| 比较点 | 像调整前的回应 | 反映指令格式的回应 |
|---|---|---|
| 三行摘要 | 有核心内容,但扩成一段或超过三行 | 把核心按三行结构分开 |
案例 2. 分步骤说明
制作内部培训资料时,用户可能请求 请用新员工能跟着做的 3 步说明。在这个场景中,容易觉得模型只要知道内容,结构也会自然符合。但即使是人,也不会因为知道信息,就自动符合 3 步 和 容易跟随的顺序。一般语言模型可能会任意混合说明顺序,或无法符合请求的步骤数。例如,如果在准备步骤之前先讲例外处理,内容即使正确,实际跟着做也会更难。也就是说,有信息 和 用容易教学的结构说出来 是不同能力。
这里发生的变化,是从 是否知道内容 的标准,移动到 是否同时守住请求的步骤数和展开顺序 的标准。经过指令调优的模型,会朝着更自然反映 步骤数、说明顺序、符合读者水平的展开 等要求的方向调整。这里要纠正的误解是 内容正确,教学结构也会自动跟上。因此,这个案例中要确认的结果不是说明内容是否正确而已,还要看 3 步顺序和容易跟随的展开是否维持,步骤之间的依赖顺序是否也没有错位。
| 比较点 | 像调整前的回应 | 反映指令格式的回应 |
|---|---|---|
| 3 步说明 | 有内容,但步骤数或顺序摇晃 | 维持准备、执行、检查这样可跟随的顺序 |
案例 3. 拒绝和限制告知
用户可能要求查看没有内部权限的文档,或在没有可确认依据的情况下要求断定性回答。这个场景中,容易觉得模型亲切地一直回答就是好回应。所以只要回答继续下去,看起来服务质量也会更高。但此时如果无条件继续回答,可能导致错误信息或权限违规。例如,如果模型猜测并摘要自己无法访问的文件内容,就既无法遵守实际文档访问控制,又可能传播错误内容。此时需要的不是 回答到底的诚实努力,而是 知道在哪里停下的回应习惯。
这里发生的变化,是从 是否把答案继续写下去 的标准,移动到 是否结构化提出拒绝理由和安全的下一步行动 的标准。指令调优也会用于强化回应习惯,让模型结构化说明 为什么不能做、可确认的替代方案、下一步需要的信息。因此,这个案例中要确认的结果是,不是无条件继续回答,而是拒绝理由和安全的下一步行动是否一起呈现,用户需要的下一项输入或批准条件是否也一起显现。
| 比较点 | 像调整前的回应 | 反映指令格式的回应 |
|---|---|---|
| 限制告知 | 猜测无法访问的内容并继续回答 | 分开说明不能做的理由和可行的安全下一步 |
把三个案例从回应习惯角度重新归在一起,可以整理如下。
| 情况 | 只有基础模型时容易摇晃的部分 | 指令调优更想抓住的部分 |
|---|---|---|
| 摘要请求 | 长度和行数等格式约束 | 维持请求的结构和分量 |
| 分步骤说明 | 步骤数和展开顺序 | 面向读者的引导脉络和步骤结构 |
| 拒绝和限制告知 | 无条件继续回答的习惯 | 提出拒绝理由和安全下一步 |
需要指令格式调整的场景
读完本节之后,即使还不知道对齐或 RLHF 细节,也可以先练习区分当前卡住的是 内容不足问题,还是 指令格式调整问题。如果格式正确但最新规定或依据事实经常错,就要看缺少的是新知识或依据连接,而不是只看它像 assistant 一样回答。核心事实正确但经常违反 三行 这样的请求格式时,问题可能不是事实性,而是指令格式遵守习惯较弱。说明内容正确但步骤数和展开顺序摇晃时,可能比新增知识更需要符合请求结构的回应习惯。对不能完成的请求也一直答下去、限制告知很弱时,首先显现的是拒绝和限制告知习惯调整,而不是内容生成。
这里重要的不是认为 指令调优会加入新知识,而是先把 说什么 和 怎么回答 读作不同问题。
这里经常混在一起的还有下面几点。
- 容易把知道事实的能力和遵守请求格式看成同一种能力。
- 容易认为内容正确时,格式和限制告知也会自然跟上。
- 容易夸大指令调优,认为它能一次性解决最新性、事实性、安全性。
因此,本节的收束点,是把 指令调优是调整回应习惯和格式的层 这句话变成实际判断标准。
练习与示例
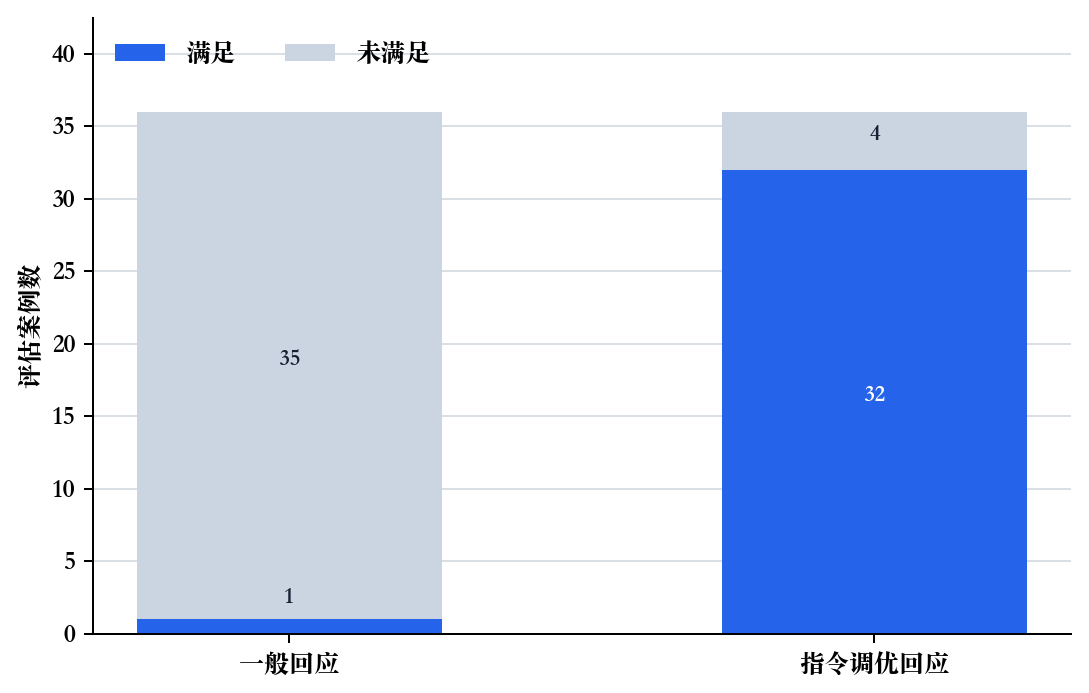
这个示例的目标不是复现真实指令调优训练整体,而是通过评估日志确认,即使面对 同一组事实,回应习惯也会如何不同。它不是只直接比较四个请求,而是从 36 个请求评估记录中,汇总 三行摘要、3 步说明、表格整理、依据不足时限制告知 满足了多少。
下面的代码使用指令执行评估 CSV p6_9_1_instruction_following_eval-zh.csv。代表性原始回应日志另放在 p6-9-1-instruction-response-log-zh.csv。评估 CSV 的一行是一个用户指令评估案例,回应日志 CSV 的一行是在同一案例中观察到的一般回应或指令格式反映回应。
核心列是 request_type、requested_signal、base_*、tuned_*。requested_signal 告诉我们要看哪种指令遵守信号,例如行数、编号步骤、表格行数、不确定性标记。
base_* 列是在一般回应中观察到的格式信号,tuned_* 列是在反映指令格式的回应中观察到的格式信号。reader_hint 和 base_observation 列不是替代答案的列,而是在打开 CSV 时提示应观察什么格式差异的辅助说明。回应日志 CSV 是用来确认这些信号来自哪些原始回应的辅助资料。部分 tuned_* 行也故意保留为未通过标准。这样才能把指令调优读作提高回应格式遵守率的调整,而不是完美答案装置。
这段代码不会用自然语言理解直接评分原始回应。人先看原始回应,观察行数、编号步骤数、表格行数、限制告知标记等结构信号,并记录在 CSV 中;代码再用相同标准汇总这些观察信号。因此,这个示例的学习点不是 实现自动评分器,而是观察指令调优时应分离哪些输出信号。
要确认的核心是,instruction tuning 不是新增事实,而是即使内容相同,也可以读作更稳定匹配请求输出格式和指令遵守率的变化。
执行结果示例可以这样阅读。
所以,这个示例中要确认的结果不是一两个成功案例,而是多个请求类型中,一般回应和反映指令格式的回应之间,通过模式如何变化。基础回应在某些请求中也可能偶然符合格式,但把 36 个案例合在一起看,请求格式遵守率会从 0.03 变为 0.89。同时,反映指令格式的回应也有 4 个案例没有通过标准。这种差异正让我们把指令调优读作 回应习惯调整,而不是 新增知识 或 自动完美化。
把摘要统计画成图,一般回应和指令调优回应的差异会更简单地显现。这里的 0.03 -> 0.89 不是一般性能分数,而是按上面标准统计本示例 36 条评估日志得到的观察值。即使用同一组事实,指令调优回应也会朝着在多种请求格式中更稳定提高满足率的方向改变输出规则。同时仍有 4 个未满足案例,所以这张图也让我们把指令调优读作提高请求格式遵守率的调整,而不是完美答案装置。
读者可以在这个示例中直接尝试下面的调整。
- 在 CSV 中添加
two_sentence_summary、pros_cons_table等新请求类型 - 把
three_line_summary的通过标准从lines == 3改成lines <= 3,观察结果如何变化 - 把
limitations标准改得更严格,要求同时有一段限制告知和追加信息项 - 打开故意保留为失败的
tuned_*行,确认哪些请求格式仍然漏掉标准
这个示例中要读出的核心如下。
- 即使问题相同,回应格式要求也可能不同
- 一般回应即使能成功接着写内容,也常常漏掉格式要求
- 指令调优后的回应会更稳定地把用户请求的结构反映为实际输出信号,但不会自动解决所有案例
- 尤其是
摘要、步骤、表格、限制告知这样彼此不同的回应习惯,指令调优会帮助一个模型更稳定地取出这些习惯,但剩余失败仍要在评估和对齐阶段再确认
也就是说,把指令调优理解为改变 如何回答 的层,通常比理解为改变 知道什么 更好。
回应方式调整中变化的格式
这个压缩比较显示,instruction tuning 与其说是注入新知识,不如说是让已有基础能力更好地以用户请求格式表现出来的层。尤其在这里,即使用同一组事实,当请求习惯变成 三行、3 步、表格、限制告知 时,输出规则也必须一起改变。不过,正如剩余失败案例所显示的,格式遵守率提高并不意味着事实性、最新性、安全性也已经解决。因此下一节会再次区分 很好遵循的回答 和 可接受的回答。
检查清单
- 能否把指令调优解释为调整
如何回答而不是知道什么的层? - 能否再次区分预训练、微调、指令调优分别改变什么?
- 是否准备好把 P6-10.2 读作区分
很好遵循和可接受行为的问题?
来源与参考资料
- Long Ouyang et al.,
Training language models to follow instructions with human feedback, arXiv, 2022, 确认日期:2026-07-19. https://arxiv.org/abs/2203.02155 - Victor Sanh et al.,
Multitask Prompted Training Enables Zero-Shot Task Generalization, arXiv, 2021, 确认日期:2026-07-19. https://arxiv.org/abs/2110.08207 - OpenAI,
Aligning language models to follow instructions, 2022, 确认日期:2026-07-19. https://openai.com/index/instruction-following/