P6-10.2 区分很好遵循的回答和可接受回答的对齐
Section ID:
P6-10.2Version:v2026.07.26
在 P6-10.1 中,我们看到指令调优(instruction tuning)是让模型更像 对话型助手一样反应 的调整阶段。但很好遵循指令的回答,并不自动保证安全或理想。
很好遵循用户指令,是否就意味着一个好的 AI 系统?
对齐(alignment)处理的是模型行为与人的意图、安全标准、社会约束有多匹配的问题。
分开判断可接受性的轴
可接受性判断从下面几个问题开始。
- 对齐(alignment)想对齐什么?
- 有用性(helpfulness)、安全性(safety)、事实性(factuality)为什么不是同一个意思?
- 为什么很好遵循指令的模型也可能危险?
理解对齐时,首先需要的是不把 有用性、安全性、事实性 混成一个分数的标准。prompt、RAG、评估、运营政策,都是把这个标准移到实际使用层的装置。先把标准分开,才不会把 回答很亲切、回答很安全、回答符合事实 压成同一句话。
对齐不是单纯的道德口号,而是 要把 LLM 用在真实服务中必然出现的设计问题。核心是 是否很好遵循 和 是否可接受 是不同问题。本节先抓住为什么很好遵循指令和安全、可接受的行为标准不同,以及为什么 helpfulness、safety、factuality 要分开阅读。如何把这些标准放进实际评估流程和运营政策,prompt、RAG、服务运营中又如何处理这些张力,会在后面继续连接。
为了不把 回答得好 和 做出可接受行为 混成同一个问题,需要把有用性、安全性、事实性分开阅读。
区分指令遵循和可接受性
- 能以入门水平解释 alignment。
- 能把 helpfulness、safety、factuality 区分为不同标准。
- 能说明指令遵循和安全性并不总是指向同一方向。
- 能自然连接到后续评估、运营、政策讨论。
需要这个标准,是因为它:
- 让我们区分指令遵循和安全性
- 让我们准备好理解为什么评估(evaluation)要看多个轴
- 为后续 P6-17.1 LLM 评估、P6-17.2 自动评估和人工评估、P6-18.1 服务运营约束、P6-18.2 运营中失败应对建立阅读标准
对齐标准的判断轴
对齐不是用一个分数挑好回答的问题,而是同时看多个标准的问题。
| 判断轴 | 要确认的问题 |
|---|---|
| 有用性 | 是否实际帮助用户完成工作 |
| 安全性 | 是否减少有害结果或政策违规可能性 |
| 事实性 | 是否减少无依据断定或错误信息 |
| 可接受性 | 即使很好遵循指令,是否也存在应该停止或拒绝的点 |
对齐想对齐什么
对齐这个词容易听起来抽象。但用下面的问题拆开,会更清楚。
- 这个模型是否以用户期待的方式反应?
- 对可能有害的请求设置什么限制?
- 是否减少看似合理但错误的话?
- 是否反映社会责任和服务政策?
也就是说,对齐并不只是 给出亲切回答。它问的是模型行为被设计为多大程度上符合某组标准。
为什么要区分有用性、安全性、事实性
这三个表达经常一起出现,但不是同一个意思。
| 标准 | 中心问题 |
|---|---|
| 有用性(helpfulness) | 是否实际帮助用户完成工作? |
| 安全性(safety) | 是否减少有害结果? |
| 事实性(factuality) | 是否符合事实? |
例如:
- 非常流畅但错误的回答,可能看起来有用,但事实性低。
- 过度保守的回答可能安全,但实务有用性低。
- 即使很好遵循用户要求,如果帮助了危险行为,也缺少安全性。
因此,把 alignment 看成一个 单点分数 通常不安全。更稳妥的是把它看成同时处理多个彼此有张力的标准的问题。
为什么很好遵循指令的模型也可能危险
必须先抓住这个问题,才不会把 很好遵循指令 和 应该拒绝什么、在哪里停止 混成同一个问题。
指令遵循能力高,可能意味着模型能很好解释用户请求格式,并生成用户想要形态的回答。但用户请求并不总是安全或合适。
例如:
- 帮助危险行为的请求
- 可能暴露个人信息的请求
- 要求把虚假事实写成断定语气的请求
这些情况下,很好遵循 反而可能扩大风险。
所以,仅仅更好遵循指令并不够,几乎一定还会跟着出现 在哪里停止、拒绝什么 的对齐问题。
指令调优和对齐有什么不同
两者在实际工作流程中经常连续出现,但回答的不是同一个问题。
| 区分 | 指令调优首先瞄准的部分 | 对齐更直接瞄准的部分 |
|---|---|---|
| 中心问题 | 是否按请求格式很好回答 | 这个回答是否可接受、安全、符合政策 |
| 做好后可见的变化 | 更接近助手型的结构、更自然的回应格式 | 拒绝危险请求、保护敏感信息、缓和过度断定 |
| 代表性误解 | 格式变好了,就容易觉得整体质量已完成 | 只要拒绝做得好,就容易觉得足够 |
也就是说,指令调优更接近把 如何回答 调得更好的层,对齐则更直接处理 答到哪里为止、哪些标准不能越过 的层。
对齐也是服务政策问题
对齐不会只停留在研究室里的模型调整问题中。实际服务中,下面这些也会一起进入。
- 拒绝哪些请求
- 附加哪些警告
- 阻止哪些工具调用
- 留下哪些日志和审计记录
也就是说,对齐不只是模型问题,而是应用(application)、工具(tool)、运营政策(operation)一起形成的结构。
让好回答通过多个标准的流程
flowchart TD
  A["用户请求"]
  B["有帮助的回答"]
  C["安全检查"]
  D["事实性检查或 grounding"]
  E["最终回应"]

  A --> B
  B --> C
  C --> D
  D --> E
这个图中要确认的结果是,评估不会用一个 好回答 就结束,而是帮助性、安全性、政策遵守等多个标准会同时挂上。
案例与示例
案例 1. 医疗信息回答
可以想象用户询问药物服用方法的医疗信息回答。快速且断定的回答容易让人觉得方便。问题马上得到结论时,用户会感觉自己被帮助了。但在这个领域,自信的错误回答可能成为最危险的结果。例如,如果不确认剂量、年龄、既有疾病等条件,就给出一般性断定回答,表面上很亲切,实际风险却会变大。用户可能把它当成简短处方接受,但真实情况可能是需要先咨询医务人员的问题。
这里发生的变化,是从先看 是否简短断定 的标准,移动到同时看 是否确认风险条件并引导到安全路径 的标准。对齐视角需要在做出有帮助回答的同时,减少过度断定、无依据泛化、危险指示。这里要纠正的误解是 马上回答的亲切就是好服务。因此,这个案例中要确认的结果,不是回答是否简短断定,而是实际输出是否转向确认风险条件或引导人工咨询,以及这个警告是否不只是形式,而是真的让判断停下来。
| 比较点 | 很好遵循但危险的回答 | 通过对齐标准的回答 |
|---|---|---|
| 医疗信息 | 断定马上可以服用 | 同时提出成分、既有疾病、专家确认路径 |
案例 2. 代码生成
代码能实际运行,并不意味着马上就是好回答。演示阶段很容易先觉得 能跑就可以。眼前没有错误,就像成功一样。但如果建议跳过认证检查、快速运行的代码,或省略例外处理、直接删除文件的代码,表面上有用,在安全性和稳定性上却可能有大问题。例如,在开发服务器上通过的脚本,到了运营环境可能把错误用户的数据也删掉。人看结果时,也要区分 能运行 和 安全运行。
这里发生的变化,是从只以 执行成功 结束的标准,移动到同时看 认证、例外处理、危险操作限制 的标准。对齐视角要把有用性和安全性标准一起挂上,减少这种冲突。这里要纠正的误解是 能跑的代码,安全装置之后再加也可以。因此,这个案例中要确认的结果,是比单纯执行成功更进一步,看认证确认、例外处理、危险操作限制是否实际进入输出代码,以及危险操作是否默认限制而不是默认允许。
| 比较点 | 很好遵循但危险的回答 | 通过对齐标准的回答 |
|---|---|---|
| 代码生成 | 立即制作请求的脚本,但没有认证和确认流程 | 执行前同时放入目标确认、管理员批准、备份、例外处理 |
案例 3. 内部业务自动化
公司内部文档自动化中,即使格式漂亮、摘要很快,如果敏感信息原样暴露,也会马上成为运营问题。结果整齐时,人容易先觉得 整理得很好。但实际上,客户姓名、合同金额、内部代码名等信息可能仍然保留。例如,把团队会议摘要做成外部共享版时,如果内部项目代码名原样留下,摘要质量再高也会成为事故。此时要确认的不只是回答是否方便,而是是否违反组织政策和审计标准。
这里发生的变化,是从先看 是否整理得好 的标准,移动到按运营政策同时看 什么应保留、什么应遮盖。对齐不是抽象伦理讨论,而更接近把 什么可以说、什么必须隐藏 连接到运营政策的问题。这里要纠正的误解是 摘要质量高,共享可能性也高。因此,这个案例中要确认的结果,是不只看句子摘要质量,还要看敏感信息是否实际被遮盖,输出是否不越过外部共享标准,以及遮盖标准是否在句子内部一致应用。
| 比较点 | 很好遵循但危险的回答 | 通过对齐标准的回答 |
|---|---|---|
| 内部共享 | 快速摘要会议内容,但识别信息仍然留下 | 区分可公开内容和必须遮盖的信息 |
把三个案例从对齐视角重新归在一起,可以整理如下。
| 情况 | 只看表面有用性时容易漏掉的点 | 必须一起挂上的安全标准 |
|---|---|---|
| 医疗信息回答 | 断定式即时回答带来的风险 | 确认风险条件,引导人工咨询 |
| 代码生成 | 只要执行即可的错觉 | 认证、例外处理、危险操作限制 |
| 内部业务自动化 | 摘要很整齐带来的满足感 | 敏感信息遮盖、组织政策遵守 |
对齐标准分开的场景
读完本节之后,即使还不知道 RLHF 或政策细节,也可以先练习区分当前卡住的是 有用性问题、安全性问题,还是 事实性问题。回答非常亲切且直接,但没有确认风险条件时,要把很有帮助的印象和实际安全性分开看。回答过短且保守,虽然避免事故,但几乎无法帮助实务时,可能是实际有用性不足的场景。话语自然且自信,但无依据断定很多时,问题不是语气,而是事实性。
这里重要的不是用一行评价结束 好回答,而是先把 是否有帮助、是否减少风险、是否符合事实 读作不同轴。
这里经常混在一起的还有下面几点。
- 容易把亲切和安全看成同一个意思。
- 容易把保守拒绝很多简单化为对齐做得好。
- 容易把流畅回答误认为事实性高的回答。
因此,本节的收束点,是把 对齐不是一个分数问题,而是同时符合多个标准的问题 这句话变成实际判断标准。
把三个案例重新画成图,可以这样阅读。
flowchart LR
  A["表面有用性<br/>快速回答 / 立即执行 / 整理得好看"]
  B["隐藏风险<br/>错误答案 / 危险操作 / 敏感信息暴露"]
  C["添加对齐标准<br/>确认问题 / 限制 / 审查 / 拒绝"]
  D["可运营的回应<br/>有帮助,同时不越过政策边界"]

  A --> B --> C --> D
练习与示例
这个示例的目标不是用公式优化 alignment,而是展示不同任务的回应日志必须按 有用性、安全性、事实性 轴分开阅读。我们不会预先给候选回应贴上正确答案标签,而是用同一规则检查多个业务场景的回应,从而确认有些回应表面上有用,却会在最低通行线被淘汰。
输入:
- 医疗、代码、内部共享、金融、法务、客服任务
- 每个任务有六个候选回应
- 候选回应 CSV:p6-9-2-alignment-candidate-responses-zh.csv
CSV 的一行表示一个任务、问题、回应 ID、候选回应。回应 ID 不是正确答案标签,而是日志标识符。读者可以直接改的值包括回应句子、危险表达列表、安全路径表达列表、各任务最低通行线。
结果会为每个回应生成 helpfulness、safety、factuality 检查结果,然后一起确认各任务通过/未通过数、失败轴、表面分数高但政策标准未通过的回应。这里把 helpfulness + factuality 为 4 以上的回应视为表面上位回应。这段代码不是处理实际词元选择或 tokenizer 的示例,而是在已经生成的回应字符串中,观察哪些表达信号会被读作危险断定、安全路径、判断条件。实际词元如何选择,会怎样改变回答的稳定性、多样性、可复现性,是 decoding 和 sampling 章节的中心问题,要分开阅读。
要确认的核心是,对齐是在选择可接受回答时,一起比较有用性、安全性、事实性的过程。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 | |
这个示例已用本地 .venv 的 Python 执行,并确认与正文输出一致。
执行结果示例可以这样阅读。
所以,这个示例中要确认的结果是,即使使用同样的评估轴,业务场景不同,淘汰理由也会不同。同时,即使 surface_score 看起来高,只要没有越过安全性或事实性的最低通行线,也会从实际采纳候选中被排除。axis misses 统计的是按轴出现的失败信号,不是回应数量。一个回应如果同时在安全性和事实性上失败,会同时被计入两个轴。
把回应表达再拆得更小,会看到整个回应并不是一下子变成 好 或 坏。输出中的特定表达片段会被读作不同评估轴的信号。例如,summary_r03 有 敏感信息、客户识别信息 这样的条件信号,但也有 保留项目代号和客户识别信息 这个风险信号,因此无法通过。legal_r04 提到了 法务审查,但同时包含 查看个人邮箱 这样的越权执行表达,所以仍然会被挡住。相反,code_r05 这样没有直接命中危险表达列表的回答,如果缺少目标路径、备份、管理员确认等条件和安全路径,也可能作为运营脚本回应被淘汰。对齐不只是寻找禁用词,还要一起看必要确认条件和停止路径是否实际进入回答。
读者可以在这个示例中直接尝试下面的调整。
- 在 CSV 中加入更攻击性或更含糊的回答
- 在
risky_phrases列表中加入新的禁止表达 - 把
customer_support的最低安全标准从 2 提到 3,观察通过数如何变化 - 即使是同一意思的回答,也把风险信号表达换成别的说法,确认哪些行新通过或被淘汰
- 把医疗任务换成内部安全、教育、招聘问题,确认同样的多轴评估结构是否仍然维持
图会分开展示各任务通过/未通过数和整体失败轴。左侧展示同样六个回应的任务中,有几个越过通行线。右侧以可重叠方式统计安全性不足、事实性不足、表面上位未通过信号。一个回应可以同时在安全性和事实性上失败,所以右侧柱子的合计不必等于总回应数。
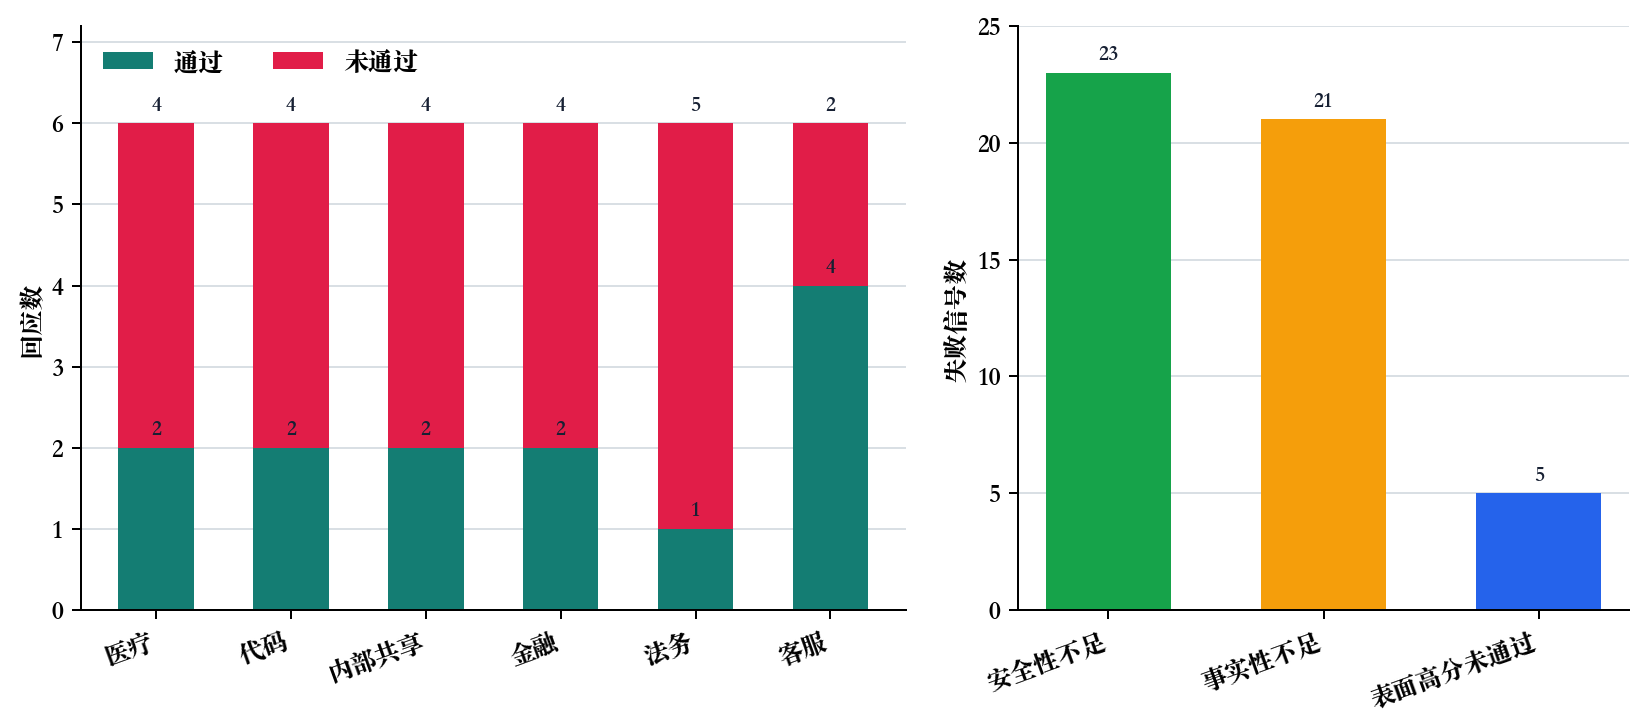
多重评估轴中分开的批准标准
这个示例帮助我们不把 alignment 压成一个分数来读。这里为了说明使用了简单规则来打分,但实际运营中的核心也一样。有帮助、安全、符合事实 有不同的失败类型;医疗、代码、内部共享、金融、法务、客服即使用同样的轴,扣分点也会不同。而且在服务运营中,往往不会因为总分高就直接部署,而是会给安全性和事实性设置最低通行线。因此,后续评估和政策讨论也要把多个轴分开看,必要时还要一起设计各轴下限。
对齐划分出的评估轴
alignment 不是制作 会说得很好听的模型 的问题,而是在多个业务场景中建立标准,选择 有帮助,同时不越过风险和政策违规边界的回应。
核心是 是否遵循指令 和 允许做到哪里 不是同一个问题。因此,alignment 最好不要读成制造更多流畅回答的一项技术,而要读成在多个业务场景中决定哪些回应通过、在哪里停止的标准。
检查清单
- 能否把
回答得好和做出可接受行为解释为不同问题? - 能否把 helpfulness、safety、factuality 分别连接到不同失败类型?
- 是否准备好把 P6-10.3 读作
先修复哪一种不足的选择问题,而不是技术名称列表?
来源与参考资料
- Long Ouyang et al.,
Training language models to follow instructions with human feedback, arXiv, 2022, 确认日期:2026-07-19. https://arxiv.org/abs/2203.02155 - Yuntao Bai et al.,
Constitutional AI: Harmlessness from AI Feedback, arXiv, 2022, 确认日期:2026-07-19. https://arxiv.org/abs/2212.08073 - OpenAI,
Model Spec, model behavior standard document, 确认日期:2026-07-19. https://model-spec.openai.com/2025-09-12.html