P6-10.4 补充学习:LoRA 的 low-rank 所小幅表示的调整分
Section ID:
P6-10.4Version:v2026.07.26
在 P6-9.2 中,我们把 LoRA 看成 在大型基础模型上添加小调整分,从而降低完整微调负担的方法。只用这个说明,也能抓住大致的成本感。但实际文档里很快会连续出现 Low-Rank Adaptation、rank、adapter、QLoRA 这样的名字。如果一次解释所有名字,补充学习本身会变得太大,初学者也容易错过首先该抓住什么。
本节先集中看 LoRA 本身。目标不是实现真实 LoRA,而是把 LoRA 这个名字拆成 它想把什么小幅表示 和 它为了什么目的进行适应 来读,并抓住 low-rank 这个词是贴在 更新的表示方式 上,而不是贴在模型本体大小上。adapter、LoRA、QLoRA 之间的细节比较,会在下一节补充学习 P6-10.5 中继续。
先拆开阅读 Low-Rank Adaptation
LoRA 是 Low-Rank Adaptation 的缩写。如果一开始就追着 rank 的线性代数含义或矩阵分解公式走,实现细节会比主线先变大。这里先按下面方式读这个名字就足够。
| 名字片段 | 首先抓住的意思 |
|---|---|
| Low-Rank | 比起原样学习整个巨大变化,尝试用更小形式表示变化分 |
| Adaptation | 不是从头新建基础模型,而是让已有模型适应目的 |
这里的 小 不是说模型本体变小。基础模型仍然很大。LoRA 想减少的是 再次大规模改变整个基础模型的负担。也就是说,它尽量保持巨大的本体,只把目的所需的变化作为小调整分单独学习后贴上去。
为什么叫 low-rank
极简地说,LoRA 的想法是:不要重新写完整的大权重,而是用更小的调整结构来近似。
在这个阶段,可以这样理解。
- 原始权重矩阵非常大
- 但任务适应所需的整个变化不一定总是同样巨大
- 因此会出现一种想法:用两个较小调整矩阵相乘的方式来表示
变化分
也就是说,LoRA 从这样的视角出发:比起 整个基础模型,为任务而改变的部分 可能可以具有更小的结构。
LoRA 不是重新学习整个大型模型,而是尝试只把必要变化分表示成更小的结构。
这里重要的是,LoRA 并不表示另外做一个 小模型。核心是不要重新写已有的大权重,而是把任务适应所需的更新表示成更小结构。所以 low-rank 这个词更接近贴在 更新的表示方式 上,而不是模型大小本身。
LoRA 接在模型哪里
第一次读 LoRA 时,常常会卡在 LoRA 是接在模型外面,还是模型里面。
更稳妥的说明如下。
- 基础模型的原始权重大体保持固定
- 在 attention 等核心线性变换层附近放置小的、可学习的调整分
- 实际输出可以理解成
原始权重的计算结果 + 小调整分的计算结果
也就是说,LoRA 不是完全另做第二个模型,而更接近在 基础模型内部的部分线性变换上添加小的校正装置。
练习和示例
这个示例的目标不是实现真实 LoRA,而是按 rank 比较 整个大矩阵 和 小 rank 调整分 的规模差异。
下面代码使用基础权重大小和多个 rank 值。结果中会确认完整矩阵参数数、各 rank 的 LoRA 调整分参数数,以及相对完整矩阵的比例。
要确认的核心是,LoRA 的核心在于不学习整个矩阵,而只学习小 rank 调整分,从而大幅减少所需参数数。
看示例之前,可以先像下面这样预测。
| 比较场景 | 执行前先预测的变化 | 为什么这个预测重要 |
|---|---|---|
从 rank=4 到 rank=32 | 调整分参数数和比例一起变大 | rank 会增加表达余地,但成本也会一起增加。 |
| 比较完整矩阵和 LoRA 调整分 | LoRA 调整分比例会非常小 | 这有助于把 高效调整 读成规模差异,而不是口号。 |
| 并排看多个 rank | rank 越小,快速实验越有利,但表达余地可能更受限制 | 数字并不表示 越小一定越好。 |
这个示例已用本地 .venv 的 Python 执行,并确认与正文输出一致。
执行结果示例可以这样阅读。
这些数字不是在主张某个特定产品的真实设置。它只是展示下面的感觉。
- 完整权重矩阵非常大
- 小 rank 调整分可以小得多
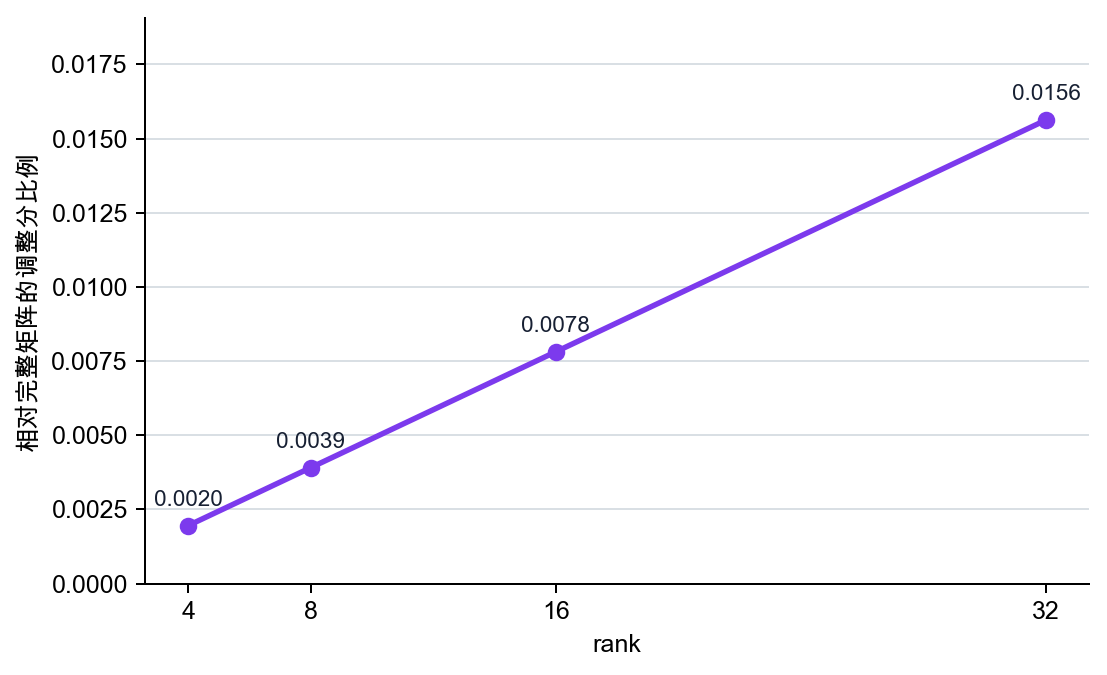
- rank 变大时,调整表达力可能增加,但调整分规模也会一起变大
这个差异能帮助理解为什么会出现 高效调整 这个说法。
下面图表再次展示 rank 变大时,LoRA 调整分比例如何一起变大。这里的核心不只是调整分比完整矩阵小,还包括 rank 选择是同时改变成本和表达余地的把手。
示例之后,更重要的是把数字重新翻译成结构选择。
| 从数字中直接读出的内容 | 如果误读数字会产生的误解 | 连接到下一判断的问题 |
|---|---|---|
| rank 越大,调整分规模也越大 | 可能误以为 rank 变大也仍然 免费变轻 | 当前瓶颈是表达力不足,还是资源约束 |
| 相对完整矩阵,调整分比例非常小 | 可能把 LoRA 误解成 新做一个小模型 | 是否需要保持基础模型,只分离变化分的好处 |
| 只靠小 rank 比较无法确定质量 | 可能误以为只看数字就能立刻选择最终方式 | 当前阶段是最终性能确认,还是快速探索 |
检查清单
- 能把 LoRA 展开为
Low-Rank Adaptation来说明。 - 能把 low-rank 解释为更新表示轴,而不是模型本体大小轴。
- 能把 rank 变大时调整分规模也一起变大这件事,读成成本和表达余地之间的平衡。
出处和参考资料
- Edward J. Hu et al., LoRA: Low-Rank Adaptation of Large Language Models, arXiv, 2021, 确认日期: 2026-07-19.