P6-11.1 调整输入指令、上下文、示例的提示工程
Section ID:
P6-11.1Version:v2026.07.31
把本节转成练习记录时,要分开 user_goal、instruction、context、example、output_format、observed_response、remaining_limit。这样,用 prompt wording 能调整的问题,就不会和必须交给搜索、工具、评估结构的问题混在同一层位。
在 P6-10.2 中,我们看到对齐(alignment)不只是让回答变亲切的问题,而是有用性、安全性、事实性、服务政策一起牵涉进来的设计问题。接下来要看用户最先能直接握在手里的工具。
用户实际上怎样观察和调整 LLM 的行为?
提示工程(prompt engineering)是一种实践方法:通过设计输入来观察模型反应,并把反应调整得更接近想要的格式和条件。
换成更容易的话,可以这样说。
提示是告诉模型要回答什么、用什么方式回答的第一个调整点。
输入设计承担的工作
- 提示工程调整什么?
- 为什么提示成为 LLM 使用体验中的第一个工具?
- 哪些指令、上下文、示例在实际中有帮助?
核心是,提示是 观察并调整当前模型反应的输入设计。Chain-of-thought、self-consistency、automatic prompt optimization 是在提示层处理中间步骤或候选比较的策略,而提示的限制会在需要最新依据和真实执行结构的地方显现。
提示不是 魔法咒语。把它读成观察并调整模型行为的输入设计工具更安全。
提示这一章是在看过预训练、微调、对齐之后,阅读 用户现在马上能调整的输入设计,确认它的限制,然后过渡到 RAG 和工具使用的区间。当前阶段的问题是:当前模型反应能通过输入设计改变到什么程度。模型权重调整仍然留在微调层位,最新依据连接和真实执行连接会在 RAG、tool use、AI agent 结构中再看。
这里首先要改变的印象,不是 写好句子的诀窍,而是 观察并调整当前模型反应的输入设计。
区分输入设计能解决的问题和要交给结构的问题
- 能用入门水平说明提示工程。
- 能区分指令(instruction)、上下文(context)、示例(example)的作用。
- 能说明为什么提示成为快速实验和行为观察的出发点。
- 能把提示的限制读成
只靠输入设计无法确认的问题。
许多刚开始使用生成式 AI 工具的用户,最先通过提示体会到 同一个模型也会随着输入设计不同而有不同动作。所以提示最好读成用户在 RAG、tool use、AI agent 之前最先遇到的直接控制装置。
这个视角重要的原因可以整理如下。
- 即使不了解模型结构,也能开始观察行为。
- 能连接到后续 RAG、tool use、AI agent 中为什么输入设计仍然重要。
- 同时帮助 P6-11.2 分离只靠提示无法解决的限制。
首先要分开的场景是:答案出来了,但长度和格式摇摆;同一任务中读者水平或语气持续偏离;回答看似合理,但最新性或依据不稳。前两种情况可以先看指令、上下文、示例中哪一项空着。相反,如果问题是最新文档、真实依据、计算·查询·执行成功,那么只把输入句子写得更精细,可能仍然无法确认。
以这个区分为标准,提示工程就能从 好句子诀窍 更直接地读成 在输入设计中先解决问题,并区分哪些问题需要改变结构的第一个控制点。
提示改变什么
提示通常不改变模型内部权重。它改变的是输入。
| 问题 | 简短回答 |
|---|---|
| 用户直接改变的是什么? | 输入句子和条件 |
| 还没有改变的是什么? | 模型内部权重 |
| 所以提示的作用是什么? | 更好引出当前模型反应的输入设计 |
也就是说,用户设计下面这些内容。
- 请求模型做什么
- 一起提供什么背景信息
- 希望答案使用什么格式
- 展示什么示例
提示不是重新训练模型,而是更好引出当前模型如何反应的输入设计。
从服务结构角度看,提示是 还没有接外部文档、外部工具之前,最内侧的控制点。
提示能直接改变的东西和不容易改变的东西
刚学提示时,很容易觉得只要输入句子写得好,所有问题都能解决。但提示清楚地分成 能直接改变的层 和 只靠它不容易改变的层。
| 提示首先容易改变的东西 | 只靠提示不容易改变的东西 |
|---|---|
| 回答长度和格式 | 最新信息访问 |
| 说明顺序和语气 | 外部系统查询和执行 |
| 跟随示例的输出模式 | 计算准确度保证 |
| 要求查看范围和依据的指令 | 长期领域风格的完全固定 |
也就是说,提示擅长改变 怎样引出当前模型反应,但不能替代 模型外的信息、执行结构、持续适应 本身。
这个差异可以再简短地整理如下。
| 先用提示试的问题 | 只靠提示无法确认的问题 |
|---|---|
| 能让答案更短、更长、更结构化吗? | 能让模型实际读取最新文档吗? |
| 能减少同一模型的格式摇摆吗? | 能保证计算准确度和执行成功吗? |
| 能通过示例让反应模式更稳定吗? | 能完全结束长期风格固定或持续适应吗? |
看见这个摘要,也就一起抓住了提示限制的核心。提示是 更好引出当前模型反应的第一个控制点,但不是负责 超出限制的结构保证 的手段。
为什么提示成为第一个工具
原因非常实际。
- 可以马上尝试
- 成本相对小
- 不需要重新训练模型
- 失败后可以马上修改并重新观察
也就是说,提示工程是 LLM 时代的 最快实验工具。
所以许多用户在理解算法之前,先通过提示体会模型的性格。这一点在学习顺序上也重要。使用经验先来,之后理论再跟上解释为什么会出现那样的反应。
构成提示的基本元素
实践和学习中最常见的构成有下面三种。
| 元素 | 中心问题 |
|---|---|
| 指令(instruction) | 请求模型做什么? |
| 上下文(context) | 一起提供什么背景信息或资料? |
| 示例(example) | 展示什么输入-输出模式? |
把这三项分开后,提示会显得不那么抽象。
把同一个请求写得更结构化,可以用下面的最小流程来看。
| 顺序 | 用户决定的内容 |
|---|---|
| 1 | 请求模型做什么 |
| 2 | 提供什么作为参考 |
| 3 | 希望答案采用什么格式 |
指令决定什么
指令决定任务目标。
例如:
请用三行总结请按读者水平解释请整理成表格
这样的句子告诉模型 应该做什么。
上下文决定什么
上下文决定模型应该参考的背景和范围。
例如:
- 原文文档的一部分
- 公司内部政策
- 前面的对话内容
- 术语定义
如果没有这些信息,模型更可能用一般模式填补空白。因此,上下文和准确度关系很深。
示例决定什么
例如:
- 一个问题和答案对
- 一个输入和分类标签对
- 一个原文和摘要文对
这些示例给出 用这种方式回答即可 的形式信号。few-shot prompting 让人觉得有用的原因就在这里。
也就是说,示例不太是放入更多内容的装置,而更接近展示 应该跟随什么格式和反应模式 的装置。需要确认的结果是:加上示例后,模型是否不仅生成内容,还更接近地遵循要求的格式和反应模式。
提示工程也是观察工作
必须先抓住这个表达,才不会把提示工程读成简单的句子装饰,而会读成观察输出如何随输入变化、寻找失败模式的工作。更准确地说,它接近一种反复实验:
- 改变输入
- 观察输出如何变化
- 寻找失败模式
- 寻找更稳定的表达
也就是说,提示工程既是 句子感,也是 行为观察实验。
这一点重要,是因为即使接上 RAG 或工具使用,用户仍然要先设计 写什么请求、怎样写请求。
提示应在 Part 6 主线中读成用户最先触碰的实务控制点,并连接到之后还需要什么结构。
最短要抓住的结构是 提示输入调整 -> RAG 依据连接 -> tool use/AI agent 执行结构。在提示输入调整中,我们问什么输入能更好引出想要的格式和范围;在 RAG 中,我们问提示不足时要接什么依据;在 tool use 和 AI agent 结构中,我们再问文档不足以完成的执行由什么完成、按什么顺序继续。提示在这个流程中承担 输入调整,一旦看到限制,就要分别接上依据连接和执行结构。
这里首先要留下的是实验备忘和格式检查统计:尝试了什么输入设计,答案里哪些项目经常缺失,格式在哪里摇摆。有了这个记录,P6-11.2 才能重新检查提示限制,也能不动摇地转到 P6-12.1 的依据连接判断或 P6-14.1 的执行需要判断。越往后,这个记录会再次被读成 P6-16 的评估标准,以及 Part 6 的回顾备忘、执行记录、改善计划。
极简图示
flowchart TD
  A["指令"]
  B["上下文"]
  C["示例"]
  D["提示"]
  E["模型响应"]
  F["观察并修改"]

  A --> D
  B --> D
  C --> D
  D --> E
  E --> F
这个图的核心是:提示不是写一次就结束的句子,而是观察和修改持续进行的工作。
案例和示例
案例 1. 摘要任务
可以想象用户贴上一段很长的会议记录,只写 帮我总结 的场景。这种情况下,人们容易期待模型会自己选择合适长度和重点。但模型必须自己猜测长度、语气、重要度标准,所以有的答案可能太长,有的答案可能漏掉核心结论。同一份文档,用于高管报告的摘要和用于实务交接的摘要,需要保留的内容可能不同。
人首先要做的不是寻找更聪明的模型,而是明确写出 几行、给谁看的摘要、要保留什么。这里的变化,是从只写 帮我总结 就结束,转向看是否明确了长度、读者、保留标准。像 按读者水平用三行总结 这样同时给出长度和读者水平,输出摇摆会减少。否则内容即使正确,可能对报告来说太长,对交接来说又太稀疏。因此这个案例要确认的结果是:明确摘要长度、读者、保留标准后,输出范围和格式摇摆是否实际减少,同一文档是否能按用途稳定跟随不同结构。
这个案例之所以是真实工作场景,是因为同一份会议记录,只要读者不同,好摘要 的标准就完全不同。高管可能只想快速看决定和风险,实务负责人则可能需要更长地确认后续动作和未解决事项。如果提示里不写出这个差异,模型就会依赖一般摘要模式生成答案。于是有时 结论 先出现,有时背景说明变长,有时必须保留的行动项消失。也就是说,摘要案例的核心不是把句子写得更漂亮,而是在输入中先固定 丢掉什么、留下什么。
比较同一份会议记录用于不同用途时应该先写什么,会更清楚。
| 同一原文文档 | 只有模糊的 总结一下 时容易摇摆的内容 | 提示中首先要明确的内容 |
|---|---|---|
| 高管报告用会议记录 | 背景说明可能变长,结论可能后移 | 行数、决策中心、保留风险项目 |
| 交接用工作记录 | 决定还在,但下一步行动和负责人可能消失 | 读者、要保留的槽位、后续工作优先 |
| 客户共享用公告草稿 | 内部术语和未定信息可能混入 | 外部读者标准、可公开范围、语气 |
这个比较的核心是,摘要质量 不是只由模型性能决定。这里要纠正的误解是 同一份文档大致只有一种好摘要。实际上,读者和目的一变,首先变化的是需要保留的信息结构。
案例 2. 分类任务
可以想象客服分类任务中,只给 退款、配送、账户、错误 这些标签。标签名称很直观时,人们容易期待模型也会类似地理解边界。但人只看标签名时,也可能按各自方式解释边界,答案会摇摆。例如 配送晚了,所以我想退款 这样的句子同时包含 配送 和 退款,该优先哪个标签会变得含糊。
这时一起提供输入示例和标签示例,模型会更稳定地读出 这种句子送到这个标签 的模式。没有示例时,相似咨询可能每天进入不同队列,运营处理顺序也会摇摆。这里的变化是从 只给标签名也够,转向看是否需要展示标签边界的示例。因此在分类案例中,提示不是从无到有创造正确答案,而是让标签解释边界更清楚。这个案例要确认的结果是:比起只给标签名,加入输入示例和标签示例后,相似咨询是否更一致地汇入同一队列,边界案例中优先级是否更少摇摆。
这个案例也直接连接到真实运营。咨询分类不是猜标签名的游戏,而是把同性质请求送到同一处理流程。标签边界没有在输入中明确时,模型和人工审核者都容易各用各的标准。如果某天 配送延迟导致退款请求 被送到 配送,第二天又被送到 退款,后续处理团队和 SLA 都会一起摇摆。因此分类提示中重要的不是漂亮说明,而是用示例固定 边界案例放在哪里。
实务中特别能暴露提示设计水平的是下面这些咨询。
| 边界咨询场景 | 只有标签名时容易发生的摇摆 | 示例中首先要固定的内容 |
|---|---|---|
配送晚了,所以我想退款 | 配送 和 退款 之间优先级摇摆 | 复合咨询的一阶优先标签 |
无法登录,所以不能取消订单 | 账户 和 退款 之间路由不同 | 以障碍原因为中心,还是以业务结果为中心 |
出现错误,最后付款也没成功 | 错误 和 支付/退款 边界摇摆 | 系统错误优先规则和后续队列移动规则 |
这个表中重要的是,示例不是简单说明补充,而是把运营规则放进模型输入的装置。必须抓住的标准是:标签名直观 和 所有边界案例稳定进入同一队列 是不同问题。
案例 3. 文档问答
假设在文档问答中,用户问 按照这个政策,家人也可以一起登记吗?。人们容易期待,只要问题足够具体,回答就会停留在那个范围里。但如果只给问题,模型可能混入一般福利制度常识,增加偏离实际文档范围的风险。
人首先要做的不是问得更啰嗦,而是一起提供相关规定段落,并给出 只在这个范围内回答 的上下文。如果再加上 先引用依据句子,再简短解释 这样的格式条件,回答结构也会更稳定。否则即使回答看似合理,也可能给出和实际内部规定不同的指引。
这里的变化是从 问题写好就够,转向看是否一起提供了答案应该绑定的文档范围和依据格式。这样,响应会比一般常识更接近贴上的文档范围。因此这个案例要确认的结果是:加入相关段落和依据格式后,答案是否比一般常识更接近实际文档范围,回答是否避免不必要地扩展到依据句之外。
在文档问答中,提示承担的角色与其说是 找文档本身,不如说是固定已经贴上的文档应该怎样被阅读。例如同一段规定文本,写 只回答 时,模型可能省略依据只给结论;写 先写依据句,再解释 时,回答结构会改变。因此这个案例不是说 提示能解决一切,而是说明即使文档已经存在,输入设计仍然会大幅改变结果结构。
三个案例可以从输入设计角度重新整理如下。
| 情况 | 只有模糊请求时摇摆的内容 | 提示中首先要明确的内容 |
|---|---|---|
| 摘要任务 | 长度、读者、保留核心 | 行数、目标读者、重要度标准 |
| 分类任务 | 标签边界和优先级 | 标签示例、边界案例 |
| 文档问答 | 回答范围和依据限制 | 参考段落、引用方式、解释范围 |
三个案例还可以进一步压缩成下面这样。
flowchart LR
  A["模糊请求<br/>总结一下 / 分类一下 / 回答一下"]
  B["摇摆的输出<br/>长度 / 标签边界 / 依据范围"]
  C["结构化提示<br/>指令 + 上下文 + 示例"]
  D["更稳定的响应<br/>格式 / 范围 / 模式保持"]

  A --> B --> C --> D
核心不是 更华丽的句子,而是找到 必须明确什么,摇摆才会减少。
输入设计首先能减少的场景
修改提示时最常漏掉的是,把 把句子写得更长 和 先固定摇摆的标准 看成同一件事。实际上,比起修饰表达,更重要的是先分离当前结果在哪个槽位摇摆。
| 观察到的摇摆 | 首先固定的提示元素 | 为什么要先处理它 |
|---|---|---|
| 比起事实内容,格式和长度先摇摆 | 任务指令(instruction) | 当前问题中心如果是输出形状,而不是最新文档或执行,那么在增加其他结构前,先固定输入指令更合适。 |
| 摘要长度忽长忽短,读者水平不合适 | 任务指令(instruction) | 先固定几行、给谁看的摘要,长度和语气才会一起稳定 |
| 分类结果会出来,但每到边界案例标签就变化 | 示例(example) | 只说明标签名时边界优先级较弱,复合案例示例能抓住判断边界 |
| 文档问答漏到一般常识 | 上下文(context) | 比起继续修饰问题,先绑定参考段落和回答范围,才能减少依据外扩展 |
把同一张表改成实务问题,会更清楚。
| 如果看到这种场景 | 先问的问题 |
|---|---|
| 答案大体正确,但形状总是摇摆 | 现在需要的是增加新结构,还是把输入指令写得更清楚? |
| 答案太长或太短 | 除了 要做什么,是否充分写了 要留下什么格式? |
| 相似咨询进入不同标签 | 是否把边界案例作为示例展示了? |
| 混入没有依据的说明 | 是否实际把模型应参考的文档范围放进输入? |
首先要学会的标准很简单。提示工程不是 把句子改得更像样的技术,而是寻找 任务指令、上下文、示例 中哪里空着导致结果摇摆,并填上那个槽位的输入设计。
练习和示例
这个示例的目标不是 写出一次好句子,而是直接观察:把同一任务反复应用到多个请求卡片时,哪种提示会产生更稳定的结果。真实服务中,提示评价也比起一次漂亮输出,更常看 在多个输入中格式和核心项目是否持续保持。
这次示例不使用人工写出的响应函数,而是读取观察模型响应时使用的保存日志格式。p6_10_1_generate_prompt_response_log.py 实际调用 Ollama 本地模型,并按 模型响应原文 -> 格式信号和核心词保留情况 -> CSV 观察记录 的顺序压缩保存。正文基本示例读取已经执行好的 CSV 日志。这个 CSV 是在特定模型、设置值、执行时点生成的快照日志。执行结果会因模型和版本而不同,所以正文要看的不是某一句具体句子,而是 只写任务的提示、给出指令和上下文的提示、连示例也给出的提示、示例和检查指令都给出的提示 的检查统计如何变化。
假设客户支持团队每天要把多条运营备忘简短总结。简单请求会自由总结,但运营上必须保留的项目可能会消失。给出指令和上下文后,读者、行数、必须保留的项目会更明确。再加上示例,模型会更直接地看到 应该跟随什么样的答案形状。
下面示例比较四个运营备忘在四种提示类型下的保存响应日志。比较标准是按备忘重复响应、行数、编号格式、核心项目保留率、槽位缺失情况、按提示类型的整体摘要统计。执行生成脚本时,英语提示会被传给 Ollama 本地模型,响应以同样 CSV 列保存。保存日志同时包含 log_source、model_name、temperature、slot_language 列,方便确认记录来自什么执行环境。正文为了可复现的阅读流程,先读取已执行好的保存日志 CSV。
先用表查看提示设计差异,如下所示。
| 比较项目 | 只写任务的提示 | 指令+上下文提示 | 指令+上下文+示例提示 | 指令+上下文+示例+检查提示 |
|---|---|---|---|---|
| 任务指令 | 请总结 | 给运营负责人看的 3 行总结 | 维持同一指令 | 维持同一指令 |
| 上下文 | 只有运营备忘 | 同时有运营备忘和读者目的 | 维持同一上下文 | 维持同一上下文 |
| 示例 | 无 | 无 | 有三行槽位输出示例 | 有同一示例 |
| 追加控制 | 无 | 无 | 无 | 有禁止导入句和核心事实检查指令 |
| 检查标准 | 人凭眼看 | 检查行数、槽位、关键字保留率 | 用同一标准反复比较 | 用同一标准反复比较 |
代码中要确认的核心是,输入中加入指令、上下文、示例后,不仅答案内容,格式可检查性和事实保留情况也可能一起改变。即使把 temperature 降到 0,模型响应也不是完全固定的计算结果,所以要一起看多个卡片和多次重复日志的统计,而不是一次结果。
保存响应日志位于 p6-10-1-prompt-response-log.csv。一行是一个模型响应观察记录。核心列是 prompt_type、card_name、log_source、model_name、temperature、line_count、numbered_lines、slot_count、keyword_hits、keyword_total、missing_slots。response_note 不替代完整原文响应,只简短保留看到了什么格式信号。这个日志是用 llama3.2:latest、temperature=0.2 调用生成的执行快照,生成脚本为了在翻译本中维持同一执行标准,也使用英语提示和英语槽位名。
只把 Ollama 调用部分拿出来看,结构如下。正文默认执行读取保存 CSV,但真实模型验证会把同一运营备忘反复发送给四种提示类型,并把响应原文压缩成同一观察列保存。
这个调用只在 Ollama 服务器和模型准备好的环境中运行。正文固定的下面示例为了在没有服务器时复现同一观察结构,读取保存 CSV。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 | |
这次执行快照的汇总结果可以这样读。
把同一保存日志画成图,可以看到输入元素增加时,哪些项目先稳定。简单提示即使保留部分核心词,也几乎无法形成编号格式和必需槽位。给出指令和上下文后,槽位名稳定出现,但模型常常在前面加导入句,破坏 正好 3 行 条件。加上示例后,编号格式和槽位稳定了;再加上检查指令后,在这次快照中核心关键字保留数进一步上升。也就是说,示例能强力固定输出形状,检查指令能让模型重新查看不能漏掉的事实。
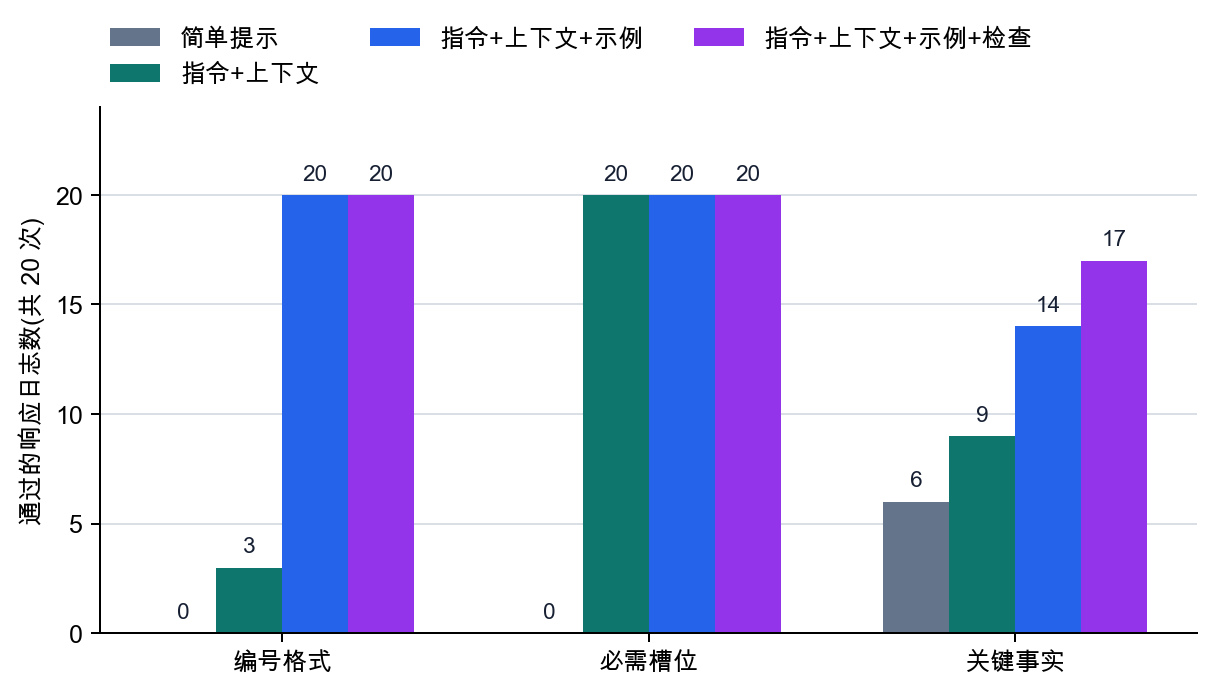
阅读这个结果时,核心不是 加上检查指令就永远完美。这次快照中,指令+上下文+示例+检查提示的整体核心关键字保留数最高,但在 refund backlog 卡片中,只加示例的提示保留得更好。相反,指令+上下文提示经常因为在格式前加不必要的导入句而失败,但槽位名本身很稳定。这里的 核心关键字 不是深层语义评分,而只是检查指定字符串是否留在响应中的简单观察标准。因此,如果有绝对不能漏掉的项目,就要实验 必须包含的关键字、缺失时重写、检查后再请求 等追加控制,并且这些控制也要在多个备忘中重新确认。
所以,这个示例要确认的结果有两个。
- 随着指令、上下文、示例、检查指令增加,多个请求卡片和重复响应中的
行数、编号格式、槽位保持如何变化。 - 即使格式稳定性提高,核心项目保留也不会自动解决,所以提示实验要同时检查
格式稳定性和内容保留率。
读者可以在这个示例中直接尝试下面的调整。
- 在 CSV 中加入
customer_impact这样的新槽位,并把slot_count标准调得更严格 - 把
format_ok_count标准从line_count == 3改成line_count <= 3 - 不先看
full_keyword_keep_count,而改成先看平均关键字保留率
如果安装了 Ollama,并且能接收本地模型,可以把同样的请求卡片再次发送给真实模型,生成新日志。这时可以像 OLLAMA_MODEL=要使用的模型名 .venv/bin/python docs/assets/part-06/chapter-10/p6_10_1_generate_prompt_response_log.py 这样执行。发送给模型的提示为了在翻译本中保持同一执行标准,仍然用英语编写。生成新 CSV 后,再运行这段正文代码和 p6_10_1_prompt_structure_chart.py,用同一标准比较保存日志和图表。比起把响应原文固定进正文,更适合像上面的 CSV 一样重新保存成观察列。实时调用结果会随模型和版本变化,所以正文比较的是 format_ok_count、slot_ok_count、full_keyword_keep_count、average_keyword_ratio 的变化,而不是某个特定句子。保存 CSV 是在这个执行条件下得到的快照,读者重新执行时数字可能不同。
这个验证方法重要,是因为提示工程不是 一个好示例,而是 能否用同一标准重新观察 的问题。直接执行时,流程如下。
| 阶段 | 要确认的内容 |
|---|---|
| 生成 Ollama 日志 | 是否把同一运营备忘和四种提示类型重新发送给模型 |
| 保存 CSV 观察列 | 是否把响应原文压缩成行数、槽位数、关键字保留率等可比较的列 |
| 汇总并重新生成图表 | 即使更换模型或 temperature,是否仍能用同一指标比较输入元素差异 |
这个示例中要读出的核心如下。
- 简单提示是
只说明任务的状态 - 指令+上下文提示是
任务、读者、槽位、检查标准一起给出的状态 - 指令+上下文+示例提示是连
要跟随的输出模式也展示出来的状态 - 指令+上下文+示例+检查提示是连
输出前要确认的条件也附上的状态 - 因此,提示工程不是漂亮句子比赛,而更接近
可重复的输入设计和检查设计
提示改变的输入设计
在这个比较中,重要的不是句子有多长,而是模型应该把判断所需信息放进哪些槽位。用 Ollama 直接执行时,每次数字不一定固定。因此在本节中,比起欣赏某个响应原文,更重要的是比较保存日志中的 format_ok_count、slot_ok_count、full_keyword_keep_count、average_keyword_ratio。提示工程不是看一个模型输出,而是改变输入,留下观察记录,再用记录决定下一次修改。
检查清单
- 能把提示说明为
输入设计和行为观察实验,而不是句子诀窍吗? - 能区分指令、上下文、示例分别首先改变什么吗?
- 准备好把 P6-11.2 读成寻找
只靠输入调整无法确认的失败的阶段了吗?
出处和参考资料
- Tom B. Brown et al., Language Models are Few-Shot Learners, arXiv, 2020, 确认日期: 2026-07-19.
- Jason Wei et al., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, arXiv, 2022, 确认日期: 2026-07-19.
- OpenAI, Prompting | ChatGPT Learn, 确认日期: 2026-07-19.
- Ollama, API Introduction, 确认日期: 2026-07-22.
- Ollama, Quickstart, 确认日期: 2026-07-22.