P6-11.3 补充学习:观察和比较回答路径
Section ID:
P6-11.3Version:v2026.07.26
副标题:CoT 和 self-consistency 如何让我们不同地看待一条路径和多条路径
在 P6-11.1 中,我们把提示工程(prompt engineering)看成输入设计的第一个控制点;在 P6-11.2 中,我们看了把只靠提示无法闭合的问题交给系统结构的标准。但在提示层内部,还可以再区分一种策略。差异在于:是让模型直接给答案,还是让中间判断路径更可见,还是比较多个候选路径。
Chain-of-thought(CoT)和 self-consistency 都是为了更好观察或比较回答路径的提示策略。CoT 想在一次回答中更清楚地显露中间 reasoning,self-consistency 则想看多个 reasoning 候选最终会汇聚到哪里。
本节要闭合的问题如下。
只看一个答案让人不安时,如何在提示层更好地观察回答路径?
比答案更需要路径的场景
有些任务只看最终答案就足够。但在混合多个条件的分类、比较多个段落的判断、有规则优先级的业务中,看起来正确的答案和真正按标准应用出来的答案可能不同。
例如,把客户咨询分到 退款、配送、账户、错误 中一个标签。即使模型回答 退款,只看这个答案也很难知道它是否先看了配送开始条件、是否更重视付款取消条件、是否忽略了运营规则。此时需要的不是更漂亮的句子,而是更好地观察 它按什么标准到达这个答案。
如果把提示策略能减少的问题和必须交给系统结构的问题分开,可以这样看。
| 卡住的点 | 首先看的提示策略 | 仍然不能替代的东西 |
|---|---|---|
| 答案出来了,但标准应用顺序看不见 | CoT | 最新文档召回、计算验算、执行日志 |
| 结论偶尔摇摆 | self-consistency | 共同错误前提导致的错误、外部依据缺失 |
| 回答路径变长,难以审阅 | 输出格式和路径摘要调整 | 评估体系、批准流程 |
这个表的核心是,CoT 和 self-consistency 都是帮助 观察回答路径 的策略。相反,最新文档、计算工具、保存成功这类系统外保证,不是这些策略的职责。
Chain-of-thought 是显露中间标准的策略
Chain-of-thought 不是让模型马上只说答案,而是让中间阶段 reasoning 更清楚地显露出来的策略。
简单请求可能是这样。
请把这条咨询分类为退款、配送、账户、错误中的一个。
CoT 风格请求会变成这样。
先拆分咨询中的核心条件,
简短写出每个标签候选被排除或保留的理由,
最后写一个最终标签。
此时期待的变化不是 答案变长。而是人不只看最终标签,还能检查模型先看了哪些条件、排除了哪些候选。
这里说 看路径,不是说直接看进模型内部。它更接近把判断痕迹以用户能检查的形式结构化地接收。初学者阶段,只抓住下面四个槽位就足够。
| 要确认的槽位 | 提问 | 示例 |
|---|---|---|
| 从输入中抓到的条件 | 模型把什么当作依据 | 付款取消、配送开始、退款咨询 |
| 候选标签 | 把可能答案分成什么 | 退款、配送 |
| 排除理由 | 为什么丢掉某些候选 | 直接提出退款请求,所以不能只看成配送咨询 |
| 最终答案 | 最后选择什么 | 退款 |
如果没有这四个槽位,即使有 CoT 请求,审阅者也必须重新读一长段话。反过来,有了四个槽位,人就能和真实业务规则对照。如果运营规则是 先确认配送是否开始,就可以看模型的中间标准中是否也先出现了这个项目。
但 CoT 也有局限。
- 中间步骤长,不代表 reasoning 一定正确。
- 如果没有最新文档,模型可能把旧前提解释得更长。
- 需要计算的问题,即使有中间说明,也仍然需要单独的验算结构。
因此,CoT 是 让中间标准可见的输入策略,不是事实保证装置。
self-consistency 看多条路径的合意
self-consistency 不是只相信一条 reasoning 路径,而是看多次生成的路径中,更常到达哪个结论。
在这个阶段,可以这样理解。
| 策略 | 看的东西 | 期待效果 |
|---|---|---|
| CoT | 一次回答中的中间 reasoning | 标准应用顺序更可见 |
| self-consistency | 多个 reasoning 候选的结论分布 | 减少偶然的一次摇摆 |
例如,同一个分类问题让模型解多次,三次是 退款,一次是 配送,那么 退款 看起来可能是更稳定的候选。但这仍然只是看候选路径的合意。如果多个候选共享同一个错误前提,合意也会一起错。
最新退款政策问题重复多次都得到同一答案,即使如此,如果模型没有看到最新文档,这个结果也可能是 旧记忆的稳定重复,不是 当前政策的验证。这里就是 self-consistency 和 RAG 的边界。
实际阅读 self-consistency 时,不要只看 几次中有几次同一结论,也要一起看结论分歧的理由。
| 候选路径 | 中间判断摘要 | 最终标签 | 审阅点 |
|---|---|---|---|
| 1 | 先看付款取消和退款咨询 | 退款 | 把直接退款请求当作依据 |
| 2 | 先看配送是否开始 | 配送 | 抓到了运营规则可能先检查的条件 |
| 3 | 把退款咨询看成客户意图 | 退款 | 按客户意图判断 |
| 4 | 把付款取消快速连接到退款处理 | 退款 | 取消和退款连接得稍快 |
看到这个结果后,不应该只用多数票确认 退款。还要看为什么出现 配送 候选。如果真实业务规则优先看配送是否开始,第二条路径可能比 3:1 多数票更重要。self-consistency 展示结论分布,但哪条路径符合业务标准,仍然要由人的标准表或评估结构判断。
合意不等于依据
CoT 和 self-consistency 最容易被过度信任,是因为输出看起来更认真。中间说明很长,多次询问也出现相似结论,人就更想相信。但提示策略改变的是回答路径的观察方式,不是答案本身的出发点。
可以先抓住下面的比较。
| 看起来好的信号 | 直接相信会产生的误判 | 重新确认的东西 |
|---|---|---|
| 中间步骤很长很详细 | 以为 reasoning 长,事实也会对 | 标准应用顺序是否符合业务规则 |
| 多个候选到达同一结论 | 以为已经确认最新事实 | 共同前提是否符合当前文档 |
| 结论稳定重复 | 以为执行或计算也稳定 | 是否有计算日志、工具执行结果、依据文档 ID |
CoT 和 self-consistency 有用的场景,是 需要更仔细阅读路径的问题。需要确认最新性、依据性、执行成功的问题,则必须像 P6-11.2 中看到的那样转到其他结构。
案例和示例
案例 1. 为什么在条件很多的分类问题中加 CoT
假设客户咨询同时包含多个条件,比如 付款已经取消,但配送已经开始,退款什么时候到账?。最终标签只写 退款,看起来可能正确,但真实运营规则可能先检查配送是否开始,再判断退款可能性。
这时 CoT 能让模型显露它在 付款取消、配送开始、退款请求 中先看了什么。人可以检查标签选择标准是否按业务规则相同顺序应用,而不只看最终标签。
把同一输入用两种输出方式比较,差异会更清楚。
| 输出方式 | 人能立刻看到的东西 | 剩下的不安 |
|---|---|---|
退款 | 最终标签 | 不知道是否考虑了配送开始条件 |
条件:付款取消、配送开始、退款咨询排除:不是单纯配送咨询最终:退款 | 抓了哪些条件、排除了哪些候选 | 人仍然要对照运营规则和顺序 |
需要确认的结果不是 说明是否变长,而是 选择标签的标准是否更可读,而且这个标准是否符合真实分类规则。
案例 2. 即使有 self-consistency,最新政策问题仍会留下
假设把最新退款政策问题跑很多次,并采用最常出现的答案。多次出现同一答案,会看起来很稳定。但如果模型没有看到最新政策文档,重复答案也可能只是旧政策的反复。
这个案例中要改变的标准,不是 答案重复了几次,而是 这个重复是否发生在当前文档依据之上。self-consistency 可以减少一次性摇摆,但不能解决最新文档连接缺失。
练习和示例
这个示例的目标不是只用文字区分 CoT 和 self-consistency,而是从多条响应路径日志中同时读取结论分布和检查信号。即使同一结论重复多次,如果缺少依据或计算错误,也不能原样采用。相反,即使是少数路径,也可能包含业务规则上重要的警告。
下面 CSV 是对四个任务实际调用 Ollama 本地模型而生成的 40 条响应路径快照日志。生成脚本不会把预设答案候选放进提示,而是把同一任务分成 CoT 式单一路径观察和 self-consistency 式重复候选观察,多次调用。然后把模型响应原文压缩成观察列:最终答案、短路径摘要、依据提及、计算错误、当前政策缺失、规则警告、少数结论情况。实际模型、提示、采样设置不同,每条路径的结论和检查信号也可能不同。
首先,生成保存日志的代码如下。发送给模型的提示为了在翻译本中保持同一执行标准而使用英语,正文示例会读取这个脚本生成好的 CSV 快照。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 217 218 219 220 221 222 223 224 225 226 227 228 229 230 231 232 233 234 235 236 237 238 239 240 241 242 243 244 245 246 247 248 249 250 | |
如果安装了 Ollama,并且本地模型可用,可以运行 .venv/bin/python docs/assets/part-06/chapter-10/p6_10_3_generate_response_path_log.py 来生成同一格式的新日志。正文中包含的数字是用 llama3.2:latest 和特定设置运行得到的快照。重新执行时,结论分布和检查信号数可能改变,这个差异本身也说明为什么需要 self-consistency 和日志观察。
一行是一条响应路径。核心列是 task_name、path_type、log_source、model_name、temperature、final_answer、evidence_mentioned、calculation_correct、policy_current、rule_warning、minority_answer。path_type 区分这是 CoT 式单一路径观察,还是 self-consistency 式重复候选。这里要看的不是结论多数票,而是依据缺失、计算错误、当前政策缺失、业务规则警告信号、偏离多数结论的少数结论是否一起留下。尤其是 path_summary 不是模型内部 reasoning 本身,而是压缩到可审阅水平的路径摘要。
执行结果示例可以这样阅读。
这个结果中,mixed_refund_label、discount_total、security_escalation 的最多结论比例都是 1.0。但 security_escalation 仍然留下 5 条依据缺失,所以结论全部相同并不表示已经留下足够可审阅的标准。discount_total 也全部收敛到 apply_discount,但很多路径没有留下足够计算依据。current_refund_policy 的多数结论是 check_current_policy,但仍然留下选择旧退款期限的少数结论和当前政策缺失。这里 rule_warning 单独显示响应中是否留下了业务规则上应该再看的信号,minority_answer 显示是否出现了不同于多数结论的结论。
把同一日志画成图,会更清楚地看到结论合意和观察到的检查信号是不同轴。即使上方柱很高,如果下方检查信号也高,就不能只因为答案经常重复而采用。下方柱不是响应数量,而是多个检查列的合计。一个响应中如果同时有依据缺失和规则警告,两个信号都会一起加上,所以柱高应该读成 审阅者还要重新看的信号有多少,而不是 有几个答案失败。
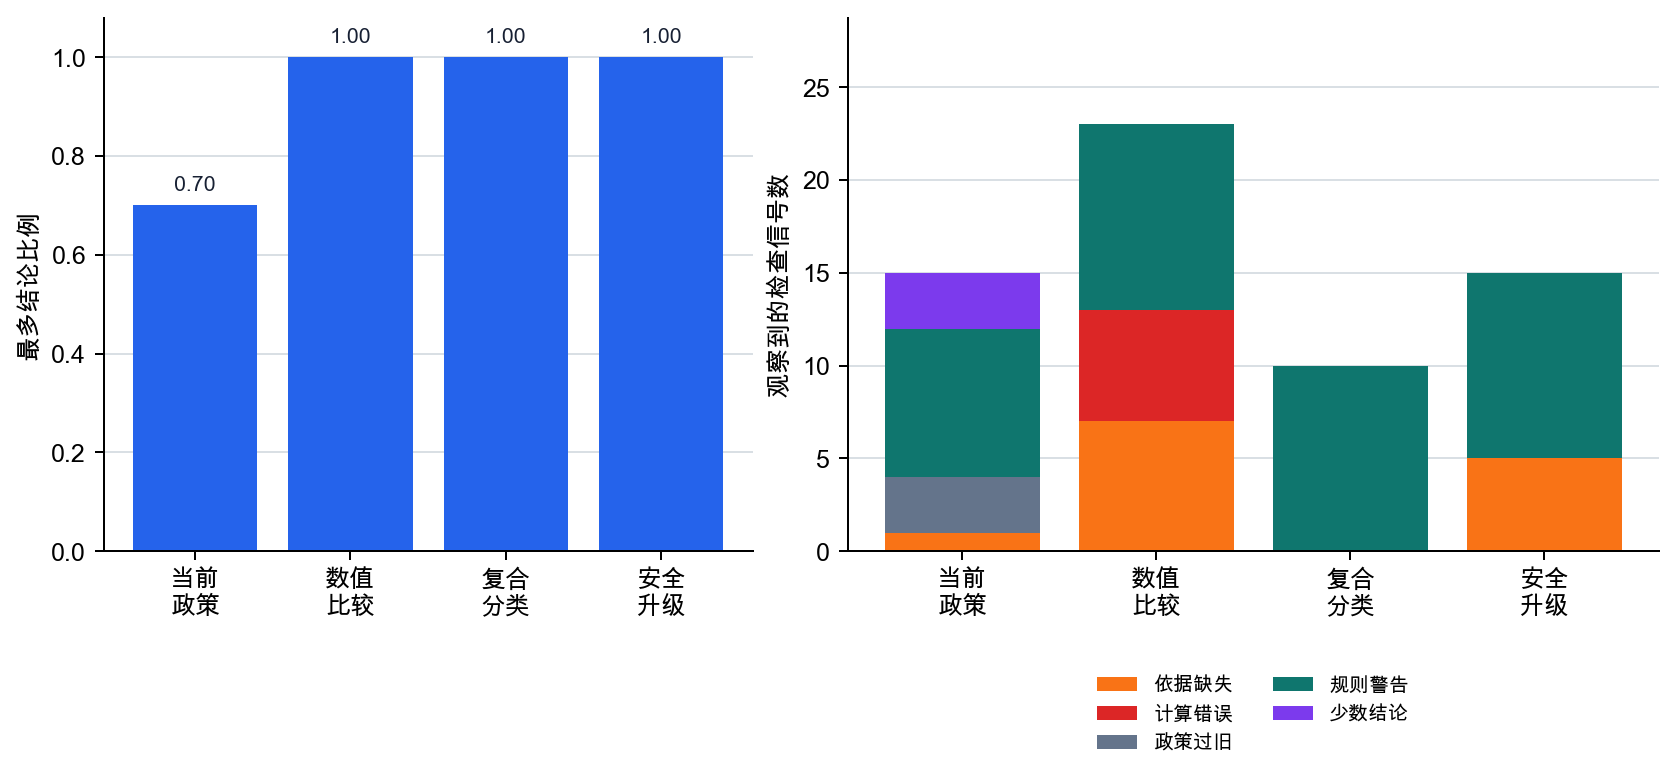
读者可以在这个示例中直接改变的值,是日志行本身和检查信号标准。例如,把 rule_warning 定得更严格,就能只留下响应路径中对真实业务规则重要的警告。把 policy_current 为 False 的路径全部排除,也能确认 self-consistency 的多数票如何改变。通过这种操作,可以确认 CoT 和 self-consistency 不是保证答案的技术,而是帮助更好观察和比较回答路径的策略。
下面场景中,先标出应该看 CoT、self-consistency,还是提示策略之外的系统结构。核心是先选择 输出为什么不安。
| 场景 | 不安的理由 | 首先看什么 | 理由 |
|---|---|---|---|
| 分类标签出来了,但审阅者难以理解为什么是这个标签 | |||
| 同一数值比较问题中结论偶尔不同,原始数值已经在输入中 | |||
| 多次询问都说同一退款期限,但没有显示文档版本 | |||
| 计算过程说明很长,但合计经常错误 | |||
| 三次出现同一标签,但一次出现的另一个标签在业务规则上看起来重要 |
解说:
| 场景 | 不安的理由 | 首先看什么 | 理由 |
|---|---|---|---|
| 标签选择标准读不出来 | 判断路径不可见 | CoT | 首先要显露中间标准和候选排除理由 |
| 有原始数值,但结论摇摆 | 一次生成摇摆 | self-consistency | 可以比较多个候选路径的结论分布,减少一次性摇摆 |
| 没有文档版本 | 当前依据缺失 | RAG 或依据连接结构 | 即使多次合意,没有当前文档依据也不能闭合最新性 |
| 说明很长但计算错误 | 缺少实际计算验证 | 工具使用或验算结构 | 比 reasoning 说明更先需要真实计算验证 |
| 少数候选在业务规则上重要 | 多数票和业务优先级冲突 | self-consistency 结果解读 + 规则对照 | 要看候选分布,但不能只靠多数票闭合 |
这个练习的核心是,不把 CoT 和 self-consistency 笼统看成 更强的提示。CoT 让一条路径更可读,self-consistency 比较多条路径。但依据和执行保证仍然是单独结构的问题。
检查清单
- 能把 CoT 说明成让中间 reasoning 路径更清楚显露的策略吗?
- 能把 self-consistency 说明成观察多个 reasoning 候选合意的策略吗?
- 能区分中间说明很长或结论反复出现这件事,与最新依据、计算验证、工具执行保证之间的差异吗?
- 准备好在 P6-11.4 中把 automatic prompt optimization 读成提示实验循环策略,而不是回答路径策略了吗?
出处和参考资料
- Jason Wei et al., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, arXiv, 2022, 确认日期: 2026-07-19.
- Xuezhi Wang et al., Self-Consistency Improves Chain of Thought Reasoning in Language Models, arXiv, 2022, 确认日期: 2026-07-19.
- Pranab Sahoo et al., A Systematic Survey of Prompt Engineering in Large Language Models: Techniques and Applications, arXiv, 2024, 确认日期: 2026-07-19.