P6-11.4 补充学习:提示候选的反复改进
Section ID:
P6-11.4Version:v2026.07.26
副标题:automatic prompt optimization 如何评价提示实验,并把结果交给下一个候选
在 P6-11.3 中,我们把 CoT 和 self-consistency 看作观察或比较回答路径的策略。现在方向稍有不同。automatic prompt optimization 更接近于讨论提示候选本身:怎样评价它们,又怎样反复改进它们。
automatic prompt optimization 是一种尝试用评价标准和迭代循环,把人手动一点点修改提示的工作变得更系统的做法。重要的不是“自动”这个词,而是在多个输入上比较提示候选,并根据结果选择下一个候选的结构。
本节要收束的问题如下。
把提示改好,究竟是按照什么标准反复比较?
选择提示候选的问题
写一次提示,觉得满意就结束,这种方式很快。但在重复业务中它很容易摇摆。一个提示可能在某个输入上表现良好,在另一个输入上却漏掉关键项或破坏格式。因此,当有多个提示候选时,要看的不是哪句话更像样,而是哪个候选在多个输入上更稳定地通过标准。
automatic prompt optimization 试图把这种反复比较进一步自动化。基本结构可以这样看。
| 步骤 | 做什么 | 容易漏掉的点 |
|---|---|---|
| 制作提示候选 | 准备多种输入设计方案 | 候选多并不等于标准好 |
| 应用于评价集 | 在同一组输入上比较结果 | 评价集太窄时,只可能适合特定案例 |
| 打分 | 按格式、遗漏、准确性等标准比较 | 打分标准弱,自动化也会弱 |
| 选择下一个候选 | 保留得分更好的候选,或生成新候选 | 高分并不保证真实服务质量 |
这个结构并不是要提前说明 P6-16 的完整评价体系。这里先抓住一点:选择提示候选时也需要最低限度的评价标准。评价标准本身的设计和运营会在后面再次讨论。
选择提示候选不是比较句子偏好,而是在制作一张小实验表。比如要选择客户通知摘要提示,至少要同时放入输入集合和检查标准。
| 评价输入 | 为什么需要 | 必须保留的项目 |
|---|---|---|
| 简短的配送延迟通知 | 简单正常案例 | 延迟原因、新的预计到达日期 |
| 有退款例外条件的通知 | 容易遗漏的边界案例 | 退款可能条件、例外条件 |
| 需要客户采取行动的通知 | 检查是否保留下一个行动 | 提交文件、截止日期 |
| 政策文档部分含糊的通知 | 检查是否抑制猜测 | 需要确认标记、依据句 |
有了这张表,automatic prompt optimization 中的 automatic 才有意义。即使自动生成了很多候选,如果没有这样的输入和标准,也无法判断到底哪里变好了。
自动化不能代替评价标准
听到 automatic prompt optimization 时,很容易以为机器会自动把提示改好。但自动化快速放大的,是我们放进去的评价标准。如果评价标准只看流畅度,它可能选出更顺滑的句子,却漏掉重要依据句、禁止表达或长度限制。
假设我们要自动改进客户通知摘要提示。如果评价标准只有句子是否自然,自动优化可能会朝着更亲切、更顺滑的句子前进。但真实目的可能是不要漏掉退款期限、例外条件、客户下一步要做的事。
因此,在 automatic prompt optimization 中首先要问的不是使用什么算法,而是什么才算好的提示。
候选比较中的最低标准
在初学阶段,比起复杂的优化算法,先看下面四个标准更稳妥。
| 评价标准 | 检查问题 | 太弱时会发生的问题 |
|---|---|---|
| 格式稳定性 | 是否遵守要求的行数、表格或槽位 | 输出形状每次都摇摆 |
| 关键项保留 | 是否漏掉必须保留的事实 | 文字自然,但重要信息消失 |
| 禁止条件遵守 | 是否避开不能使用的表达或猜测 | 安全或政策违规风险仍然存在 |
| 验证集多样性 | 是否同时有简单案例和边界案例 | 选出只适合特定输入的提示 |
从这些标准看,automatic prompt optimization 不是自动把提示句子修得更漂亮的技术。它是一个实验循环,用来比较哪个候选在多个输入上更稳定地通过标准。
分数如果被合成一个数字,也容易误解。比起“总分 90 分”,更重要的是它在哪个标准上强,在哪个标准上弱。
| 候选 | 格式稳定性 | 关键项保留 | 禁止条件遵守 | 边界案例处理 | 解读 |
|---|---|---|---|---|---|
| A | 5 | 2 | 4 | 2 | 形状稳定,但经常漏掉重要项目 |
| B | 4 | 5 | 4 | 4 | 稍长,但更接近真实目的 |
| C | 5 | 3 | 2 | 1 | 看起来好,但猜测和边界案例失败较大 |
在这张表中,B 不一定是最漂亮的提示。但如果客户通知摘要的目的在于保留关键项,B 就是更好的候选。automatic prompt optimization 的学习重点不在于追逐高总分,而在于必须先设计好分数表。
案例和示例
案例 1. 只把流畅度当分数时,重要信息会消失
假设有客户通知摘要提示候选 A 和 B。A 的句子短而朴素,但保留了退款期限、例外条件和下一步行动。B 的句子柔和好读,但有时会漏掉例外条件。
如果评价标准只有自然的句子,B 可能得到更高分。但在真实服务中,漏掉例外条件是更大的失败。这时自动优化会朝错误方向加速。它可能比人手动犯错更快地选择符合错误标准的提示。
这里要确认的结果不是分数是否提高,而是这个分数是否包含真实目的。
案例 2. 评价集太窄时,提示会贴合特定案例
假设只用三份内部通知比较摘要提示。这三份文档都很短,结构也相似。此时得分高的提示,并不能自动说明它在长政策文档或例外很多的客户通知中也能工作。
automatic prompt optimization 会跟随评价集中的信号。评价集太窄时,候选提示也可能贴合那个狭窄输入。因此验证集中不仅要有简单案例,还要有边界案例、有例外的案例、容易失败的案例。
如果“扩大验证集”这句话停留在模糊层面,也没有帮助。把输入种类这样拆开,就能看到哪里是空的。
| 输入种类 | 为什么要包含 | 缺少时产生的错觉 |
|---|---|---|
| 正常案例 | 检查基本业务是否成立 | 漏看提示是否连基本格式都守不住 |
| 边界案例 | 条件冲突时检查优先级 | 选择只在简单案例中好用的候选 |
| 预期失败案例 | 检查模型容易猜测或省略的点 | 危险失败没有进入评价 |
| 长输入案例 | 检查长度和结构改变后是否还能撑住 | 把短输入专用提示泛化 |
在这个案例中,需要改变的标准不是分数最高的提示,而是在多样输入中仍能维持标准的提示。
练习和示例
下面示例的目标,是把 automatic prompt optimization 读成“选择最像样的句子”以外的东西:在多个评价输入上,反复汇总提示候选的失败项目。
下面的 CSV 是把 4 个候选提示应用到 9 个评价输入上的观察日志。
一行是一个评价输入 × 一个提示候选的观察值。核心列是 case_type, prompt_candidate, format_ok, key_fact_ok, forbidden_ok, boundary_ok, response_too_long。normal 是简单正常案例,boundary 是条件冲突的边界案例,failure_expected 是容易出现猜测、禁止表达或依据不足的案例。
这里把 format_ok 设为 1 分,key_fact_ok 和 forbidden_ok 各设为 3 分,boundary_ok 设为 2 分。这加入了一个运营假设:在客户通知摘要中,关键项保留和禁止条件遵守比外形更重要。改变这些权重后,哪个候选看起来更好也可能改变。
运行结果示例如下。
这个结果中首先要读的是候选 B 和 D 的差异。B 很好地保留了关键项、禁止条件和边界案例,但仍有 6 次格式失败和 9 次长度超限。D 在同一评价集上通过了所有标准,所以总分最高。相反,A 很短且格式稳定,但 9 次漏掉关键项;C 保留了关键项,却 9 次违反禁止条件。
用图表看,分数和失败类型提供的是不同信息,这一点会更清楚。
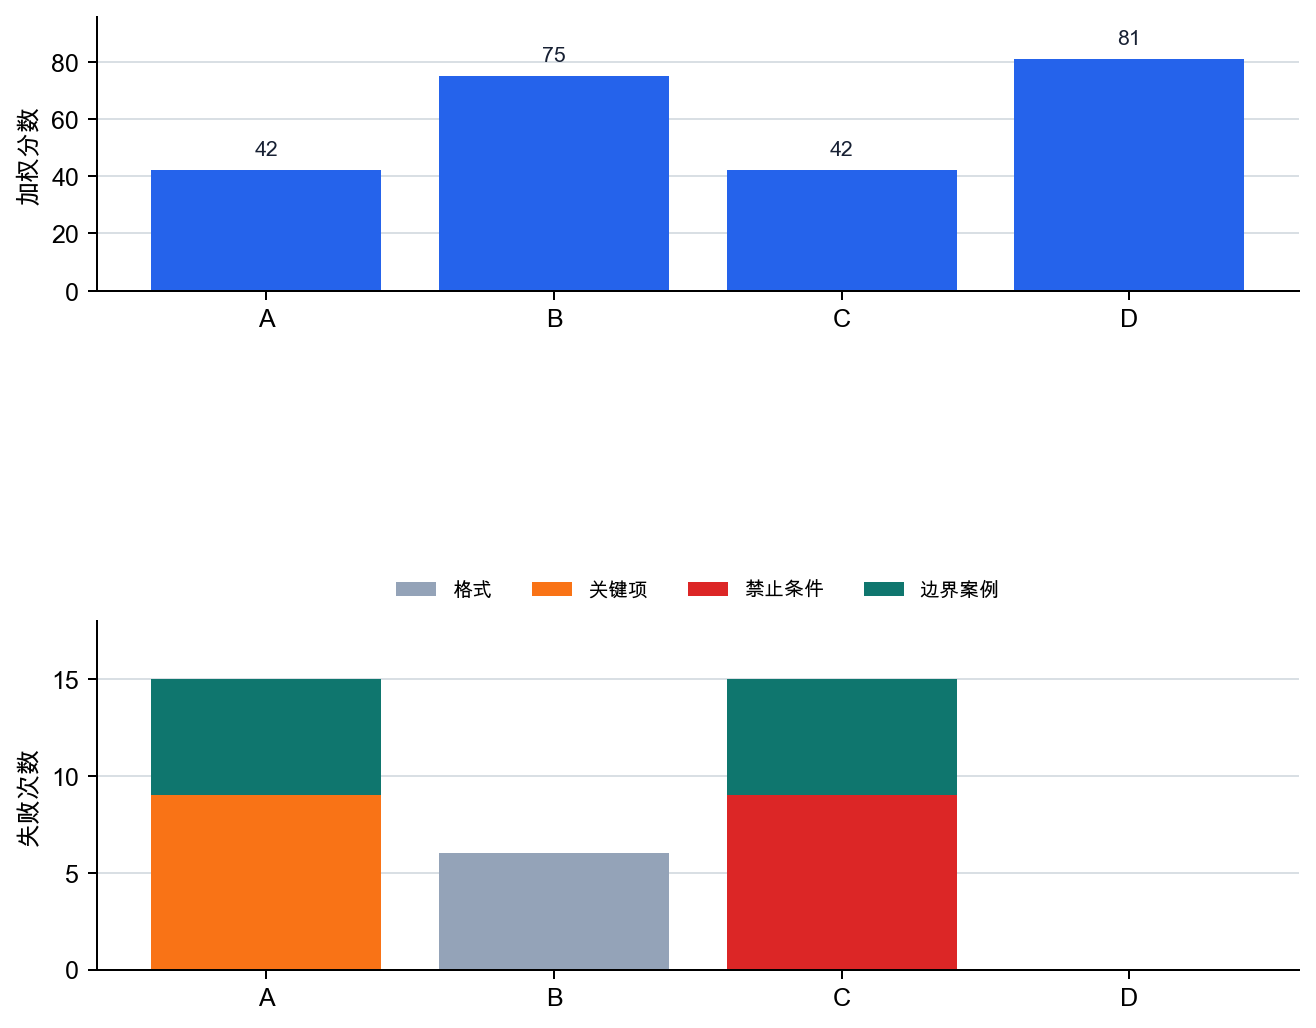
这个示例中,读者可以直接改动的值是 weights。例如,如果某类文档非常重视格式稳定性,可以把 format_ok 的权重从 1 提高到 3。反过来,如果安全告知更重要,可以进一步提高 forbidden_ok 的权重。这里重要的是,自动优化不会替我们设计分数。哪个分数应该更重要,仍要由使用者根据问题目的决定。
下面是比较三个提示候选的简单判断练习。先标出哪个候选如果立刻采用会有风险。
| 候选 | 看起来好的点 | 可能漏掉的东西 | 立刻采用的风险 |
|---|---|---|---|
| A | 总是简短易读 | 经常省略例外条件 | |
| B | 很好地保留依据句 | 句子稍微变长 | |
| C | 在 5 个评价案例中最高分 | 还没看边界案例 |
解说:
| 候选 | 判断 | 理由 |
|---|---|---|
| A | 危险 | 流畅和简短是优点,但关键项保留弱时,服务失败可能变大 |
| B | 视目的而有力 | 如果依据保留很重要,即使变长也可能是更安全的候选 |
| C | 暂缓 | 即使分数高,评价集太窄时仍不知道是否过拟合 |
这个练习的核心,不是把 automatic prompt optimization 只理解为选择最高分提示。还要一起看它是什么分数、来自什么输入、漏掉了哪些失败。
再深入一步。请在下面的分数表中,把可以直接选择的候选和应当暂缓的候选分开。分数从 1 到 5,假设在客户通知摘要中,关键项保留和禁止条件遵守尤其重要。
| 候选 | 格式稳定性 | 关键项保留 | 禁止条件遵守 | 验证集多样性 | 判断 |
|---|---|---|---|---|---|
| A | 5 | 2 | 5 | 4 | |
| B | 4 | 5 | 4 | 4 | |
| C | 5 | 5 | 2 | 2 |
解说:
| 候选 | 判断 | 理由 |
|---|---|---|
| A | 暂缓 | 格式稳定,但关键项保留低,可能漏掉真实目的 |
| B | 有力 | 关键项保留和禁止条件遵守都高,验证集也不窄 |
| C | 危险 | 关键项留下了,但禁止条件遵守低,验证集狭窄,服务应用风险大 |
即使不知道复杂算法,也可以做出这种判断。阅读 automatic prompt optimization 时首先需要的感觉是:自动选出的候选,还要按什么标准重新读?
与 P6-16 的边界
本节不是说明整个评价体系的地方。这里需要的是一种直觉:要反复改进提示候选,至少需要最低限度的评价标准和验证输入。自动评价和人工评价、评价集设计、运营中的回归检测,会在 P6-16 中更正式地讨论。
因此,本节的结论可以这样把握。
- automatic prompt optimization 可以让提示实验循环更快。
- 但如果评价标准弱,它只是更快地重复弱标准。
- 选择提示候选时,也要同时看格式、关键项、禁止条件和验证集多样性。
检查清单
- 能否把 automatic prompt optimization 说明为通过评价循环反复改进提示候选的方法?
- 能否说明自动化并不能代替评价标准本身?
- 能否区分高分、狭窄评价集和真实服务质量?
- 能否区分 P6-16 的评价体系主体和本节的最低评价标准?
来源和参考资料
- Pranab Sahoo et al., A Systematic Survey of Prompt Engineering in Large Language Models: Techniques and Applications, arXiv, 2024, 确认日期:2026-07-19.
- Tom B. Brown et al., Language Models are Few-Shot Learners, arXiv, 2020, 确认日期:2026-07-19.