P6-12.1 用外部依据代替模型记忆的 RAG
Section ID:
P6-12.1Version:v2026.07.31
记录 RAG 请求时,要分开 question、retrieval_query、retrieved_evidence、evidence_source、answer_claim、missing_evidence。这样,交给模型记忆的回答和附上外部依据的回答就不会看起来像同一件事。
在 P6-11.2 中,我们看到只靠提示很难解决新鲜度、依据保证、可执行性等问题。于是,重要的不只是回答句子本身,而是先怎样改变进入回答的材料。
如果不只依赖模型记忆,而要一起使用外部依据,该怎么做?
RAG(retrieval-augmented generation) 是一种结构:模型在生成回答前先检索相关文档,再基于这些文档生成。
在回答前附加外部依据的标准
RAG 是把回答的出发点从模型记忆改为外部文档依据的结构。如果提示和指令调整处理的是让模型怎样回答,RAG 就把问题改成让模型依据什么回答。实际结合流程是把检索结果附加到输入上下文,再在其上生成回答;检索存储结构和索引则是为了让需要的文档可以被重新找到。
因此,这里的核心变化不是问题句子是否润色得更好,而是回答前先附加哪份文档。这个标准站稳后,才能把 RAG 读成独立的依据连接结构,而不是提示的延长线。
一开始只区分两个问题就够了。把已经拥有的会议记录概括成三行,或把分类结果改写成表格格式,通常是用同一份材料调整回答方式的问题。相反,询问今天变更的内部政策或当前 SDK 版本的用法,则是把回答材料本身重新选成当前文档的问题。第二种场景中,RAG 就变得必要。
把长文档贴进提示的技巧这种印象,应改读为把回答的出发点改成外部依据文档的结构。这里首先要留下的是检索备忘和依据检查记录:找到了哪些文档作为依据候选,为什么判断每份文档相关,最终回答是否真的站在文档依据上。
文档不会自动出现在回答前。通常要先把文档片段保存成可检索的形式,问题进来时再先取出相关片段。这个存储结构可以混合关键词搜索、普通数据库、向量数据库(vector database)。但在 LLM 服务中,为了找到语义接近的文档,经常会使用向量数据库。本节先抓住回答前检索并附加依据这个 RAG 结构,P6-13.1 再看这些依据如何以嵌入、原文和元数据的形式保存并取回。
| 首先区分的场景 | 先抓住的判断 | 为什么要先区分 |
|---|---|---|
| 只是回答语气、表格格式、摘要方式不满意 | 很可能是提示调整问题 | 材料通常已经存在,只是表达方式在摇摆。 |
| 需要今天变更的政策、当前 SDK 版本、内部手册 | 很可能先需要 RAG | 回答前不附加最新文档和内部文档,就容易出现依赖记忆的错误答案。 |
| 文档看过了,但计算、查询、实际执行更重要 | 可能不能只靠 RAG 收束 | 阅读文档和计算数值或调用系统是不同问题。 |
| 文档候选太多,不清楚依据是什么 | 要同时检查检索质量和依据记录 | 即使加了 RAG,如果没有留下为什么选中文档,也很难确认可信度。 |
为什么只靠模型记忆不够
LLM 通过预训练和调整学习了许多模式。但在真实服务中,最新信息和内部文档经常不会自动反映到模型中。RAG 增加的是回答前查找依据文档的步骤,因此回答的出发点会从模型记忆移动到文档依据。
- 必须反映今天变更的政策
- 必须基于公司内部文档回答
- 必须以最新产品规格为准说明
- 必须在回答中附上实际来源
这些要求很难只靠模型内部已有的记忆稳定解决。
原因很简单。
- 训练时点之后的信息不会自动更新
- 内部文档可能原本就没有包含在训练中
- 回答即使看起来合理,也可能没有连接到实际依据
RAG 想改变什么
RAG 的基本想法非常实用。
先找相关文档,把这些文档一起放进去,再在这个范围内生成回答。
也就是说,结构从模型独自取出记忆,变成:
- 先发生检索(retrieval)
- 结果作为上下文(context)附加
- 生成(generation)在其上进行
因此,与其把 RAG 理解成让模型更聪明的技术,不如把它理解成把回答依据连接到外部材料的服务结构。
从服务结构角度看,如果提示处理的是怎样问模型,RAG 处理的就是让模型依据什么回答。
把这个差异改写成运营问题,会更清楚。
| 现在先确认什么 | 提示阶段的问题 | RAG 阶段的问题 |
|---|---|---|
| 回答为什么摇摆 | 请求格式是否含糊? | 依据文档是否缺失或过旧? |
| 先改哪里 | 要重写指令、上下文、示例吗? | 要先附加检索范围和最新文档吗? |
| 确认什么结果 | 格式、长度、语气是否稳定? | 实际文档条件和数字是否反映在回答中? |
RAG 想减少哪些问题
RAG 通常用于减少下面的问题。
- 最新信息不足
- 内部文档没有反映
- 没有依据的一般性回答
- 来源难以追踪
RAG 不是只相信模型记忆,而是先取回需要的文档,缩小回答的依据范围。
与微调有什么不同
这个差异非常重要。
| 方式 | 主要想解决的问题 |
|---|---|
| 微调(fine-tuning) | 调整特定格式、反应倾向、领域适配 |
| RAG | 连接最新信息、外部依据、文档型回答 |
例如:
- 让回答格式符合公司风格,可能更接近微调
- 反映今天变更的退款政策,则更直接地接近 RAG
没有这个区分,使用者很容易误以为所有问题都能用一次微调或一个提示解决。
用同一个请求流程再整理,就是:
- 提示:调整提问方式
- 微调:进一步匹配反应倾向和格式
- RAG:回答前附加外部依据
再分出一点,P6-12.2 和 P6-12 的衔接会更自然。外部课程通常会同时处理预训练用数据准备和检索用文档准备,但二者不是同一项工作。
| 数据准备种类 | 先对齐什么 | 这里连接到哪里 |
|---|---|---|
| 预训练用数据准备 | 让模型学习广泛语言模式 | P6-8.1, P6-8.2 |
| 检索用文档准备 | 让文档能按当前问题重新取出 | P6-11, P6-12 |
也就是说,加上 RAG 更接近于准备可检索的文档,并在回答前附加这些文档,而不是重新大规模训练模型。
把外部 RAG 整理资料和实务经验报告一起看,还要再分出一个轴。RAG 不是问题进来之后才开始的技术,而要和更早的文档准备(content preparation)阶段一起读。
| 问题进来之前 | 问题进来之后 |
|---|---|
| 保留最新版本文档,并区分旧文档 | 检索符合当前问题的文档 |
| 把段落切分得不过长也不过短 | 把检索到的段落附加到输入上下文 |
| 整理重复文档并附加元数据 | 在这些段落范围内生成回答 |
也就是说,RAG 的第一个成功条件不只是检索模型是否聪明,也是要检索的文档是否已经准备成可检索的形态。
为什么实务中常用
在实务中,能确认依据的回答经常比听起来像正确答案的回答更重要。
例如:
- 基于内部 wiki 的回答
- 基于产品手册的客户支持
- 基于法律/政策文档的搜索型回答
- 基于技术文档的开发辅助
这些场景中,RAG 实用是因为它改变的是接近依据的路径,而不是模型本身。
这里重要的一句话是:
在实务中,比起漂亮的回答,能追踪依据的回答往往更重要。
RAG 也不是万能的
但也不能夸大 RAG。
有 RAG 并不会自动保证:
- 总能找到最相关的文档
- 总能准确读取找到的文档
- 引用总是正确
- 检索结果一定充分
也就是说,RAG 只是让系统同时处理检索问题和生成问题,并不会自动解决两者。
更安全的说明如下。
RAG 是把回答依据连接到外部资料的强结构,但必须分别检查检索质量和生成质量。
非常简单地画出来
flowchart TD
  A["用户问题"]
  B["检索相关文档"]
  C["把文档附加到上下文"]
  D["生成有依据的回答"]

  A --> B
  B --> C
  C --> D
这个图的核心是先检索,再生成。
案例和示例
案例 1. 内部政策问答
如果问题是差旅费结算标准有什么变化?,很容易先按记得的公告或上一次标准回答。内部政策终究也是人阅读的文档,所以容易期待模型像知道一般知识一样知道它们。但内部政策经常修订,旧标准和今天的标准可能不同,依赖记忆的方式很容易直接变成错误说明。比如去年交通费没有上限,而今年开始有上限,那么语气再自然,答案本身也是错的。更危险的是,这种回答容易在组织内部被复制成看起来像官方说明的句子。
RAG 会先检索最新内部政策文档,找到当前有效的条款,把该段落附加到上下文后再生成回答。这里结构上改变的是,出发点从拿出记得的答案移动到先确认当前有效文档。需要纠正的误解是自然说明就暂时足够。因此,这个案例中要先确认的结果不是说明是否自然,而是实际最新政策段落是否作为回答依据附加上去,以及只看那个段落是否也能重新确认当前有效标准。
案例 2. 基于产品手册的支持
可以想象一个回答产品使用方法的客服聊天机器人。只要整理好几个 FAQ 和常用回答模板,似乎就能处理基本问题。客户问题也常常重复,所以一直复用一次做好的回答,看起来也没什么大问题。但菜单名称和设置位置会随着版本变化,模板即使自然,内容也可能很快变旧。例如旧版本的高级设置菜单在当前版本中移动到偏好设置,记忆型回答就会把客户带到错误画面。此时用户会遇到回答很亲切,为什么和实际画面不一样?这样的失败。
RAG 会先从最新手册和 FAQ 中找到相关文档,附加当前版本说明后再组织回答。这样,回答质量就可以先按与当前文档的一致性来管理,而不是先看语气。这里要纠正的误解是常见问题用记忆型模板也足够。因此,这个案例中要确认的结果不是模板是否自然,而是当前版本菜单和步骤是否符合实际文档,以及回答的每一步是否也对应真实画面路径。
案例 3. 开发文档搜索
想象开发者问:当前 SDK 版本中认证头应该放在哪里? 模型知道很多一般 API 知识,所以很容易认为它可以直接回答。语法问题看起来也像是记忆中的示例比搜索更快。但如果模型记住的是旧版本语法,看似合理的回答在真实代码中会立即失败。例如它照旧回答过去版本的 Authorization 示例,而当前版本已经改成单独传入 auth 对象,那么复制进去的代码会马上失败。这个失败不只是一个错误答案,还会带来调试时间、信任下降和错误示例代码扩散。
这时首先要确认的不是模型的一般知识,而是现在使用的版本文档。RAG 会先检索当前 API 文档和示例页面,作为上下文附加后再回答,从而降低这种版本不一致风险。核心不在生成句子的流畅度,而在检索阶段是否准确拿到当前文档。这里要纠正的误解是代码看起来像样就可以先复制试试。因此,这个案例中要确认的结果不是回答是否像样,而是当前 SDK 文档和代码示例是否一起作为依据附加上去,以及只沿着这些依据是否能复现同样的代码。
把三个案例重新整理成运营检查标准如下。
| 情况 | 必须先附加的依据 | 没有依据时出现的错误答案 |
|---|---|---|
| 内部政策 | 最新政策公告、当前有效条款 | 自然地重复旧规则 |
| 产品支持 | 当前版本手册路径、最新 FAQ | 指引已过时的菜单名称和步骤 |
| 开发文档 | 当前 SDK/API 版本文档、官方示例 | 把旧选项名或代码模式混入回答 |
同一内容按依据优先结构重新看,可以这样读。
flowchart TD
  A["用户问题"]
  B{"先从记忆回答?"}

  A --> B
  B -->|是| D["旧答案或泛泛回答风险"]
  B -->|否,先检索| E["附加当前文档"]
  E --> F["有依据的回答"]
核心不是问题之后马上生成,而是问题之后先检索依据。
需要依据连接的场景
第一次读 RAG 时最容易混淆的点,是只看到回答错了,就马上把提示改得更长。但本节三个案例中,先于句子表达要检查的是回答前是否真的附加了当前文档。
| 如果看到这种场景 | 先确认什么 | 为什么这个顺序重要 |
|---|---|---|
| 回答语气或表格格式不满意,但事实关系本身已经正确 | 这是要再附加最新文档的问题,还是格式调整问题? | 如果依据已经正确,与其继续加 RAG,不如先区分提示或调整层问题。 |
| 回答很自然,但和今天变更的政策不同 | 是否先检索了最新政策文档? | 没有最新文档时,谨慎语气也可能重复过去答案。 |
| 菜单说明很亲切,但和实际画面路径不同 | 当前版本手册是否作为依据附加? | 比模板更先要对齐的是当前版本文档。 |
| 代码示例看起来合理,但在当前 SDK 中直接失败 | 当前版本官方文档和示例是否附加? | 要得到可复制的回答,当前版本依据必须先于一般知识。 |
把同一标准改写成更短的实务问题,可以这样读。
| 如果产生这种怀疑 | 先问的问题 |
|---|---|
回答格式有点可惜,但事实似乎对 | 现在需要的是新文档依据,还是语气·格式调整? |
回答很顺,但看起来有点旧 | 回答依据的是哪份最新文档? |
说明很亲切,但和实际画面不合 | 当前版本手册路径是否真的附加了? |
代码看起来合理,但运行不了 | 官方示例和当前 API 文档是否一起被取回? |
首先要学会的标准很简单。RAG 不是把问题写得更好的技巧,而是在系统阶段先固定回答前要附加什么依据的结构。
练习和示例
这个示例的目标不是实现真实的向量数据库或 LLM 服务,而是确认 RAG 的最小动作:问题 -> 用检索模型选择相关文档 -> 基于该文档回答。把退款政策、产品手册、SDK 文档问题一起运行,比较没有检索时的回答和附加检索模型选中文档后的回答有什么变化。
用户可能询问最新政策、当前版本产品画面、当前 SDK 用法。模型内部记忆中可能还残留旧标准或一般常识,如果不先找相关文档,就可能产生自然的错误答案。因此,这个示例把 scikit-learn 的 TfidfVectorizer 当作一个很小的检索模型来使用。它不是真正的嵌入模型,但把问题和文档转成向量,再选择接近文档的流程,可以通过直接执行来确认。中文短句如果只按空格分词比较,很容易漏掉相邻字符的表达,所以示例使用字符 n-gram。
下面示例使用两个 CSV 文件作为输入。
问题列表的一行表示一个用户问题。核心列是 case_id, question, memory_answer, current_signal。memory_answer 是不检索、只依赖模型记忆时可能出现的旧答案,current_signal 是用于观察回答是否提到最新依据的线索。这个线索不是答案表,所以还要同时看检索文档的主题一致性、版本状态、相似度、依据文档数量。
文档候选的一行是一个检索对象文档片段。核心列是 title, text, version_status, source_type。version_status 为 current 的行是当前依据文档,old 是归档文档,related 是相关但难以作为最终回答核心依据的辅助文档。
阅读这个示例时,最好先用表抓住要检查什么。
| 检查项 | 为什么需要 |
|---|---|
memory 回答是否包含最新信号 | 确认不检索回答会漏掉什么 |
| 检索模型选中的首位文档是否符合问题主题 | 确认回答前真的出现了依据选择阶段 |
| 检索模型选中的首位文档是否为当前文档 | 确认旧文档没有作为当前回答依据进入 |
| RAG 回答是否包含最新信号 | 辅助确认选中文档是否实际反映到回答中 |
| 是否一起留下相似度分数 | 为了追踪为什么先附加某份文档 |
代码中要确认的核心是:RAG 不是直接修回答句子的技术,而是回答前先让检索模型选择依据文档的结构。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 | |
在仓库根目录执行这段代码时,会输出如下结果。
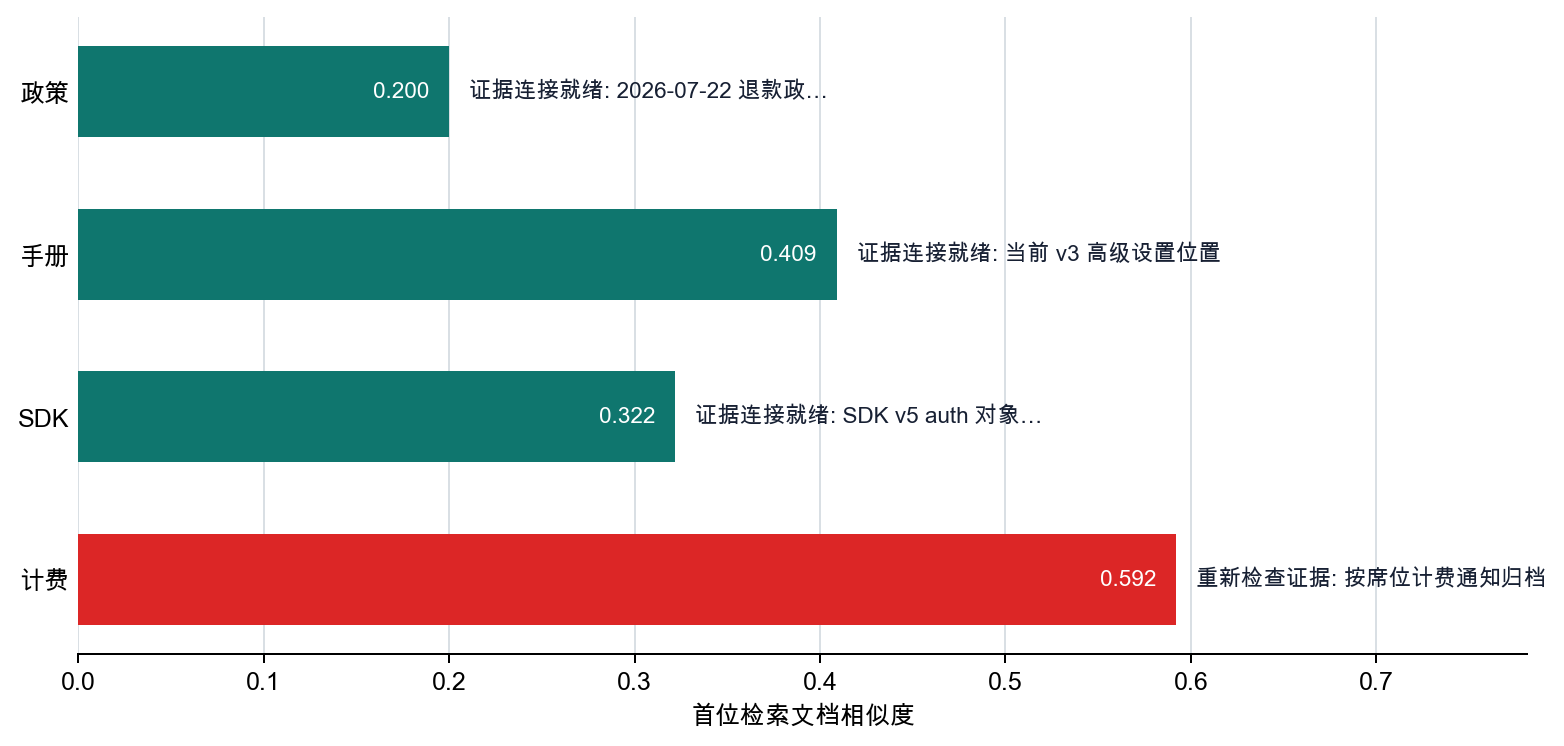
首先要注意的是,memory_update_mention_count 为 0,grounding_ready_count 为 3。如果模型只靠记忆、不检索就回答,四个问题都会漏掉最新信号。但 RAG 在政策、手册、SDK 问题中先附加了符合问题主题的当前文档,再在回答中恢复最新信号。相反,pricing 问题只有归档计费候选,所以即使附加了两个文档,top_doc_is_current 和 answer_mentions_expected_update 仍为 false。简言之,grounding_ready 不是检索文档的数量,而是检查是否真的把符合问题主题的当前文档连接到了回答。
因此,这个示例要检查的结果有两点。
- 系统不是只凭问题立即回答。检索模型先附加通过搜索选出的相关文档,然后再进入生成。
- RAG 质量不能只看回答句子,还要看
是否检索到符合问题主题的当前文档、是否留下相似度分数和依据标题、缺少依据时是否仍作为失败保留。
读者可以直接这样调整示例。
- 改动问题 CSV 中的表达,观察检索文档和相似度分数如何变化。
- 向文档 CSV 中加入归档文档或无关文档,检查当前文档是否仍在首位。
- 添加符合
pricing问题的当前文档,观察grounding_ready如何变化。 - 把
top_k从 1 改为 3,观察依据文档束如何变化。 - 修改
answer_with_rag,让它不仅返回文档标题,也返回文档 ID 和版本状态。
依据优先结构中改变的回答标准
前面的示例并没有实现 RAG 的全部。它展示的是最短场景:结构不是先做回答,再用依据装饰,而是先附加依据,再做回答。这里要读的核心,与其说是回答句子本身,不如说是回答前必须经过哪一个依据步骤。同样重要的是,这个原则会在政策、手册、SDK 等领域反复出现。
这个示例中要读的核心如下。
- 不要因为有问题就马上回答。
- 先找文档。
- 附加这些文档后再回答。
换句话说,RAG 的核心变化更多在回答前的依据步骤,而不是回答句子。
查看首位检索文档的相似度时,这种差异会更自然地出现。政策、手册、SDK 问题会把符合问题主题的当前文档放到前面,并基于这些文档生成回答。相反,计费问题会把低相似度的其他主题文档或归档文档放到前面,所以仅仅“检索到了文档”并不意味着依据连接已经准备好。因此,这里要读的变化不是回答句子稍微变好,而是必须另外记录回答前选中了哪份文档,以及它的相关性有多高。RAG 的核心不是让模型记住更多,而是在回答前检索当前相关文档,并让模型从这些文档出发说话。
更重要的是,说得像真的和附带依据回答不是同一个问题。因此,最好不要把 RAG 读成让模型变聪明的装置,而要读成通过回答前检索依据文档,结构性补偿提示限制的第一个连接结构。
检查清单
- 能否把 RAG 说明为
回答前附加当前文档的结构? - 能否区分提示、微调、RAG 各自先改变什么?
- 是否已经准备好把 P6-12.2 读成
附加文档如何实际引向回答,而不是为什么要附加文档?
来源和参考资料
- Patrick Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, NeurIPS, 2020, 确认日期:2026-07-19.
- OpenAI, Retrieval, OpenAI API Docs, 确认日期:2026-07-19.
- OpenAI, File search, OpenAI API Docs, 确认日期:2026-07-19.
- scikit-learn developers, TfidfVectorizer, scikit-learn documentation, 确认日期:2026-07-22.
- scikit-learn developers, Cosine similarity, scikit-learn documentation, 确认日期:2026-07-22.