P6-13.1 同时保存嵌入、原文和元数据的向量数据库
Section ID:
P6-13.1Version:v2026.07.26
在 P6-12.2 中,我们看到检索结果会在生成前附加到输入上下文。现在问题转向:这种检索实际运行在什么样的存储结构之上。
向量数据库(vector database) 是一种系统,它把嵌入(embedding)向量以及与之连接的原文、元数据一起保存,并帮助快速找到相似向量。
检索存储结构承担的工作
核心问题如下。
- 为什么不只搜索原始文本,而要保存向量?
- 向量数据库保存什么,又返回什么?
- 为什么 RAG 结构中经常出现向量数据库?
首先要收束的问题是为什么不只保存文本,而要把嵌入、原文、元数据一起保存。向量数据库不是一种新的魔法存储,而是 RAG 的检索存储结构:它把嵌入、原文和元数据一起处理,让检索到的文档能在生成前重新使用。
如果 P6-12.2 看的是取回文档在回答前附加到哪里,那么这里看的就是为了让这些文档可检索,要把它们放进什么存储结构。接着 P6-13.2 会看用什么索引和检索质量标准缩小已保存的候选。超出文档检索、进入实际查询或执行的事情,会在后面的工具使用部分另外讨论。
区分向量、原文和元数据的保存
理解向量数据库时,要先分开看保存的值。嵌入是为了找到相似文档而准备的数值表示,文档块(chunk)是生成阶段实际重新阅读的原文,元数据(metadata)则是来源、版本、日期、类别等在选择和验证候选时使用的信息。三者要一起读,才能自然连接:为什么 RAG 中普通关键词搜索不够,以及 P6-13.2 的索引和检索质量问题为什么要另外接上。
首先要区分的场景可以这样整理。
| 先看到的卡点 | 先想到的问题 | 为什么这个问题要先问 |
|---|---|---|
| 文档似乎存在,但问题表达和文档表达不一致 | 同义段落是否作为向量候选上来,而不是只靠关键词? | 表达不同也取不回相关段落时,检索根本无法开始。 |
| 似乎找到了相关段落,但没有能直接贴进回答的依据句 | 返回结果里是否一起包含原文块? | 生成阶段要重写实际句子,而不是数值向量。 |
| 段落看起来对,但无法判断是否最新、来自哪份文档 | 日期、版本、来源等元数据是否一起返回? | 即使看到候选,不能判断来源和新鲜度,也很难用于运营回答。 |
| 候选出现多个,但很难缩小哪个更合适 | 类别(category)、文档 ID 等选择标准是否一起附上? | 语义相似度含糊时,元数据可能成为最终选择标准。 |
以这张表为标准,向量数据库会更容易被读成检索后立刻能重新使用原文和元数据的存储结构,而不是只保存向量的地方。
为什么保存向量
正如前一节看到的,RAG 会先查找相关文档。但问题和文档并不总是使用相同词语。
例如,用户可能问:
退款标准变了吗?
而文档里可能写的是:
退货处理期间变更
这种情况下,简单关键词搜索可能漏掉文档,但在向量空间中把意义相近的表达找得更近的方法会有帮助。
也就是说,向量数据库让服务更容易管理把句子转换成数值向量后,快速找到语义接近的项目这件事。
向量数据库保存什么
读者最常误解的点是它只保存向量吗?。实际中通常会一起保存下面这些值。
- 嵌入向量
- 原文或文档块(chunk)
- 文档 ID
- 标题、日期、来源等元数据(metadata)
因此,与其把向量数据库看成孤零零堆着数值向量的地方,不如把它看成检索后还能重新取回原文的连接式存储。
它返回什么
把问题转换成嵌入并搜索后,系统通常返回:
- 接近的向量条目
- 与这些条目连接的文档块
- 相似度分数
- 元数据
然后 RAG 管线会把这些结果重新附加到提示上下文,并交给生成阶段。
为什么它常出现在 RAG 中
RAG 是问题 -> 相关文档检索 -> 生成结构。如果检索以语义为基础进行,就需要一个高效处理向量存储和相似度搜索的层。
向量数据库在 RAG 中承担检索阶段的实务型存储层角色。
也就是说,这个系统的作用不是替代模型,而是帮助模型找到可参考的文档。
和普通数据库有什么不同
与其先做严格比较,不如先抓角色差异。
| 存储视角 | 中心问题 |
|---|---|
| 普通数据库 | 怎样找到精确匹配的键、字段、条件? |
| 向量数据库 | 怎样找到语义相近的项目? |
当然,真实服务中也经常把两者一起使用。例如:
- 用户 ID 或日期过滤使用普通字段搜索
- 查找语义相近文档使用向量搜索
这样的组合很常见。
向量数据库也不是万能的
这一点必须一起放进去,才不会把加了向量数据库和检索质量问题自动解决混为一谈。
有向量数据库并不会自动解决:
- 总能找到最相关文档
- 自动排除旧文档
- 自动修正切分错误的文档
也就是说,向量存储结构很重要,但文档如何切块、元数据如何附加、使用什么嵌入模型,仍然同样重要。
非常简单地画出来
flowchart TD
  A["文本块"]
  B["嵌入向量"]
  C["向量数据库"]
  D["最接近的匹配块"]

  A --> B
  B --> C
  C --> D
这个图的核心是,文本先转换成向量,检索发生在这个向量存储中。
案例和示例
案例 1. 内部 wiki 搜索
想象内部 wiki 中,用户问:离职前公司笔记本要归还到哪里? 这种问题中,很容易先找直接包含笔记本归还这一表达的文档。但实际文档标题可能是离职流程、资产回收说明、离职检查清单,核心句也可能藏在正文里的IT 资产由安全团队服务台回收。这时,问题里有归还,文档里只有回收,业务流程其实仍然相同。只用关键词找,用户可能误以为没有文档,但实际上只是表达不同,指向的是同一流程。
这里改变的是,从看有没有相同词语,移动到看同义段落是否作为候选出现。向量数据库把问题和文档块保存成基于意义的向量,让相关段落更容易越过表达差异成为候选。这里要纠正的误解是表达不同就一定是不同流程。因此,这个案例中要确认的结果是,即使没有归还这个词,回收段落是否也能作为候选出现,并且该候选是否连同来源元数据一起交给生成阶段。
案例 2. 产品手册搜索
假设产品手册中,用户问:我想把设置恢复到初始状态。 如果只用字符串搜索,系统很容易先找含有初始状态、恢复等表达的文档。但实际手册可能混用出厂初始化、设置还原、重置后重新启动等术语,菜单路径也可能只出现在正文表格中的一格。例如,检索可能只找到概述段落,却漏掉写有实际按钮顺序的段落。这样用户会停留在重置功能似乎存在,但仍不知道实际按哪里的状态。
这里改变的是,从看表达是否相似,移动到看实际需要的步骤段落是否一起成为候选。向量数据库把这些文档块放在意义接近的位置,即使表达不同,也更容易均衡地收集相关候选。这里要纠正的误解是找到了概述说明,就等于找到了步骤。因此,这个案例中要确认的结果是,比概述说明更重要的实际按钮顺序段落是否一起出现,以及该段落的位置或类别元数据是否也一起返回。
案例 3. 开发文档支持
假设开发者问:请求限制发生时,有没有稍等后再发送的选项? 很容易先认为必须知道准确函数名或选项名才能搜索。但问题里没有准确名称,实际需要找到的是包含 retry 或 backoff 说明的 API 段落。例如文档可能只写了 exponential backoff 和 max_retries,而问题却完全展开成稍等后再发送。只靠关键词搜索时,问题没有选项名,相关段落可能不会成为候选。
这里改变的是,从看是否知道准确选项名,移动到看是否能找到语义接近的 API 说明。向量数据库把这种问题和文档块按意义保存得更近,能够更好地提起相关 API 说明。这里要纠正的误解是不知道准确选项名,搜索几乎就不可能。因此,这个案例中要确认的结果是,即使不知道准确选项名,retry 或 backoff 段落是否也会成为候选,并且该段落的版本、来源元数据是否一起返回,供后续生成阶段直接使用。
把三个案例按取回标准重新整理如下。
| 情况 | 只靠字符串搜索容易漏掉什么 | 向量搜索想取回什么 |
|---|---|---|
| 内部 wiki 搜索 | 归还和回收这种表达不同但业务相同的段落 | 同义的离职流程段落 |
| 产品手册搜索 | 藏在概述说明后的实际按钮顺序段落 | 执行步骤所需的核心段落 |
| 开发文档支持 | 问题中没有准确名称时的 retry/backoff 相关 API 说明 | 语义接近的选项和行为说明段落 |
同一内容从存储结构视角再看,可以这样读。
flowchart LR
  A["文本块"]
  B["嵌入向量"]
  C["元数据<br/>来源 / 类别 / 版本"]
  D["向量数据库记录"]
  E["检索 payload<br/>文本 + 元数据"]

  A --> D
  B --> D
  C --> D
  D --> E
核心不是只把向量单独保存,而是把文本和元数据也作为连接记录来处理,让生成阶段在检索后可以立刻重新使用。
检索结果要成为依据时
第一次读向量数据库时,常见误解是只记住找到相似句子这一句话,却没有马上连接到为什么原文和元数据也必须一起附上。但在真实 RAG 检查中,是否找到了相近向量和结果是否包含可立即使用的原文与来源信息同样重要。
检索结果要作为依据进入生成阶段,至少要同时看到三种值。
| 检索结果中要看的值 | 成为依据时为什么需要 |
|---|---|
| 相似度分数和候选排名 | 要决定先读哪个块,哪个块作为辅助候选。 |
| 原文块 | 生成阶段要附加实际句子来回答,而不是附加数值向量。 |
| 来源、版本、状态、类别 | 要确认候选是否当前有效、来自哪里、能应用哪些过滤。 |
首先要学会的标准很简单。向量数据库是查找相似向量的地方,同时也是为了把结果交给 RAG 下一阶段,而一起返回原文和元数据的检索存储结构。
练习和示例
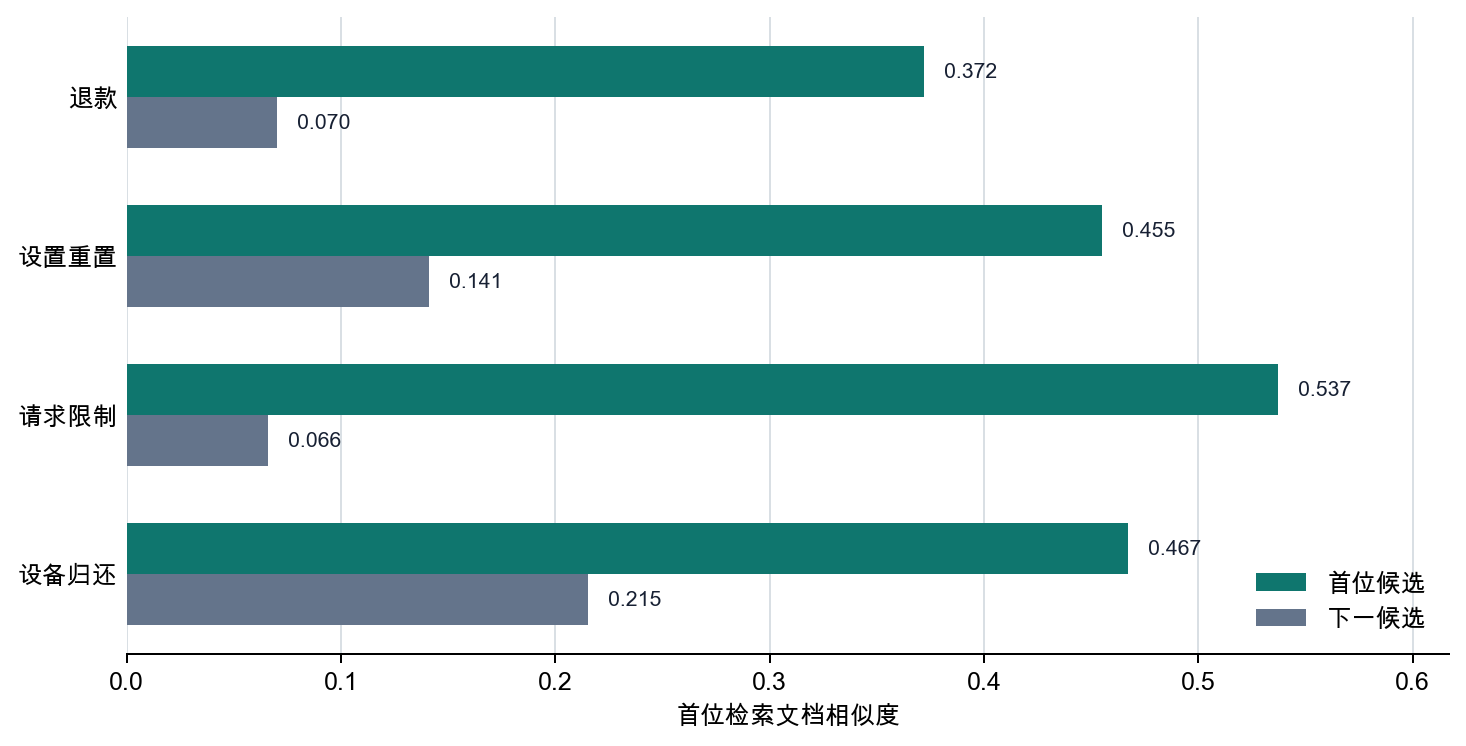
这个示例的目标不是实现完整的向量数据库引擎,而是用眼睛确认:向量、原文、元数据会一起保存,并通过与问题向量的相似度再次取回。我们把退款政策、设置菜单、SDK 限制处理、设备归还等不同问题一起运行,比较同一个存储结构如何根据问题取回不同文档块和元数据,以及这些结果如何变成可以交给生成阶段的检索结果包。
文档块不能只有数值向量。它们还要同时带有原文和来源信息。问题进来时,系统要找到接近问题向量的块;检索之后,则必须把原文文本和元数据一起交给生成阶段。因此,重要的不只是哪个是 1 位候选,也包括随它一起返回的来源和类别是什么。
下面示例使用文档块 CSV p6-12-vector-db-documents-zh.csv 和问题 CSV p6-12-vector-db-queries-zh.csv。文档文件的一行就像检索存储中的一条记录,包含文档 ID、标题、原文块、来源、类别、版本、状态。问题文件的一行包含一个用户问题。输出中会确认每个问题的相似度分数、首位候选文档块、检索后重新取出的原文和元数据,以及交给生成阶段的检索结果包。
先要确认的点如下。
| 检查项 | 为什么需要 |
|---|---|
| top-k 候选排名和相似度如何变化 | 确认问题改变时先读哪个文档块 |
| 返回结果是否包含原文 | 生成阶段必须能附加实际句子 |
| 返回结果是否包含元数据 | 来源标注、日期过滤、版本过滤都需要它 |
| payload 包中一起包含哪些值 | 确认检索结果是否足以作为生成依据 |
代码中要确认的核心是:向量数据库不只返回相似句子,还必须一起返回原文和元数据,才能作为 RAG 依据存储。示例使用 ChromaDB 的内存集合。为了避免外部嵌入模型下载变成重点,文档和问题用 TF-IDF 向量化,然后把这些向量直接放入 Chroma 集合并搜索。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 | |
示例输出可以这样读。
首先要注意的是,returned_top1_categories 会随问题变化,而且 payload_has_text_count 和 payload_has_metadata_count 都是 4。换句话说,向量数据库不应被读成只返回一个接近的数值项目。它应该被读成一个层:对不同问题把不同文档块提到 top-1,并返回生成阶段可以立即使用的原文和元数据。
同一结果可以按检索场景这样整理。
| 问题 | 首先可见的检索性质 | 为什么这样读 | 生成阶段能立即使用什么 |
|---|---|---|---|
refund_current | 退款政策检索 | 退款类别块成为 top-1,支持回复块作为下一候选跟随。 | 退款处理期间句子和来源 |
settings_reset | 手册检索 | 重置步骤成为 top-1,归档状态保留在元数据中。 | 重置步骤句和版本状态 |
api_retry | SDK 指南检索 | 请求限制重试文档以 API 类别和 SDK 版本成为 top-1。 | 重试选项说明和 SDK 来源 |
offboarding_asset | 内部 wiki 检索 | 笔记本归还问题把资产归还段落提到 top-1,同类别检查清单跟随。 | 资产归还句和 HR wiki 来源 |
因此,这个示例要留下两个结果。
- 存储层不只保存 embedding 数字。它保存并取回生成阶段可在搜索后复用的原文和元数据。
- 即使使用同一个存储结构,问题向量一变,首位文档块、来源、类别也会一起变化,所以向量数据库不只是数值存储,而是
按问题返回依据的层。
读者可以直接这样调整示例。
- 改变问题 CSV 中的
question措辞,观察首位文档和相似度分数如何变化。 - 向问题 CSV 中添加新问题,观察是否出现其他类别作为 top-1。
- 向文档 CSV 中添加另一条退款主题块,观察 top-k 候选包如何变化。
- 改变文档 CSV 中的
status或version值,想象它们如何作为检索后的过滤条件使用。
存储结构必须一起保留的值
上面的示例不是实现向量数据库的代码。它展示的是一个最小场景:找到相似向量这句话背后,有一层会一起保存和取回原文与元数据。关键在于,单独的嵌入数字不够;回答阶段要复用的信息必须在检索后仍被保留。同一个存储结构会因不同问题返回不同来源和类别,这一点也很重要。
在相似度图中,首位候选和下一候选的差距会因问题而异。设置重置问题的首位候选相对清楚,而退款问题则留下同时检查回复模板和政策通知的余地。当检索结果进入生成阶段时,这种差距可以帮助我们决定哪个文档块成为第一依据,哪个候选作为辅助依据保留。图表显示的是候选排名分离,但要把结果当作真实 RAG payload 使用,仍必须像文本输出那样同时保留原文和元数据。
向量存储必须一起返回什么
向量数据库不只是收集数值向量的地方。它是一个检索存储层,用来找到接近问题的文档块,并把这些句子和来源信息交给生成阶段。
嵌入和向量搜索在 LLM 之前也很重要。但随着生成式 AI 服务扩散,这项技术作为查找文档并把它们附加到回答结构中的关键层重新变得显眼。
这个存储层重要,是因为它:
- 把抽象数学概念中的嵌入连接到服务存储结构
- 帮助我们准备阅读 P6-13.2 的索引和检索质量问题
- 把前面的 P6-12.1 和 P6-12.2 RAG 流程重新连接到实际存储层
这里建立的视角会继续进入后续章节。
- P6-13.2 索引和检索质量:同时阅读检索速度和候选质量的标准
- P6-14.1 工具使用和 P6-15.1 AI agent 结构:观察检索型功能在整个系统中位于哪里
- P6-17.1 LLM 评价、P6-18.1 服务运营约束、P6-19.1 把小型生成式 AI 功能串成一个流程:把检索型和工具连接型功能带入实际设计与运营判断的可复用标准
检查清单
- 能否把向量数据库说明为
一起处理嵌入、原文、元数据的检索存储结构,而不是只含有向量的存储? - 能否说明字符串搜索和语义搜索为什么不同,为什么要分开?
- 是否准备好把 P6-13.2 读成
怎样更快、更准确地探索已保存候选的问题,而不是存储本身的说明?
来源和参考资料
- OpenAI, Vector embeddings, OpenAI API Docs, 确认日期:2026-07-19.
- Chroma, Adding Data to Chroma Collections, Chroma Docs, 确认日期:2026-07-22. 确认
ids,documents,metadatas,embeddings可以一起插入 Chroma collection。 - Chroma, Query and Get, Chroma Docs, 确认日期:2026-07-22. 确认 collection 可以用
query_embeddings查询并返回 documents 和 metadata。 - Jeff Johnson, Matthijs Douze, Herve Jegou, Billion-scale similarity search with GPUs, arXiv, 2017, 确认日期:2026-07-19.
- Yu A. Malkov, D. A. Yashunin, Efficient and Robust Approximate Nearest Neighbor Search Using Hierarchical Navigable Small World Graphs, arXiv, 2016, 确认日期:2026-07-19.