P6-13.2 在搜索速度和候选质量之间取舍的索引
Section ID:
P6-13.2Version:v2026.07.26
在 P6-13.1 中,我们看到向量数据库会把嵌入向量、原文和元数据一起保存,并在检索阶段承担实务型存储层角色。现在问题变得更具体:为什么快速找到相似向量很难,又必须放弃或调整什么?
索引(index)是提高检索速度的结构。在向量搜索中,它通常会迫使我们一起思考速度和准确度之间的平衡。
探索结构承担的工作
核心问题如下。
- 为什么不把每个向量都逐一比较?
- 索引在检索中承担什么角色?
- 为什么搜索速度和搜索质量必须一起调整?
索引应读成用于近似搜索的结构。在向量存储结构之上,先收束候选要以什么速度和质量平衡缩小;至于服务中检索以外的功能如何扩展,则留作另外的执行结构问题。
这里不把索引当作简单的内部技术名略过,而是把它读成为了更快搜索而允许近似(approximation)的结构。P6-13.1 看的是候选要放进什么存储结构才能再次取回,本节看的是这些候选要以什么速度和质量平衡被缩小。文档检索是否要走向实际查询或执行,会在 P6-13 的工具使用部分继续讨论。
区分检索速度和候选质量
- 可以在入门层面说明索引的角色。
- 可以说明精确查找和快速查找的差异。
- 可以说明向量搜索质量不能和速度分开阅读。
- 可以准备进入下一章的工具使用和服务结构说明。
首先要区分的场景可以这样整理。
| 先看到的卡点 | 先想到的问题 | 为什么这个问题要先问 |
|---|---|---|
| 响应变快了,但回答比以前贫弱 | 核心段落是否仍在 top-k 里? | 提速可能把真正需要的候选移除了。 |
| 最终回答自然,但执行时出现版本错误 | 当前版本文档是否包含在上位候选里? | 生成再流畅,候选包错了,起点也会错。 |
| 整体响应慢,但不清楚原因是检索还是生成 | 瓶颈是否在候选压缩阶段? | 如果探索结构是瓶颈,就应先调索引而不是提示。 |
| 候选来了很多,但总是先附加奇怪文档 | 是否同时看 top-1 正合率和 top-k 包含率? | 不区分找得快和找得对,就容易误读检索质量。 |
以这张表为标准,索引会更容易被读成同时调整速度和候选质量的探索结构,而不是快速查找的内部技术。
为什么不比较所有向量
最简单的方法,是把问题向量和已保存的所有向量逐一比较。但文档数量增多时,这种方式会变得很慢。
例如:
- 文档只有几百个时可能还能处理
- 但如果有几十万、几百万个文档
- 每次比较所有向量的成本就会变大
所以在实务中,快速缩小可能接近的候选会比精确比较所有项更重要。索引就在这里出现。
索引做什么
索引可以这样理解。
索引是一种探索结构,它帮助系统不从头到尾看完整体,而是更快找到可能接近的候选。
也就是说,索引接近于提高检索速度的寻路结构。
这一点和普通数据库索引也相似,但向量搜索的不同之处在于,它要找的是语义接近的项目。
为什么速度和准确度会绑在一起
这里的重要概念是近似搜索(approximate search)。
在向量搜索中,通常要在下面两者之间取得平衡。
- 非常准确但较慢的方式
- 可能稍微不那么准确但更快的方式
向量搜索索引通常更接近于快速找到足够好的候选,而不是总能找到唯一完美答案的结构。
搜索质量会因什么摇摆
搜索质量不只由索引种类决定。下面这些因素也会一起影响。
- 嵌入质量
- 文档块(chunk)大小
- 元数据过滤
- 索引设置
- top-k 数量
也就是说,搜索质量是存储结构、文档准备、检索策略一起制造的问题。
为什么它和 RAG 质量直接相连
RAG 会把检索结果附加到生成中。因此检索质量低时,生成做得再好,起点也会摇摆。
例如:
- 取回无关文档,回答会跑偏
- 不太重要的文档排在前面,核心可能被遗漏
- 旧文档混入,新鲜度问题会再次出现
也就是说,看向量搜索质量时,不能只看找得多快,还要先确认真正需要的文档是否进入候选集。这会决定 RAG 回答质量的上限。
非常简单地画出来
flowchart TD
  A["查询向量"]
  B["索引缩小候选"]
  C["top-k 最近候选"]
  D["用于生成的取回块"]

  A --> B
  B --> C
  C --> D
这个图的核心是,索引不是直接做回答生成,而是快速缩小检索候选。
案例和示例
案例 1. 内部文档搜索速度
假设内部 wiki 文档只有几百个时搜索很快,但增加到几万个后突然变慢。这个情况一开始很容易只被看成搜索稍微慢一点。但在运营阶段,回答延迟会直接导致用户离开。例如,一个休假规定问题光是选择候选文档就多花 4 秒,即使后面的生成阶段不变,用户也会觉得整个聊天机器人很慢。从这个时点开始,问题不只是文档变多,而是在许多文档中能多快缩小候选。
这里改变的是,从看文档数量是否增加,移动到看核心候选压缩时间是否仍在实际等待时间内。索引结构和检索策略正是改变候选压缩速度的核心装置。这个案例要纠正的误解是慢只是因为文档多,没办法。因此要确认的结果是,文档数量增加后,核心候选缩小时间是否仍处于服务等待时间内,以及能否用记录说明瓶颈在候选压缩阶段,而不是生成阶段。
案例 2. 手册回答质量
假设产品手册中必须找到一个准确的设置段落,但为了让搜索更快,把近似设置调得很激进。响应时间变短时,很容易觉得搜索更好了。但这样即使延迟减少,最重要的段落也可能从候选中掉出去,回答质量马上摇摆。例如,关闭自动保存问题只抓到设置概述段落,实际菜单路径段落却漏掉,回答就可能止于在设置里更改,实际用户仍然找不到按钮位置。反过来,如果总是使用最严格搜索,相关段落可能找得很好,但回答会太慢。
这里改变的是,从看响应是否变快,移动到同时看核心段落是否留在候选里。也就是说,运营者不仅要问是否变快,还要问快速找到的候选是否足够好。这个案例要纠正的误解是把快和好自动当成同义词。因此要确认的结果是,响应时间变快后实际核心段落是否仍在候选里,以及因为候选中漏掉该段落,步骤型回答会变得多贫弱。
案例 3. 开发文档助手
假设开发文档助手拥有许多名称相似的 API 文档。人只看最终回答时,通常会先觉得模型把代码解释错了。但如果 top-k 结果里不是当前版本文档,而混入了旧版本文档,生成阶段就可能基于该候选做出相当自然的回答。例如,询问 2.x 选项时,1.x 文档进入候选上位,回答可能很流畅,但执行时会立刻出现错误代码示例。也就是说,真正的起点可能是候选文档包已经偏了。
这里改变的是,从看最终回答是否自然,移动到先看top-k 候选中是否包含正确版本文档。因此这个场景需要与生成评价分开的检索质量评价。这个案例要纠正的误解是只改最终句子就能解决问题。所以要确认的结果是,在看最终回答前,top-k 候选中是否实际包含当前版本文档,以及即使 top-1 错了,正确文档是否仍在 top-k 中存活。
把三个案例按速度·质量平衡重新整理如下。
| 情况 | 只看变快会漏掉什么 | 要一起看的检索质量标准 |
|---|---|---|
| 内部文档搜索速度 | 只看整体延迟,漏掉候选压缩失败 | 是否在服务时间内保留核心候选 |
| 手册回答质量 | 响应变快后,核心步骤段落可能掉出 | 核心段落是否留在 top-k 内 |
| 开发文档助手 | 自然的最终回答掩盖版本候选错误 | 当前版本文档是否包含在 top-k 中 |
同一内容可以按检索取舍结构重看。
flowchart LR
  A["查询向量"]
  B["更快的索引设置"]
  C["更慢但更严格的设置"]
  D["更低延迟"]
  E["更好的候选质量"]
  F["风险:错误 top-k"]

  A --> B --> D
  A --> C --> E
  B --> F
核心是,快和好不会自动成为同一个意思。
必须一起看搜索质量的场景
第一次读索引时,常见误解是只看到响应时间减少,就觉得搜索也变好了。但实际检查时,必须把快了多少和正确文档是否留在候选里一起读。
| 如果看到这种场景 | 先确认什么 | 为什么要一起看 |
|---|---|---|
| 响应变快了,但回答变贫弱 | 核心段落是否留在 top-k 里? | 提速可能移除了需要的候选。 |
| 最终回答自然,但执行出现版本错误 | 当前版本文档是否包含在 top-k 中? | 生成再流畅,如果候选包已错,回答也会站在错误依据上。 |
| 搜索延迟很长,用户体验差 | 瓶颈是否是候选压缩而不是生成? | 慢的来源是索引搜索时,应先调检索结构而不是提示。 |
同一标准可以改写成更短的实务问题。
| 如果产生这种怀疑 | 先问的问题 |
|---|---|
变快了,但答案变弱了 | 核心候选是否被推到 top-k 外? |
答案像样,但版本不对 | 当前版本文档是否在上位候选里? |
整体都慢,不知道瓶颈在哪里 | 候选压缩时间是否大于生成时间? |
首先要学会的标准很简单。索引评价不是只看 latency。它是同时看 top-k 包含率、top-1 正合率、版本正合性,才能读出真实搜索质量的工作。
练习和示例
这个示例的目标不是实现真实的 ANN 索引引擎,而是通过小实验确认:快速缩小候选的设置和不漏掉正确候选的设置可能互相冲突。实际 ANN 库实习更适合放在 Part 7 项目中。这里读取 CSV 中的文档向量和问题向量,改变 candidate_budget 和 version_filter,观察 top-k 包含率、top-1 正合率、版本正合性、延迟时间替代值如何变化。
在开发文档搜索中,当前版本文档必须进入 top-k。快速设置会降低延迟,但可能漏掉部分候选;较慢设置花费更久,但可以更好地取回重要候选。
下面示例使用多个问题、拆成 CSV 的文档向量和问题向量、候选压缩设置 candidate_budget、版本过滤设置 version_filter。输出中会确认每个问题的延迟时间、每个问题的 top-k 候选、当前版本文档是否实际包含、各设置的 top-k 包含率和 top-1 正合率。设置故意分为快速设置、均衡设置、严格设置三个阶段。这样可以区分快但遗漏的情况、候选里包含但 1 位摇摆的情况、通过版本过滤稳定下来的情况。
这个示例中要一起看的检查项如下。
| 检查项 | 为什么需要 |
|---|---|
target_in_top_k | 确认生成阶段可参考的候选中正解是否存活 |
rank_of_target | 确认正解是否太靠后,以至于生成可能漏掉 |
top1_is_target | 确认最先附加的文档是否正确 |
top1_version_ok | 确认名称相似的旧版本文档是否先出现 |
文档向量和问题向量不直接长篇放进正文代码,而是分离成 CSV 资产。
先短看输入文件的一部分会有帮助。文档 CSV 不只包含数值向量,也在同一主题中放入当前版本文档,以及容易混淆的旧版本和一般说明文档。
| doc_id | topic | version | boundary_hint | config_axis | recovery_axis | flow_axis |
|---|---|---|---|---|---|---|
| sdk_v2_request_timeout | request timeout | v2 | current_version_candidate | 0.90 | 0.18 | 0.10 |
| sdk_v1_request_timeout_guide | request timeout | v1 | old_version_collision | 0.93 | 0.16 | 0.09 |
| sdk_general_request_timeout_notes | request timeout | general | general_note_collision | 0.87 | 0.22 | 0.12 |
问题 CSV 会用多种表达询问同一目标文档。它包括直接询问文档名的问题、改写表达的问题、与旧版本文档碰撞的问题,也包含部分错误症状或混合意图问题。因此比起单一问题偶然通过,更能观察表达和周边候选改变时,目标文档是否仍留在 top-k 中。
| query_id | topic | variant | target_doc | reader_hint | | --- | --- | --- | --- | | Q01 | request timeout | direct_name | sdk_v2_request_timeout | 文档名和查询词几乎一致的基准问题 | | Q02 | request timeout | paraphrase | sdk_v2_request_timeout | 不用 timeout 一词也应找到同义文档 | | Q03 | request timeout | boundary_wording | sdk_v2_request_timeout | 1.x 文档可能看起来更近,因此要一起看版本条件 | | Q40 | pagination cursor | symptom_wording | sdk_v2_pagination_cursor | troubleshooting 相关,但基本 usage 文档应保持可见 |
代码中要确认的核心是:搜索质量评价首先要看正确文档是否实际进入上位候选,而不是只看速度。代码直接使用的列是 doc_id, version, config_axis, recovery_axis, flow_axis, question, target_doc。三条轴不是要再现真实嵌入模型的内部维度,而是把设置文档、恢复文档、处理流程文档彼此靠近或远离的情况简化成容易阅读的坐标。topic, boundary_hint, variant, reader_hint 是帮助读者打开 CSV 时观察哪些行是当前版本候选,哪些行容易与旧版本或一般说明碰撞的说明列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 | |
执行结果示例如下。
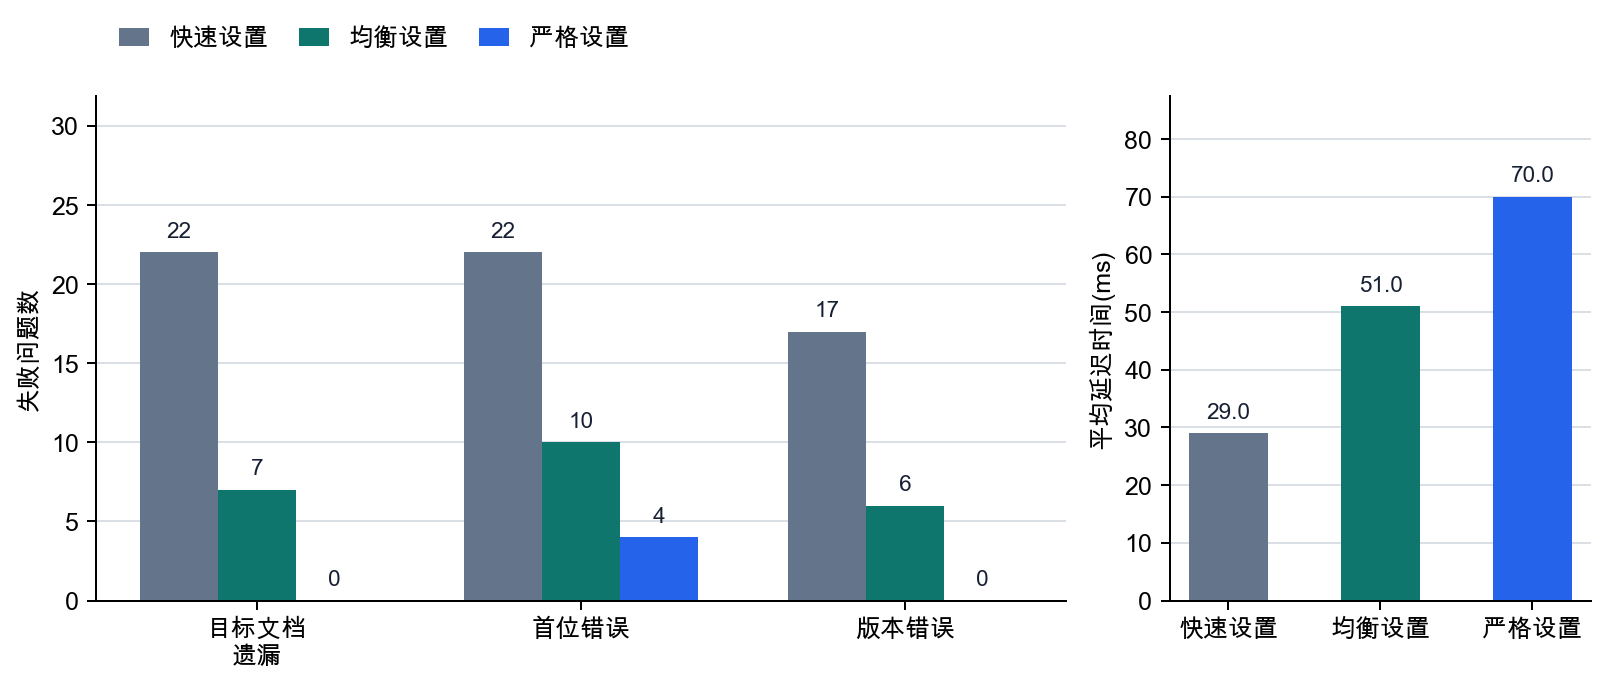
这个示例中首先要看的是,fast 设置的平均延迟时间替代值较低,但因为候选预算缩小到 1,它没有把许多 2.x 目标文档留在 top-k 中。balanced 设置扩大候选预算,减少了许多遗漏,但在相关文档较多的问题中,目标文档会被推到第 2 位,或者仍然掉出 top-k。strict 设置打开 version_filter 并进一步扩大候选预算,减少了目标遗漏和版本错误,但同为 v2 的 troubleshooting 文档排在第 1 位的情况不会自动消失。
因此,这个示例要确认三点。
- 更快的搜索设置不总是更好的搜索。必须把延迟时间和
真正需要的文档是否进入 top-k、top-1 是否正确、是否需要版本过滤一起读。 - 即使
target_in_top_k通过,top1_is_target和top1_version_ok仍可能失败,所以搜索质量不能用一个通过与否收束。 - 单个问题可能偶然通过,但把多个问题绑在一起看时,
hit_rate、top1_hit_rate、version_ok_rate的差异会更清楚。
读者可以直接这样调整示例。
- 把
settings["fast"]["candidate_budget"]改成 1、2、4,观察候选数和遗漏文档如何变化。 - 把
settings["balanced"]["version_filter"]改成"v2",确认旧版本文档排在第 1 位的问题是否减少。 - 在
inspect_search中加入recall_like_score或top2_version_mix之类的项目,扩展自己的质量指标。
把速度和质量冲突重新读成运营判断后,就更清楚不能只看单一指标来断定原因。
| 先看到的信号 | 立刻在检索索引层确认什么 | 为什么先看这里 |
|---|---|---|
| 响应变快,但回答经常跑偏 | target_in_top_k, top1_hit_rate | 在责怪生成前,先确认检索候选本身是否摇摆。 |
| top-k 里有正解,但最终回答错了 | rank_of_target, chunk 构成, 生成阶段使用方式 | 检索可能通过了,但生成没有正确使用核心候选。 |
| 名称相似的旧版本文档经常混入 | top1_version_ok, 元数据过滤, 版本标签 | 问题可能不是速度,而是候选正合性和过滤设计。 |
| 只有特定问题群搜索较弱 | 按问题类型看的 hit rate, chunk 大小, 嵌入表达 | 数据准备或表达问题可能比整个索引更关键。 |
检索取舍中摇摆的速度和质量
前面的示例不是实现真实 ANN 的代码,而是用最小搜索实验说明:更快搜索和更好候选取回不是同一个目标。比如只看延迟时间替代值选择快速设置,结果核心段落从候选中掉出,那么后面的生成阶段即使很流畅,回答质量也会立刻下降。这里重要的不是数字大小本身,而是搜索中必须同时看速度和质量,并决定哪一边更优先。运营者还要看多个问题上的 top-k 包含率,而不是单一成功案例,才能区分偶然成功和真实稳定性。
从图表看,快速设置的平均延迟较低,但目标文档遗漏和首位错误较大。均衡设置减少遗漏,但首位错误和版本错误仍然存在。严格设置更慢,但消除了目标遗漏和版本错误,仍留下相关 v2 文档排在首位的一部分错误。因此索引评价不能只看 latency,而要把目标遗漏、首位错误、版本错误一起放着读。
选择索引时一起摇摆的东西
向量搜索索引是让搜索更快的结构。但在实际运营中,如果不一起看正解候选是否在 top-k 中存活,就无法选择好的设置。
随着向量搜索广泛使用,搜索问题又把我们带回到数据结构和算法的感觉。但在 LLM 服务语境中,更重要的是这不只是搜索引擎问题,而会直接连接到生成质量和用户体验。
这个观点重要,是因为它:
- 让我们把向量数据库和探索结构一起读,而不是只读成简单存储
- 为后面的评价章中为什么要单独看检索指标做准备
- 强化服务结构中速度、成本、质量彼此纠缠的观点
检查清单
- 应能把索引说明为
同时左右速度和质量的探索结构,而不只是提高探索速度的结构。 - 应能区分
正解是否包含在 top-k 中和第 1 个结果是否就是正解这两个不同质量指标。 - 应抓住下一章不是检索存储结构说明的延长,而是基于缩小后的候选进入实际工具调用和外部执行的阶段。
来源和参考资料
- Yu A. Malkov, D. A. Yashunin, Efficient and Robust Approximate Nearest Neighbor Search Using Hierarchical Navigable Small World Graphs, arXiv, 2016, 确认日期:2026-07-19.
- Jeff Johnson, Matthijs Douze, Herve Jegou, Billion-scale similarity search with GPUs, arXiv, 2017, 确认日期:2026-07-19.
- OpenAI, Vector embeddings, OpenAI API Docs, 确认日期:2026-07-19.