P6-14.2 把自然语言请求分成名称和参数的函数调用
Section ID:
P6-14.2Version:v2026.07.31
阅读函数调用时,要分别写下 natural_language_request、function_name、arguments、schema_validation、execution_result、response_use。这样才能追踪自然语言请求被结构化成了什么名称和参数,以及结果又如何用于回答。
在 P6-14.1 中,我们看到工具使用(tool use)把模型连接到外部函数。这会引出一个更具体的问题。
系统用什么格式交换应该使用工具这个判断?
函数调用(function calling)是一种方法。它让模型用结构化格式表达应该调用哪个工具,以及要带哪些参数(arguments)。
结构化执行请求的标准
核心问题有三个。
- 为什么需要 function calling?
- 自然语言请求和结构化工具调用有什么不同?
- 为什么把函数名称和参数分开很重要?
首先要收束的问题,是把 function calling 读成为了可靠连接工具使用而形成的结构化执行请求,并理解为什么自然语言需要变成名称和参数结构。
持续推进反复工作的执行结构,是把多个结构化调用绑成多个步骤的问题。Function calling 先聚焦于让一个执行请求变得可验证。
这里不要把 function calling 读成产品功能名,而要读成可靠连接工具使用的结构化方法。如果 tool use 问的是应该执行什么,function calling 问的是这个执行判断如何变成名称和参数结构,让系统能够验证并继续处理。如何串联多个调用,会接到 P6-14 的 AI agent 结构。
核心变化是从应该执行什么移动到怎样把这个执行请求变成可验证结构。这个差异让我们把 function calling 读成稳定执行连接的中间层,而不是简单的产品功能。
这个阶段要先留下的记录,是函数名称、参数、缺失字段检查、预期结果格式,以及调用被阻止的理由。这些记录让我们能把自然语言请求重新对齐到执行结构,并把执行失败和之后的运行失败分开。
区分自然语言请求和结构化执行请求
自然语言请求容易让人阅读和推断。结构化执行请求则把名称和字段分开,让系统在执行前检查。两种形式可以承载同一个意图,但用途不同。
| 区分 | 自然语言请求 | 结构化执行请求 |
|---|---|---|
| 主要读者 | 人和模型 | 应用、API、执行环境 |
| 主要优势 | 容易宽泛表达意图 | 容易验证字段并追踪日志 |
| 常见弱点 | 缺失条件可能藏在句子里 | schema 外的意图需要另行解释 |
| 先检查什么 | 用户想要什么? | 哪个函数会用哪些参数运行? |
请求如何变成函数名称和参数
Function calling 不会直接执行自然语言。它会把自然语言转成执行前可以检查的中间表达。这个转换可以这样分开。
| 阶段 | 示例 | 此阶段要检查什么 |
|---|---|---|
| 自然语言请求 | 今天把 300 美元换算成韩元 | 用户想要什么? |
| 函数候选 | lookup_exchange_rate | 应该调用哪个函数? |
| 参数候选 | base_currency=USD, quote_currency=KRW, amount=300 | 执行所需值是否填好了? |
| 验证结果 | ready 或 needs_clarification | 现在执行、追问,还是需要批准? |
这张表的重点是,function calling 不是回答句子。它是执行前一刻的可验证请求结构。
为什么需要结构化
如果只用自然语言句子处理 tool use,歧义会很大。
假设模型说:
搜索今天首尔的汇率并告诉我。
人可以理解这句话,但系统仍然可能不清楚这些内容。
- 应该使用哪个工具?
- 参数是什么?
- 预期日期格式是什么?
- 失败时应该返回什么?
所以 function-calling 结构通常会分开:
- 工具名称
- 参数名称
- 参数值
换句话说,自然语言不会原样执行。它会被转换成可执行结构。
自然语言请求和结构化函数调用,用不同形式承载同一意图。自然语言对人友好,但缺失条件可能藏在里面。结构化调用对人显得僵硬,却让系统更容易验证字段并留下执行记录。因此,function calling 可以读成把句子变成结构的方法,使系统能更安全地执行模型意图。
为什么要分开函数名称和参数
这个区分让系统能分别验证调用哪个函数和传入哪些值,然后拆分失败原因。
例如:
- 函数名称:
lookup_exchange_rate - 参数:
{"base_currency": "USD", "quote_currency": "KRW", "amount": 300}
有了这个分离,系统更容易:
- 检查工具是否被允许
- 验证参数格式
- 发现缺失参数
- 在执行前要求批准
Function calling 不只是整齐的格式。它是一种提高可验证性(verifiability)和可控制性(controllability)的结构。
结果也应该结构化吗?
是的。当工具结果也以结构形式返回时:
- 模型更容易再次读取
- 应用更容易后处理
- 日志和轨迹(trace)更容易留下
所以 function calling 最好不只读成输入结构化,也要读成会重新连接执行结果的流程。
Function calling 并不总是足够
拥有 function calling 并不保证:
- 模型总是选择正确工具
- 参数总是完整
- 错误执行一定会被完全阻止
因此,真实系统通常还会添加:
- schema 验证
- 权限检查
- 用户批准
- 失败时的重试或错误报告
最小图示
flowchart TD
  A["用户请求"]
  B["模型生成结构化函数调用"]
  C["应用验证并执行"]
  D["工具结果"]
  E["最终回答"]

  A --> B
  B --> C
  C --> D
  D --> E
这张图的重点是,流程变成了句子 -> 结构 -> 执行 -> 结果。
案例和示例
案例 1. 汇率查询
考虑请求告诉我今天的美元汇率。人们大致能理解,所以会觉得系统应该可以直接处理。但系统必须先分开哪一组货币、哪一天、哪个地区标准等参数,实际查询才可能成立。例如,用户意图可能是 USD/KRW,也可能是美元指数。如果不做这个分离,查询本身可能成功,却返回和用户意图不同的值。执行成功和意图匹配不是同一件事。
判断标准会从问题大致能否理解,变成查询所需参数是否完整结构化。Function-calling 结构把自然语言变成显式字段,使执行阶段更清楚。需要越过的误解是:如果句子能自然理解,查询也会正确。要检查的结果是,查询前是否已经把问题拆成货币对、基准日期等参数,并且只看这些参数也能重新确认原始意图。
案例 2. 日历创建
在自然语言中,明天下午 3 点安排一个会议看起来已经足够具体。人们常常期待对方会理解。但实际日历 API 需要参会者、时区、标题、日期格式等更结构化的参数。明天在用户时区不同的时候可能指向不同日期;没有参会者,事件创建本身也可能不完整。如果漏掉这个差异,模型可能很好地理解句子,但执行阶段会立刻停止,或者创建出错误时间的事件。时间错误或参会者为空的日历事件,更接近运行失败,而不是成功。
判断标准会从句子是否足够具体,变成API 要求的所有字段是否实际填好了。Function-calling 结构把隐含信息变成显式参数包。要检查的结果是,在创建日历事件前,时间、日期、标题、参会者是否都被结构化,缺失字段是否在执行前显现出来。
案例 3. 代码 AI agent
想象一个代码 AI agent 在读取文件、运行测试、应用补丁之间来回切换。如果只留下自然语言说明,很难追踪哪项工作用了哪些参数。像我读了文件并运行了测试这样的句子看似足够说明,但在运行中我们需要知道读的是哪个文件、运行的是哪条测试命令。同一句运行了测试,会因为目录、标志、目标不同而表示非常不同的事情。
如果过程被记录成函数调用,read_file、run_tests、apply_patch 这样的步骤会明确,执行流程也更容易重放。判断标准从只记录做了什么工作,变成检查哪个函数带哪些参数运行过是否可追踪。没有这个记录,同样失败再次出现时,很难判断哪个阶段的输入发生了变化。因此,function calling 不只和执行成功直接相关,也和日志、可复现性直接相关。要检查的结果是,能否追踪哪个函数带哪些参数被调用,并重建哪个阶段因为参数缺失而停止。
三个案例可以从结构化视角重新分组。
| 情况 | 自然语言中仍然含糊的东西 | Function-calling 结构明确了什么 |
|---|---|---|
| 汇率查询 | 按什么标准查询哪个值 | 货币对、日期、地区参数 |
| 日历创建 | 明天、下午等表达的执行标准 | 日期、时间、时区、参会者字段 |
| 代码 AI agent | 什么按什么顺序运行过 | 函数名称、参数、执行日志 |
同样内容可以重新读成结构化执行请求流程。
flowchart LR
  A["自然语言请求"]
  B["结构化调用<br/>名称 + 参数"]
  C["验证<br/>是否缺字段?"]
  D["可执行准备完成"]
  E["需要追问或重试"]

  A --> B --> C
  C -->|有效| D
  C -->|无效| E
关键点是,已经结构化和已经准备好执行不是同一件事。
什么时候需要结构化调用
第一次读 function calling 时,最常见的混淆是把句子已经理解和执行已经准备好当成一回事。实际上,我们必须分别检查将调用哪个函数、需要哪些字段,以及是否能在没有缺失值的情况下执行。
| 如果出现这个场景 | 先检查 | 为什么要先看这个 |
|---|---|---|
| 请求含义清楚,但系统的工具选择含糊。 | 函数名称是否明确决定? | 如果函数名含糊,参数验证开始前,执行目标就已经不稳定。 |
| 函数看起来正确,但执行经常立刻停止。 | 必填参数是否没有遗漏地填好? | 自然句子可以说得通,但日期、时区、货币对等字段仍可能为空。 |
| 结构存在,但结果仍然不稳定。 | 结果格式和失败原因是否一起记录? | 只有能追踪调用成功和失败,才可能重试或修正。 |
同样标准可以缩成实践问题。
| 如果你怀疑这一点 | 先问的问题 |
|---|---|
我知道它想做什么,但调用很模糊。 | 是否由一个函数名称明确了执行目标? |
请求很具体,为什么执行还会失败? | 所有必填参数都填好了吗? |
失败了,但不知道停在哪里。 | 结果格式和失败原因是否被结构化记录? |
第一个标准很简单。Function calling 不是把自然语言整理得好看。它是把函数名称、参数、结果分开,让执行前验证和执行后追踪成为可能的结构。
练习和示例
这个示例不会调用真实 API 或模型。它展示函数调用候选在执行前必须通过哪些验证检查。如果只看一两句话,很容易以为做出函数名称和参数就够了。所以我们一次验证多个函数候选,看看哪些已经准备好执行,哪些需要追问,哪些必须因为批准而停止。
下面的示例使用函数调用候选 CSV p6-13-2-function-call-requests-zh.csv。一行包含用户请求、参考用英文请求、函数名称、参数候选,以及是否需要批准。这个 CSV 不是真实模型产生的日志,而是为了观察 function calling 验证结构而制作的输入。model_request_en 是为了想象多语言译本和模型输入格式而保留的参考列。这个示例中的验证代码只使用函数名称和参数候选。CSV 中的空白单元格表示该函数调用候选仍然缺少参数,或执行前需要再次确认。
用户用自然语言请求创建日历事件、查询汇率、修改文件,或发送邮件草稿。系统不会直接执行这些句子。它会先根据每个函数的 schema 检查必填参数,并把会改变外部状态的请求分离到等待批准状态。因此,已经结构化和已经准备好执行不是同一件事。
要一起阅读的检查项如下。
| 检查项 | 为什么需要 |
|---|---|
function_name | 检查正在调用哪个函数。 |
missing_fields | 检查执行前哪些参数为空。 |
status | 区分准备完成、需要追问、需要批准。 |
schema_required_fields | 确认每个函数有不同的必填参数。 |
输入 CSV 有 24 行。重点不是大规模数据处理或统计代表性,而是把具有不同验证标准的候选并排放在一起:日历创建、汇率查询、文件补丁、邮件草稿。行数帮助显示,每个函数 schema 会产生不同的必填参数检查。
代码的核心是,function-call 风格的 tool use 会分开函数名称、参数、schema 验证、批准,从而生成执行前一刻的状态。
示例输出可以这样读。
首先看 status_counts。24 个调用草稿中,13 个已经准备好执行,9 个因为 time、timezone、file_path、body 等必填参数缺失而需要追问,2 个虽然必填参数已经填好,但仍然停在等待批准状态。这就是 function-call 结构重要的原因:它会在执行前暴露这些差异,而不是把它们藏在自然语言回答后面。
接着看 function_status_counts。同一个 ready 状态,在日历创建、汇率查询、文件补丁、邮件草稿中由不同的必填参数包产生。因此,function calling 不是对所有工具套用一个通用字段检查。一旦函数名称确定,验证就会切换到该函数自己的 schema。
最后,missing_field_counts 表明缺失信息不是一种失败。日历创建可能缺 time、timezone 或 attendees。汇率查询可能缺 amount 或 quote_currency。文件补丁可能缺 file_path 或 change_summary。邮件草稿可能缺 recipient 或 body。因此,function calling 不只能记录失败,还能记录是哪一个参数挡住了执行。
读者可以直接这样调整示例。
- 在 CSV 中添加新的函数候选,并在
function_schemas中添加必填参数。 - 修改
approval_required,检查同一个参数结构会变成ready还是needs_approval。 - 填入或删除空白单元格,观察
status_counts和missing_field_counts怎样变化。 - 给
function_schemas添加必填字段,观察更严格的运行策略如何增加追问需求。
再往前一步,我们应该区分 function calling 解决了什么,以及还没有解决什么。
| 情况 | Function calling 直接解决什么 | Function calling 之外还剩什么 |
|---|---|---|
| 请求能理解,但执行输入含糊。 | 分离函数名称和参数,使执行输入显式化。 | 决定选择哪个工具的质量 |
| 缺失字段需要在执行前被发现。 | 验证 missing_fields 等缺失参数。 | 判断值是否符合用户意图的语义解释 |
| 结果需要传给后续步骤。 | 更容易用一致结构返回结果。 | 规划多个调用的顺序 |
| 失败需要复现并记录。 | 追踪哪个函数带哪些参数被调用。 | 运行循环中的重试、替代路径、停止条件 |
这张表重要,是因为它避免把 function calling = agent 混在一起。Function calling 结构化的是执行前一刻的一个请求,而规划和重试多个调用属于 agent 层。
结构化执行请求内部也会分裂验证标准
上面的示例不是实现 function calling 全部内容的代码。它说明人说的话和系统执行的东西不是同一句话。重点不是去掉自然语言,而是读出执行前一刻必须存在什么名称和参数结构。
图中,同一批请求里的每个函数会分裂成不同的执行准备状态。左侧显示日历创建、汇率查询、文件补丁、邮件草稿分别落入 ready、needs clarification、needs approval。右侧显示阻止执行的所有缺失字段。所以重点不只是有结构,而是这个结构能显示哪些字段缺失、哪些请求不能在没有批准时继续。
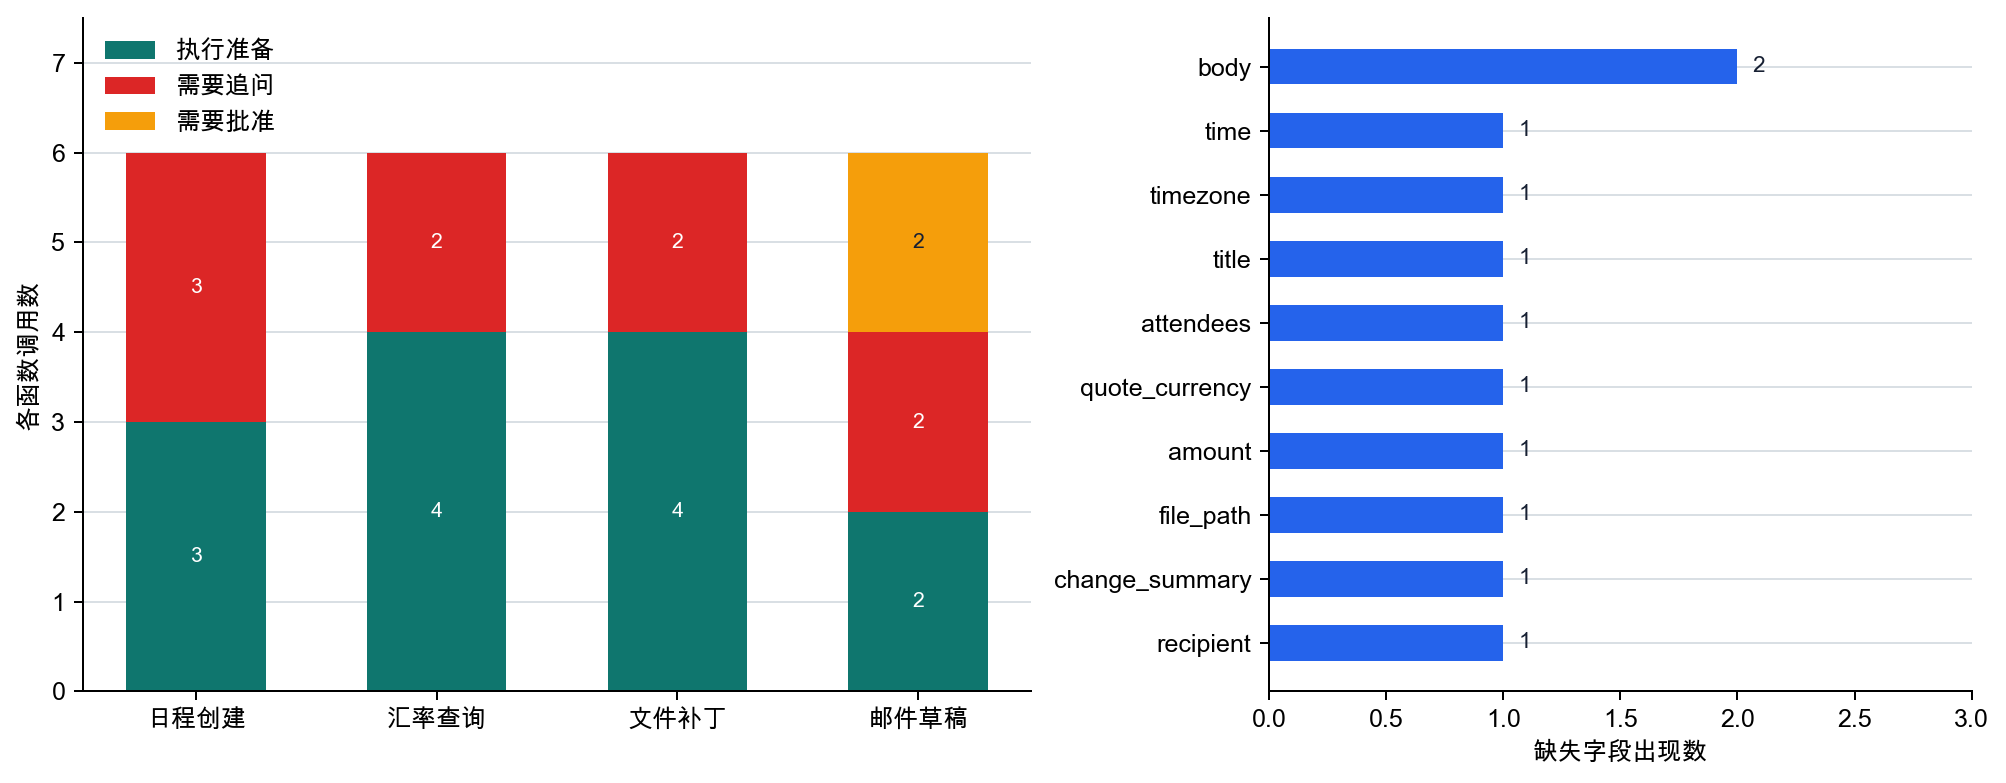
Function calling 如何稳定执行请求
Function calling 的核心不是去掉自然语言。它是把执行前一刻的请求变成名称和参数分开的可验证结构。
更重要的区分是,解释得好和通过实际可执行请求结构不是同一个问题。因此,function calling 不是增加更多工具的装饰。它是在执行前把请求变成可验证结构,从而让 tool use 不那么不稳定的代表性方法。
这种结构化很重要,因为它:
- 防止 tool use 停留在含糊自然语言层面
- 给我们理解 AI agent、MCP、harness 所需的结构感
- 解释为什么可执行 AI 服务需要应用层
检查清单
- 你应该能够把 function calling 说明成
名称和参数分开的可验证调用结构,而不是自然语言指令。 - 你应该能够说出为什么分离
哪个函数和哪些参数会让验证和失败追踪更容易。 - 你应该理解,下一个问题会移动到如何在目标流程中按顺序连接结构化调用。
参考资料
- OpenAI, Function calling, OpenAI API Docs, accessed: 2026-07-19.
- OpenAI, Using tools, OpenAI API Docs, accessed: 2026-07-19.
- Shunyu Yao et al., ReAct: Synergizing Reasoning and Acting in Language Models, arXiv, 2022, accessed: 2026-07-19.