P6-15.1 根据中间结果改变下一项工作的 Agent
Section ID:
P6-15.1Version:v2026.07.31
记录 AI agent 流程 时,要分开 goal、current_state、next_action、tool_result、observation、updated_plan。有了这份记录,单次回答生成和根据中间结果改变下一步行动的目标 流程 才能区分开。
在 P6-14.2 中,我们看到 function calling 会用结构化格式表示工具使用(tool use)。现在问题会变大。工具调用不是一次调用就结束,而是必须跨多个步骤继续时,这种工作流应该叫什么?
Agent 是一种工作结构。它接收一个目标,持续推进必要的子任务,并通过重复工具使用和观察(observation)来产生结果。
单次调用和目标流程的差异
理解 AI agent 时首先要收束的问题,是把跨多个步骤承载目标的执行结构和单个工具调用区分开。如果上一章的 tool use 问的是我们应该查询或执行一次什么,agent 问的则是如何按顺序连接多个工具调用和文档读取结果,以及什么时候停止或重试。
因此,把 agent 读成宽泛产品名并不安全。更稳妥的读法是:看到中间结果后,下一步行动会改变的目标流程。如果 P6-14.2 的 function calling 关注的是用可验证结构传递一个执行请求,那么 agent 关注的是多个调用和读取的顺序,以及状态管理。P6-15.2 会更具体地看这个循环如何在计划、行动和观察之间移动。
这里要留下的记录,是步骤计划、中间观察笔记和下一步。这些记录让我们之后能重新阅读为什么下一项行动发生了变化,以及流程层面的失败发生在哪里。下一节 P6-15.2 会更具体地看何时停止并交给人审查。
应该读成 agent 工作流的场景
这里要固定的区分,不是把 agent 背成新产品名称,而是区分使用了几个工具和看到中间结果后下一步行动发生变化。长回答不会自动变成 agent。反过来,即使输出很短,只要系统检查搜索结果后重新搜索、读取工具结果后选择不同工具,或失败后停止并交给人,结构就更接近 agent。
| 首先看到的场景 | 是否应先读成 agent? | 为什么这个区分重要 |
|---|---|---|
| 一次查询或执行几乎就能结束回答 | 通常不是 | 一个 tool use 或一个 RAG 步骤可能已经足够。 |
| 搜索词、工具或下一步会在中间结果后改变 | 是 | 选择下一项行动本身成为问题。 |
| 失败后必须决定重试、停止和交接标准 | 是 | 目标流程和状态管理比一个回答更重要。 |
带着这张表阅读下面的 agent 说明、状态和案例时,会更容易把 agent 理解成下一步选择不断变化的目标流程,而不只是使用很多工具的系统。
把读取和执行绑进目标顺序的结构
Prompt 设计输入。RAG 找到外部文档并把它们作为回答依据。Tool use 调用外部函数。Function calling 把这个调用整理成名称和参数结构。
Agent 中新变得重要的,是把这些要素放进一个目标流程。和一次工具调用不同,下一项行动会在中间结果后改变,中心会从一个回答移动到以目标为中心的工作流。所以读 agent 时,我们应该先问看到当前状态后,系统选择接下来做什么,而不是它执行了一次什么。
例如,如果一个目标继续经过这样的流程:
- 查找信息
- 选择需要的工具
- 读取中间结果
- 改变下一项行动
- 失败后重试
- 总结最终结果
那么它就比简单的一次性请求更接近 AI agent 结构。
换句话说,agent 的中心更接近朝向目标的工作流,而不是一次回应。
聊天界面和工作协调结构的差异
Agent 常被粗略理解成更聪明的聊天机器人。但更稳妥的解释是:
Agent 可以有对话界面,但核心不是对话本身。它的核心是为了目标推进工作步骤的执行结构。
例如,agent 可以:
- 重新拆分问题
- 搜索文档
- 读取文件
- 运行测试
- 看到失败原因后再次尝试
这种流程更接近工作协调结构,而不是简单的一次性回答。
Prompt、RAG、tool use 和 AI agent 的层位
| 结构 | 先处理什么 | 立即需要的判断 | 结果如何结束 |
|---|---|---|---|
| Prompt | 用户输入和指令 | 应该怎样提问? | 一个模型回应 |
| RAG | 文档和依据 | 应该附上哪些文档? | 带依据的回答 |
| Tool use | 外部函数 | 应该调用哪个函数? | 查询值、计算值、执行结果 |
| Function calling | 工具调用格式 | 应该传递哪个名称和哪些参数? | 可验证调用请求 |
| Agent | 多步骤状态 | 下一步该做什么,何时停止? | 朝目标继续的工作流 |
这张表的重点是,agent 不只是附加了更多工具的版本。它把选择下一步变成中心问题。因此,解释 agent 不是列出更多函数,而是把前面的读取和执行组件重新组织成基于目标的顺序。
第 12 章到第 14 章的最小差异可以再固定如下。
| 当前层位 | 核心问题 | 接下来引向什么 |
|---|---|---|
| Tool use | 实际应该查询或执行什么? | 什么名称和参数结构承载执行请求? |
| Function calling | 怎样让这个执行请求可验证? | 多个调用应该按什么目标顺序继续? |
| Agent | 多次读取和执行如何作为目标流程继续? | 什么共享连接格式和执行记录承载这个流程? |
| MCP / harness | 连接应如何暴露,执行应如何记录? | 记录应如何用于评估和运行? |
如果没有状态,下一项行动也会摇晃
要继续多步骤工作,系统必须知道中间状态。
例如:
- 哪些文档已经读过
- 哪些工具调用成功了
- 发生了什么错误
- 接下来应该做什么
没有这些信息,agent 每一步都可能丢失语境,并重复同样的错误。
所以 agent 更接近带状态的执行,而不是简单输出生成。
因此,agent 说明必须把当前步骤、上一轮结果和剩余目标一起看,才能回答为什么。
实际请求什么时候超出一个回答
要区分的重点是,返回一个说明和把多个工作步骤推进到完成不是同一个问题。因此,需要 agent 的场景通常会通过这个问题显露出来:看到中间结果后,是否必须重新选择下一项行动?
- 超出简单说明
- 收集真实材料
- 使用工具
- 重新组织结果
- 把工作推进到最后
换句话说,当请求不能用一个回答结束,并开始沿着读取 -> 执行 -> 检查 -> 选择下一项行动继续时,把这个场景读成 AI agent 结构会比读成单次回应更准确。
示例包括:
- 开发辅助
- 研究辅助
- 文档处理自动化
- 客服工作流
这些都是 AI agent 结构比较突出的地方。
目标流程增加的运行复杂度
这一点也必须包含。
拥有 agent 并不会自动解决:
- 总是制定正确计划
- 避免无限循环
- 阻止所有错误工具调用
- 优化成本和延迟
所以要持续检查的结果不只是它能不能跨多个步骤继续,还要看结构是否显示哪里应该停止、重新计划、交给人。
随着步骤增加:
- 失败点增加
- 需要更多日志
- 批准和权限管理变得重要
- 评估和可复现性可能变得更难
换句话说,agent 扩展能力,同时也显著增加运行复杂度。
从目标到观察的基本流程
flowchart TD
  A["目标"]
  B["选择下一步"]
  C["使用文档或工具"]
  D["观察结果"]
  E["继续或停止"]

  A --> B
  B --> C
  C --> D
  D --> E
这张图的重点是,agent 不是一次性以问题 -> 回答结束的结构,而是目标 -> 步骤选择 -> 行动 -> 观察的重复结构。
中间观察改变行为的案例
案例 1. 编码 agent
如果用户要求修复登录错误,人们可能期待一次原因说明或一段修复代码。但真实的编码 AI agent 会找到相关文件,读取错误位置,应用补丁,再次运行测试。
例如,如果第一次修复后测试暴露出另一个认证异常,agent 不应该在那里停止。它必须继续到下一项修复。就像人会检查中间结果一样,agent 也会在看到测试失败或新错误消息后改变下一项行动。如果忽略这个观察,它可能减少了原始错误,却在留下另一个回归的情况下结束。
判断标准从是否产出一个修复,变成看到测试结果后是否改变下一项行动。这种结构被称为 agent,是因为它不是一个回答,而是读取-修复-运行-复查的工作流。这个案例中要检查的结果,不是是否产生了一次代码修改,而是看到测试结果后下一项行动是否真的改变。
| 步骤 | 中间观察 | 接下来实际必须改变什么 |
|---|---|---|
| 读取文件 | 找到认证逻辑的位置 | 先修复哪一部分 |
| 应用补丁 | 代码修改完成 | 运行哪项测试 |
| 运行测试 | 新错误、回归、失败日志 | 下一次补丁方向和复查顺序 |
案例 2. 文档研究 AI agent
如果用户要求带依据总结最新退款政策,看起来一次搜索就能立刻结束回答。但文档研究 AI agent 会像人工研究一样查找相关公告和政策文档,检查文档日期和依据层级;如果依据不足,就会改变搜索词或阅读其他来源。
如果第一条搜索结果是去年的公告,agent 不应该立刻总结它。它应该重新搜索最新修订文档。相反,如果找到了最新公告,但详细条件在另一个政策 PDF 中,agent 也许还需要打开那个 PDF 并补强依据。否则,回答看起来有引用,实际上却可能附上过期依据或漏掉关键条件。
判断标准从是否出现一个搜索结果,变成是否一边检查日期和依据层级,一边重新探索。搜索、阅读、总结、来源整理和重新探索在一个目标下继续,所以这种结构比简单搜索工具更接近 agent。这个案例中要检查的结果,是 agent 是否检查日期和依据层级并一直找到最新文档,而不是立刻总结第一条结果。
| 步骤 | 中间观察 | 接下来实际必须改变什么 |
|---|---|---|
| 第一次搜索 | 去年公告,来源不足 | 搜索词和日期过滤 |
| 阅读文档 | 缺少详细条件 | 追加 PDF 或原始政策文本 |
| 摘要前检查 | 有来源,但时效性不确定 | 是否重新探索并补强引用依据 |
案例 3. 业务自动化 agent
用户可能要求找出今天收到的紧急咨询,并查看负责人的日历。即使这个请求被表达成一句话,实际系统也必须继续经过邮箱查询、紧急度分类、负责人搜索、日历检查和结果记录。
如果三个项目被分类为紧急咨询,系统可能需要为每个负责人查询不同日历;如果日程冲突,还可能需要重新设置优先级。每一步都是单独的工具调用,但核心是把这些调用连接成一个业务目标,并根据中间结果改变下一步顺序。
如果系统不看中间结果,只按最初固定顺序推进,它可能先处理低紧急度项目,或漏掉负责人日程冲突。判断标准从是否按顺序调用工具,变成实际顺序和优先级是否根据中间结果改变。这个案例中要检查的结果,是工作流是否根据中间结果改变实际工作顺序和优先级,而不只是列出工具调用。
扩展成工作结构,案例可以这样读。
| 情况 | 起始目标 | 中间会改变什么 | 为什么应读成 agent |
|---|---|---|---|
| 编码辅助 | 修复错误 | 根据测试日志改变下一次补丁方向 | 需要重试循环,而不是一个代码建议 |
| 文档研究 | 整理最新依据 | 搜索词、日期过滤、阅读优先级 | 如果在第一次搜索结束,旧依据可能残留 |
| 业务自动化 | 处理紧急咨询 | 优先级、负责人、日程冲突处理 | 多个系统的结果出现后,顺序必须持续变化 |
根据观察改变,而不是根据工具数量判断
第一次读 agent 时最容易漏掉的是,因为它使用几个工具就把系统称为 agent。但核心不是工具数量。核心是看到中间结果后,下一项行动是否真的改变。
第一个问题很简单。如果某个东西看起来像搜索后结束的一次性回答,检查中间结果后是否真的出现了下一次选择。如果使用了多个工具,但顺序总是固定的,检查顺序或下一阶段是否会根据观察改变。失败发生时,检查系统是继续推进同一顺序,还是改成重新搜索或重试等不同动作。
首先要学会的标准不是这是不是一个有很多工具的系统,而是中间观察是否改变下一项行动选择。P6-15.2 会连同计划-行动-观察循环一起,更仔细地看停止和人工审查的详细标准。
再把它看成工作流结构,同一个想法可以这样读。
flowchart LR
  A["目标"]
  B["当前状态"]
  C["选择下一步"]
  D["用文档或工具行动"]
  E["观察结果"]
  F["更新状态"]

  A --> B --> C --> D --> E --> F
  F --> C
关键不是一个回答,而是更新状态并重新选择下一项行动的重复。
比较模型建议和 guard 最终行动
这个示例的目标不是实现完整 agent 框架。这里检查的是,当观察结果不同时,下一项行动也应该不同。编码辅助、文档研究和业务自动化是不同任务,但从 agent 视角看,都可以重新读成从当前状态选择下一项行动的问题。没有相关语境、只有过期语境、依据不足、执行失败、需要人工审查、来源已经附上,这些状态分别需要不同的下一项行动。
下面的示例使用观察状态 CSV p6-14-1-agent-observation-states-zh.csv。一行表示 agent 在编码辅助、文档研究、业务自动化等任务中间看到的当前状态。CSV 的 observation_zh 是显示给读者的中文观察说明,model_observation_en 是传给模型的英文观察句,found_context、current_context、detail_missing、conflict_found、action_failed、approval_needed、sources_attached 是应用检查模型建议时使用的状态信号。
代码中要检查的重点是,模型读取观察句并提出下一项行动,但应用不会原样信任这个建议。它会用状态信号再次检查建议。运行代码前,需要安装 Ollama 并拉取模型。例如运行 ollama pull qwen2.5:1.5b,然后在 Ollama 运行时执行代码。若要使用其他模型,可以把环境变量改成 AIBOOK_OLLAMA_MODEL=model-name 这样的值。传给模型的 prompt 和观察句保持英文。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 | |
示例输出可以这样读。
首先要注意,模型为所有观察状态都提出了下一项行动。但 guard_changed_model_action_count 也是 10。例如在 verified_patch_with_notes 中,模型提出了 attach_sources,但状态信号已经显示 sources_attached,所以 guard 把它关闭为 finish。换句话说,agent 流程需要的不只是模型建议本身,而是把模型建议、当前状态、最终下一项行动一起记录的结构。
同样,像 old_error_log 或 stale_policy_notice 这样依据不是最新时,agent 必须重新搜索或重新读取。像 new_test_failure 或 calendar_api_failed 这样执行本身失败时,不应该继续推进同一个顺序,而应该换一个步骤重试。像 security_sensitive_change 或 manager_approval_required 这样出现权限或批准边界时,agent 不应该独自继续,而应该交给人工审查。
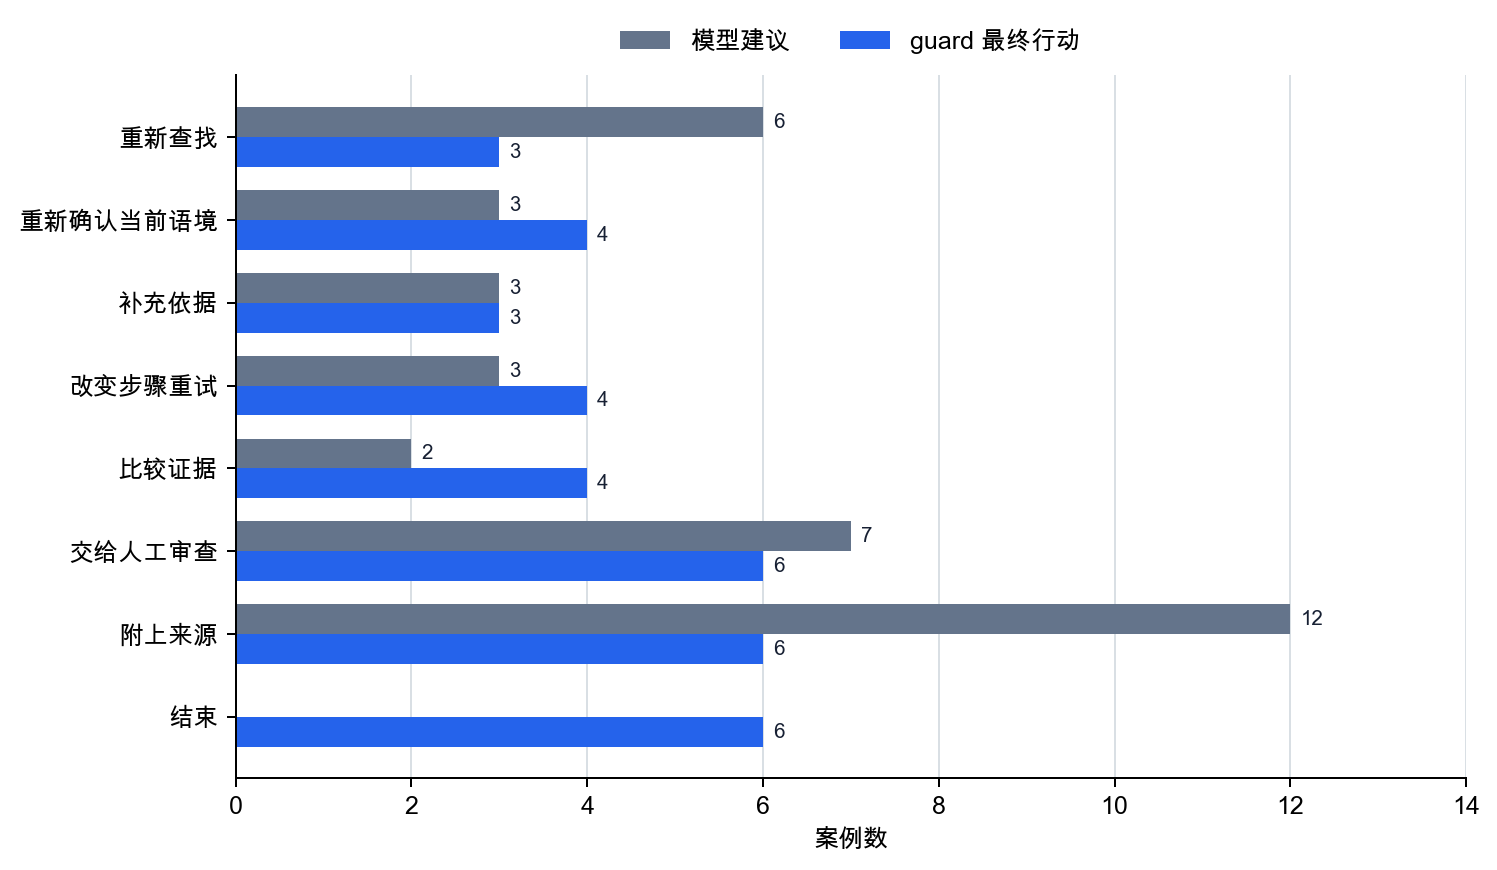
这张图显示模型建议和 guard 最终行动之间的差异。模型相对频繁地提出 attach_sources,但 guard 会再次检查状态信号,并把已经附上证据的案例关闭为 finish。相反,当出现权限、失败或冲突信号时,guard 可以把最终行动固定为人工审查、重试或证据比较,而不完全跟随模型建议。
因此,从这张图中要读出的结论并不是简单地说模型错了。它显示的是,在 agent 流程中,模型提出下一项行动候选,应用再用当前状态和记录标准把这个候选缩窄。
这个示例中要确认的结果有两个。
- 模型会读取观察句并提出下一项行动,但这个建议必须和状态信号一起再次检查。
- Agent 的核心不是使用很多工具,而是记录
从当前状态重新选择下一项行动的目标流程。
读者可以在示例中直接尝试这些调整。
- 在 CSV 中把
current_context改成false,观察出现过期依据时下一项行动如何变化。 - 把
action_failed改成true,确认它是否变成重试,而不是继续同一顺序。 - 把
approval_needed改成true,观察 agent 是否移动到人工审查,而不是继续推进。 - 把
sources_attached改成true,观察不再需要更多工作的案例是否关闭为finish。 - 改变
AIBOOK_OLLAMA_MODEL,观察模型建议和 guard 修正之间的差异如何变化。
这里还需要再分开一层。Agent 直接试图解决的是下一项行动选择和顺序调整。但每个调用如何表达、权限边界如何记录、执行 trace 如何留下,仍然是另一个层位的问题。调用格式验证已经在 P6-14.2 中处理,共享连接规则会接到 P6-16.1,执行记录和可复现性会在 P6-16.2 中更具体化。
观察信号产生的下一项行动
前面的示例不是实现完整 agent 的代码,而是一个小的检查场景,用来显示中间观察如何分出下一项行动。这里要读的不是步骤数量。即使目标相同,当前状态不同,下一项行动也必须不同。没有相关语境、过期语境、详细依据不足、执行失败、权限边界、来源已经附上分别要求不同的下一项行动。
这个示例中要读出的核心如下。
- 即使目标只有一个,当前状态也可以分裂成多种形式。
- 状态改变时,下一项行动也必须改变。
- 选择和理由必须被记录,之后才能重新检查 agent 流程。
为什么要把多个调用读成目标流程
Agent 的核心不是使用很多工具,而是把目标分成多个步骤,并在观察当前状态时持续重新选择下一项行动的执行流程。
更重要的是,一次回答得好和一边看中间结果一边继续工作不是同一个问题。因此,agent 最好读成一种观察多步骤状态并重新选择下一项行动的执行流程,而不是附加了更多工具的版本。
这个执行流程重要,是因为:
- 它把前面的 P6-14.1 tool use 和 P6-14.2 function calling 放进
连接多个步骤的执行结构,而不只是一次调用。 - 它为理解 P6-15.2 的 plan、action、observation loop 做准备。
- 它显示为什么需要一起看 P6-16.1 MCP、P6-16.2 harness 和 P6-17.1 evaluation。
检查清单
- 你应该能够把 agent 说明成
把多次读取和执行连接成目标流程的工作结构,而不是更聪明的聊天机器人。 - 如果 RAG、tool use、function calling 分别是读取、执行、结构化,你应该能够说出 agent 是以
选择下一步为中心的更高层流程。 - 你应该知道,agent 流程会在计划、行动、观察的重复循环中变得更具体。
参考资料
- Shunyu Yao et al., ReAct: Synergizing Reasoning and Acting in Language Models, arXiv, 2022, accessed 2026-07-19.
- OpenAI, Agents SDK, OpenAI API Docs, accessed 2026-07-19.
- OpenAI, Using tools, OpenAI API Docs, accessed 2026-07-19.