P6-16.1 用共享格式连接工具和资源的 MCP
Section ID:
P6-16.1Version:v2026.07.31
阅读 MCP 时,要分开 resource、tool、prompt、server_boundary、permission_scope、client_runtime。这个区分可以防止协议、工具、执行环境和权限被合并成一个内部功能。
在 P6-15.2 中,我们看到 agent 具有计划、行动、观察的重复结构。现在需要看的是,要让这些工具和状态跨多个系统更一致地连接,需要什么。
MCP,也就是 Model Context Protocol,是一种接口视角,帮助模型、AI agent 和应用更一致地连接外部工具和数据。换句话说,它更接近一种约定:不要把每个工具和数据源都单独临时接上,而是用更规则的方式连接多个工具和数据源。
工具和资源的共享连接格式
首先要收束的问题是:用什么共享格式连接工具和资源。包裹执行的运行装置关注的是如何记录和复现使用连接的执行,而认证和权限碰到真实失败处理的地方,仍然属于运行控制问题。
这里把 MCP 读成让工具连接不那么临时拼接的标准化视角。
如果 AI agent loop 问的是多次读取和执行应该通过什么重复结构继续,MCP 视角问的是这个 loop 使用的工具和资源应如何以共享格式暴露,才让后续执行和记录更少摇晃。这里把 Model Context Protocol (MCP) 读成一种共享连接接口,它把模型能力和工具连接格式分开。执行记录和复现环境会在 P6-16.2 的 harness 中单独处理。
这里首先要固定的是:哪些工具和资源以什么共享格式暴露,以及连接接口是否规则。
| MCP 中先要整理的连接信息 | 为什么需要 | 后续检查 |
|---|---|---|
| 工具说明和资源说明 | 暴露哪些工具和资源可用、名称是什么、输入格式是什么,可以减少调用失败和连接不匹配。 | 接到 P6-16.2 的 trace/replay 和工具连接记录 |
| 权限边界和批准条件 | 显示哪些调用可以立即运行、哪些需要批准,可以减少运行失败。 | 接到 P6-16.2 的批准记录和 P6-18.2 的失败处理 |
共享格式这个说法可能仍然抽象。此时不要先背协议名,更安全的做法是想象:在处理同一目标时,如果每个工具都有不同输入格式,最先坏掉的是什么。
假设一个 agent 必须同时使用下面三项。
- 搜索工具:
query,top_k - 文件读取工具:
path - 日程查询工具:
date,room_id
如果这三项只通过完全不同的规则连接,agent 在问应该传什么信息之前,还要先担心这次应该用什么形状调用这个工具。把搜索结果交给读取步骤时,需要路径。移动到日程查询时,又需要日期和会议室 ID 格式。中间转换和异常处理会快速增加。
有了共享连接视角,agent 可以先用规则化方式检查哪些可搜索工具、可读取资源、可查询工具以什么名称和输入格式暴露。换句话说,MCP 不改变每个工具的目的。它更适合读成一个让能传给下一步的东西更可预测的层。
同一场景可以缩短成这样。
| 同一目标流程中最先摇晃的东西 | 共享连接视角弱时 | 有共享连接视角时 |
|---|---|---|
| 选择哪个工具 | 工具说明位置和命名体系不同,连选择都会混乱。 | 更容易用同一种方式检查已暴露工具和资源。 |
| 传什么给下一步 | 搜索结果、路径、查询参数每次都要转换成不同格式。 | 更容易匹配下一步期望的输入格式。 |
| 到哪里找失败原因 | 容易把模型判断问题和连接格式问题混在一起。 | 更容易把连接规则和执行判断分开。 |
区分模型能力和工具连接规则
只有一两个工具时,每个连接可以直接构建。但 AI agent 结构变大后,工具数量增加,连接方式很容易变得不一致。MCP 这样的连接视角,是试图让工具说明、请求格式和响应格式更规则,使周围连接环境比模型本身更不混乱。
从服务结构看,tool use 接近调用工具,而 MCP 处理的是这些工具应该如何以共享格式暴露这个阶段。模型理解和生成文本的能力,与外部工具的暴露名称、输入格式、返回格式,是不同层位。先有这个区分,我们才能分清原因是模型限制,还是工具暴露与连接设计问题。
模型的中心是读取给定输入,并选择下一个需要的词或行动候选。MCP 这样的连接视角则关注如何访问模型外部的工具和数据,例如文件、搜索、数据库和 API。因此,MCP 更接近如何连接模型周围执行环境的问题,而不是模型内部能力。
例如,当 AI agent 结构变大时,一个任务内会需要多种工具。
- 一个工具读取文件。
- 一个工具搜索。
- 一个工具查询数据库。
- 一个工具调用 API。
如果这些连接全是临时拼接,系统会越来越难处理。工具增加时,如果不规则化模型可用的东西和应使用的格式,失败原因会按工具分散。
MCP 首先让三件事更容易:以规则方式暴露工具列表,更一致地保持请求和响应结构,以及在多个系统改变时复用连接视角。换句话说,MCP 更接近连接整理工具,而不是新能力生成器。
放回同一个请求流程中看,prompt 写请求,RAG 接上要读的文档,tool use 调用要执行的函数。Agent 持续多个步骤,MCP 帮助这些连接以更规则的格式被处理。这个顺序把 MCP 和模型性能、harness 记录环境分开。
本节需要学习的不是背下 MCP 的每个实现细节。入门水平上,只要能说明 MCP,区分模型能力和连接接口,并说出为什么 AI agent 和 tool use 增大后连接标准变重要,就足够了。接下来再进入 P6-16.2 中 connected execution 如何交给 harness 记录环境。
最先要分开的场景可以整理如下。
| 首先看到的阻塞 | 先问的问题 | 为什么这个问题要先问 |
|---|---|---|
| 处理同一目标的工具名称和输入格式差异太大,调用前流程就摇晃 | 哪些工具和资源以哪些名称和输入格式暴露? | 如果连接格式临时拼接,格式转换和异常处理会在模型判断之前增长。 |
| 调用成功,但返回形状不同,下一步总是坏掉 | 响应格式是否也能读成共享规则? | 即使输入匹配,临时的输出结构也会让下一步连接再次不稳定。 |
| 工具增加了,但先用哪个工具的说明不一致 | 工具说明和资源说明能否用同一种方式检查? | 如果选择标准分散,同一目标流程会从工具选择开始摇晃。 |
| 需要权限的调用和可立即运行的调用混在一起 | 权限边界和批准条件在连接说明中是否可见? | 如果批准问题出现得太晚,连接成功和运行失败会混成同一种错误。 |
带着这张表阅读后文,更容易把 MCP 直接读成让工具和资源连接不那么临时拼接的共享格式,而不是只读成协议名称。
flowchart LR
  A["用户任务"]
  B["agent 选择工具"]
  C["共享连接规则"]
  D["工具或资源"]

  A --> B
  B --> C
  C --> D
这张图的重点是,agent 通过共享连接规则看工具和资源,而不是为每个工具记住不同的私有规则。
如果先从角色而不是技术细节理解 MCP,连接问题更容易分开。MCP 首先试图标准化的是有哪些工具、哪些数据或资源可以读取、请求和响应以什么格式发生。因此,MCP 更准确的读法不是让模型更聪明的方法,而是让模型和外部系统更少混乱地连接的方法。
多工具流程中可见的差异
flowchart TD
  A["模型或 agent"]
  B["共享连接接口"]
  C["工具和数据源"]

  A --> B
  B --> C
这张图的核心,是把 MCP 读成模型和工具之间的连接层。
同样内容可以再从连接拥塞视角比较。
| 状态 | 模型或 agent 必须知道什么 | 常见运行问题 |
|---|---|---|
| MCP 这样的共享连接视角较弱时 | 每个工具都有不同名称、参数格式、返回格式 | 格式不匹配、异常处理增加、新工具追加成本上升 |
| MCP 这样的共享连接视角存在时 | 工具列表和资源信息以共享方式暴露 | 更容易把权限、质量、评估问题和连接本身分开。 |
MCP 不会自动解决工具质量、权限问题、错误调用或评估。整理连接格式和提高真实运行质量是不同问题。所以 MCP 更适合读成一种连接整理视角,帮助 prompt、RAG、tool use、AI agent 流程以更规则格式处理不断增长的连接,而不是新能力生成器。
案例和示例
这些案例的焦点不是工具是什么,而是连接规则最先在哪里摇晃。
案例 1. 同时使用文档读取和搜索的 agent
想象一个 agent 查找内部政策文档并据此回答。因为文件读取和文档搜索都是看文档,很容易觉得二者可以相似连接。但这个 agent 有时需要直接打开文件,有时需要先搜索相关文档。例如,已知准确文件路径和只知道关键词、需要先找候选文档时,做法不同。
如果文件读取工具和搜索工具使用不同调用规则和结果格式,agent 在作答前必须分别学习应该怎样访问这个东西。如果连接混乱,回答前的准备步骤可能选择错误工具:本应先搜索的文档被直接读取,或者已知路径的文件被无意义地搜索。
判断标准从两者是否都在看文档,变成可读取资源和可搜索资源是否能被区分,并以同一格式处理。MCP 这样的连接层会以更规则格式暴露这些资源,让什么可以读取和什么可以搜索更容易用同一方式处理。这个案例中要检查的结果,是工具选择是否更一致:带路径的文件直接读取,没有路径的问题先搜索。
| 起始状态 | 应该先用什么 | 连接规则摇晃时的问题 |
|---|---|---|
| 已知准确文件路径 | read-resource 调用 | 不必要地先搜索,使回应变长或探索无关候选。 |
| 只知道主题,不知道路径 | search-resource 调用 | 把错误路径传给读取工具并立即失败。 |
| 必须从搜索结果选择候选 | 搜索结果和可读取资源之间的连接 | 搜索结果传给下一步读取的格式不一致,流程中断。 |
案例 2. 编码 agent
假设一个编码 agent 搜索代码库、读取文件、运行测试并应用补丁。很容易以为分别接上一个搜索工具和一个执行工具就足够。但如果每个工具都直接单独接上,输入格式和返回格式不同,每一步都容易增加单独异常处理。例如,搜索结果可能是文件列表,测试运行器需要目录路径,补丁工具又可能需要另一种格式。
在这种情况下,把工具彼此连接起来可能比实际修代码更费力。如果这种连接不稳定,补丁本身可能是对的,但验证会因为格式不匹配停在测试运行阶段。判断标准从是否接上了每个工具,变成工具输入和返回格式是否能可预测地连接。有了连接标准视角,agent 可以用更可预测的方式处理可搜索工具、可读取资源和可执行工具。这个案例中要检查的结果,是在补丁内容本身之前,原本因输入格式不匹配而停止的阶段是否减少,搜索结果到测试执行的连接是否更稳定。
| 阶段连接 | 即使每个工具单独成功也可能出现的问题 | 共享连接视角的好处 |
|---|---|---|
| 搜索结果 -> 文件读取 | 读取资源不能直接接收文件候选列表,需要额外转换。 | 更容易预测哪个项目是可读取资源。 |
| 文件读取 -> 补丁应用 | 位置信息和补丁目标格式不同,中间处理增加。 | 更容易规则化作为补丁目标传递的最小信息结构。 |
| 补丁应用 -> 测试执行 | 基于文件的结果不能直接用于目录/命令型运行器。 | 可执行工具能通过共享方法调用,减少下一步不稳定。 |
案例 3. 连接组织内部系统
想象一个助手在组织内部使用文档库、工作数据库和日历 API。只要需要的数据存在,人们很容易觉得连接本身不是大问题。但这些系统手动接上时,访问方式会不同:文档使用搜索查询,数据库使用类似 SQL 的查询,日历使用单独 API 参数。例如,同样是检查今天日程,也可能需要先在数据库中找人员信息,再通过日历 API 查询日程,然后再从文档库读取相关指南。
这里的问题不是没有数据,而是每个数据源的访问规则非常不同。如果访问规则临时拼接,把一个系统调用的值传给下一个调用时,格式错误或遗漏很容易发生。判断标准从需要的数据是否存在,变成不同系统的访问规则是否能以规则格式处理。MCP 这样的连接层以模型友好的方式暴露这些系统,让 agent 能访问哪些资源、以什么格式访问更加规则。这个案例中要检查的结果,是人员查询、日程查询和指南文档读取是否能作为一个工作流更稳定地继续,而不是频繁因规则不同而断开。
三个案例可以从连接稳定性视角重新分组。
| 情况 | 没有共享连接视角时最先摇晃什么 | 有共享连接视角时首先稳定什么 |
|---|---|---|
| 文档读取 + 搜索 | 选择可读取资源和可搜索资源的规则 | 区分哪些资源被读取,哪些资源被搜索 |
| 编码 agent | 工具专用输入和返回格式连接 | 从搜索到执行的格式可预测性 |
| 内部系统连接 | 每个系统不同的访问规则 | 人员信息、日程、文档查询的连接流程 |
应先检查连接规则的场景
第一次读 MCP 时常见的误解,是把工具连接不好立刻当成模型能力不足。但首先应该检查的不是模型多聪明,而是工具和资源以什么共享格式暴露。前面的标准可以转成这些实践问题。
| 如果你怀疑这一点 | 先问的问题 |
|---|---|
工具存在,为什么连接总是摇晃? | 工具说明和请求格式是否通过共享规则暴露? |
搜索后读取步骤总是坏掉。 | 可读取资源和搜索结果能否通过同一连接视角传递? |
调用能工作,但下一步又需要单独处理。 | 返回值是否也是下一步可以直接读取的共享格式? |
为什么添加一个工具这么贵? | 新工具是否容易放进同一个接口? |
首先要学会的标准很简单。MCP 不是让模型更聪明的功能。它是一种共享接口视角,通过让工具说明、资源访问、请求/响应格式不那么临时拼接,减少连接不稳定。
练习和示例
这个示例的目标不是实现整个协议,而是看看 MCP server 如何通过官方 Python SDK 暴露工具和资源。这个示例需要 Python 3.10 或更高版本以及 mcp Python SDK。如果尚未安装,可以用 pip install "mcp[cli]>=1.27,<2" 安装稳定版本线,然后运行代码。
代码中先看两件事。用 @mcp.tool() 注册的函数会暴露为可执行工具,用 @mcp.resource("policy://refund/latest") 注册的函数会暴露为可读取资源。换句话说,agent 不是随意直接认识外部系统。它把服务器暴露的工具名称、输入格式和资源 URI 看成连接目标。
示例输出可以这样读。
在这个输出中,search_policy(query: str) 是可执行工具,policy://refund/latest 是可读取资源。重要的不是函数内部计算,而是工具名称、输入格式、资源 URI 被注册在服务器上。真实 MCP client 会基于服务器暴露的信息发现并调用工具和资源。MCP 整理的不是很好地总结退款政策的能力,而是查找退款政策的工具和读取退款政策的资源如何以共享格式暴露。
把同一原则扩展到多个请求,连接格式的差异会更清楚。下面的图不是为了解释 SDK 使用方法,而是一个辅助实验,用来比较工具/资源暴露格式一致时和摇晃时会发生什么。使用工具目录 CSV p6-15-1-mcp-tool-catalog-zh.csv、资源目录 CSV p6-15-1-mcp-resource-catalog-zh.csv、请求 CSV p6-15-1-mcp-connection-requests-zh.csv,把 36 个请求分别流过共享连接层(common_layer)和临时连接层(mixed_layer)。比较结果会显示请求完成、连接准备、工具解释、资源解释在哪里分裂。
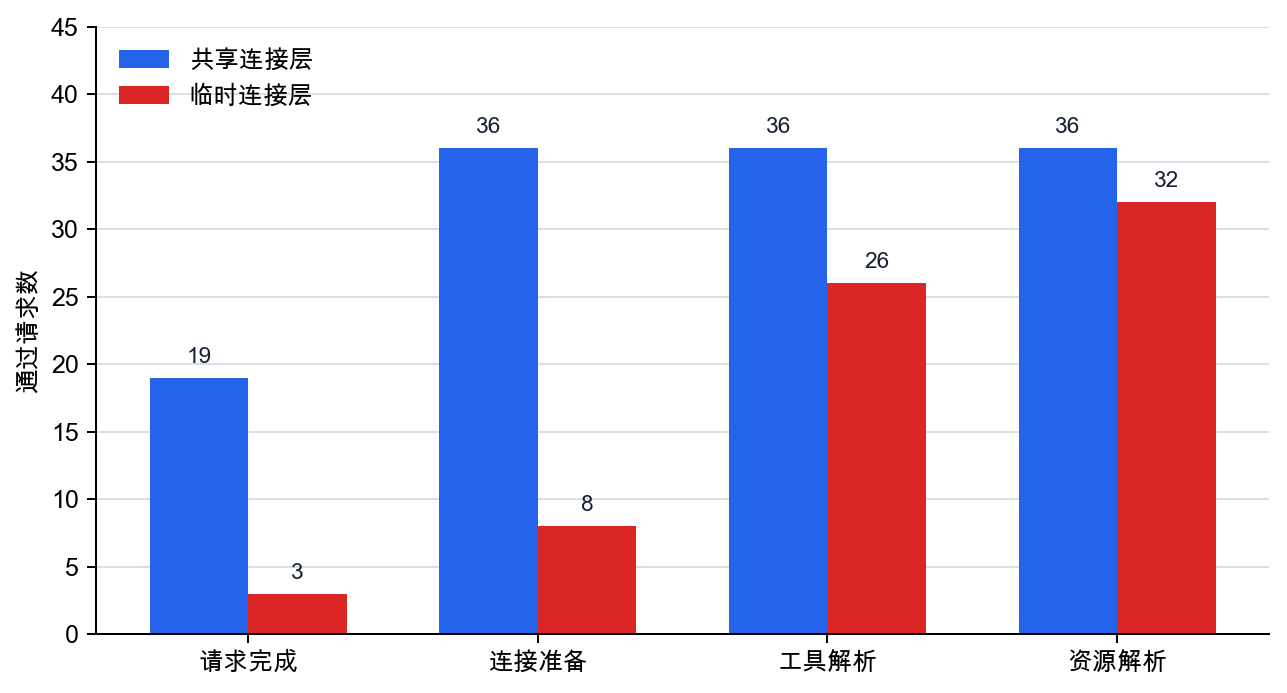
这张图把共享连接层和临时连接层之间的差异拆成请求完成、连接准备、工具解释、资源解释。即使在共享连接层中,因为批准和缺失输入,请求完成也停在 19 个案例,但连接准备通过了全部 36 个案例。相反,临时连接层即使能在一定程度上找到工具和资源,输入格式和资源类型仍然摇晃,所以连接准备和请求完成都会明显下降。
这张图中要检查的结果是,模型或 agent 不是逐个直接处理外部系统。它们通过一个用共享接口暴露工具和资源的连接层访问外部系统。
读者可以在本节中尝试这些调整。
- 在 SDK 示例中用包含
security的问题调用search_policy(),观察是否返回不同的 resource URI。 - 给 SDK 示例再添加一个
@mcp.tool()工具,观察工具名称和输入格式如何出现在输出说明中。 - 在 CSV 辅助实验中,只给
mixed_layer的一个工具添加input_schema,检查为什么整体一致性仍然会破坏。
再进一步,需要区分 MCP 直接整理的东西,以及仍然要交给 harness 或运行层的东西。
| 情况 | MCP 直接整理什么 | 单靠 MCP 之外还剩什么 |
|---|---|---|
| 工具名称和输入格式临时拼接 | 暴露共享名称、输入格式和资源类型 | 执行 trace 存储、replay、评估记录 |
| 资源访问因系统而不同 | 在同一连接层暴露可读取资源和可执行工具 | 判断哪次执行实际安全 |
| 添加新工具时连接经常坏掉 | 通过保持连接格式规则来降低追加成本 | 批准门、失败恢复、成本控制 |
| 不清楚问题是模型性能还是连接设计 | 分离连接解释失败和模型内部性能问题 | 连接成功后如何管理质量和运行 |
这张表的重点是,MCP 是让连接规则化的层,不是记录执行或判断质量的层。Harness 会把同一连接留下执行 trace 和 replay,而 evaluation 和 operations 会把这个记录读成质量判断和控制行动。
连接格式比工具数量更重要
这个压缩后的连接结构显示,在工具很多的时代,比工具数量更重要的是如何用同一种方式连接它们。MCP 视角不是附加更多工具的技术,而是让已附加工具能用同一种方式被阅读和调用的连接规则。更重要的是,模型说什么和模型连接到哪些系统、用什么格式连接不是同一个问题。
检查清单
- 你应该能够把 MCP 说明成
以共享格式暴露工具和资源的连接接口视角,而不是新的模型能力。 - 你应该能够说出模型问题和连接问题应拆成不同层位。
- 你应该知道,已连接执行会继续进入由什么记录和复现环境管理的问题。
参考资料
- Model Context Protocol, What is the Model Context Protocol (MCP)?, accessed 2026-07-19.
- OpenAI, MCP and Connectors, OpenAI API Docs, accessed 2026-07-19.
- OpenAI, Using tools, OpenAI API Docs, accessed 2026-07-19.