跳转至

P6-16.2 包裹执行记录和可复现环境的 Harness

Section ID: P6-16.2 Version: v2026.07.31

harness 记录要分为 input_snapshot、tool_call_log、environment_state、approval_state、output_snapshot、replay_note。这样就不是只看最终回答,而能再次确认同一次执行为什么按那样的 流程 进行。

在 P6-16.1 中,我们看到 MCP 是一种让模型、外部工具和数据之间的连接更一致的接口视角。但即使连接格式已经整理好,如果执行流程没有留下记录,之后仍然很难再次解释失败原因或改进效果。现在要看的,是包裹 AI agent 执行、留下日志和评估输入,并让流程能够再次运行的结构。

Harness 接近一种执行环境或运行装置。它包裹 agent 或模型运行,并管理输入、工具调用、结果、日志、评估输入和复现信息。

包裹执行记录的结构

首先要收束的问题是,应该用什么形式保存 trace、replay information 和 approval records。质量检查是把留下的记录读成通过标准的问题,而运行约束和失败处理则是把这个判断移动到真实服务控制中的问题。

这里不要把 harness 读成某个单一产品名,而要读成控制、记录并评估执行的包裹结构。

如果前面的章节在创建连接和执行结构,那么 harness 解释的是为什么执行留下的 trace、log、replay information 和 approval record 会成为评估标准的输入。好的执行记录不是运行附录。它支撑的是应该用什么标准判断这个结果可接受这个问题。

Harness 固定三个轴。第一,什么应该作为 trace 和 replay information 留下?第二,为什么这个记录会成为评估输入?第三,MCP 和 harness 在连接和执行管理中各自处理什么?核心视角会从连接是否做好了,变成能否再次解释和比较使用该连接的执行。

MCP、harness、evaluation、operations 的最小差异可以固定如下。

当前层位 核心问题 接下来引向什么
MCP 应该连接什么,并用什么共享格式? 使用该连接的执行应留下什么 trace 和 replay 信息?
Harness 执行应如何被包裹和记录? 留下的记录应按什么质量标准读取?
Evaluation 哪些执行可以判为可接受? 通过的执行应如何通过成本、延迟、失败控制来运行?
Operations 哪些失败应在哪里停止,如何恢复? 这个判断应如何留在请求流程和运行记录中?

区分执行输出和可复现记录

与其把 harness 背成工具名,更安全的做法是问:如果某条记录缺失,哪种失败就无法再次缩小原因。这个视角建立后,harness 就能被读成一种运行装置,它通过 trace、log、eval、replay 等记录,让由 MCP 连接的工具执行再次变得可解释,而不只是简单日志存储。

首先看到的阻塞 先保留的记录 为什么这条记录要先保留
失败可见,但错误起点无法解释 Trace 没有执行路径,知识问题和执行问题就无法分开。
回答错误,但不清楚问题在搜索还是批准 读取文档、工具调用、批准记录 不同运行失败不应混成同一种质量问题。
无法比较某个修复是否真的改善流程 Replay 信息和执行设置 同一流程能再次运行之前,改进不能被信任。

带着这张表阅读 harness 的角色、它和 MCP 的区别以及下面的案例,会更容易把 harness 把握成让失败再次可解释的记录结构,而不只是留下日志的装置。

包裹输入和工具调用的执行环境

Harness 的范围可以更清楚地看成一组角色。

Harness 通常管理:

  • 执行使用了什么输入
  • 调用了哪些工具
  • 返回了什么结果
  • 中间发生了什么失败
  • 流程是否可以再次复现

换句话说,harness 不只看模型说了什么。它处理的是整个执行应该如何被包裹和管理。

flowchart LR
  A["输入"]
  B["agent 执行"]
  C["工具调用和 trace"]
  D["评估 / replay / 批准"]
  E["运行或改进"]

  A --> B
  B --> C
  C --> D
  D --> E

这张图的重点是,harness 不只留下结果句子。它会留下走向该结果的执行步骤和检查步骤。

只留下最终回答时会消失的执行原因

在单次问答场景中,一行日志也许足够。但 AI agent 会:

  • 生成多步计划
  • 调用工具
  • 遇到中间失败
  • 再次尝试
  • 产出最终结果

在这种结构中,如果只看最终回答,很难知道哪里做得好、哪里出了错。

因此,下面这些会变得重要。

  • Trace:流程按什么顺序移动?
  • Log:交换了哪些输入和结果?
  • Evaluation record:结果是否可接受?
  • Replay information:同一流程能否再次复现?

包裹这些要求的结构就接近 harness。

连接格式和执行记录的差异

这个差异也必须分开。

结构 中心作用
MCP 整理工具和数据连接接口
Harness 包裹执行、记录执行,并留下评估输入

换句话说:

  • MCP 接近应该连接什么以及如何连接。
  • Harness 接近使用该连接的流程应如何被管理并再次解释。

它们可以一起使用,但不是同一层位的概念。

把 harness 缩小成一个 DevOps 工具时产生的误解

如果把 harness 理解成某个具体产品或工具,它的范围会变得太窄。更稳妥的解释是:

Harness 更接近围绕执行的运行模式或环境视角。

这意味着 harness 可以是:

  • 测试运行器
  • 评估环境
  • trace 收集结构
  • 包含批准和权限检查的执行 wrapper

核心是包裹执行这个角色,而不是某个品牌。

绑定评估和可复现性的记录

即使 agent 系统一次看起来运行良好,下一次也可能表现不同。因此在运行中,下面这些问题会变重要。

  • 它在哪个输入上失败?
  • 哪个工具调用导致了问题?
  • 在什么设置下可以复现?
  • 修复是否真的改善了它?

没有 harness,这些问题很难处理。

换句话说,harness 不只是记录。它是调试和改进的基础。

由执行包裹并再次交给人审查的流程

flowchart TD
  A["agent 执行"]
  B["trace 和日志"]
  C["评估和 replay"]
  D["改进或批准"]
  E["人工交接或策略阻断"]

  A --> B
  B --> C
  C --> D
  C --> E

这张图的重点是,harness 包裹执行以产生可观测性(observability)和可改进性(improvability),并在需要时把流程移动到人工审查或策略阻断。

让失败原因能够再次说明的案例

这些案例的焦点不是是否失败,而是必须记录多少,才能再次解释同一失败。

案例 1. 编码 agent

假设编码 agent 修改了几个文件,随后测试失败。如果只看结果,我们知道失败了这个事实,但路径很快消失:先读了哪个文件,插入了哪个补丁,哪项测试最先显示问题。人可以手动追踪,但重复实验增加后,过程会开始依赖记忆和重建。例如,最后的失败可能出现在登录测试中,但真正原因可能是更早在共享工具函数中改动的一行。

如果这条路径没有留下,花在重复同一实验上的时间可能比追踪原因还多。有了 harness,读取文件、应用修改、执行测试和结果会作为 trace 留下,使问题点更容易再次追踪。判断标准从只看最终结果成功还是失败,变成检查能否重新追踪导致失败的执行路径。这个案例中要检查的结果,是记录是否不仅留下最终失败行,还留下哪个文件修改后哪项测试最先坏掉。

这是一个实践场景,因为编码 agent 的输出通常会经过多个文件、多个命令和多个验证步骤,而不是一个文件。即使人手动编辑,找出哪个 commit 弄坏了它也需要时间。如果 agent 在短时间内应用多个补丁,从记忆中重建路径会更难。所以 harness 的价值更接近让失败再次可解释,而不是防止失败。一行测试失败只能告诉我们某处坏了,却不能告诉我们哪个读取步骤或哪个编辑制造了失败。

即使是同一个失败,操作者能做出的判断也会随着记录层级大幅改变。

留下的记录 从外面看起来怎样 实际能再次判断什么
一行最终测试失败 确认失败 几乎无法追踪哪个修改制造了回归
修改文件列表 + 最终失败 修改范围可见 文件顺序和第一个问题测试仍不清楚
读取文件 + 补丁顺序 + 测试 trace 看起来复杂 第一个回归点、不必要编辑和遗漏验证可以分开

这张表的重要标准不是日志多很麻烦,而是没有日志,同一个失败就必须重新实验。在编码 agent 中,harness 不是替代调试的魔法。它是让调试成为可能的最小记录装置。

案例 2. 文档研究 AI agent

假设文档研究 AI agent 生成了政策变更摘要,但内容错误。如果只看最终句子,很难判断 agent 是总结错了,还是一开始就搜索了错误文档。真正的改进只能在区分二者之后开始,但没有执行记录时两者都只是猜测。例如,准确总结去年的公告和错误总结最新公告,是完全不同的失败。

如果缺少这个区分,应该修搜索逻辑还是修摘要 prompt 的决策也会摇晃。Harness 会留下搜索了哪些文档、阅读了哪些段落、采取了哪些摘要步骤,所以问题可以一步步分开。判断标准从只问回答是否错误,变成问能否区分是搜索阶段错了还是摘要阶段错了。这个案例中要检查的结果,是错误回答是否实际分离成搜索失败和摘要失败等不同原因。

这个场景在真实运行中也经常出现。研究 agent 通常在一个流程中同时处理寻找文档和整理找到的文档。但如果只留下最终摘要,人们很容易把两者混在一起。结果回答错误并不能区分是搜索阶段选了旧文档,还是已经读到最新文档但解释错了。这个差异会完全改变改进方向。前者是搜索优先级或新鲜度过滤问题,后者是摘要规则或引用结构问题。

同一个错误回答中,harness 留下的记录会扮演不同角色。

错误回答场景 没有 harness 时留下的解释 有 harness 时分离出的原因
读了去年的公告并准确总结 被模糊成总结失败 搜索失败、最新文档选择失败
读了最新公告但漏掉关键条款 只剩猜测:是不是找错文档? 摘要失败、关键信息保留失败
读了多个文档但混合了旧版和新版 只剩结论很奇怪 文档选择问题和冲突整理失败可以分开

这个案例纠正的误解是所有错误回答都是同一种失败。Harness 不是为了更快制造错误回答,而是为了把错误回答的原因拆成搜索层和解释层,以便设定下一次修复优先级。

案例 3. 客服 AI agent

假设客服 AI agent 发送了不可退款回答,但实际最新政策允许退款。人首先应该检查流程:是否读取了旧政策文档、是否读对了但应用回复规则错误,或是否没有批准步骤就立即发送。但如果没有执行记录,只剩一个错误回答,就很难在组织内解释错误发生在哪里。例如,如果政策解释是对的,但批准步骤被跳过并立即发送,那么问题可能是运行控制失败,而不是模型知识问题。

如果这个差异不可见,就很难设计控制来防止同样的回答错误再次出现。Harness 会把读取的政策、使用的工具、批准状态和评估状态一起留下,使审计和复现成为可能。判断标准从只问回答是否错误,变成问错误发生在哪个运行阶段。这个案例中要检查的结果是,当回答错误发生时,系统能否再次解释是哪一阶段出问题:引用旧文档、规则应用错误,还是缺少批准。

三个案例可以从运行视角这样分组。

情况 Harness 必须首先揭示什么 通过该记录能分离出的失败
编码 agent 经过了哪些文件和测试 补丁问题和遗漏验证
文档研究 AI agent 读了哪些文档,哪些段落被用作依据 搜索失败和解释失败
客服 AI agent 使用了哪条政策和哪条批准路径 知识错误和运行控制错误

应先检查执行记录的场景

第一次读 harness 时常见的误解,是只记住留下很多日志,却没有连接到这些日志必须实际导向复现、原因分离和运行行动。Harness 的核心不是记录数量,而是留下足够的执行细节,让同一失败可以再次解释并决定下一项行动。这个标准可以转成实践问题。

如果你怀疑这一点 先问的问题
我知道它失败了,但无法缩小原因。 留下了哪一步 trace?
这是模型错误还是运行错误? 依据文档、批准、工具调用记录是否分开?
修好了,但真的改善了吗? 能否 replay 同一运行来比较前后?

首先要学会的标准很简单。Harness 不是留下日志的装置。它是用 trace、approval 和 replay 让执行再次可解释,并把它交给评估和运行行动的运行装置。

核心不是运行更多执行。更重要的是,记录必须留下,这样我们才能分开应该用什么标准判为可接受,以及哪些失败应当作为搜索问题、哪些应当作为批准问题处理。

这个连接的最短版本如下。

Harness 留下什么 后续评估问题 后续运行行动
搜索文档和 trace 回答依据来自哪里? 修正搜索质量,替换依据文档
工具调用日志和批准状态 执行路径是否安全且合适? 添加批准 gate,调整调用限制
Replay ID 和执行设置 同一失败能否复现并比较? 比较修复前后,检查回归

在 P6-16 中,我们会把 harness 读成评估输入;在 P6-17 中,会把同一记录再次读成运行控制和失败处理的输入。

直接留下 harness 记录

这个示例的目标不是构建完整生产 harness,而是看看本地模型执行流程中应该留下哪些记录 artifact。如果只保存最终回答,我们能看到回答变了,却很难再次解释模型选择了什么依据、打算采取什么行动、在哪里停止。相反,如果执行输入、模型判断、工具契约、工具输出、批准 gate、replay 标准一起留下,同一个请求之后就能再次比较。

下面的示例把 OpenAI Agents SDK 的 Agent、function_tool、trace、Runner 与本地 Ollama 模型一起使用。要运行它,需要 openai-agents 包,并在 Ollama 中拉取 qwen2.5:1.5b 模型。运行前,Ollama 应用或服务器必须正在运行,且在终端运行 ollama list 时应能看到模型名。默认路径不使用 API key。模型判断用的 prompt 按 Python 示例指南用英文编写。本地模型会看到文档候选,并生成政策版本、回答草稿和发送意图。然后本地执行政策查询工具,需要批准的发送工具会被记录为停在 gate。每次执行都会作为 JSON 文件保存在 .tmp/p6-15-2-harness-runs/ 下,replay 比较会再次读取保存的运行记录。

首先,这个示例中要一起阅读的 harness 检查标准如下。

检查项 为什么需要
tool_contracts 需要知道哪些工具以什么输入格式和批准条件暴露。
model_decision 需要记录模型选择了什么依据,以及打算采取什么行动。
observations 输入、模型输出、工具输出和 gate 状态必须按执行顺序留下。
run_artifact 观察记录和执行摘要必须作为文件留下,以便之后再次读取。
replay_id 同一执行必须之后可以重新加载用于比较。
comparison 修改前后必须用同一标准读取。
import asyncio
import hashlib
import json
import os
from pathlib import Path
from pprint import pprint
import urllib.error
import urllib.request

from agents import Agent, Runner, function_tool, trace

REQUEST = "Please tell me whether a refund is available after a service outage."
TRACE_WORKFLOW = "refund-support-harness"
ARTIFACT_DIR = Path(".tmp/p6-15-2-harness-runs")
OLLAMA_MODEL = os.environ.get("OLLAMA_MODEL", "qwen2.5:1.5b")
OLLAMA_URL = os.environ.get("OLLAMA_URL", "http://127.0.0.1:11434/api/generate")

POLICY_STORE = {
    "2025_12_01": {
        "document_id": "refund_policy_2025_12_01",
        "refund_allowed_after_outage": False,
        "text": "Refund is not allowed after a service outage.",
    },
    "2026_06_29": {
        "document_id": "refund_policy_2026_06_29",
        "refund_allowed_after_outage": True,
        "text": "Refund is allowed after a service outage.",
    },
}


def read_policy_document_local(policy_version: str) -> dict:
    policy = POLICY_STORE[policy_version]
    return {"policy_version": policy_version, **policy}


def retrieved_policy_docs(order: str) -> list[dict]:
    versions_by_order = {
        "old_first": ["2025_12_01", "2026_06_29"],
        "current_first": ["2026_06_29", "2025_12_01"],
    }
    return [read_policy_document_local(version) for version in versions_by_order[order]]


@function_tool
def read_policy_document(policy_version: str) -> dict:
    """Return the refund policy document selected by version."""
    return read_policy_document_local(policy_version)


@function_tool(needs_approval=True)
def send_refund_reply(customer_id: str, answer: str) -> str:
    """Send a refund reply after human approval."""
    return f"queued reply to {customer_id}: {answer}"


refund_agent = Agent(
    name="Refund support agent",
    instructions=(
        "Answer in English. Read the refund policy document before drafting. "
        "If the answer will be sent to a customer, use the approval-required tool."
    ),
    tools=[read_policy_document, send_refund_reply],
)


def inspect_tool_contract(tool):
    return {
        "name": tool.name,
        "required_inputs": tool.params_json_schema.get("required", []),
        "needs_approval": bool(tool.needs_approval),
    }


def build_model_prompt(request: str, policy_docs: list[dict]) -> str:
    policy_lines = "\n".join(
        "- {policy_version}: {text}".format(**doc)
        for doc in policy_docs
    )
    return f"""Return only compact JSON with these keys:
policy_version, answer_en, send_reply_intent.
Use true or false for send_reply_intent.

User request:
{request}

Retrieved policy documents are ordered by search rank:
{policy_lines}

Use the top-ranked document unless the document itself clearly says it is obsolete.
Choose the policy version you used and draft a short English answer.
"""


def call_local_model(prompt: str) -> str:
    payload = {
        "model": OLLAMA_MODEL,
        "prompt": prompt,
        "stream": False,
        "format": "json",
        "options": {"temperature": 0},
    }
    request = urllib.request.Request(
        OLLAMA_URL,
        data=json.dumps(payload).encode("utf-8"),
        headers={"Content-Type": "application/json"},
    )
    try:
        with urllib.request.urlopen(request, timeout=90) as response:
            data = json.loads(response.read().decode("utf-8"))
    except (urllib.error.URLError, TimeoutError) as error:
        raise RuntimeError(
            "Ollama is not reachable. Start Ollama and check `ollama list` "
            f"for model `{OLLAMA_MODEL}`."
        ) from error
    return data["response"]


def parse_model_json(raw_text: str) -> dict:
    cleaned = raw_text.strip()
    if cleaned.startswith("`"):
        cleaned = cleaned.strip("`")
        cleaned = cleaned.removeprefix("json").strip()
    return json.loads(cleaned)


def normalize_model_decision(raw_text: str) -> dict:
    try:
        decision = parse_model_json(raw_text)
        return {
            "parse_ok": True,
            "policy_version": decision.get("policy_version"),
            "answer_en": decision.get("answer_en"),
            "send_reply_intent": normalize_boolean(decision.get("send_reply_intent")),
            "raw_text": raw_text,
        }
    except json.JSONDecodeError as error:
        return {
            "parse_ok": False,
            "policy_version": None,
            "answer_en": "",
            "send_reply_intent": False,
            "parse_error": str(error),
            "raw_text": raw_text,
        }


def normalize_boolean(value) -> bool:
    if isinstance(value, bool):
        return value
    if isinstance(value, str):
        return value.strip().lower() in {"true", "yes", "y", "1"}
    if isinstance(value, (int, float)):
        return value == 1
    return False


def input_hash(request):
    return hashlib.sha256(request.encode("utf-8")).hexdigest()[:12]


def select_policy(model_decision: dict, policy_docs: list[dict]) -> tuple[dict, bool]:
    selected_version = model_decision["policy_version"]
    if selected_version in POLICY_STORE:
        return read_policy_document_local(selected_version), False
    return policy_docs[0], True


def build_run_record(agent, request, retrieval_order, run_id):
    tool_contracts = [inspect_tool_contract(tool) for tool in agent.tools]
    policy_docs = retrieved_policy_docs(retrieval_order)
    prompt = build_model_prompt(request, policy_docs)
    raw_model_output = call_local_model(prompt)
    model_decision = normalize_model_decision(raw_model_output)

    observations = [
        {"event": "input", "value": request},
        {"event": "retrieved_documents", "order": retrieval_order, "value": policy_docs},
        {"event": "model_prompt", "language": "en", "value": prompt},
        {"event": "model_output", "model": OLLAMA_MODEL, "value": raw_model_output},
        {"event": "model_decision", "value": model_decision},
        {"event": "tool_contracts", "value": tool_contracts},
    ]

    policy, unknown_policy_version = select_policy(model_decision, policy_docs)
    observations.append({"event": "tool_output", "tool": "read_policy_document", "value": policy})

    approval_tool = next(tool for tool in tool_contracts if tool["name"] == "send_refund_reply")
    if model_decision["send_reply_intent"] and approval_tool["needs_approval"]:
        gate_status = "blocked_for_human_approval"
        send_status = "not_sent"
    elif model_decision["send_reply_intent"]:
        gate_status = "not_required"
        send_status = "sent"
    else:
        gate_status = "not_requested"
        send_status = "not_sent"

    observations.append(
        {
            "event": "approval_gate",
            "tool": "send_refund_reply",
            "status": gate_status,
        }
    )

    latest_policy_version = "2026_06_29"
    exception_flags = {
        "model_output_parse_error": not model_decision["parse_ok"],
        "unknown_policy_version": unknown_policy_version,
        "stale_policy_selected": policy["policy_version"] != latest_policy_version,
        "send_intent_blocked_by_gate": gate_status == "blocked_for_human_approval",
    }
    artifact_path = ARTIFACT_DIR / f"{run_id}.json"
    run_report = {
        "agent": agent.name,
        "model": OLLAMA_MODEL,
        "answer": model_decision["answer_en"],
        "retrieval_order": retrieval_order,
        "policy_version": policy["policy_version"],
        "document_id": policy["document_id"],
        "send_status": send_status,
        "gate_status": gate_status,
        "exception_flags": exception_flags,
        "trace": {"workflow": TRACE_WORKFLOW, "group_id": run_id},
        "observation_count": len(observations),
        "artifact_path": str(artifact_path),
        "replay_id": run_id,
    }
    return {
        "schema_version": "p6-15-2-local-run-v1",
        "run_id": run_id,
        "input_hash": input_hash(request),
        "observations": observations,
        "run_report": run_report,
    }


def save_run_record(record):
    ARTIFACT_DIR.mkdir(parents=True, exist_ok=True)
    path = ARTIFACT_DIR / f"{record['run_id']}.json"
    path.write_text(json.dumps(record, ensure_ascii=False, indent=2), encoding="utf-8")
    return path


def load_run_record(run_id):
    path = ARTIFACT_DIR / f"{run_id}.json"
    return json.loads(path.read_text(encoding="utf-8"))


def run_and_record(agent, request, retrieval_order, run_id):
    record = build_run_record(agent, request, retrieval_order, run_id)
    save_run_record(record)
    return record


def compare_saved_runs(before_run_id, after_run_id):
    before = load_run_record(before_run_id)
    after = load_run_record(after_run_id)
    before_report = before["run_report"]
    after_report = after["run_report"]
    return {
        "same_input": before["input_hash"] == after["input_hash"],
        "changed_retrieval_order": before_report["retrieval_order"] != after_report["retrieval_order"],
        "changed_policy_version": before_report["policy_version"] != after_report["policy_version"],
        "changed_answer": before_report["answer"] != after_report["answer"],
        "gate_kept": before_report["gate_status"] == after_report["gate_status"],
        "stale_policy_fixed": (
            before_report["exception_flags"]["stale_policy_selected"]
            and not after_report["exception_flags"]["stale_policy_selected"]
        ),
        "before": before_report,
        "after": after_report,
    }


async def run_live_agent(agent, request, replay_id):
    with trace(TRACE_WORKFLOW, group_id=replay_id):
        result = await Runner.run(
            agent,
            (
                "Customer ID: C-1042\n"
                f"User request: {request}\n"
                "Use policy version 2026_06_29."
            ),
            max_turns=6,
        )
    return {
        "final_output": result.final_output,
        "replay_id": replay_id,
    }


first_run = run_and_record(refund_agent, REQUEST, "old_first", "refund-support-run-001")
second_run = run_and_record(refund_agent, REQUEST, "current_first", "refund-support-run-002")
replayed_first_run = load_run_record("refund-support-run-001")
important_events = {"model_decision", "tool_output", "approval_gate"}
important_observations = []
for event in replayed_first_run["observations"]:
    if event["event"] not in important_events:
        continue
    if event["event"] == "model_decision":
        event = {**event, "value": {k: v for k, v in event["value"].items() if k != "raw_text"}}
    important_observations.append(event)

print("[first run report]")
pprint(first_run["run_report"])
print()

print("[important observations]")
pprint(important_observations)
print()

print("[replay comparison]")
pprint(compare_saved_runs(first_run["run_id"], second_run["run_id"]))

if os.environ.get("RUN_LIVE_AGENT") == "1" and os.environ.get("OPENAI_API_KEY"):
    print("\n[live sdk run]")
    pprint(asyncio.run(run_live_agent(refund_agent, REQUEST, "refund-support-live-001")))
else:
    print("\n[live sdk run skipped]")
    print("Set RUN_LIVE_AGENT=1 and OPENAI_API_KEY to call Runner.run().")

没有 API key 时,结果如下。这个输出包含本地模型实际生成的政策选择和回答草稿。从 harness 视角看,重要的不是回答句子本身,而是选择旧政策的运行和选择当前政策的运行如何被记录并比较。
[first run report]
{'agent': 'Refund support agent',
 'answer': 'Refund is not available after a service outage.',
 'artifact_path': '.tmp/p6-15-2-harness-runs/refund-support-run-001.json',
 'document_id': 'refund_policy_2025_12_01',
 'exception_flags': {'model_output_parse_error': False,
                     'send_intent_blocked_by_gate': True,
                     'stale_policy_selected': True,
                     'unknown_policy_version': False},
 'gate_status': 'blocked_for_human_approval',
 'model': 'qwen2.5:1.5b',
 'observation_count': 8,
 'policy_version': '2025_12_01',
 'replay_id': 'refund-support-run-001',
 'retrieval_order': 'old_first',
 'send_status': 'not_sent',
 'trace': {'group_id': 'refund-support-run-001',
           'workflow': 'refund-support-harness'}}

[important observations]
[{'event': 'model_decision',
  'value': {'answer_en': 'Refund is not available after a service outage.',
            'parse_ok': True,
            'policy_version': '2025_12_01',
            'send_reply_intent': True}},
 {'event': 'tool_output',
  'tool': 'read_policy_document',
  'value': {'document_id': 'refund_policy_2025_12_01',
            'policy_version': '2025_12_01',
            'refund_allowed_after_outage': False,
            'text': 'Refund is not allowed after a service outage.'}},
 {'event': 'approval_gate',
  'status': 'blocked_for_human_approval',
  'tool': 'send_refund_reply'}]

[replay comparison]
{'after': {'agent': 'Refund support agent',
           'answer': 'A refund is available.',
           'artifact_path': '.tmp/p6-15-2-harness-runs/refund-support-run-002.json',
           'document_id': 'refund_policy_2026_06_29',
           'exception_flags': {'model_output_parse_error': False,
                               'send_intent_blocked_by_gate': True,
                               'stale_policy_selected': False,
                               'unknown_policy_version': False},
           'gate_status': 'blocked_for_human_approval',
           'model': 'qwen2.5:1.5b',
           'observation_count': 8,
           'policy_version': '2026_06_29',
           'replay_id': 'refund-support-run-002',
           'retrieval_order': 'current_first',
           'send_status': 'not_sent',
           'trace': {'group_id': 'refund-support-run-002',
                     'workflow': 'refund-support-harness'}},
 'before': {'agent': 'Refund support agent',
            'answer': 'Refund is not available after a service outage.',
            'artifact_path': '.tmp/p6-15-2-harness-runs/refund-support-run-001.json',
            'document_id': 'refund_policy_2025_12_01',
            'exception_flags': {'model_output_parse_error': False,
                                'send_intent_blocked_by_gate': True,
                                'stale_policy_selected': True,
                                'unknown_policy_version': False},
            'gate_status': 'blocked_for_human_approval',
            'model': 'qwen2.5:1.5b',
            'observation_count': 8,
            'policy_version': '2025_12_01',
            'replay_id': 'refund-support-run-001',
            'retrieval_order': 'old_first',
            'send_status': 'not_sent',
            'trace': {'group_id': 'refund-support-run-001',
                      'workflow': 'refund-support-harness'}},
 'changed_answer': True,
 'changed_policy_version': True,
 'changed_retrieval_order': True,
 'gate_kept': True,
 'same_input': True,
 'stale_policy_fixed': True}

[live sdk run skipped]
Set RUN_LIVE_AGENT=1 and OPENAI_API_KEY to call Runner.run().

这个示例中首先要注意的是包围执行的记录框架,而不是 Runner.run() 调用本身。第一次运行是旧政策在搜索排序中排在前面的情况,本地模型跟随顶部文档并选择 2025_12_01 政策。第二次运行是当前政策排在前面的情况,replay 比较会同时留下 changed_retrieval_order、changed_policy_version 和 stale_policy_fixed。因为 send_refund_reply 是标记为 needs_approval=True 的发送工具,两次执行都没有实际发送,而是以 blocked_for_human_approval 停止。这个差异必须留在报告中,评估或运行层才能分开搜索候选问题、模型判断问题和批准 gate 问题。

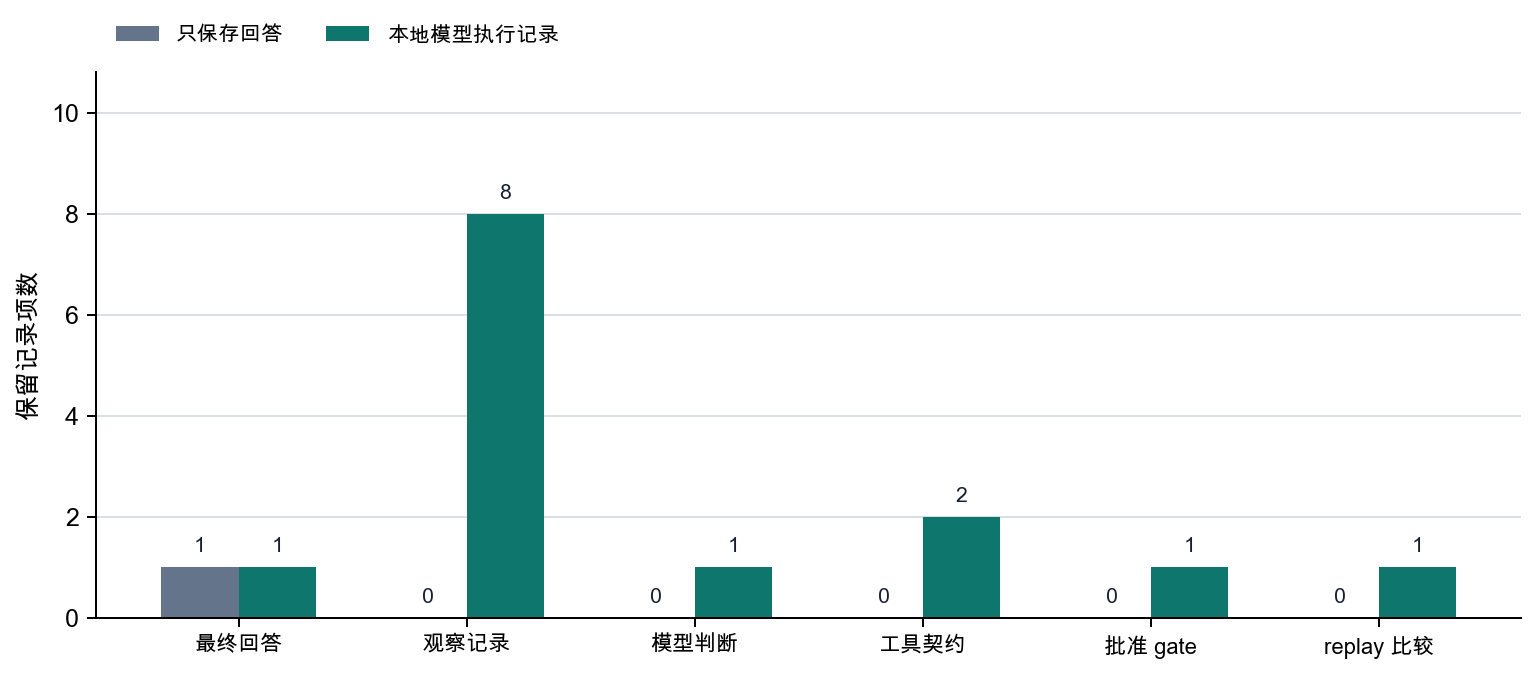
harness 观察记录比较

这张图比较只保存最终回答的运行,和把本地模型执行作为记录 artifact 留下的运行。核心不是项目数量。模型判断、工具契约、实际工具输出、批准 gate、trace group、保存的 run artifact、replay 比较必须一起留下,这样同一请求再次运行时,我们才能解释什么保持不变、什么发生了改变。

同一次执行可以按 harness 的三个轴重新分组。

轴 代码留下什么 为什么可复现性需要它
Observation observations 输入、检索候选、模型判断、工具契约、工具输出和 gate 状态必须能按同一顺序审查。
Report run_report 执行结果和执行边界必须能作为人可比较的摘要读取。
Reproduction save_run_record(), load_run_record(), compare_saved_runs() 保存的运行记录必须能重新加载,用来比较旧运行和新运行。
Gate needs_approval=True 不得在没有批准时运行的工具,需要在执行边界被分开。

所以这个示例中要检查的结果,不是某个退款回答是否正确。更重要的结果是,即使是同一请求,当搜索候选顺序变化时,模型选择的政策和回答也可能变化,而 harness 记录会把这个差异作为 replay comparison 留下。同时,即使存在发送意图,批准 gate 仍然存在并阻止实际发送。

读者可以尝试这些调整。

  • 在 old_first 和 current_first 之间改变文档顺序,观察所选政策和 stale_policy_selected 如何变化。
  • 把 OLLAMA_MODEL 改成 llama3.2:latest,观察模型输出质量和 model_output_parse_error 出现可能性如何变化。
  • 在 normalize_model_decision() 中把 policy_version 改成任意值,观察是否记录 unknown_policy_version,以及流程是否回退到顶部文档。
  • 从 send_refund_reply 移除 needs_approval=True,观察 approval gate 如何从报告中消失,以及 send_status 如何变化。
  • 移除 save_run_record() 调用,观察即使存在 observations,为什么旧执行和新执行也会难以比较。
  • 设置 RUN_LIVE_AGENT=1 和 OPENAI_API_KEY,观察实际 Runner.run() 结果是否被归入同一个 trace.group_id。

再进一步,需要区分 harness 直接修复的东西,以及 evaluation 或 operations 必须基于 harness 记录重新判断的东西。

首先看到的信号 Harness 必须留下什么 Harness 不会替我们做出的判断
只剩最终回答 输入、工具调用 trace、replay ID 比较旧执行和新执行的标准
需要前后比较 Replay ID、执行设置、trace 存储状态 在同一条件下重新评估回归是否减少
未经批准就发出执行 批准状态和实际发送路径 添加批准 gate 并强化自动阻断策略
某个失败无法再次复现 输入、工具调用、中间状态记录 判断不可复现本身是否是运行风险

这张表的重点是,harness 既不是判断好坏的层,也不是自动修复运行问题的层。Harness 是让判断和行动成为可能的记录层。评估章节把这个记录读成质量标准,运行章节把同一记录读成控制和恢复行动。

成为评估输入的执行记录

前面的示例不是实现完整商业运行 harness 的代码。它是一个检查场景,检查包裹 SDK 运行时需要的最小观察记录和复现标准。重要的不是列出很多记录项,而是如果只剩一个结果句子,执行条件和中间观察都会消失,replay comparison 也不可能进行。

Harness 视角不是保存回答结果的装置,而是让同一执行再次可解释、可比较的执行记录结构。如果只看回答句子,很容易只说可接受或奇怪。但当观察报告、批准记录和 replay 信息一起留下时,评估轴就可以分成是否同一请求、是否同一工具结果、是否同一批准路径等问题。

到这里,执行记录会作为评估输入进入下一章。P6-16 中,我们不会只读一个结果句子,而会把 harness 留下的 trace、依据文档、批准状态和可 replay 性读成质量标准。P6-17 中,我们会再次把同一记录读成成本、延迟、失败阻断和人工审查等运行控制。

检查清单

  • 你应该能够把 harness 说明成包裹执行、记录执行并留下评估输入的运行装置,而不是一个工具。
  • 你应该能够说出 MCP 处理连接,而 harness 处理执行管理和复现标准。
  • 你应该知道 evaluation 不是脱离 harness 独立漂浮的抽象判断,而是通过质量标准读取执行记录的阶段。

参考资料