P6-18.1 按成本、延迟和使用量再次过滤的运营约束
Section ID:
P6-18.1Version:v2026.07.31
运营约束要把 quality_result、cost_per_request、latency_budget、usage_limit、capacity_risk、deployment_decision 一起记录。这样即使评估分数通过,也能看出它仍可能在实际运营候选阶段被重新筛掉。
即使 evaluation 选出了好的回答候选,也不代表服务马上可行。回答必须在用户能忍受的等待时间内、以可承担的成本、并且在预期请求量到来时反复提供。服务运营约束是一条独立通过线,会把已经通过质量评估的候选再次过滤成实际运营候选。
AI 服务不是只由模型质量决定。它必须在成本、延迟、使用限制、失败可能性等真实约束内运作。即使模型很好,如果服务太慢、太贵,或经常停止,也很难说它是好服务。
运营限制判断处理什么
核心问题是:
- 为什么好模型本身不足以形成好服务?
- 成本、延迟和使用限制如何制造问题?
- 服务设计中必须一起权衡什么?
如果 AI 服务判断只困在模型性能里,很多重要失败会被漏掉。即使候选通过了质量评估,如果它太慢、太贵,或无法处理并发请求,也会作为运营候选再次失败。所以这一阶段的问题不是有没有好模型,而是这个好回答能否在运营限制内反复提供。
服务限制判断会一起查看下面这些内容。
| 运营约束 | 要问的问题 | 被阻塞时首先调整什么 |
|---|---|---|
| 成本 | 单次请求和重复请求的成本是否在预算内? | 模型大小、上下文长度、工具调用次数 |
| 延迟 | 回答是否在用户能等待的时间内到达? | 搜索深度、生成长度、缓存、轻量路径 |
| 处理量和容量 | 服务能否并发处理预期请求量? | 队列、缓存、速率限制、基础设施限制 |
| 可恢复性 | 主要重路径被阻塞时是否有替代路径? | fallback 回答、部分响应、人工交接 |
所以,evaluation pass 和 operational candidate pass 不是同一件事。如果 evaluation 分离回答质量轴,运营限制判断则分离这种质量是否能被反复提供。
这一阶段首先要留下的判断,应该显示哪个运营限制阻塞了候选,下一步应从哪里调整,以及通过 evaluation 的回答是否还能作为真实运营候选保留。
这个判断会成为失败处理和真实请求记录的输入。
| 运营限制判断留下什么 | 分支出的运营路径 | 请求记录中应留下的代表值 |
|---|---|---|
| 延迟是主要约束 | 调整 timeout 标准、轻量路径、fallback 审查 | 下一步行动、incident note、执行说明 |
| 成本是主要约束 | 减少调用、使用更小模型、缩短步骤 | 下一步行动、执行记录、成本摘要 |
| 处理量是主要约束 | 队列、缓存、处理量限制路径审查 | 下一步行动、incident note、运营说明 |
| 候选可以继续运营 | 保留运营候选 | 状态摘要、运营摘要、请求运行记录 |
因此,运营限制判断不是读一次就忘的表。它是失败处理分支和请求流程记录的输入。
区分评估通过和运营可行
只要抓住这个区分,AI 服务约束就不再是一串 operations 术语,而是用来观察成本、延迟、使用限制如何与质量相撞的标准。也更容易理解为什么越过运营限制后,必须立刻进入失败处理路径。
首先要拆开的场景是:
| 首先看到的阻塞 | 首先要问的问题 | 为什么这个问题要先问 |
|---|---|---|
| 回答质量不错,但用户觉得太慢 | 延迟是否超过允许范围? | 质量通过和服务体验通过不同,所以响应时间要单独判断。 |
| 能运行,但调用增加后运营负担急剧增长 | 成本是否超过重复运营预算? | 服务判断问的是能否持续运行,不只是一次成功。 |
| 一两个请求能运行,但流量上来就崩 | 容量和处理量限制是否先被阻塞? | demo 成功和重复请求运营不同。 |
| 为提高质量增加了更多步骤,整个路径变得太重 | 应该降低处理深度,还是拆成 fallback 路径? | 更多步骤不总是更好的服务,允许深度必须在运营限制内判断。 |
这张表帮助我们把服务运营约束读成解释为什么通过 evaluation 的回答会作为实际服务候选再次失败的标准,而不是运营词汇表。
为什么模型质量本身不够
即使模型能产生好回答,真实服务仍然必须满足速度、成本、处理量和稳定性。因此问题会从它是否表现好转向它能否持续运行。
- 它必须足够快地响应。
- 它不能太贵。
- 它必须处理很多请求。
- 发生失败时不能完全停止。
所以,服务是一个包含运营可行性的问题,而不只是回答质量。
为什么成本是大问题
AI 服务通常会产生每次调用成本,或在直接运营时产生基础设施成本。尤其当下面这些项目一起增加时,负担会变大。
- 长输入上下文
- 长输出
- 更大的模型
- 更多工具调用
- 更多重试
Agent 结构和 RAG 结构可以提升质量,但随着调用阶段增加,成本也可能一起增加。
第一个重要点是,功能更多 = 总是更好的选择是错的。
为什么延迟重要
用户不只想要正确答案;他们也想要在可等待时间内得到答案。
例如,下面这些步骤串在一起时,延迟会累积。
- 文档检索
- 模型生成
- 工具调用
- 后处理
于是服务必须问:
- 每一步是否每次都必须运行?
- 有些步骤能否缓存?
- 多慢才是可接受的?
因此,延迟不仅是技术问题,也是用户体验问题。
同一个答案在 2 秒内到达,和 20 秒后到达,会形成不同的服务体验。延迟看起来可能不如准确性重要,但在真实使用中,它会强烈影响采用。
使用限制和容量问题
服务增长后,请求量也会增长。于是可能出现下面这些问题。
- 每分钟请求数限制
- 并发处理限制
- 模型供应商 API 限制
- 内部基础设施瓶颈
可以这样读:
好的 demo 和可运营的服务不同。Demo 只需要成功一次,服务必须承受重复请求。
这句话对读者尤其重要。很多 AI demo 很惊艳,但进入真实服务后,并发请求和成本经常先出现。
为什么质量和约束必须一起读
这一点很重要。
使用更大的模型可以提高质量。但它也可能:
- 增加成本
- 增加延迟
- 增加运营复杂度
使用更小的模型可以:
- 让响应更快
- 降低质量或稳定性
因此,服务设计通常是一个平衡问题:
应该以什么成本和速度,在什么使用范围内,提供什么水平的质量?
在同一服务流程中:
| 想要提高的东西 | 可能一起增加的负担 |
|---|---|
| 更大的模型 | 成本、延迟 |
| 更多检索文档 | 成本、上下文长度、处理时间 |
| 更多工具调用 | 失败点、运营复杂度 |
缩短成部署候选判断时,首先应该出现下面的检查清单。
| 保留为部署候选前再次检查 | 为什么必须再次检查 |
|---|---|
| 是否通过质量评估? | 看起来好的回答必须先通过真实标准。 |
| 延迟是否在允许范围内? | 即使答案正确,到达太晚也会作为服务失败。 |
| 成本是否在调用预算内? | 一次成功必须能作为重复运营成本持续。 |
| 容量能否承受负载? | Demo 成功和重复请求运营不同。 |
| 是否有 fallback 或轻量路径? | 主要路径过重时,系统不应完全停止。 |
Evaluation pass 和 operational candidate pass 不是同一件事。这也是实际材料经常把 LLMOps 或 serving 作为单独模块处理的原因。
为什么 RAG 和 AI agent 结构会变得更复杂
与简单聊天相比,RAG 和 AI agent 有更多步骤。
- 检索
- 文档整理
- 模型生成
- 工具调用
- 重试
随着步骤增加:
- 调用次数增加
- 失败可能性增加
- 延迟累积
- 日志和评估成本也增加
结构越强,运营约束也越强。
在简单 prompt-only 结构中,约束相对简单。但加入 RAG 和 AI agent 后,本节核心是:为了做出好回答而增加的步骤和维持这些步骤的运营负担会一起增长。
再简化一次:
flowchart LR
  A["更高质量的方案"]
  B["更多步骤"]
  C["更高成本"]
  D["更高延迟"]
  E["容量压力"]

  A --> B
  B --> C
  B --> D
  B --> E
这张图的核心是,提升质量的选择往往也会带来更多步骤和运营负担。
案例和例子
这些案例的重点不是看起来好不好,而是能否在运营约束内持续提供。
案例 1. 客户支持聊天机器人
假设客户支持聊天机器人每次都检索所有长政策文档,并总是生成长回答。起初很容易认为读得更多、答得更长,就会是更好的聊天机器人。这可能让回答看起来更详细、更准确。但即使只是密码重置这类简单问题,用户也必须等待好几秒,实际体验可能仍然是聪明但很慢。
对于配送追踪这类短状态查询,每次附上一大段政策解释看起来准确,但用户会觉得回答晚且过量。一些用户可能没读完就离开。人们首先看到的运营问题不只是质量,而是客户能否忍受这个速度。这个案例中要检查的结果,是响应时间是否独立于回答质量提升而损害实际使用体验,以及短问题能否在不过度处理的情况下结束。
这是一个真实运营场景,因为客户感知到的质量不只由准确性决定。如果短问题花太久,或带着不必要的长回答,用户会先感到延迟和疲劳,而不是智能。因此运营者更应该检查处理深度是否超过问题难度,而不是只问是否读得更多、答得更长。
| 问题场景 | 容易先下的判断 | Operations 必须再次检查什么 |
|---|---|---|
| 密码重置这类简单问题 | 解释越多越好 | 短问题是否触发了过度检索和长回答? |
| 配送追踪这类状态查询 | 添加政策上下文很亲切 | 回答是否先用必要状态值快速结束? |
| 例外很多的政策问题 | 读取很多文档更安全 | 是否只对复杂问题选择更深处理? |
这张表修正的是更多处理 = 总是更好的服务这个误解。
案例 2. 开发助手工具
假设开发助手在编辑代码前会进行文件探索、搜索、测试和重试。这可以提高一次修复的成功率。但随着调用阶段增加,token 成本和执行时间也会增加。如果工具对一个小变量名修改也重复运行完整测试,用户会觉得它准确但太重。
例如,每次修正一个拼写错误都运行完整集成测试,可能提高安全性,却大幅降低日常可用性。如果整个团队都重复这个流程,基础设施成本会快速增长。重要问题不是多做是否更好,而是为质量提升支付的成本是否可接受。这个案例中要检查的结果,不只是修复成功率高不高,而是执行时间和成本是否仍在日常使用范围内。
开发助手经常为了减少失败而增加更多检查和重试。但如果同一个重流程不分任务大小都运行,工具会更安全,却更难日常使用。重命名变量和修改构建配置的风险等级不同。如果两者都经过同样的完整测试和多步骤验证路径,团队很快会觉得只在重要工作中使用它。
| 编辑场景 | 更多检查运行时看起来更好的地方 | 运营中要重新检查的成本 |
|---|---|---|
| 变量重命名或字符串拼写修正 | 出错可能性降低 | 小工作运行完整测试会增加延迟和成本。 |
| 函数签名变更 | 更宽的验证可以提高安全性 | 这种情况下,更强检查可能是合理的。 |
| 多文件重构 | 重试和搜索确实能提高质量 | 调用和重试限制需要单独上限。 |
重要标准不是它准确,所以好,而是为准确性支付的时间和成本是否与任务大小成比例。
案例 3. 内部文档问答
假设内部文档问答为了提高准确性,尽可能附上相关文档。实际上,这会增加成本和延迟,过多段落也可能埋没关键句,让回答更模糊。比如退款政策问题,如果附上十个文档,不太重要的一般指引可能比关键例外条款更显眼。
这种情况下,回答变长了,但用户需要的一行判断标准出现得更晚。更多证据不总是带来更好回答。标准会从先问附了多少文档变成问问题真正需要的依据是否被准确选出。要检查的结果是,关键例外条款是否先在回答中保留下来,而不是附了多少文档。
三个案例可以按运营约束这样整理。
| 情况 | 为提高性能而增长的运营负担 | 需要再次调整的标准 |
|---|---|---|
| 客户支持聊天机器人 | 长检索和长回答增加延迟 | 按问题难度控制处理深度、响应时间 |
| 开发助手工具 | 测试、重试、工具调用增加成本 | 按任务大小控制检查强度、执行预算 |
| 内部文档问答 | 文档过多增加成本和噪声 | Top-k、文档选择准确性、回答长度 |
应该作为运营候选再次过滤的场景
初读运营约束时常见误解是:已经通过 evaluation,所以现在可以部署了。但真实服务候选判断必须再次分开好回答和可持续承担的回答。实用问题如下。
| 如果你怀疑这个 | 首先要问的问题 |
|---|---|
回答是对的,为什么还是不舒服? | 响应时间是否在真实用户期望内? |
它准确,但太贵。 | 能否用更少调用和更短路径达到同样质量? |
一个一个请求能跑,但同时使用就崩。 | 当前结构是否真的能处理预期请求量? |
附了很多文档,但回答变模糊了。 | 是否只保留问题需要的依据,其余减少? |
如果立刻标注哪个运营约束先失败,判断会更短。
| 首先要留在设计上的判断 | 留下这个判断的标准 |
|---|---|
latency needs adjustment | 回答质量没问题,但超出用户可等待时间。 |
cost needs adjustment | 保持同样质量需要太多调用、太大模型或太多上下文。 |
capacity needs adjustment | 一个请求能跑,但处理量和并发无法承受流量。 |
processing depth needs adjustment | 检索、工具调用或长回答阶段相对问题难度过重。 |
can remain as operational candidate | 质量、延迟、成本、容量都在当前服务限制内。 |
关键是把这是一个好回答和这是一个可运营设计分开。这会自然连接到示例中的 primary_tradeoff 和 next_adjustment 值。
首先要学会的标准很简单。服务运营约束不是在质量好之后附加的次要条件。它是一条独立通过线,询问这种质量能否在成本、延迟和容量内反复提供。
练习和例子
这个例子的目标,是把质量和约束一起看成实际选择结果,并读取每个设计应该先减少或改变什么。我们不只比较两个设计,而是把多个服务设计放到同一运营约束下,比较哪些通过、哪些失败。除了质量、延迟、成本之外,我们还加入该设计能处理的每分钟请求数,这样可以看到一个设计可能作为 demo 可行,却在运营中失败。
例子使用服务设计候选、团队允许的最大延迟和成本、最低质量线,以及预期每分钟请求数。有些设计快且便宜,但质量低。有些质量高,但慢或贵。有些单次请求看起来不错,但无法处理每分钟请求。
输出会显示每个设计是否可接受、为什么被选择或拒绝、在通过运营约束的设计中质量最高的候选,以及下一步应做什么调整。代码中的关键点是,服务设计必须同时满足延迟、成本、处理量和单个回答质量。
要一起读取的运营约束标准是:
| 检查项 | 为什么需要 |
|---|---|
quality_ok | 低于最低质量线的设计,即使快且便宜,也难以采用。 |
latency_ok | 回答必须在用户可等待时间内到达。 |
cost_ok | 即使单次请求好,超出预算也难以持续运营。 |
throughput_ok | 如果无法承受重复请求,它就是 demo,而不是服务。 |
| Next adjustment | 对失败设计,需要知道首先减少或改变什么。 |
例子使用服务候选 CSV p6_17_1_service_candidates.csv。一行表示一个服务设计案。quality_score 是回答质量,avg_latency_ms 是平均响应时间,estimated_cost_per_1k_requests 是每 1,000 个请求的预估成本,max_requests_per_minute 是当前结构能处理的每分钟请求数。这些值不是实际运营日志,而是学习用候选值;但它们会一起比较 36 个候选,避免只看一两个数字就下结论。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 | |
示例输出可以这样读取。
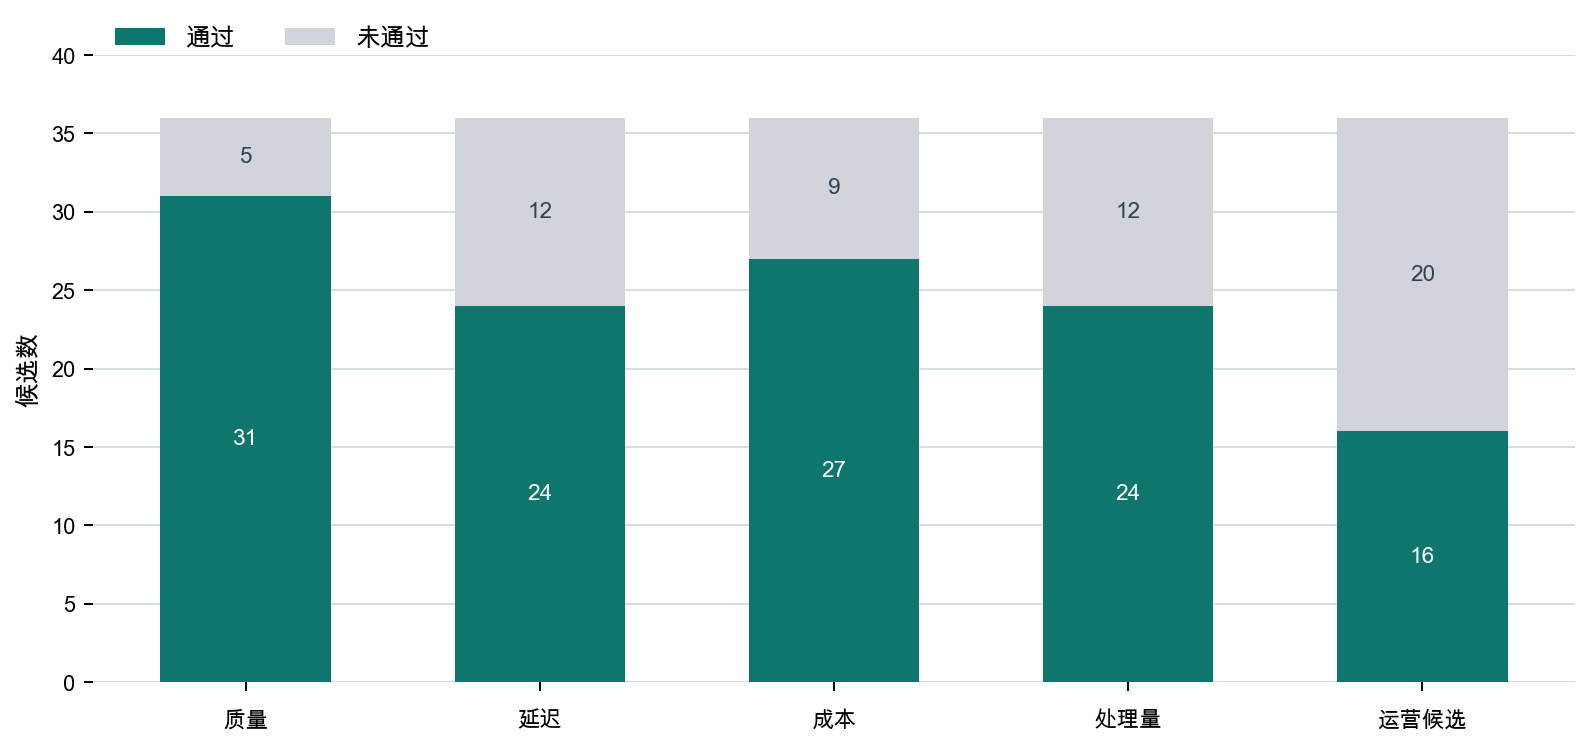
首先要注意 failed_checks 和 primary_tradeoff 的区别。failed_checks 显示候选没通过的所有限制,而 primary_tradeoff 缩小为首先要调整的轴。判断顺序不是简单选择最大数字。如果候选没有通过最低质量线,它首先被视为质量问题。如果它通过质量但被运营限制阻塞,瓶颈会按延迟、成本、处理量的顺序缩小,因为这些直接连接到用户体验和请求路径缩减。
所以,rich_deep_rag 同时在延迟、成本和处理量上失败,但首先要调整的轴是延迟。这个候选接近一种为了提升回答质量而让检索和生成路径变重的情况,因此下一步不是立刻丢弃整个结构,而是先减少搜索深度、生成长度,或寻找缓存机会。相反,accurate_but_capped 只看单次请求质量可能比 balanced_support 更好,但因为每分钟请求容量不足,它作为运营候选失败。cost_over_budget_support 通过质量、延迟和处理量,却在成本上失败;capacity_shortfall_support 则因为刚好低于所需处理量而失败。next_adjustment 让我们不仅知道它失败了,还知道先修哪里。
这张图不是为了让我们记住个别候选名称。它总结 36 个候选如何被每个约束轴过滤。即使很多候选分别通过质量、延迟、成本或处理量,四个条件合在一起后,最终 operational candidate 数量会减少。要检查的结果是,当延迟、成本和处理量约束一起应用时,更高质量数字仍然可能输掉;快速便宜的设计如果没过最低质量线,也会失败。
读者可以尝试这些调整。
- 放宽
max_latency_ms,观察高质量设计是否通过。 - 提高
min_quality_score,观察balanced_support何时也失败。 - 提高
required_requests_per_minute,观察balanced_support何时被推出运营候选。
用一句话说,服务运营约束不是选择一个好模型;它是选择一个能在约束内维持的设计,并决定先调整哪个薄弱轴。
到了真实服务阶段,产出一个看起来好的响应还不够。还必须问这个响应是否能被快速、可承担、稳定地维持。因此,本节应该被读成运营约束判断,而不是简单的模型性能比较。
这个运营判断重要,是因为它:
- 从 P6-17.1 和 P6-17.2 的
这是不是好回答,移动到这个回答是否真的能被快速、低成本、稳定地提供 - 把视角从模型中心思维转向服务运营思维
- 为失败处理和 incident management 问题做准备
- 为 Part 7 部署和运营回顾加入约束设计,而不只是功能实现
检查清单
- 你应该能够把服务运营约束说明成
这种质量能否在成本、速度和容量内持续,而不是质量好不好。 - 你应该能够说出,成本、延迟和使用限制是不同约束,同一个质量提升选择可能同时摇动三者。
- 你应该能够继续思考,在这些限制内发生失败时,应该由哪条恢复路径处理。
参考资料
- OpenAI, Production best practices, OpenAI API Docs, accessed 2026-07-19.
- OpenAI, Latency optimization, OpenAI API Docs, accessed 2026-07-19.
- OpenAI, Cost optimization, OpenAI API Docs, accessed 2026-07-19.