跳转至

P6-18.2 把错误分到恢复路径的运营失败处理

Section ID: P6-18.2 Version: v2026.07.31

失败应对记录要分开 failure_type、trace_step、retry_allowed、fallback_path、approval_required、recovery_result。有了这些字段,就能按恢复路径查看模型错误、工具错误、权限问题,而不是把它们都归为同一种障碍。

设定服务运营限制之后,还需要决定实际失败应该走向哪里。失败处理不只是修正最终回答句子。它意味着把检索、工具调用、权限、延迟和日志一起查看,然后在 retry、fallback、stop、approval 中选择最安全的路线。换句话说,它更接近回溯产生回答的整个过程,而不是只看一行回答。

Failure Routing 决定什么

核心问题是:

  • AI 服务中的失败可以有哪些形态?
  • 应该怎样区分模型失败和系统失败?
  • 运营中需要哪些响应标准?

如果失败处理被简化成错误消息处理,就会漏掉 LLM 服务特有的多步骤失败。看起来相似的失败可能需要不同动作:检索缺失、模型幻觉、工具权限错误、timeout、处理量限制越界,不是同一个问题。关键变化是从判断回答是否好转向决定失败路线。

Failure routing 可以这样拆开。

失败信号 首先缩小的轴 首先选择的响应路线 要保留的记录
临时 timeout、瞬时外部 API 错误 临时系统错误 有界 retry 重试次数、各步骤延迟
检索缺失、慢重路径、部分工具不可用 检索或执行路径问题 Fallback 检索候选、替代路径、用户影响
权限缺失、风险执行、无依据断言 权限或安全问题 Stop 或 approval 权限状态、批准请求、停止理由
文档已读但回答夸大或格式漂移 模型输出问题 人工审查或模型修复 草稿回答、依据比较、修复任务

这里,retry、fallback、stop、approval 组成的失败处理,是把回答失败和系统失败按路线读取的方式,而不是把它们压成一个标签。

即使失败看起来一样,路径首先停在哪里不同,记录和后续动作也会不同。别扭回答背后可能有正常检索和工具调用。反过来,在模型回答生成前,流程可能已经在检索候选或权限边界处失败。因此,失败处理应该保留检索候选、工具调用、权限状态、timeout 记录、草稿回答与依据的比较,而不是只编辑最终句子。

区分模型失败和系统失败

  • 你可以在入门层面解释 AI 服务失败类型。
  • 你可以区分模型失败和系统失败。
  • 你可以解释 trace、fallback、retry、approval 的作用。
  • 你可以从运营视角连接 prompting、RAG、tool use、AI agents、evaluation。

与其背很多失败类型名称,不如使用一个问题:为什么同一个表面失败会分到 retry、fallback、stop 或 approval。

首先看到的失败信号 后续响应路线 为什么这样分流
短暂 timeout、临时外部 API 错误 retry 同一路径短暂再试可能恢复。
检索缺失、慢重路径、部分工具不可用 fallback 与其完全停止,服务可能需要降级到更简单路径并保留最低功能。
权限缺失、风险执行、无依据断言 stop 或 approval 继续可能增加错误执行或错误指引风险。
读完文档后回答仍持续夸大或格式漂移 人工审查 + 独立修复任务 如果系统恢复和模型改进被压进同一路线,原因追踪会变模糊。

如果先抓住这张表,后面的失败类型、trace、retry、fallback 和案例会更容易被理解成分支结构:不只是发生了错误,而是它首先应该走哪条路线。

失败从哪里出现

在 AI 服务中,失败不会只出现在一个点。它可能出现在模型、检索、工具、性能、权限等多个层位。因为每个原因需要不同响应,所以逐步观察失败并缩小原因很重要。

例如:

  • 模型给出了事实错误的回答。
  • 检索带回了无关文档。
  • 工具调用失败。
  • 函数参数构造错误。
  • 回答是对的,但到达太晚。

因此,失败可以跨越多个层位:输出内容、检索、执行、性能、权限。

关键是不要只把失败 = 错误回答来读。慢响应、权限错误、坏检索,从运营视角看都是失败。

模型失败和系统失败有什么不同

这个区分很重要。

模型失败

  • 幻觉
  • 错误摘要
  • 格式不匹配
  • 无依据的一般回答

系统失败

  • 检索缺失
  • 工具或 API 调用失败
  • 数据访问权限错误
  • Timeout
  • 缓存或状态不一致

如果不分开这些,所有问题都会被压成模型不好。但在真实运营中,必须缩小原因。

可以这样简短重述这个区分:

  • 模型失败:文档已经被读取之后,问题仍出现在摘要、推理或表达中。
  • 系统失败:制造回答的路径断了,例如检索、工具调用、权限或后处理。

为什么 Trace 重要

只看最终回答,很少能看出失败原因。运营中必须能重新查看下面这些问题。

  • 检索了哪些文档?
  • 调用了哪些工具?
  • 传入了哪些参数?
  • 哪个步骤花了很长时间?

这些信息必须可用,才能判断问题是检索失败、模型失败,还是工具失败。

因此,trace 不只是日志。它是失败分析的起点。

作为服务流程来看,agents 和工具使用增加时,trace 会变得更重要。步骤越多,服务越需要能回溯哪里出错了。

为什么需要 Retry 和 Fallback

在运营中,比起试图完全防止每个失败,更重要的是决定怎样软化失败。

例如:

  • 检索失败时,切换到一般回答模式。
  • 工具调用失败时,请用户确认。
  • 较慢模型延迟时,换成更小模型。
  • 外部 API 失败时,使用最近缓存结果。

这种结构可以理解为 fallback。

Retry 是临时失败后再试一次的方法。但无限 retry 会增加成本和延迟,所以需要限制。

这里下面的区分尤其重要。

响应工具 主要目的
retry 通过再次尝试从短暂失败中恢复
fallback 原路径失败时使用替代路径
stop 停止推进,防止更大错误
approval 把权限敏感或有外部影响的动作放到人工批准后面

Retry、fallback、stop、approval 不只是功能名称。它们是失败分诊的基本分支。

在运营服务中,最短的读法是:短暂事故用有界 retry,主路径被阻塞时用 fallback,出现权限或风险时用 stop 或 approval,模型输出漂移时分开人工审查和修复任务。核心不是停在我们看到了失败,而是立刻决定这个失败首先应该进入哪条路线。

把运营失败分到恢复路线

如果把 P6-17.2 的自动和人工评估、P6-18.1 的运营约束,以及本节的失败处理连成一个运营序列,首先应该看到下面四行。

运营步骤 首先检查的问题 要保留的代表记录
自动 gate 回答是否通过格式、来源线索、禁用表达、基础长度条件? 回答状态检查、自动检查结果
人工审查 语气、可能误解、下一步行动清晰度、例外解释是否可接受? 审查摘要、审查评论
运营限制检查 路径能否承受延迟、成本、处理量和 rate-limit 约束? 执行时间、调用次数、成本摘要
失败处理 应该走哪条路线:retry、fallback、stop,还是 approval? Incident 记录、下一步行动、trace 记录

这张表的关键不是把evaluation和operation分开读。即使回答看起来好,如果它没过自动 gate,也不是部署候选。即使过了自动 gate,如果人读起来可能误解,也需要修订。即使两者都好,如果延迟或成本无法维持,也可能在运营上被拒绝。而实际失败发生时,如果没有 trace 记录或下一步说明,同样问题会重复。

用一句话说,Part 6 后半可以压缩成下面的服务判断:

自动过滤什么 -> 人必须读到最后的是什么 -> 是否符合运营限制 -> 失败时记录哪条路线

为什么 Approval 和 Permission 重要

尤其在 AI agent 结构中,自动执行每个动作可能有风险。

例如:

  • 删除文件
  • 发送邮件
  • 修改外部系统
  • 运行昂贵作业

这些动作可能需要批准流程。

因此,失败处理不只是出错后的清理。它也包含在执行前预防风险失败的结构。

所以,失败处理同时包括事后恢复和执行前预防。

流程可以再简化如下。

flowchart LR
  A["检测到失败"]
  B["分类失败"]
  C["retry / fallback / stop / review"]
  D["保存 trace 并改进"]

  A --> B
  B --> C
  C --> D

这张图的重点是,失败处理不会以显示错误消息结束。它会分类失败、选择响应路线、留下 trace,并把 trace 连接到下一次改进。

失败处理不是最终输出之后的附加物。它必须成为整个执行结构的一部分。

案例和例子

这些案例的重点不是失败是否发生了,而是失败之后路径应该怎样分开。

案例 1. RAG 回答失败

假设 RAG 回答错了。最终回答错时,人们常先断定模型弱。但实际上,需要区分系统一开始就检索了错误文档,还是找到了正确文档,但回答在摘要过程中误读了它们。没有 trace 时,只剩最终回答,检索失败和生成失败会看起来像一团。例如,如果最新通知从未出现在检索候选中,这是检索问题。如果最新通知被检索到了,但回答遗漏了例外条款,这是读取问题。

如果这两者不分开,重复失败就无法告诉你应该修检索还是修 prompt。这里的变化是从只问最终回答是否错了,转向拆解哪个步骤错了。失败处理结构会把检索文档列表、选中段落和最终回答一起保留,方便重新查看漂移发生在哪里。因此,这个案例中要确认的结果不只是回答错了,而是能否说明实际漂移的是哪一步:检索还是解释。

首先检查的点 如果这里失败,首先怀疑什么 下一步行动
检索候选列表 检索漏掉、缺少最新文档 重新搜索、调整查询、fallback 回答
选中段落 相关段落选择错误 审查选择规则、重新附上依据
最终摘要 读取或摘要解释错误 调整 prompt、人工审查、修订回答

案例 2. Agent 工具调用失败

假设 agent 调用文件读取工具并收到权限错误。人工工作时,人们通常会停下并寻找另一条路径。但在自动结构中,如果系统假装不知道失败并继续下一步,就可能生成一个好像看过内容的回答。例如,它没能读取配置文件,却基于已经检查配置这个前提提出补丁,一个错误会立刻变成虚假的工作记录。

如果系统接着进入实际修改,可能会基于错误前提进一步损坏仓库。这个案例中的问题不只是工具错误,而是失败后仍继续的执行策略。这里的变化是从只看发生了错误,转向检查路径是否在错误之后实际变成 stop、retry 或等待 approval。失败处理结构会预先定义在哪里停止、重试几次、何时请求人工批准。因此,这个案例中要确认的结果,是权限错误之后路径是否转为 stop、retry 或人工 approval,而不是继续进入虚假成功流程。

失败信号 如果继续执行会怎样 失败处理中首先应分出的路线
权限错误 假设未读文件已被读取 stop 或 approval
临时 timeout 可能把正常资源当成永久失败 有界 retry,然后 fallback
文件缺失或路径错误 在错误目标上继续后续工作 重新检查路径,然后 stop 或重新搜索

案例 3. 慢响应

假设回答是正确的,但 20 秒后才到达。如果内容正确,人们起初可能觉得它成功了。但技术上,即使正确回答也可能在用户刷新页面或离开服务之后才到达。对于长文档分析请求,等待可能可以接受。对于简单政策检查问题,20 秒已经接近失败。

在运营中,人必须关注的失败不只是内容错误,还包括用户无法等待的速度。如果响应太慢,即使正确回答也可能在被阅读前就被抛弃。这里的变化是从只问内容是否正确,转向也问它是否在可用时间内到达。所需响应可能不是更好的文字,而是 timeout 阈值、先给短答、稍后给详细答之类 fallback 设计。因此,这个案例中要确认的结果,是用户是否在可等待时间内收到最低限度回答,这要与最终正确性分开。

三个案例可以按响应流程这样归类。

情况 首先要保留的观察记录 下一步修什么
RAG 回答失败 检索候选、选中段落、最终回答 检索、读取、prompt 中哪一步错了
Agent 工具调用失败 错误类型、重试次数、approval 状态 停止规则、重试策略、权限处理
慢响应 各步骤延迟、fallback 使用 Timeout 标准、先给短答、轻量路径

失败路线必须分开的场景

初读失败处理时最容易漏掉的是:看到发生了问题后立刻跳到一个解决方案。在真实运营中,首先要拆开这个失败是否应该再试一次、降级到更简单路径、立即停止,还是交给人。转成实用问题如下。

如果出现这种怀疑 首先要问的问题
再试一次会不会成功? 这是临时错误还是结构性错误?
当前路径太重或被阻塞。 是否有更简单的 fallback 回答或缓存路径?
继续看起来更危险。 是否应该在这里停止,并转入人工 approval 或 review?

首先要学会的标准很简单。失败处理不是一句修复错误,而是一个分支任务:在 retry、fallback、stop、approval 中选择现在最安全的路线。

练习和例子

这个例子的目标,是看到失败处理不会在发生了错误这里结束。Retry、fallback、stop 分支会实际分开,每个案例会通向不同的下一步运营动作。我们不只看一个失败案例,而是把系统失败和模型失败一起比较,看看什么时候 retry 合适,什么时候 fallback、human review 或 model repair 合适。

下面的例子使用多个失败情况、重试限制、缓存可用性、人工审查可用性和 grounding 文档可用性。Timeout 可能发生在检索中,权限错误可能发生在工具调用中,幻觉或格式不匹配可能出现在回答过程中。

现在再加一层:LLM grader 视角。LLM grader 读取失败观察记录,只建议 suggested_family、suggested_risk 和 reason。但 LLM 不直接做最终恢复决策。Policy code 会重新检查 trace_saved、retry_count、cached_summary_available、approval_required、grounding_available 等明确运营信号,然后关闭最终 decision。

输出中,我们检查 LLM grader 建议的失败 family 和 risk、policy gate 做出的最终响应决策、retry 和 fallback 状态、human-review routing 状态、model-fix task 和 system-recovery task 摘要,以及运营者应立即采取的下一步行动。代码中要检查的关键是,LLM 可以组织失败观察,但 approval、stop、recovery route 这样的运营决策仍然必须由显式 policy 关闭。

这个例子的响应标准是:

检查项 为什么需要
LLM grader suggestion 从观察记录中先草拟失败 family 和 risk
Failure family 避免把系统失败和模型失败混在运营者记录中
Response decision 记录将使用 retry、fallback、approval、stop、human review、model fix 中哪条路径
Next action 让运营者立刻知道下一步做什么
Trace saved state 因为失败原因必须之后可复现、可分析
User impact 区分必须立刻保护用户体验的失败

下面的例子使用失败案例 CSV p6_17_2_failure_cases.csv。一行表示一个失败场景。failure_family 是运营者读取 trace 后首先留下的观察分类,error 包含首先观察到的失败信号,例如 timeout、permission error、hallucination 或 format mismatch。retry_count、max_retries、cached_summary_available、approval_required、trace_saved 等列是控制变量,会改变同一错误在 retry、fallback、approval、stop 之间走向哪条路线。

默认情况下,代码使用可复现的本地 grader。如果本地 Ollama 模型已经准备好,可以设置 P6_17_2_USE_OLLAMA=1 和 OLLAMA_MODEL,在同一位置调用真实 LLM grader。输出字段 grader_source 会区分建议来自可复现 fallback grader,还是实际 Ollama 调用。Prompt 使用英文,以便跨翻译版本保持相同执行标准。

from collections import Counter
from csv import DictReader
import json
import os
from pathlib import Path
from pprint import pprint
from urllib import request

CSV_PATH = Path(__file__).with_name("p6_17_2_failure_cases.csv")
OLLAMA_URL = os.environ.get("OLLAMA_URL", "http://localhost:11434/api/generate")
OLLAMA_MODEL = os.environ.get("OLLAMA_MODEL", "llama3.2:1b")
USE_OLLAMA = os.environ.get("P6_17_2_USE_OLLAMA") == "1"
GRADER_RUBRIC = """
Grade the failure trace, but do not choose the final recovery route.
- suggested_family is "system" when the failure is in retrieval, tools,
  permissions, timeout, cache, queue, API, or trace capture.
- suggested_family is "model" when the failure is in generation, grounding,
  citation, tone, format, or unsupported content.
- suggested_risk is "high" when the trace is missing, evidence is missing,
  approval is required, or unsafe output may reach a user.
- suggested_risk is "medium" when service can continue only after retry,
  fallback, parser repair, or human review.
- suggested_risk is "low" only when the failure is minor and already contained.

Examples:
- error=timeout at step=search_docs -> system, medium
- error=permission_error at step=send_email -> system, high
- error=risky_action at step=update_database -> system, high
- error=hallucination at step=answer_generation -> model, high
- error=format_mismatch at step=answer_generation -> model, medium
"""

SELECTED_CASES = [
    "timeout_retry_search",
    "timeout_fallback_search",
    "permission_approval_send",
    "risky_action_stop_no_reviewer",
    "hallucination_review_grounded",
    "format_fix_parser",
]


def parse_bool(value):
    return value == "yes"


def load_failure_cases(csv_path=CSV_PATH):
    with csv_path.open(newline="", encoding="utf-8") as file:
        rows = list(DictReader(file))

    cases = []
    for row in rows:
        cases.append(
            {
                "case_id": row["case_id"],
                "case_name": row["case_name"],
                "failure_family": row["failure_family"],
                "step": row["step"],
                "error": row["error"],
                "retry_count": int(row["retry_count"]),
                "max_retries": int(row["max_retries"]),
                "cached_summary_available": parse_bool(
                    row["cached_summary_available"]
                ),
                "trace_saved": parse_bool(row["trace_saved"]),
                "human_review_available": parse_bool(row["human_review_available"]),
                "grounding_available": parse_bool(row["grounding_available"]),
                "approval_required": parse_bool(row["approval_required"]),
            }
        )
    return cases


def build_failure_observation(case):
    return (
        f"step={case['step']}; error={case['error']}; "
        f"retry_count={case['retry_count']}; max_retries={case['max_retries']}; "
        f"cached_summary_available={case['cached_summary_available']}; "
        f"trace_saved={case['trace_saved']}; "
        f"human_review_available={case['human_review_available']}; "
        f"grounding_available={case['grounding_available']}; "
        f"approval_required={case['approval_required']}"
    )


def fallback_grade_failure_trace(case):
    if case["error"] in {
        "hallucination",
        "wrong_citation",
        "grounding_gap",
        "format_mismatch",
        "overlong_answer",
        "tone_mismatch",
        "ambiguous_answer",
        "unverified_number",
        "unsafe_claim",
        "unsupported_instruction",
    }:
        suggested_family = "model"
    else:
        suggested_family = "system"

    if not case["trace_saved"] or case["approval_required"]:
        suggested_risk = "high"
    elif case["error"] in {"hallucination", "wrong_citation", "unsafe_claim"}:
        suggested_risk = "high"
    elif case["error"] in {"timeout", "rate_limit", "format_mismatch"}:
        suggested_risk = "medium"
    else:
        suggested_risk = "medium"

    reason_by_error = {
        "timeout": "Timeout belongs to the service path, so retry budget and fallback state must be checked next.",
        "rate_limit": "Rate limit is a system capacity signal, so retry and fallback policy should be checked next.",
        "permission_error": "Permission failure crosses an execution boundary, so approval or stop policy must be checked next.",
        "risky_action": "Risky external action needs an approval boundary before any execution continues.",
        "hallucination": "Hallucination is a model output risk, so grounding and human review must be checked next.",
        "wrong_citation": "Wrong citation is a model grounding risk, so evidence comparison must be checked next.",
        "format_mismatch": "Format mismatch blocks delivery or parsing, so prompt and schema repair must be checked next.",
    }
    return {
        "grader_source": "fallback",
        "suggested_family": suggested_family,
        "suggested_risk": suggested_risk,
        "reason": reason_by_error.get(
            case["error"],
            f"The observed {case['error']} should be graded before the policy gate chooses a recovery route.",
        ),
    }


def call_ollama_grader(case):
    prompt = f"""
You are an LLM grader for AI service failure traces.
Return only compact JSON with these keys:
suggested_family: "system" or "model"
suggested_risk: "low", "medium", or "high"
reason: one short sentence

Rubric:
{GRADER_RUBRIC}

Failure observation:
{build_failure_observation(case)}
"""
    payload = {
        "model": OLLAMA_MODEL,
        "prompt": prompt,
        "stream": False,
        "format": "json",
        "options": {"temperature": 0},
    }
    data = json.dumps(payload).encode("utf-8")
    req = request.Request(
        OLLAMA_URL,
        data=data,
        headers={"Content-Type": "application/json"},
        method="POST",
    )
    with request.urlopen(req, timeout=20) as response:
        body = json.loads(response.read().decode("utf-8"))
    return json.loads(body["response"])


def llm_grade_failure_trace(case):
    if USE_OLLAMA:
        try:
            grade = call_ollama_grader(case)
            return {
                "grader_source": "ollama",
                "suggested_family": grade["suggested_family"],
                "suggested_risk": grade["suggested_risk"],
                "reason": grade["reason"],
            }
        except Exception:
            pass
    return fallback_grade_failure_trace(case)


def decide_recovery(case):
    if not case["trace_saved"]:
        return {
            "decision": "stop_and_escalate",
            "decision_reason": "trace_missing",
            "next_action": "save_trace_before_continuing",
            "user_impact": "cannot_reproduce_failure",
        }
    if case["approval_required"]:
        if case["human_review_available"]:
            return {
                "decision": "approval",
                "decision_reason": "approval_required",
                "next_action": "request_human_approval",
                "user_impact": "wait_for_safe_execution",
            }
        return {
            "decision": "stop_and_escalate",
            "decision_reason": "approval_required_but_unavailable",
            "next_action": "stop_without_execution",
            "user_impact": "unsafe_to_continue",
        }
    if case["error"] in {"permission_error", "tool_not_found", "unsafe_claim"}:
        return {
            "decision": "stop_and_escalate",
            "decision_reason": case["error"],
            "next_action": "ask_human_review",
            "user_impact": "unsafe_or_impossible_to_continue",
        }
    if case["error"] in {"hallucination", "wrong_citation", "grounding_gap"}:
        if case["grounding_available"] and case["human_review_available"]:
            return {
                "decision": "human_review",
                "decision_reason": "compare_answer_with_grounding",
                "next_action": "compare_with_grounding",
                "user_impact": "potential_wrong_answer",
            }
        return {
            "decision": "stop_and_escalate",
            "decision_reason": "grounding_or_review_missing",
            "next_action": "stop_until_evidence_is_available",
            "user_impact": "answer_blocked",
        }
    if case["error"] in {
        "format_mismatch",
        "overlong_answer",
        "tone_mismatch",
    }:
        return {
            "decision": "model_fix",
            "decision_reason": case["error"],
            "next_action": "tighten_prompt_parser_or_schema",
            "user_impact": "delivery_blocked_until_format_fixed",
        }
    if case["error"] in {"ambiguous_answer", "unverified_number", "cache_stale"}:
        return {
            "decision": "human_review",
            "decision_reason": case["error"],
            "next_action": "review_before_user_delivery",
            "user_impact": "needs_review_before_release",
        }
    if case["retry_count"] < case["max_retries"]:
        return {
            "decision": "retry",
            "decision_reason": "retry_budget_remaining",
            "next_action": f"retry_{case['step']}",
            "user_impact": "temporary_delay",
        }
    if case["cached_summary_available"]:
        return {
            "decision": "fallback",
            "decision_reason": "retry_budget_exhausted_with_cache",
            "next_action": "use_cached_or_simplified_path",
            "user_impact": "reduced_freshness_but_service_continues",
        }
    return {
        "decision": "stop_and_escalate",
        "decision_reason": "no_recovery_path_left",
        "next_action": "ask_human_review",
        "user_impact": "service_stopped_for_this_request",
    }


def evaluate_case(case):
    # The LLM grader reads the trace and produces bounded tags. The policy
    # gate below still makes the final recovery decision from explicit signals.
    grade = llm_grade_failure_trace(case)
    recovery = decide_recovery(case)
    return {
        "case_name": case["case_name"],
        "failure_family": case["failure_family"],
        **grade,
        "step": case["step"],
        "error": case["error"],
        "retry_count": case["retry_count"],
        "max_retries": case["max_retries"],
        "cached_summary_available": case["cached_summary_available"],
        "approval_required": case["approval_required"],
        "trace_saved": case["trace_saved"],
        **recovery,
    }


def load_reports():
    return [evaluate_case(case) for case in load_failure_cases()]


def summarize_reports(reports):
    decision_counts = Counter(report["decision"] for report in reports)
    family_counts = Counter(report["failure_family"] for report in reports)
    return {
        "case_count": len(reports),
        "system_failure_count": family_counts["system"],
        "model_failure_count": family_counts["model"],
        "retry_count": decision_counts["retry"],
        "fallback_count": decision_counts["fallback"],
        "approval_count": decision_counts["approval"],
        "human_review_count": decision_counts["human_review"],
        "stop_and_escalate_count": decision_counts["stop_and_escalate"],
        "model_fix_count": decision_counts["model_fix"],
    }


def compact_report(report):
    return {
        "case_name": report["case_name"],
        "failure_family": report["failure_family"],
        "grader_source": report["grader_source"],
        "suggested_family": report["suggested_family"],
        "suggested_risk": report["suggested_risk"],
        "reason": report["reason"],
        "step": report["step"],
        "error": report["error"],
        "decision": report["decision"],
        "decision_reason": report["decision_reason"],
        "next_action": report["next_action"],
        "user_impact": report["user_impact"],
    }


def main():
    reports = load_reports()
    selected_reports = [
        compact_report(report)
        for report in reports
        if report["case_name"] in SELECTED_CASES
    ]

    print("[summary]")
    pprint(summarize_reports(reports))
    print("[selected_cases]")
    for report in selected_reports:
        pprint(report)


if __name__ == "__main__":
    main()

示例运行可以这样读取。

[summary]
{'approval_count': 2,
 'case_count': 36,
 'fallback_count': 4,
 'human_review_count': 6,
 'model_failure_count': 15,
 'model_fix_count': 5,
 'retry_count': 6,
 'stop_and_escalate_count': 13,
 'system_failure_count': 21}
[selected_cases]
{'case_name': 'timeout_retry_search',
 'decision': 'retry',
 'decision_reason': 'retry_budget_remaining',
 'error': 'timeout',
 'failure_family': 'system',
 'grader_source': 'fallback',
 'next_action': 'retry_search_docs',
 'reason': 'Timeout belongs to the service path, so retry budget and fallback '
           'state must be checked next.',
 'step': 'search_docs',
 'suggested_family': 'system',
 'suggested_risk': 'medium',
 'user_impact': 'temporary_delay'}
{'case_name': 'timeout_fallback_search',
 'decision': 'fallback',
 'decision_reason': 'retry_budget_exhausted_with_cache',
 'error': 'timeout',
 'failure_family': 'system',
 'grader_source': 'fallback',
 'next_action': 'use_cached_or_simplified_path',
 'reason': 'Timeout belongs to the service path, so retry budget and fallback '
           'state must be checked next.',
 'step': 'search_docs',
 'suggested_family': 'system',
 'suggested_risk': 'medium',
 'user_impact': 'reduced_freshness_but_service_continues'}
{'case_name': 'permission_approval_send',
 'decision': 'approval',
 'decision_reason': 'approval_required',
 'error': 'permission_error',
 'failure_family': 'system',
 'grader_source': 'fallback',
 'next_action': 'request_human_approval',
 'reason': 'Permission failure crosses an execution boundary, so approval or '
           'stop policy must be checked next.',
 'step': 'send_email',
 'suggested_family': 'system',
 'suggested_risk': 'high',
 'user_impact': 'wait_for_safe_execution'}
{'case_name': 'risky_action_stop_no_reviewer',
 'decision': 'stop_and_escalate',
 'decision_reason': 'approval_required_but_unavailable',
 'error': 'risky_action',
 'failure_family': 'system',
 'grader_source': 'fallback',
 'next_action': 'stop_without_execution',
 'reason': 'Risky external action needs an approval boundary before any '
           'execution continues.',
 'step': 'update_database',
 'suggested_family': 'system',
 'suggested_risk': 'high',
 'user_impact': 'unsafe_to_continue'}
{'case_name': 'hallucination_review_grounded',
 'decision': 'human_review',
 'decision_reason': 'compare_answer_with_grounding',
 'error': 'hallucination',
 'failure_family': 'model',
 'grader_source': 'fallback',
 'next_action': 'compare_with_grounding',
 'reason': 'Hallucination is a model output risk, so grounding and human '
           'review must be checked next.',
 'step': 'answer_generation',
 'suggested_family': 'model',
 'suggested_risk': 'high',
 'user_impact': 'potential_wrong_answer'}
{'case_name': 'format_fix_parser',
 'decision': 'model_fix',
 'decision_reason': 'format_mismatch',
 'error': 'format_mismatch',
 'failure_family': 'model',
 'grader_source': 'fallback',
 'next_action': 'tighten_prompt_parser_or_schema',
 'reason': 'Format mismatch blocks delivery or parsing, so prompt and schema '
           'repair must be checked next.',
 'step': 'answer_generation',
 'suggested_family': 'model',
 'suggested_risk': 'medium',
 'user_impact': 'delivery_blocked_until_format_fixed'}

按条件分开的失败恢复路径

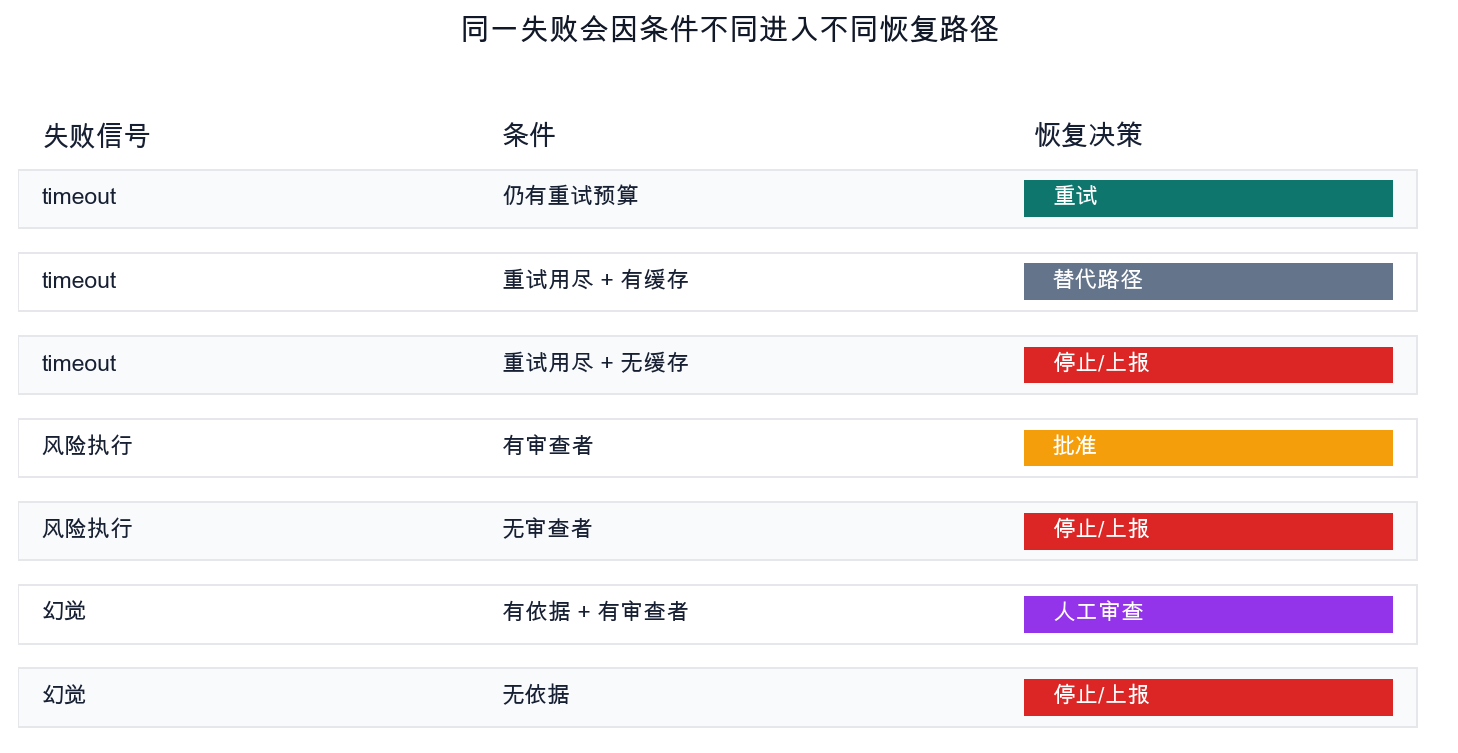
这张图中首先要看的,是 LLM grader 的建议和最终恢复决策不是同一步。如果 grader_source 是 fallback,建议来自可复现本地 grader。如果它是 ollama,建议来自实际 LLM 调用。无论哪种情况,grader 都可以读取观察记录,把 timeout 标记为 system family failure,把 hallucination 标记为 model family failure。但 policy code 仍然必须检查重试预算和缓存状态,才能决定把 timeout 送到 retry 还是 fallback。风险动作如果有审查者,可以等待 approval;如果没有审查者,就必须停止,而不是自动执行。看起来像 hallucination 的模型失败,如果有 grounding 和审查者,可以进入人工审查;如果缺少依据,就必须阻断回答。

因此,这张图不是单纯统计恢复决策总数的图。它显示的是从 LLM grader tag -> condition check -> recovery route 的分支直觉。在运营中,重要的不是发生了多少 timeout,而是把同一个 timeout 分成 retry、fallback 或 stop 的输入条件是否被记录下来。

同一结果可以按失败路线简要归类如下。

运行名 首先看到的失败性质 为什么这条路线合适 后续行动
timeout_retry_search 临时系统延迟 仍有重试次数,同一检索步骤可以再试一次。 再重试同一检索
timeout_fallback_search 服务可用较低新鲜度继续的延迟 重试次数耗尽,但缓存或更简单路径仍在,所以可以 fallback 而不是完全停止。 通过缓存或更简单路径绕行
permission_approval_send 需要人工批准的权限边界 发送邮件这类有外部影响的任务,比自动执行更适合放在 approval 后面。 请求人工批准
risky_action_stop_no_reviewer 因没有批准者而必须停止的风险执行 执行有风险且没有审查者时,没有继续的依据。 不执行并停止
hallucination_review_grounded 需要先做依据比较的模型失败 这不是检索 retry 问题。必须比较现有依据和回答的事实性。 按 grounding 文档人工审查
format_fix_parser 需要先修复输出格式的模型失败 交付格式和 parser 兼容性先坏了,内容交付前必须修复。 调整 prompt、parser 和 schema

这个例子中要确认的结果是,失败发生时,响应不会简单停止。Retry、替代路径、approval wait、human-review routing、model repair 等分支被分别设计。尤其是,即使同为 timeout,也会根据 retry 可用性和缓存存在与否走不同路线。权限或风险执行这类更适合 approval 或立即 stop 而不是 retry 的错误,以及 hallucination 这类需要先比较依据的错误,也必须分开。

这里应该留下的记录也会分开。如果使用了 LLM grader,要记录哪个 grader 建议了 family 和 risk,以及理由是什么。如果失败进入 retry,要记录重试次数和各步骤延迟。如果进入 fallback,要记录使用了哪条简化路径。如果进入 approval 或 stop,要记录权限状态、审查者可用性和停止理由。如果进入人工审查或模型修复,要把最终回答、grounding 文档、格式错误和修复任务一起保留。

读者可以直接尝试这些调整:

  • 减少 max_retries,观察 fallback 或 stop 是否比 retry 更早打开。
  • 修改 cached_summary_available,比较同一个 timeout 走向哪条路线。
  • 修改 approval_required 和 human_review_available,观察风险执行如何在 approval wait 和 stop 之间分开。
  • 添加 rate_limit、tool_not_found、wrong_citation 等其他失败类型,比较它们是系统恢复还是模型修复。

压缩成一句话,运营失败处理不是捕捉错误。它是分类失败、选择合适的恢复路线和下一步行动,并保留 trace 以便系统再次改进。

更重要的是,是否产生了好回答?和失败时在哪里停止、怎样恢复?不是同一个问题。因此,失败处理不应该被读成事后异常处理附录,而应该被读成在服务结构内定义恢复路线和下一步行动的运营判断。

这条恢复路线重要,是因为它:

  • 把 P6-18.1 的服务运营约束从我们应该观察什么?转为失败发生时应该追踪哪里?
  • 从运营视角重新连接 Part 6 的 prompting、RAG、tool use、AI agents、evaluation
  • 让综合 mini-practice 包含失败处理
  • 明确使用 AI和运营 AI 服务之间的差异

检查清单

  • 你应该能够把失败处理说明成分类失败并选择恢复路线的运营结构,而不是错误消息处理。
  • 你应该能够说出,必须区分模型失败和系统失败,这样即使症状相似,也能路由到不同动作。
  • 你应该能够把本节的判断和记录连接到一次真实请求的流程中,而不是把它当成与运营分离的新主题。

参考资料