P6-19.1 连接问题、依据、回答和记录的小型生成式 AI 功能
Section ID:
P6-19.1Version:v2026.07.31
小型生成式 AI 功能要把 question、evidence、draft_answer、tool_need、evaluation_note、run_record 作为一个请求单位来 归为一组。这样 prompt、检索、工具使用、评估就不是各自分离的概念,而会连接成一个功能 流程。
即使你能分别解释 LLM、RAG、工具使用、AI agents、evaluation 和失败处理,实际功能设计也还没有结束。现在的问题会集中到:这些概念如何在一个真实请求里一起移动。
小型生成式 AI 功能更安全的理解方式,是把它看成一个流程:解释请求 -> 检索所需依据或选择工具 -> 生成模型响应 -> 判断状态 -> 记录。这里的判断状态也包括在实际请求中留下哪些状态值,用于 automatic gate、human review、retry、fallback、stop、approval 等决策。
通过一个请求重新连接全部内容
核心问题是:
- 怎样把 Part 6 的概念重新连接成一个请求流程?
- 什么时候 prompt 本身就够,什么时候应该接 retrieval 或 tool?
- 一个小功能至少应该留下什么记录?
前面已经分别学习了检索和依据连接、工具选择和执行连接、执行记录和可复现性、运营约束、失败处理。这里要把这些片段重新连接成一个请求实际关闭的结构。
重要变化是从选择失败路线转向把包含这个判断在内的一个请求结构绑在一起。你需要一个标准,在请求层面把问题、依据、执行、评估和记录分组。只有这样,请求结果才能作为 answer draft possible、evidence reinforcement needed、state lookup needed、human review needed 等状态值留下来。
Evaluation 和 operation 中已经做出的判断,会这样下沉到请求结构中。
| 已经做出的判断 | 必须进入请求流程的内容 | 要保留为请求执行记录的内容 |
|---|---|---|
| Automatic gate 和 human review 结果 | 这个回答是立即接受,还是转入追加检查 | 回答状态、是否需要人工审查、审查摘要 |
| Retry、fallback、stop、approval 判断 | 失败发生时实际走了哪条路线 | 下一步行动、incident 记录、执行说明 |
| Retrieval、tool、state acquisition 结果 | 回答基于哪些依据和执行 | 依据文档列表、选择理由、执行记录 |
更安全的做法,是观察同一个问题什么时候在请求内部变成 answer draft、human review、state lookup needed 或 insufficient evidence。请求流程整合的核心不是贴上很多组件名称,而是让 evaluation 和 operation 判断变成实际请求状态值的时刻可见。
例如,即使在同一个 HR assistant 中,请求也会这样分开。
| 同一请求流程中首先分开的状态 | 常见问题类型 | 为什么这个状态应留下 |
|---|---|---|
| 可以立即生成回答草稿 | 润色句子、改变格式,并能用当前输入关闭的请求 | 避免用不必要的检索或工具把流程变重 |
| 需要检查依据文档 | 关于当前规则、政策、流程的问题 | 区分能写出回答和依据是否足够 |
| 需要查询当前状态 | 剩余休假、审批状态、实际日程查询 | 避免把政策说明和当前值回答混在同一步 |
| 人工审查或依据不足状态 | 例外条款很多或文档不足的问题 | 避免用自然的一般回答掩盖问题,并保留运营路线 |
所以,把请求流程绑在一起,不是简单画出问题 -> 回答。它意味着在同一结构中保留这个请求到目前为止关闭到了什么程度。有了这个标准,请求执行记录就不只是日志,而是区分 answerable、evidence reinforcement needed、state lookup needed、human review needed 的运营说明。
区分 Prompt、Retrieval 和 Tool-Use 请求流程
- 你可以把小型生成式 AI 功能解释成一个请求流程。
- 你可以区分只靠 prompt 就能处理的工作,以及需要 retrieval 或 tools 的工作。
- 你可以用一句设计句连接 input、evidence、output、evaluation 和 record。
- 你能更容易读出最小实现中需要的请求执行记录。
第一层分流可以这样整理。
| 首先看到的请求状态 | 首先要问的问题 | 为什么这个问题先来 |
|---|---|---|
| 看起来可以只根据输入写出回答 | 这个请求是否围绕 prompt 就能关闭? | 如果所需信息已经在输入里,不必要的检索或执行不应让流程更重。 |
| 可以写出回答,但当前规则或文档依据不确定 | 是否应该先检查依据文档? | 自然的一般建议和基于依据的回答,不应混成同一状态。 |
| 规则说明不够,还需要当前值或实际状态 | 是否需要 state lookup 或 tool use,而不是先 retrieval? | 文档依据问题和当前状态问题必须分开,才能看出请求流程在哪里改变。 |
| 因为例外很多,给出确定答案有风险 | 是否应保持为 human review、follow-up question 或 insufficient-evidence state? | 如果把回答生成和请求关闭当成同一件事,应该暂留的请求很容易被强行完成。 |
带着这张表,后面的内容会更容易被读成判断同一个问题先进入哪个请求状态的标准,而不是步骤列表。
应该用哪个功能作为例子?
以基于内部文档的休假政策助手为例。当用户问:本月入职的员工可以马上使用夏季休假吗?,它看起来像简单 Q&A。实际上,助手必须检索当前政策文档,请求之后还可能扩展到我还剩多少休假?这样的系统查询。助手还必须记录哪份文档被用作依据,或没有找到文档,这样功能之后才能修复。这让这个例子适合把 prompting、retrieval、tool use、evaluation 和 records 放进一个请求中连接起来。
选择这个案例,是因为只靠 prompt 关闭的问题、需要 retrieval 的问题、需要 current-state lookup 的问题可以在同一流程中并排比较。它也自然暴露依据文档选择、失败记录、人工审查路由等运营判断。重点不是详细解释 HR 领域,而是展示一个小型生成式 AI 功能需要什么结构。
画成一个请求流程
上面问题的最简单流程是:
- 读取问题类型。
- 判断是否需要当前政策。
- 如果需要,检索相关文档。
- 生成回答并附上依据。
- 如果内容模糊或缺失,路由到人工确认或追问。
即使只有这五步,也已经形成了不同于简单 prompt 示例的结构。
但要把请求流程读成可运营结构,还需要再加一步。
- 记录回答应立即接受,还是路由到依据强化或人工审查。
换句话说,说一个请求已经关闭,并不只表示生成了一个回答句子。它还表示回答停留在哪种状态已经被决定。
流程可以再简化如下。
flowchart LR
  A["用户问题"]
  B["分类请求"]
  C["仅 prompt / 检索 / 工具"]
  D["用依据或状态回答"]
  E["记录并评估"]

  A --> B
  B --> C
  C --> D
  D --> E
这张图的重点是,即使是小功能,也应该被读成问题分类、依据或状态获取、回答、记录的流程。
Part 6 后半的主线在这里收束:把好回答判断和失败时选择运营路径绑进连接问题、依据/状态、回答、评估和记录的一个请求流程。
什么时候只靠 Prompt 就够
下面这些情况通常只靠 prompt 就够。
- 润色句子
- 改变摘要格式
- 在已经提供的材料内回答
- 写创意草稿
在这些情况下,模型可以只使用当前输入里的信息完成任务。
例如:
- 把邮件句子改得更礼貌
- 把已经粘贴的会议记录总结成三句话
这些任务可以不从 retrieval 或 tool calls 开始。
什么时候需要 Retrieval
出现下面这些条件时,需要 retrieval。
- 当前规则很重要。
- 回答必须展示依据文档。
- 长内部文档不能全部直接放进 prompt。
- 当前仓库文档比模型内部记忆更可靠。
休假政策助手属于这一类。实际当前公司政策比听起来正确的一般回答更重要。
在这些情况下,问题不应被读成用更好的语气写作,而应读成准确找到当前文档,并基于依据回答。
模型写出好回答的能力和系统带来正确依据的能力不是同一个问题。
什么时候需要 Tool Use
Retrieval 本身并不总是够。
例如,如果用户问:
- 剩余休假天数、
- 审批状态,或
- 创建申请表,
文档检索就不够了。
在这些情况下,系统需要一个工具,从真实系统读取值或执行动作。
Retrieval 更接近检查规则是什么,tool use 更接近处理当前状态中应该执行或查询什么。
即使是小功能也需要最小评估
即使是小功能,只看一个回答也很难改进。
至少保留下面四类记录很有用。
| 记录项 | 为什么需要 |
|---|---|
| 用户问题 | 保留处理了什么请求 |
| 是否使用 retrieval 或 tool use | 之后区分失败原因 |
| 最终回答 | 重新查看输出质量 |
| 依据或失败理由 | 区分错误回答和系统问题 |
这四项是把 Part 6 后半的 evaluation 和 failure-handling 说明带入实际设计的最小装置。
| 设计句中的标准 | 最小要保留的记录 | 可以扩展成的更大 artifact |
|---|---|---|
| 问题和 retrieval 路径 | 按问题的请求执行记录、依据文档列表、文档分数 | Search log、选择理由、执行记录 |
| 回答是否接受以及是否需要人工审查 | Human-review-needed flag、执行状态 | 审查摘要、回答状态、incident 记录 |
| 多个问题之后的回顾 | 整体摘要 | 改进计划、Part 7 项目回顾 |
关键不是把生成式 AI 功能画成一次模型调用。必须读取请求,获取所需依据或状态,并把回答和记录看成一个结构。
案例和例子
prompt-centered、retrieval combined、tool use combined 之间的区分,可以重新连接到功能场景中。
这些案例的重点不是使用生成式 AI,而是为了关闭这个问题,必须附上哪种结构。
案例 1. 润色句子
想象一个把输入通知句子改得更礼貌的功能。很容易认为生成式 AI 功能总该包含 retrieval 或 tools,但在这个案例中首先要检查的是当前句子本身,外部文档或实时系统值可能不需要。例如,把请重新提交文件说得更柔和,不是寻找最新政策的问题,而是如何表达已经给出的句子的问题。
如果在这里附上 retrieval,无关政策短语可能混入回答,让结果比原句更长、更僵硬。因此,核心结构更接近带有好指令和示例的 prompt。如果要修改的目标已经在输入里,prompt-centered 结构可能就够。这里的变化是从问生成式 AI 是否也需要 retrieval?,转向问工作是否只用当前输入就能关闭?。因此,这个案例中要确认的结果,是目标表达转换是否能在没有 retrieval 的情况下,充分从输入句子本身关闭。
在这个场景中,首先问所需信息是否已经存在很重要。给只需要表达转换的请求添加 retrieval,会在寻找不必要依据时让回答发散。因此,设计小型生成式 AI 功能时,先移除不必要组件,比附加更多组件更重要。
| 关闭问题时已经存在的内容 | 不需要附上的东西 | 如果不必要地附上会怎样 |
|---|---|---|
| 要修改的原句 | retrieval、tool use | 无关规则或背景混入,让回答变长 |
| 期望语气或格式指令 | 外部状态查询 | 搜索结果整理变得比表达转换还大 |
| 一两个示例 | 系统执行步骤 | 简单句子编辑变成过度 workflow |
案例 2. 内部政策指引
考虑一个内部政策指引聊天机器人。看到休假应该提前几天申请?或育儿假申请顺序是什么?这类问题时,人们可能觉得模型直接写回答就行。但对这些问题,准确带来最新政策文档比语气更优先。例如,上季度政策可能写的是提前 3 天,最新政策已经改成提前 5 个工作日。即使用写得很好的 prompt,模型内部记忆也无法保证当前标准。
因为政策会变化,找到最新文档并附上依据句子,比自然回答更重要。这个案例的核心结构更接近检索最新段落,并基于依据组织回答。这里的变化是从问它能不能马上写好答案?,转向问它是否真的带来了最新政策依据?。因此,这个案例中要确认的结果,是附上最新段落后,回答在依据准确性上更稳定,而不只是语气更好。
在这个案例中,需要快速读出输入本身不够这个信号。对于政策问题,按当前标准是否正确?比句子是否自然更重要。即使只提高模型写作能力,而不附上当前文档,核心失败仍然存在。因此,retrieval 不是可选装饰,而是关闭问题所需的结构。
| 问题需要什么 | 只靠 prompt 仍然留下的限制 | 为什么必须先 retrieval |
|---|---|---|
| 当前政策数字和条件 | 内部记忆可能过时 | 必须实际附上最新段落和依据句 |
| 带来源的说明 | 回答可能自然但没有依据 | 选中文档和依据句可以一起保留 |
| 经常变化政策的指引 | 只调语气不能减少错误 | 文档更新可以直接反映到回答流程 |
案例 3. 剩余休假查询
剩余休假查询更进一步。政策文档可以解释年假如何计算,但不能回答我的账户实际还剩多少天。很容易觉得找到政策后答案就完整了。但要关闭这个请求,必须立即区分:不仅需要规则,还需要 HR 系统值。
例如,即使知道年假公式,当前余额还要反映已经使用的天数和待审批休假,只能通过查询系统知道。这个功能不能只靠 retrieval 关闭。必须附上读取真实状态的 tool use。这里的变化是从问能不能解释规则?,转向问能不能实际查到当前状态值并用它关闭回答?。因此,这个案例中要确认的结果是,一个不能只靠政策说明关闭的问题,是否在附上真实系统查询之后,才作为当前状态回答关闭。
三个案例可以缩减成下面的设计判断。
| 问题形式 | 首先检查什么 | 如果附错结构会怎样 |
|---|---|---|
| 句子表达修订 | 所需信息是否已经在输入里? | 不必要 retrieval 让回答发散 |
| 规则说明 | 是否需要当前依据文档? | 回答依赖过时标准或一般说法 |
| 当前状态查询 | 是否需要系统值而不是文档? | 解释了规则,却不能回答实际状态 |
同样想法可以再画成设计选择流程。
flowchart TD
  A["问题到达"]
  B{"当前输入是否足够?"}
  C{"是否需要最新文档依据?"}
  D{"是否需要实时系统状态?"}
  H{"确定回答是否有风险或依据不足?"}
  E["prompt-centered 流程"]
  F["prompt + retrieval 流程"]
  G["prompt + tool 流程"]
  I["人工审查或追问"]
  J["回答和运行记录"]

  A --> B
  B -->|是| E
  B -->|否| C
  C -->|是| F
  C -->|否| D
  D -->|是| G
  D -->|否| E
  E --> H
  F --> H
  G --> H
  H -->|是| I
  H -->|否| J
  I --> J
这张图的重点是,功能结构不是由模型类型选择的,而是由关闭问题所需的依据和状态选择的。而且无论选择哪种结构,最后一步都必须重新检查过度自信回答或依据不足的风险,让请求能被路由到人工审查或追问。
应该先记录请求状态的场景
初读小型生成式 AI 功能设计时,一个常见误解是:既然这是 AI 功能,就应该先接很多 retrieval 和 tools。 实际上,更重要的是区分当前问题要关闭时首先缺少什么。
转成实用问题,这个标准如下。
| 如果出现这种怀疑 | 首先要问的问题 |
|---|---|
这不就是写得好不好吗? | 所需信息是否已经在输入里? |
可以写出回答,但依据不确定。 | 是否应该先附上最新文档和依据句? |
规则解释了,但用户没有得到想要的实际值。 | 是否需要当前状态查询工具? |
可以生成回答,但现在给确定答案有风险。 | 是否应该保留为人工审查、追问或依据不足状态? |
如果把同一请求下沉到应该保留哪种状态?,可以更简短地读成:
| 读取请求后立刻记录的状态 | 首先标准 |
|---|---|
answer draft possible | 所需信息是否已经在输入中,并且请求能否无需额外依据或状态查询就关闭? |
evidence reinforcement needed | 可以写回答,但是否仍缺最新文档或依据句? |
state lookup needed | 请求是否需要当前余额、审批状态、日程状态等真实值,而不是规则说明? |
human review or insufficient evidence | 例外条款是否很多或文档不足,使现在给确定答案有风险? |
这张表的关键,是比应该附上哪种结构?再低一层,立即记录这个请求目前关闭到了什么程度。这样,即使之后附上 retrieval 或 tool use,最终状态仍然能分为 answerable、evidence reinforcement needed、state lookup needed、human review needed。
首先要学会的标准很简单。设计小型生成式 AI 功能,不是选择一种模型调用方式,而是先区分 current input、current evidence、current state 和能否给出确定答案之中首先缺少什么,然后附上正确结构和状态值。
练习和例子
这个练习的重点不是附上生成式 AI 功能,而是直接判断要关闭问题需要哪种结构。即使读完上面的案例,看到真实请求句子时,prompt、retrieval、tool use 仍可能再次混在一起。因此,先读问题,写下需要哪种结构、必须留下什么记录、如果选错结构,失败会在哪里出现,再和下面说明比较。
下面练习使用四个请求句子。它们看起来都像同一个 HR assistant,但有些请求用 prompt-centered 就能关闭,有些首先需要 prompt + retrieval,有些首先需要 prompt + tool use。
关键是首先区分问题需要 current input、current evidence,还是 current state 才能关闭。如果结构选错,缺少依据、缺少状态或不必要 retrieval 会在回答质量成为主要问题之前出现。
先遮住下表的首先附上的结构列,写下每个请求首先需要什么。然后对照答案、理由和记录项。
| 请求场景 | 首先附上的结构 | 为什么这个结构合适 | 最小要保留的记录 |
|---|---|---|---|
请把下面的通知句子改得更柔和。 | prompt-centered | 要修改的目标已经完全在输入里 | 原句、修改后句子、修改意图 |
本季度育儿假申请顺序是什么? | prompt + retrieval | 首先需要当前政策文档和依据句 | 问题、选中文档、依据句、回答 |
我还剩多少休假? | prompt + tool use | 需要当前账户状态查询,而不是规则说明 | 问题、调用的查询工具、查询结果、回答 |
今年福利积分会马上过期吗? | prompt + retrieval,必要时 human review | 首先需要当前通知文档,若文档不足,回答不应过于确定 | 问题、选中文档、依据是否不足、是否需要人工审查 |
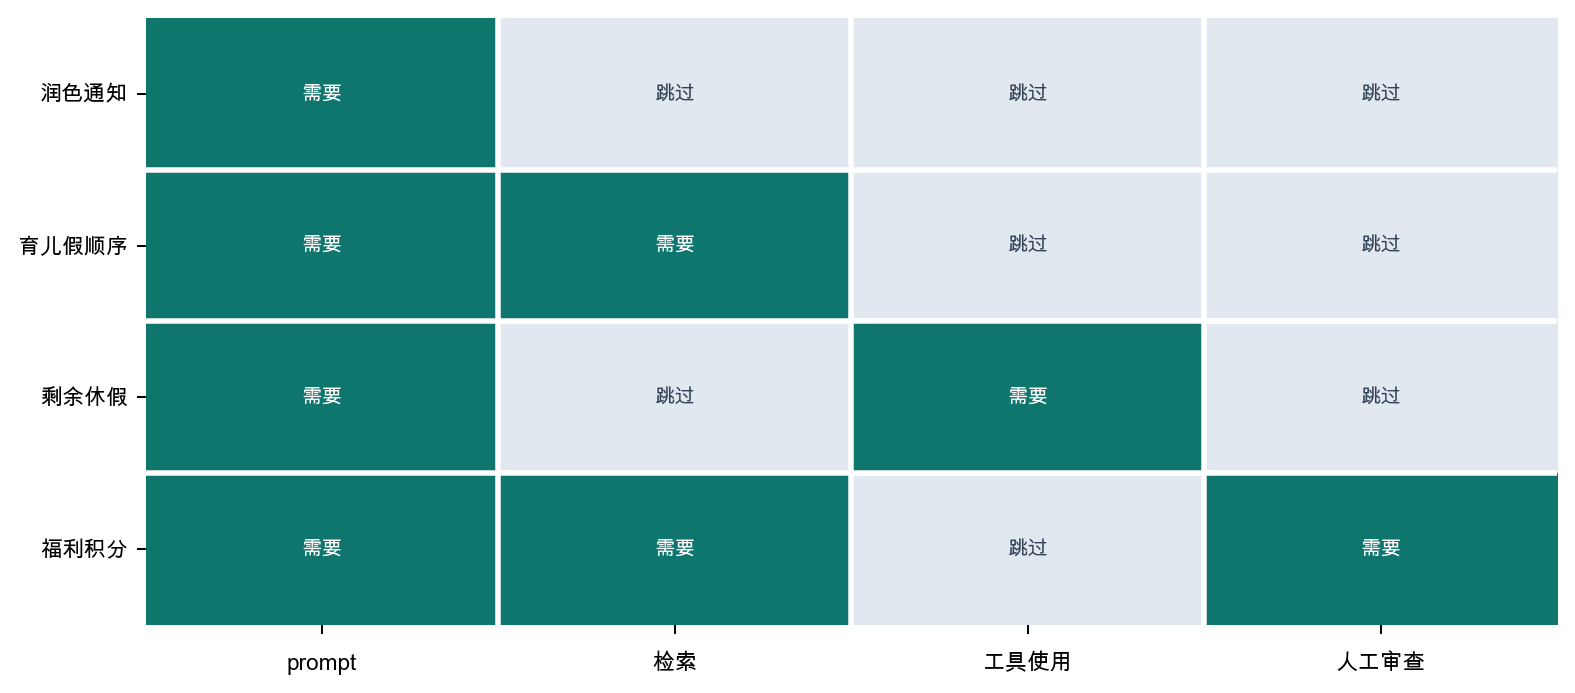
读这张表时,比正确功能名称更重要的是回答要关闭时首先缺什么。例如,如果只给剩余休假查询附上 retrieval,可能检索到规则句,但当前余额仍然没有回答。如果给句子润色附上 retrieval,回答反而可能发散。
同样想法可以缩短成实用审查说明。
| 错误选择的结构 | 首先出现的问题 | 更安全的下一步判断 |
|---|---|---|
| 给句子润色附上 retrieval | 无关规则短语混入,让回答又长又僵硬 | 先检查工作是否用当前输入就能关闭 |
| 只靠 prompt 处理政策指引 | 依赖一般说法或过时记忆,而不是当前政策 | 先附上当前文档 retrieval 和依据显示 |
| 只靠 retrieval 处理状态查询 | 解释了规则,但无法回答当前值 | 附上实际状态查询工具 |
| 依据不足时给出确定回答 | 回答听起来自然,但缺证据风险增加 | 路由到人工审查并保留失败记录 |
重新连接成设计句
不写很长设计文档也可以,只要能用下面这样的句子总结一个功能:
休假政策助手读取用户问题,检索相关政策文档,用依据句生成回答,并记录检索失败或依据缺失。
如果功能需要当前状态查询,这个句子也必须改变。例如:剩余休假指引功能读取用户问题,必要时检查休假规则,通过 HR-system lookup tool 检索当前剩余天数,并把查询结果和回答一起记录。 这个句子包含工具调用和查询结果记录。
这样的设计句已经包含:
- 输入、
- retrieval 或 tool call、
- 输出、
- 依据或查询结果,
- 失败记录。
换句话说,整个 Part 6 已经被压缩进一个小型服务句子。
如果在这里再分开一次,请求流程设计直接决定什么、最小实现检查什么,会更清楚。
| 情况 | 设计直接决定什么 | 最小实现检查什么 |
|---|---|---|
| 问题类型不同 | 需要 prompt-centered、retrieval combined、tool-use combined 中哪一种 | 这种选择是否作为实际输出和执行记录留下 |
| 依据和状态看起来混在一起 | 这是 evidence-acquisition 问题,还是 current-state lookup 问题 | 依据文档列表和查询结果是否实际分开保留 |
| 失败不能被隐藏 | Human-review routing、follow-up question、failure-record path | Human-review-needed flag、执行状态、回顾说明是否实际记录 |
| Part 6 概念看起来分散 | 把问题、依据/状态、输出、评估和记录绑成一个请求句 | 这个请求句是否作为缩减实现中的实际步骤出现 |
这张表的关键是,应该先决定应该附上哪种请求结构,而不是先看实现了什么。最小实现再检查这个结构实际留下了哪些输出和请求执行记录。
压缩成一句话,设计小型生成式 AI 功能不是调用一次模型。它是选择适合问题类型的结构,用依据和状态回答,并记录这条路径。
检查清单
- 你能否把小型生成式 AI 功能说明成
问题、依据/状态获取、输出、评估、记录的请求流程,而不是一次模型调用? - 你能否区分只靠 prompt 就够的工作,以及需要 retrieval 或 tools 的工作?
- 你能否解释 retrieval 是依据获取,而 tool use 是状态查询和执行?
参考资料
- OpenAI, Prompt engineering, OpenAI API Docs, accessed 2026-07-19.
- OpenAI, Retrieval, OpenAI API Docs, accessed 2026-07-19.
- OpenAI, Function calling, OpenAI API Docs, accessed 2026-07-19.