P6-19.2 在响应前记录依据、状态和审查的最小实现
Section ID:
P6-19.2Version:v2026.07.31
最小实现记录从留下 request_id、selected_policy、evidence_state、answer_state、review_status、retrospective_note 开始。有了这份记录,它就会被读作一个小功能:比起回应句本身,依据、状态、回顾 会先留下来。
在 P6-19.1 中,我们把小型生成式 AI 功能绑成了 request interpretation -> retrieval or tool selection -> response generation -> state judgment -> record 的流程。这里用一小段代码重新画出这个流程。
最小实现的重点不是完成高性能服务。它是用自己的眼睛看到哪个输入经过哪条路径,并作为哪种输出和记录留下。更准确地说,它让运行了什么和下一步应先修哪里出现在同一个请求记录中。
请求执行记录留下什么
核心问题是:
- 在接入真实商业 API 之前,可以做出什么最小实现?
- 什么执行记录应该把 retrieval、response generation 和 review-needed state 放在一起?
- 剩下的记录如何显示下一步改进点?
这个实现是一个缩减的基线实现。它把 RAG 流程、tool-use 结构、evaluation 和 record-keeping 视角绑成一小段代码,让我们检查一个请求留下了什么输出和执行记录。目标不是完成产品级自动化或部署,而是让同一条记录显示 should retrieval be fixed first?、should the insufficient-evidence gate be fixed first?、should the human-review boundary be reset? 等修补优先级。
重要变化是从设计请求流程转向把这个流程留下为实际请求执行记录。这里也能看到它能运行和它被设计成可记录之间的区别。这个记录不应只是结果保存。它应该成为一个输入,帮助判断 retrieval quality、state classification、human-review handoff 之中应先修什么。
更安全的做法,是观察同一个问题在代码流程中什么时候变成 answer draft generated、insufficient evidence、document not retrieved、human review needed 等状态。最小实现的核心不是打印字符串,而是在同一条记录中留下一个请求结束时所处的运营状态。
| 代码流程中首先分开的状态 | 常见情况 | 为什么必须分开记录 |
|---|---|---|
| 可以生成回答草稿 | 找到两个以上相关依据,且冲突不大 | 把请求交给下一步 evaluation,同时把可以写草稿和可部署分开 |
| 依据不足 | 找到相关文档,但直接依据弱,或只有一份文档 | 避免把 retrieval success 和 answer-finalization readiness 当成同一件事 |
| 文档未检索到 | 没有找到能关闭问题的文档 | 避免用一般建议掩盖缺口,并把搜索扩展单独留下 |
| 需要人工审查 | 例外条款或批准边界让自动确定回答有风险 | 即使是最小实现,也必须留下运营边界和交接点,下一步改进才可能进行 |
区分响应生成和执行记录
- 你可以读懂小型生成式 AI 功能的最小实现流程。
- 你可以解释为什么 retrieval 结果、response、evidence、failure record 应该一起输出。
- 你可以区分功能运行起来了,和这个功能设计得好。
- 你可以解释下一步改进前要检查的最小记录结构。
最小实现中的五个执行步骤
本节的最小实现有五步。
- 接收问题。
- 用简单规则查找相关文档。
- 根据找到的文档生成回答。
- 判断回答能否最终确定、依据是否不足、是否需要人工审查。
- 记录使用了哪些文档,并留下回答质量说明。
即使不接真实 LLM API 调用,先检查这五步,也更容易看出之后模型调用进入哪里,以及 retrieval-quality 问题在哪里产生。
政策文档和问题留下的执行状态
输入:政策文档 CSV 中的 12 个政策片段,以及诱发不同失败类型的 36 个用户问题。
输出:
按文档的 retrieval score、选中的依据文档、生成的回答草稿、是否需要人工审查、evaluation notes。
这个例子的目标不是准确率,而是检查包含运营状态分类的流程。即使在同一个最小功能中,找到多份依据、依据不足、检索失败也必须被分开读取,才能决定下一步改进优先级。问题 CSV 中的 requires_review 列不是答案键。它是观察问题本身是否触及 approval、exception、security 等人工审查边界的信号。
案例和例子
这个最小实现小节是必要的,因为它把运行了一次和留下了运营判断分开。下面三个场景显示,即使它们都像同一个政策助手,如果没有请求执行记录,我们就无法重新读取失败发生在哪里。
案例 1. 回答出现了,但理由没有记录
如果回答字符串看起来自然,人们很容易觉得功能至少运行成功了一次。例如,问题本月入职的员工可以马上使用夏季休假吗?得到一个看似可信的一句话回答时,很容易想直接通过。
但在这个案例中,真正需要的是记录:入职一个月后规则和夏季休假批准规则是否一起被读取,两份依据是否冲突,以及回答使用了哪些文档。如果只留下回答,而不记录依据文档和执行状态,之后就无法区分错误回答来自坏 retrieval 还是坏 interpretation。
所以,即使是最小实现,也应该把文档分数、选中文档和执行状态放在回答旁边。这个案例中要确认的结果不是出现了回答,而是能否从同一请求执行记录重新读取这个回答为什么出现。
这个场景重要,是因为运营中出问题时,人们首先问的往往不是它给了什么回答?,而是它为什么那样回答?。没有依据文档和执行状态,即使同样失败第二天再次出现,也不能立刻区分 retrieval-quality 问题和 prompt-interpretation 问题。修复会变成猜测。相反,如果最小实现也留下请求执行记录,就能回溯哪份文档分数过高,哪条规则没有一起选中,以及判断从哪里开始漂移。
同一请求是否留下记录,会极大改变运营者能看到的信息。
| 请求执行结果 | 表面看起来怎样 | 运营者实际能重新读取什么 |
|---|---|---|
| 只剩回答字符串 | 看起来响应已经完成 | 几乎没有。检索失败和解释失败难以分开 |
| 回答 + 选中文档列表留下 | 看起来有依据 | 能看到看过哪些文档,但为什么选择它们不清楚 |
| 回答 + 文档分数 + 选中文档 + 执行状态留下 | 看起来像一个小型基线实现 | 可以追踪应先修 retrieval、selection 还是 interpretation |
从这张表要抓住的标准不是更多记录会让事情复杂,而是没有记录,下一步改进会被阻塞。最小实现的重点不是做出漂亮 dashboard,而是留下能重新读取失败的最小线索。
案例 2. 依据不足却最终确定回答
新福利积分可以从本周开始使用吗? 这类问题风险更高。如果系统只因为检索到一份文档就最终确定回答,它实际上可能是从新福利项目在正式通知发布前需要 HR 确认这样的周边句子回答,而不是从直接的福利积分规则回答。
在这个场景中,很容易觉得既然至少出现了一份相关文档,就可以回答。但更重要的是记录:是否只有一份依据、是否可能缺少例外条款、是否需要人工审查。换句话说,retrieval success 和 answer can be finalized 不是同一步。
所以,即使在最小实现中,insufficient evidence state 和 human review needed state 也必须分开留下。这样回顾时才能区分下一步问题是搜索扩展,还是 approval-gate 设计。这个案例中要确认的结果不是生成了回答,而是依据不足状态是否作为运营路线留下,而没有被隐藏。
这在实践中更危险,因为找到一份文档会给人过多安心感。一旦搜索画面出现相关文档标题,人们很容易把它几乎当成证据已经取得。但运营判断必须分开存在相关文档和有足够依据关闭问题。尤其涉及例外条款或 approval procedure 时,凭单一依据文档最终确定自动回答,可能会用更强信心传播错误回答。
差异可以写成运营说明。
| 状态 | 首先想到的解释 | 实际应留下的运营判断 |
|---|---|---|
| 检索到 1 份相关文档 | 找到了,所以能回答。 | 区分直接依据和周边说明材料 |
| 例外条款未检查 | 先回答,之后再补强。 | 把请求提升到 human-review-needed state |
| 从单一依据完成自动响应 | 最小功能运行了。 | 因依据不足被隐藏,运营风险增加 |
需要越过的误解是 retrieval success = automatic response allowed。最小实现应该显示的不是自动化多厉害,而是这仍然必须进入人工审查这条边界线能否作为状态值保留下来。
案例 3. 找不到文档,却用一般建议填补空白
考虑问题本月开始夜班津贴是多少?。即使当前文档集没有夜班津贴政策,模型也可以结合一般 HR 指引生成一个看似可信的句子,例如按照公司政策支付。如果没有检索到文档,但回答句子听起来自然,人们很容易想:既然还是回答了,也许之后可以补强。 从运营上看,这是最危险的情况之一。没有找到相关文档这件事本身就是关键信号。如果它被一般回答盖住,需要人工审查的问题和需要扩展搜索索引的问题会一起被埋掉。
所以,最小实现应该把 document not found 作为显式状态留下,而不是作为普通异常。通过这个状态,之后的回顾可以区分没有来源文档、有文档但关键词或 embedding 没命中、问题表达应扩展。要放下的误解是如果没有找到答案,就悄悄用一般建议填空。这个案例中要确认的结果不是它是否自然地盖住空白,而是是否明确把文档未找到作为运营状态留下。
三个案例可以通过请求执行记录的视角缩减。
| 场景 | 如果只剩回答,会漏掉什么 | 要一起保留的记录 |
|---|---|---|
| 需要多份依据的问题 | 哪些文档被一起读取,以及是否可能存在冲突 | 文档分数、选中文档、执行状态、回答草稿 |
| 只有一份依据的问题 | 回答能否最终确定,还是需要人工审查 | 依据不足状态、是否需要人工审查、回顾说明 |
| 找不到文档的问题 | 这是 retrieval failure 还是 interpretation failure,以及一般建议是否盖住缺口 | 文档未检索状态、失败说明、下一步行动 |
通过记录重新读取失败
初读最小实现时常见误判是:因为出现了回答,就觉得实现已经足够。但首先要检查的不是回答是否出现,而是同一请求记录能否重新读取下一步改进还剩什么。
| 如果出现这个场景 | 首先检查什么 | 为什么这个检查先来 |
|---|---|---|
| 回答出现了,但无法解释为什么这样回答 | 文档分数和选择理由是否一起留下? | 要分开 retrieval failure 和 interpretation failure,回答背后的选择路径必须可见。 |
| 依据弱,但请求以自动响应结束 | human-review-needed state 是否单独留下? | Retrieval success 和 answer-finalization readiness 不是同一件事。 |
| 没找到文档,但一般回答盖住了 | document-not-retrieved state 和 next action 是否明确? | 如果失败被隐藏,下一次回顾无法区分搜索扩展问题和回答策略问题。 |
同样标准可以缩短成实用问题。
| 如果出现这种怀疑 | 首先要问的问题 |
|---|---|
有回答,但不知道该修什么。 | 哪份文档以什么分数被选中? |
这不是应该让人再审一次的回答吗? | Human-review-needed state 是否作为状态值留下? |
为什么 retrieval 失败了还回答? | Document-not-retrieved state 和 next action 是否没有被隐藏地记录下来? |
首先要学会的标准很简单。最小实现不是停在出现响应的玩具。它是把依据文档、执行状态、是否需要人工审查、下一步行动放在一起,让下一次改进可读的基线实现。
练习和例子
这个例子会一次检查 question -> retrieval -> answer draft -> evaluation -> record。它不只看两个问题,而是包含找到多份依据、只找到一份依据、检索失败,让一个小型基线实现也分出多种失败类型。尤其是,每个问题都会以一条请求执行记录结束,因此可以在回顾或运营判断中重新读取应该修什么。
例子输入是政策文档 CSV 和用户问题 CSV。结果包括按文档的 retrieval score、选中的依据文档、回答草稿、是否需要人工审查、回顾说明、按问题的请求执行记录,以及整个问题集的汇总统计。
关键是,即使是最小实现,也必须把 retrieval、answer、evaluation、record 绑成一个流程。请求执行记录必须按问题留下,这样才能重新读取重复失败类型。从运营视角看,依据缺口和检索失败如何分开,比原始准确率更重要。
读代码前,先写下下面代表问题应该留下什么执行状态会有帮助。
| 问题 | 首先预期的执行状态 | 为什么这样预期 |
|---|---|---|
本月入职的员工可以马上使用夏季休假吗? | 多重依据检查状态 | 请求只有同时读取入职规则和休假规则后才关闭。 |
新福利积分可以从本周开始使用吗? | 依据不足 + 人工审查状态 | 直接依据可能弱,因此有漏掉例外条款的风险。 |
本月开始夜班津贴是多少? | 文档未检索 + 人工审查状态 | 当前文档集可能找不到相关规则。 |
如果先写出自己的答案再和代码结果比较,就会更清楚:这不是简单输出检查,而是按问题进行运营状态分类的练习。
这个例子的整合记录标准是:
| 检查项 | 为什么需要 |
|---|---|
| 依据文档列表 | 留下实际使用了哪些依据 |
| 是否需要人工审查 | 分开可立即使用的回答和需要人工确认的回答 |
| 执行状态 | 一眼区分多重依据、依据不足、检索失败 |
| 整体摘要 | 读取整个流程中常见失败,而不是一次只看一个问题 |
下面的例子使用政策文档 CSV p6_18_2_policy_documents_zh.csv 和问题 CSV p6_18_2_policy_questions_zh.csv。文档文件的一行是一条政策片段。问题文件的一行包含用户问题、解释问题得到的关键词组,以及是否需要人工审查的信号。requires_review 不是判断模型答对与否的答案键,而是用于观察自动确定回答有风险的问题类型的输入信号。这个例子没有接真实 LLM 或真实搜索引擎。它是一个基线实现,用来检查请求执行记录中应该留下哪些依据和状态。
Retrieval 不会直接理解自然语言问题。它使用问题 CSV 的 query_groups 和文档 CSV 的 keyword_groups 的重叠作为简单分数。所以这里的重点不是夸大 retrieval quality,而是记录这个松散 retrieval 拉来了哪些文档,以及它的限制是什么。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 | |
输出可以分三层读取。[summary] 显示 36 个问题的状态分布。[selected_records] 显示代表问题是否分成不同执行状态。[detailed_record] 检查文档分数、选中依据、回答草稿和 evaluation state 是否一起留在一个请求中。
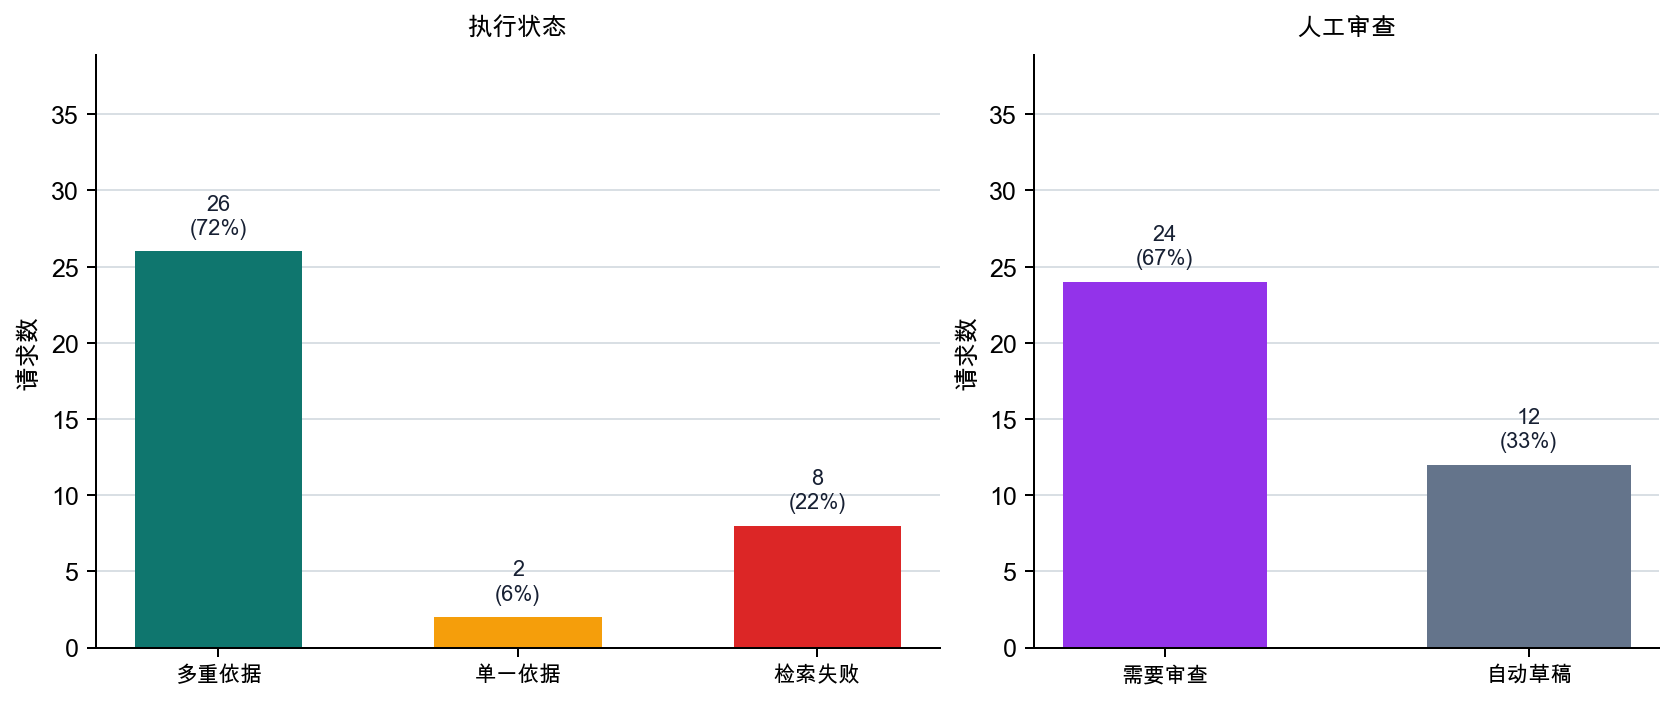
一起读取 Retrieval Score 和运营状态
这个例子不调用真实 LLM 或真实搜索引擎。我们首先看的不是性能,而是即使之后接上 LLM、RAG 和 tool use,也必须留下的请求执行记录骨架。即使这个小基线,也能清楚显示五件事。
- 一个问题进入。
- Retrieval 步骤以分数形式单独存在。
- 回答不是依赖一份文档,而是依赖选中的依据包。
- 多重依据、依据不足、检索失败被记录为不同说明和执行状态。
- 按问题的执行结果最后再次归入整体摘要。
所以,这个例子中要确认的结果不是一句模型回答了。而是 retrieval score、依据文档、回答草稿、human-review flag、回顾说明、按问题的请求执行记录是否实际分开留下。尤其在同一个最小功能中,multiple evidence secured、insufficient evidence、retrieval failed 必须作为不同运营状态留下。
在代表性的详细记录中,剩余休假天数查询文档也被检索到是有意的。这个文档共享同一个 leave 关键词组,但很难读成直接关闭入职后能否马上使用夏季休假的依据。因此,这个结果不应被读成完整 retrieval success。相反,因为简单 keyword-group retrieval 会拉入附近文档,执行记录必须保留文档分数和选中文档,这样下一步才能接 reranking、evidence-citation rules 和 groundedness checks。
同样结果可以改写成实用审查说明。
| 问题 | 现在要留下的审查说明 | 下一步 patch 优先级 |
|---|---|---|
| 同时涉及入职和休假规则的问题 | 找到了两个以上依据项,但还需要处理条件冲突的解释规则 | Interpretation rule 和 groundedness check |
| 直接依据较弱的问题,例如福利积分 | 可以写草稿,但立即最终确定有风险 | Search expansion 或 approval gate |
| 没有找到文档的问题 | 暴露失败而不是装饰回答是好的,但 retrieval 范围不足 | Index expansion、document addition、human-review flow |
从请求执行记录中回看什么
这个最小实现不会停在检查代码是否运行一次。每个问题留下的请求执行记录必须被重新读取,用来区分失败发生在 retrieval、interpretation,还是应该路由到 human review 的状态。
例如,如果找到了文档,但回答没有充分反映入职一个月后这样的条件,这是 retrieval 成功后的 interpretation failure。这时,在增加更多关键词之前,应该先检查 evidence-citation style 和 answer-review rules。反过来,如果没有找到相关文档,系统就不应该装饰回答,而应该留下 human review needed state,并先检查 keyword expansion、embedding search 或 index improvement。如果给出了回答但缺少实际剩余天数或 approval status,直接原因可能是没有 lookup API 或 tool call,而不是文档搜索问题。
这样读取后,同样失败再次出现时,首先该修什么会更清楚。
再进一步,把最小实现直接显示的东西和下一步改进剩下的东西分开也有用。
| 情况 | 这个最小实现直接显示什么 | 下一步改进还剩什么 |
|---|---|---|
| 问题产生不同结果 | 多重依据、依据不足、检索失败作为不同执行状态留下 | 真实 embedding search、reranking、更精确的 groundedness judgment |
| 出现回答但需要审查 | Human-review-needed state、回顾说明、请求执行记录 | Approval gate、真实人工审查队列、retry policy |
| 依据不足或缺失 | Retrieval 和 interpretation 被分开审查 | 更好的搜索基础设施和 tool-call connection |
| 代码运行了一次 | 请求路径和记录结构分开出现 | 包含成本、延迟、运营限制的服务工作 |
这张表的关键是,最小实现不只是能运行的例子。它是显示下一步该修哪里的基线。真实 embedding search、tool use、AI agent loops 和运营控制,之后都加在这个基线上。
回顾问题可以这么简单。
| 场景 | 立即留下的回顾问题 | 可能首先修的区域 |
|---|---|---|
| 找到了文档但回答漂移 | 回答是否把依据读到最后? | Interpretation rule、groundedness check |
| 没找到文档,请求进入人工审查 | 依据缺失是否被显露而不是隐藏? | Search expansion、human-review flow |
| 选择下一个扩展点 | 这是 retrieval 问题,还是缺少 tool? | Vector search、tool use、AI agent branch |
这个最小实现仍然不能做什么
这个最小实现显然有限:retrieval quality 依赖简单关键词规则,回答生成基本是模板级别,冲突文档之间的优先级没有处理,也没有真实 tool call 或权限检查。
但写下这些限制,正是我们把代码运行了一次和它能在真实工作条件下反复使用分开的方式。
另一个重要点是,这份限制列表会变成设计优先级。
- 如果 retrieval failures 常见,先修 retrieval quality。
- 如果找到了文档但回答经常漂移,先修 answer-generation rules 和 evidence display。
- 如果 current-state questions 增加,接入 tool use。
因此,最小实现的回顾不应该是印象,而应该成为决定 next patch order 的输入。
何时扩展到 Vector Search 和 Tool Use
当出现下面这些情况时,这个 mini-practice 会变成扩展目标。
- 文档足够多,关键词规则开始显出限制。
- 需要更可靠地找到相似表达。
- 需要 current-state lookup 或 execution。
因此,本节不是完成的实现,而是下一步改进的基线。
可以这样连接:
- 如果需要更好的依据连接,回到 P6-11 的 RAG 流程和 P6-12 的向量数据库结构。
- 如果需要真实状态查询或计算,移动到 P6-13 的 tool use。
- 如果需要多步骤判断,移动到 P6-14 的 AI agent 结构。
- 失败记录和安全装置应该通过 P6-16 的 evaluation 视角和 P6-17 的 operation 视角重新读取。
检查清单
- 你能否解释,最小实现不是完成品,而是结构检查的基线?
- 你能否解释,retrieval、response、records 应该一起输出,而不是彼此分离?
- 你能否区分功能运行起来了,和它实际可用?
参考资料
- OpenAI, Retrieval, OpenAI API Docs, accessed 2026-07-19.
- OpenAI, Working with evals, OpenAI API Docs, accessed 2026-07-19.
- OpenAI, Evaluate agent workflows, OpenAI API Docs, accessed 2026-07-19.