P6-6.1 作为阅读中心 Transformer 比较轴的 BERT
Section ID:
P6-6.1Version:v2026.07.26
即使同属 Transformer 家族,也有一条流程擅长阅读整个输入,另一条流程擅长生成下一个 token。
BERT 家族是以 encoder 为中心的 Transformer 流程,它读取整个输入上下文并创建表示。与生成相比,它通常更适合理解、分类、搜索和嵌入任务。
学习生成式 AI 时,很容易认为所有 Transformer 家族模型都差不多。但在真实服务中,读取句子并输出判断值的结构,和继续生成下一个 token的结构,用法并不相同。为了说明为什么 BERT 家族在搜索、分类、嵌入的前端仍然重要,这个区分是必要的。
重要的比较问题是:BERT 也是 Transformer,为什么它的角色和 GPT 不同? 与其打开一条很长的新主线,不如在已经读过的生成流程和阅读中心的 Transformer 家族之间建立比较标准。
阅读中心的 Transformer 比较轴
比较从这些问题开始。
- BERT 家族位于 Transformer 内部的哪里?
- 为什么 BERT 被解释为能一起查看整个输入的模型?
- 应该从什么视角把它和 GPT 家族区分开来?
最安全的做法,是把 BERT 家族抓成读取整个输入的 encoder-centered Transformer 流程。这样,它和 GPT 家族在使用上的差异会更清楚。
不过,在把 BERT 的角色扩展到分类、搜索、句子对判断和嵌入之前,应该先固定结构差异。与搜索和嵌入的实践连接,可以和 P6-13.1、P6-13.2 的搜索流水线说明一起重新阅读。
BERT 并没有简单地作为LLM 之前的旧模型被推开。它仍然是分类、搜索、嵌入前端中重要的 encoder-based 流程。这里不是把 Part 6 的主流程转移到 BERT,而是先设定比较标准,以便更准确地比较 GPT 家族和生成式 AI 主流程。
如果只压缩必须留下的比较轴,下面四行就足够。
| 比较轴 | BERT 家族 | GPT 家族 |
|---|---|---|
| 中心结构 | encoder | decoder |
| 阅读方式 | 一起读取整个输入上下文 | 查看前面的 token 并生成下一个 token |
| 代表输出 | 标签、分数、相关性、嵌入 | 后续 token、句子、回答 |
| 首先擅长的任务 | 分类、搜索、句子对判断 | 生成、对话、起草 |
区分阅读中心和生成中心结构
- 你可以把 BERT 家族解释为 encoder-centered Transformer 流程。
- 你可以通过
上下文阅读方式和主要任务解释 BERT 与 GPT 的差异,而不只看是否生成。 - 你可以说明为什么 BERT 家族和分类、搜索、嵌入等任务连接得很好。
- 你可以把理解中心任务读成结构比较的延伸。
BERT 代表什么?
BERT 是 Bidirectional Encoder Representations from Transformers 的缩写。但一次看到这个缩写,反而可能让它更陌生。与其先背名称,不如先读这些词为什么被贴在一起。
- bidirectional
- encoder
- representations
- Transformers
每个词可以简单解释如下。
| 词 | 这里要读出的含义 |
|---|---|
| bidirectional | 一起读取前面和后面上下文 |
| encoder | 读取输入并把它变成表示 |
| representations | 创建可复用于分类、搜索、比较的上下文表示 |
| Transformers | 创建这些表示的基础结构是 Transformer |
所以,BERT 的名称包含这样的想法:Transformer encoder 一起读取整个句子,并创建带上下文的表示。
先记住这一句就足够。
BERT 是一种把句子读到最后,并转成可复用于后续任务的表示的模型流程。
有了这个标准,就更容易看出为什么前面读过的 GPT 家族被解释为持续生成结构,而不是读取并判断的结构。
为什么说 BERT 会看整个输入?
GPT 家族通常被解释为 autoregressive 流程:从左侧上下文预测下一个 token。相比之下,BERT 家族会在输入句子内部同时使用前后上下文,为某个位置创建表示。
看这个句子。
I deposited money at the bank.
要读出 bank 的含义,后面的短语 deposited money 很重要。
再看另一个句子。
I sat on the bank of the river.
同一个词 bank 出现了,但后面上下文不同,所以含义会改变。
BERT 家族的核心直觉是:
一个 token 的表示不仅由这个 token 自身形成,也由整个周围上下文形成。
为什么 BERT 更接近理解而不是生成?
过度拟人化地使用理解这个词有风险。更安全的解释是:
BERT 家族擅长阅读整个句子并创建上下文表示,因此这些表示能很好连接到分类、搜索、句子对比较等任务。
所以,更适合把 BERT 读成:
- 不是为了生成长的后续句子而优化的结构,
- 而是擅长把输入转成可解释的表示空间的结构。
和 GPT 相比有什么不同?
读者常问:
- BERT 是理解模型,GPT 是生成模型吗?
方向是对的,但如果说得太简单就会误导。更安全的比较是:
| 类别 | BERT 家族 | GPT 家族 |
|---|---|---|
| 中心结构 | encoder | decoder |
| 基本直觉 | 读取整个输入并创建表示 | 查看前面的 token 并生成下一个 token |
| 擅长任务 | 分类、搜索、句子对判断、嵌入 | 生成、对话、摘要、起草 |
| 阅读方式 | 使用双向上下文 | 与生成方向一致的顺序预测 |
这张表的关键不是给谁排优劣,而是使用差异。需要从中确认的结果是:即使二者都属于 Transformer 家族,你是否能把 BERT 和 GPT 读成哪个任务先适合?,而不是哪个更好?
为什么 BERT 家族仍然重要
因为生成式 AI 热潮,BERT 家族可能看起来像过去的技术。但在真实服务中,它在需要前端的阅读、分类、排序,而不是长回答生成的部分仍然重要。
例如:
- 文档分类,
- 情感分析,
- 搜索排序,
- 句子嵌入,
- 查询和文档之间的相关性判断,
仍然很适合 encoder 家族表示模型。
GPT 打开了宽泛的生成接口,并不意味着 BERT 家族的位置消失了。
如果想象聊天机器人的 intent-analysis 工具,这一点更容易抓住。商业云服务常包含这样的功能:读取用户句子,并附上 refund request、delivery lookup、password reset 等 intent label。产品界面和设置常会变化,但中心结构仍然接近读取输入并判断合适的标签或相关性。
为什么要同时区分 BERT 和 GPT
到这里,比较的必要性会更清楚。本节的核心不是孤立地深挖 BERT。它是先区分:即使在同一个 Transformer 家族内部,读取并判断的结构和继续生成的结构也支持不同任务。设定这个标准后,P6-5.1 The GPT Family as a Decoder-Based Cumulative Generation Structure 和 P6-7.1 Next Token Prediction as the Starting Point of Long Generation 就能更直接地一起阅读。
按输入和输出拆分 BERT 与 GPT
通过问进来的是什么,出去的是什么,生成模型和 BERT 家族的差异会更容易抓住。
| 视角 | BERT 家族中首先出现的东西 | GPT 家族中首先出现的东西 |
|---|---|---|
| 输入 | 一个句子、句子对、问题-文档对 | prompt、对话历史、前面生成的 token |
| 中间表示 | 带上下文的 token 表示、句子表示 | next-token probability distribution |
| 输出 | 标签、分数、相关性、嵌入 | 后续 token、句子、回答草稿 |
BERT 家族更接近读取并输出判断值,GPT 家族更接近读取并继续下一个输出。
这个差异也会出现在聊天机器人运营工具中。Intent classification 或 routing 工具通常先判断这个用户句子应该被送到哪个流程。相反,生成式聊天机器人会在下一阶段把写出长回答句子的体验放在前面。所以二者不一定是竞争关系。在一个服务内部,它们可以作为前端的阅读和分类以及后端的生成和响应一起使用。
非常简单的图
flowchart TD
  A["输入 token"]
  B["encoder Transformer 层"]
  C["带上下文的 token 表示"]
  D["分类 / 排名 / 嵌入任务"]

  A --> B --> C --> D
这个图中要确认的结果是:BERT 家族不是读完句子后立刻生成长回答。它创建上下文表示,然后把这些表示连接到分类、搜索和嵌入任务。
案例和例子
案例 1. 文档分类
第一次看到文档分类时,很容易从统计是否出现接近标签的词开始。但在真实咨询运营中,这应该被送到哪个处理流程?比表面词更重要。
即使没有 refund 这个词,一个咨询也可能是在问退款状态。即使出现了 cancel,实际瓶颈也可能是账户认证。这个场景说明为什么 BERT 家族被解释为阅读中心结构:它能更稳定地捕捉整句的处理意图。这个案例中要确认的结果是,表面词不同的咨询是否能更稳定地聚到同一个处理队列。
即使是同一条咨询,表面词标准和整句标准也可能产生不同结果。
| 咨询表达 | 只靠关键词规则可能得到的判断 | 阅读中心模型首先试图捕捉什么 |
|---|---|---|
When will the money come back? | 可能因为没有 refund 而漏掉 | 付款取消后的退款状态咨询 |
I canceled the order but the payment still appears. | 可能因 cancel 或 refund 等表面词较弱而漂移 | 检查取消/退款处理状态的意图 |
I cannot log in, so I cannot cancel my order. | 看到 cancel,可能把案例推到退款/取消 | 真正瓶颈是账户认证还是订单取消 |
这张表纠正了只要出现和标签名相似的词就差不多够了的误解。文档分类中需要阅读中心模型,是因为它比表面词更直接地捕捉处理意图。
案例 2. 搜索排序
搜索排序也常从标题关键词匹配开始,但当用户表达和文档表达稍有不同,顶部结果就很容易漂移。用户可能搜索 return equipment,而文档写的是 asset recovery;另一个用户可能搜索 resignation,而标题写的是 offboarding procedure。
这个场景说明,为什么 BERT 家族等阅读中心模型会被解释为先阅读整个问题和整个文档之间的关系,而不是只数重叠词。这个案例中要确认的结果是,实际更相关的流程文档是否能排到仅有更多相同词的文档前面。
阅读标准会这样变化。
| 问题-文档关系 | 关键词标准可能先推高什么 | 阅读中心排序首先试图推高什么 |
|---|---|---|
问题直接包含 equipment 和 return | 标题中有很多相同词的文档 | 解释真实 offboarding 流程中设备回收步骤的文档 |
文档标题只写 offboarding procedure | 因词重叠低,可能被压低 | 离职前流程和问题意图之间的连接 |
文档使用 asset recovery guide 等不同表达 | 表面词不同,可能被漏掉 | 整个问题和整个文档之间的语义相关性 |
这个案例中的重要标准,是区分有多少词重叠?和它们是否真的在说同一个流程?。搜索排序中需要 BERT 家族,是因为这两者常常分开。
案例 3. 句子相似度和意图分类
I want to change my password 和 How do I reset my login password? 即使表面词不同,也可能属于同一解决路径。相反,Login keeps failing 看起来相似,却可能需要不同处理流程。
云端聊天机器人 intent classification 也类似。它先读取整句话请求哪个处理流程,而不是只检测词,这样更稳定。这个场景压缩了为什么 BERT 家族比长回答生成更适合读取并区分的判断结构。这个案例中要确认的结果是,同意图句子是否聚得更近,而需要不同处理流程的句子是否分开。
三个案例可以通过阅读中心判断视角分组。
| 情况 | 关键词规则容易处理错什么 | 阅读中心模型首先试图捕捉什么 |
|---|---|---|
| 文档分类 | 表面词不同的同一咨询 | 同一处理意图 |
| 搜索排序 | 只有标题相似的文档 | 实际与问题相关的流程文档 |
| 句子相似度 / 意图分类 | 看起来相似但需要不同解决路径的句子 | 同意图和不同意图的分离 |
在阅读和生成之间选择
阅读 BERT 家族时,一个常见误解是因为它不能像 GPT 那样写长回答,就把它看成较不重要。但首先要检查的不是生成能力大小,而是需要的工作是阅读和判断,还是继续写作?。转换成实践问题,可以这样读。
| 如果出现这种疑问 | 首先要问的问题 |
|---|---|
这应该生成长回答,还是先分类? | 需要的输出是句子,还是判断值? |
找到文档之前应该发生什么? | 是否需要一个读取问题和文档相关性的前端? |
只知道生成式 AI 不就够了吗? | 前端阅读、排序和嵌入是否仍然需要? |
先学会的标准很简单。BERT 家族更接近把句子读到最后,并创建表示和判断值的结构,而 GPT 家族更接近读取后继续生成下一个 token 的结构。在比较优劣之前,应先阅读用途差异。
练习
练习目标不是用代码,而是通过判断表确认:即使有相同表面词,把上下文读到最后也可能改变解释和下游标签。为了先抓住 BERT 家族的结构位置,重点放在上下文阅读和输出方向,而不是实际标签、分数或排名实验。
下面的练习检查这样一种结构:理解中心模型读取句子并把它传给判断值,这不同于生成式回答。给定四个带有相同表面词或相近主题的句子,比较不读上下文时附上的简单标签、读完整个上下文后的解释,以及传给下一任务的标签。
关键是确认:即使同一个词出现,只有把上下文读到最后,解释和下游标签才可能改变。理解中心模型首先创建解释结果和任务标签,而不是长回答;表面关键词标准和上下文解释标准,可能从同一输入产生不同输出结构。
练习使用上面整理的例句列表。
| 输入句子 | 只靠表面关键词可能得到的标签 | 读完整个上下文后的解释 | 下一任务标签 |
|---|---|---|---|
| I want to deposit money at the bank | financial_topic | 在金融机构存钱的情况 | finance_intent |
| I am walking under a tree on the bank of a river | financial_topic | 涉及河岸的自然场景 | nature_description |
| I want to reset my password | account_topic | 账户访问问题 | account_intent |
| I canceled the order but the payment still remains | payment_topic | 订单取消后的付款状态问题 | order_support_intent |
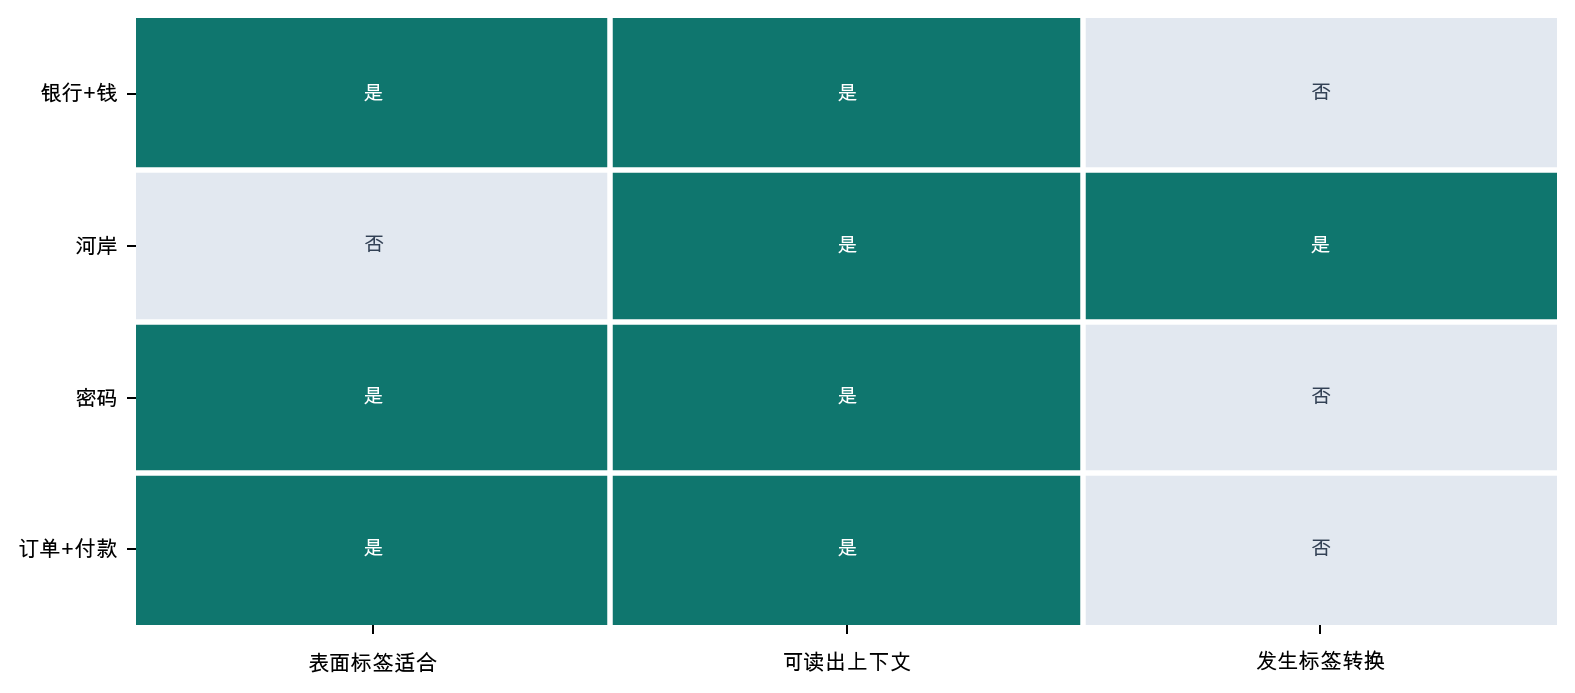
从这个练习中要读出的核心点是:
- 即使有同一个词,解释也会随周围上下文改变;
- 简单关键词标签可能错误地把第一句和第二句归到同一主题;
- 上下文解释会连接到分类或意图判断等下游任务;
- BERT 家族适合
读取整个句子 -> 创建表示 -> 连接到判断任务这一流程。
读者可以直接尝试这些调整:
- 在表中加入
I cannot log in to the banking app,判断第一个标签应是金融主题,还是账户访问问题。 - 加入
I cannot log in, so I cannot cancel my order,说明哪个应先处理:订单取消标签,还是账户标签。 - 写出同一句话被当作 GPT 家族回答生成问题处理时,和被当作 BERT 家族 routing 问题处理时,输出有什么不同。
阅读模型中首先出现的输出差异
这个练习显示,即使不像生成模型那样继续写长回答,把句子读到最后并决定要传给哪个判断也是独立且重要的能力。所以看 BERT 家族时,更准确的位置不是生成的竞争者,而是处理分类、搜索、routing 前端的阅读中心模型。
BERT 强烈显示了 Transformer 可以从翻译结构扩展到语言理解任务。
从历史上看,BERT 重要是因为:
- 它显示基于 Transformer encoder 的预训练可以很好迁移到非常广泛的下游任务;
- 它大幅提高了上下文表示的质量;
- 它迅速改变了分类、搜索、嵌入家族的实践流程。
最后要保留的结果很清楚。即使在生成式 AI 时代,读取、区分、连接的模型的角色也没有消失。它仍然是分类、搜索、嵌入等前端任务中的独立轴。用这个标准,GPT 家族说明就不太容易被读成所有语言任务的唯一答案,BERT 家族也可以被重新分离为负责阅读和判断的另一种结构。
检查清单
- 你应该能够把 BERT 解释为阅读中心 Transformer 家族中的代表性比较轴,而不是
旧模型。 - 你应该能够把 BERT 和 GPT 的差异解释为模型是
读取整个输入并创建判断值,还是继续生成下一个输出,而不是优劣关系。 - 你应该把理解中心任务抓成一个视角,用它把这种结构比较缩窄到实践任务组。
参考资料
- Jacob Devlin et al., BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, arXiv, 2018, accessed 2026-07-19.
- Matthew E. Peters et al., Deep contextualized word representations, arXiv, 2018, accessed 2026-07-19.
- Daniel Jurafsky, James H. Martin, Speech and Language Processing, draft materials, accessed 2026-07-19.